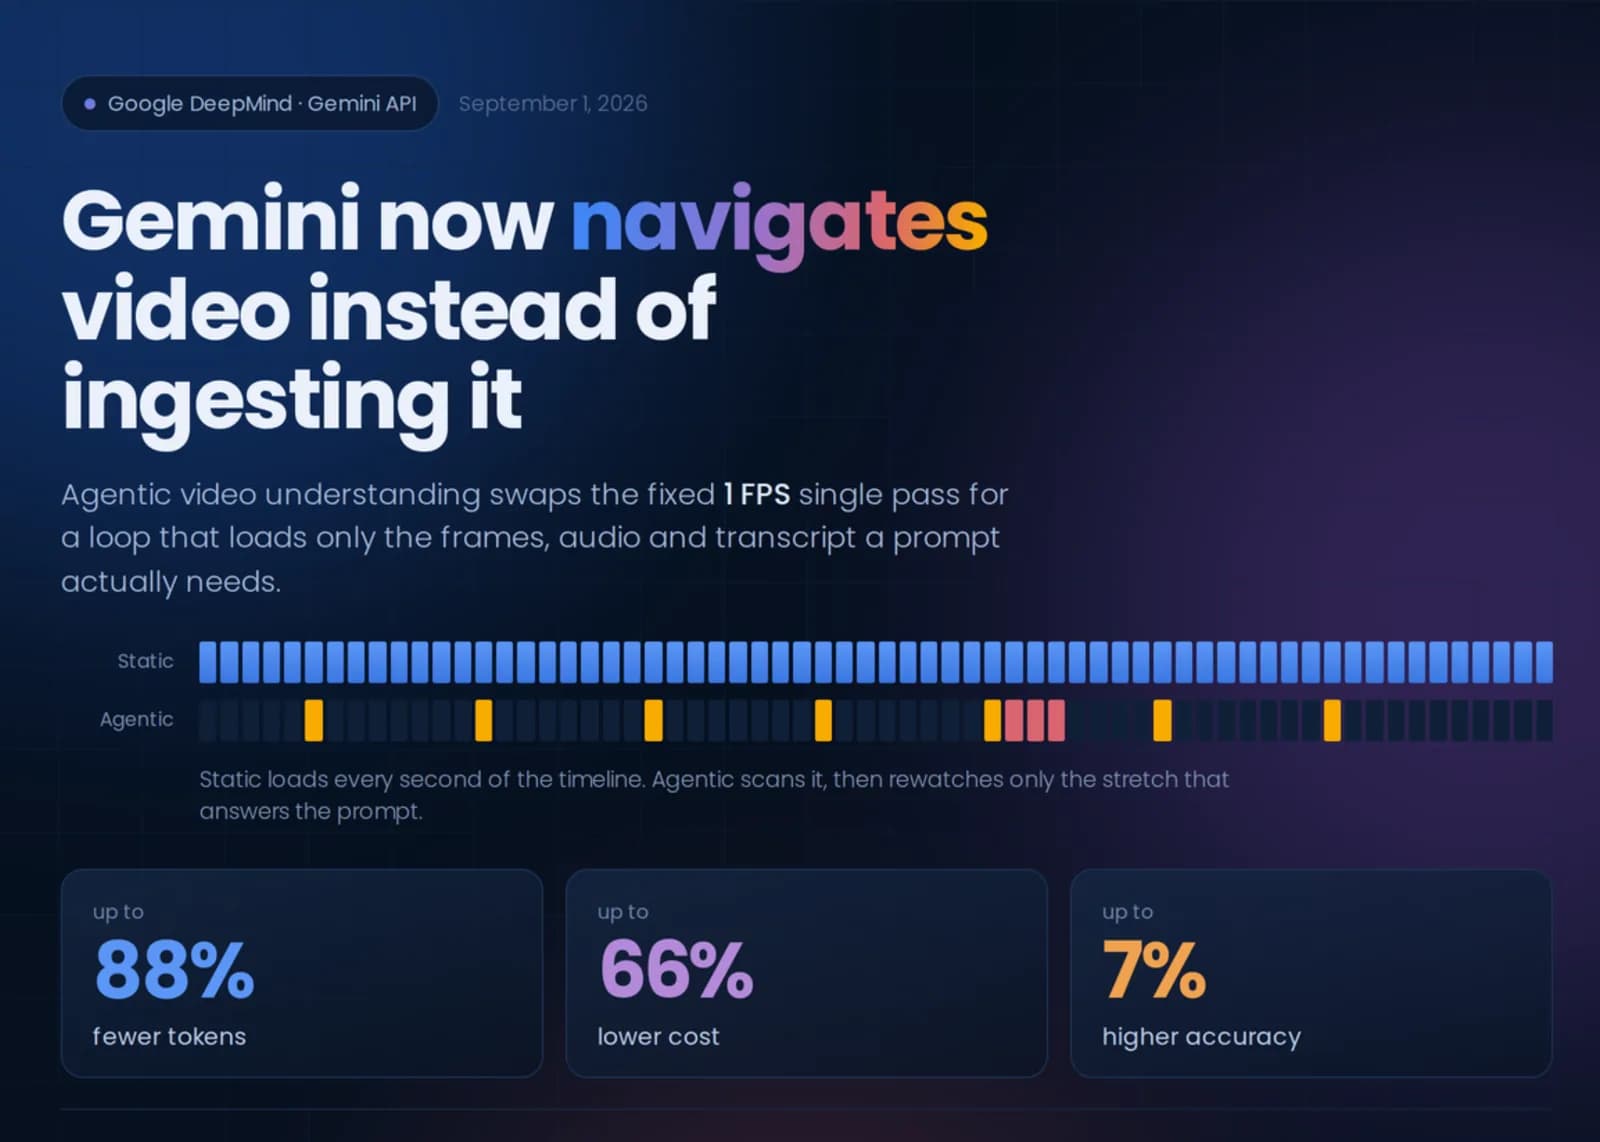
Gemini navega el video y recorta hasta 88% de los tokens
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.
Todas las notas publicadas en MechaNoticias. Ordenadas por fecha de publicación, de la más reciente a la más antigua.
2.123 notas · Página 50 de 89

Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.

Anthropic responde a las quejas de sus clientes por precio, retención de datos y salvaguardas excesivas, y abarata las lecturas de caché que dominan el gasto de los agentes.

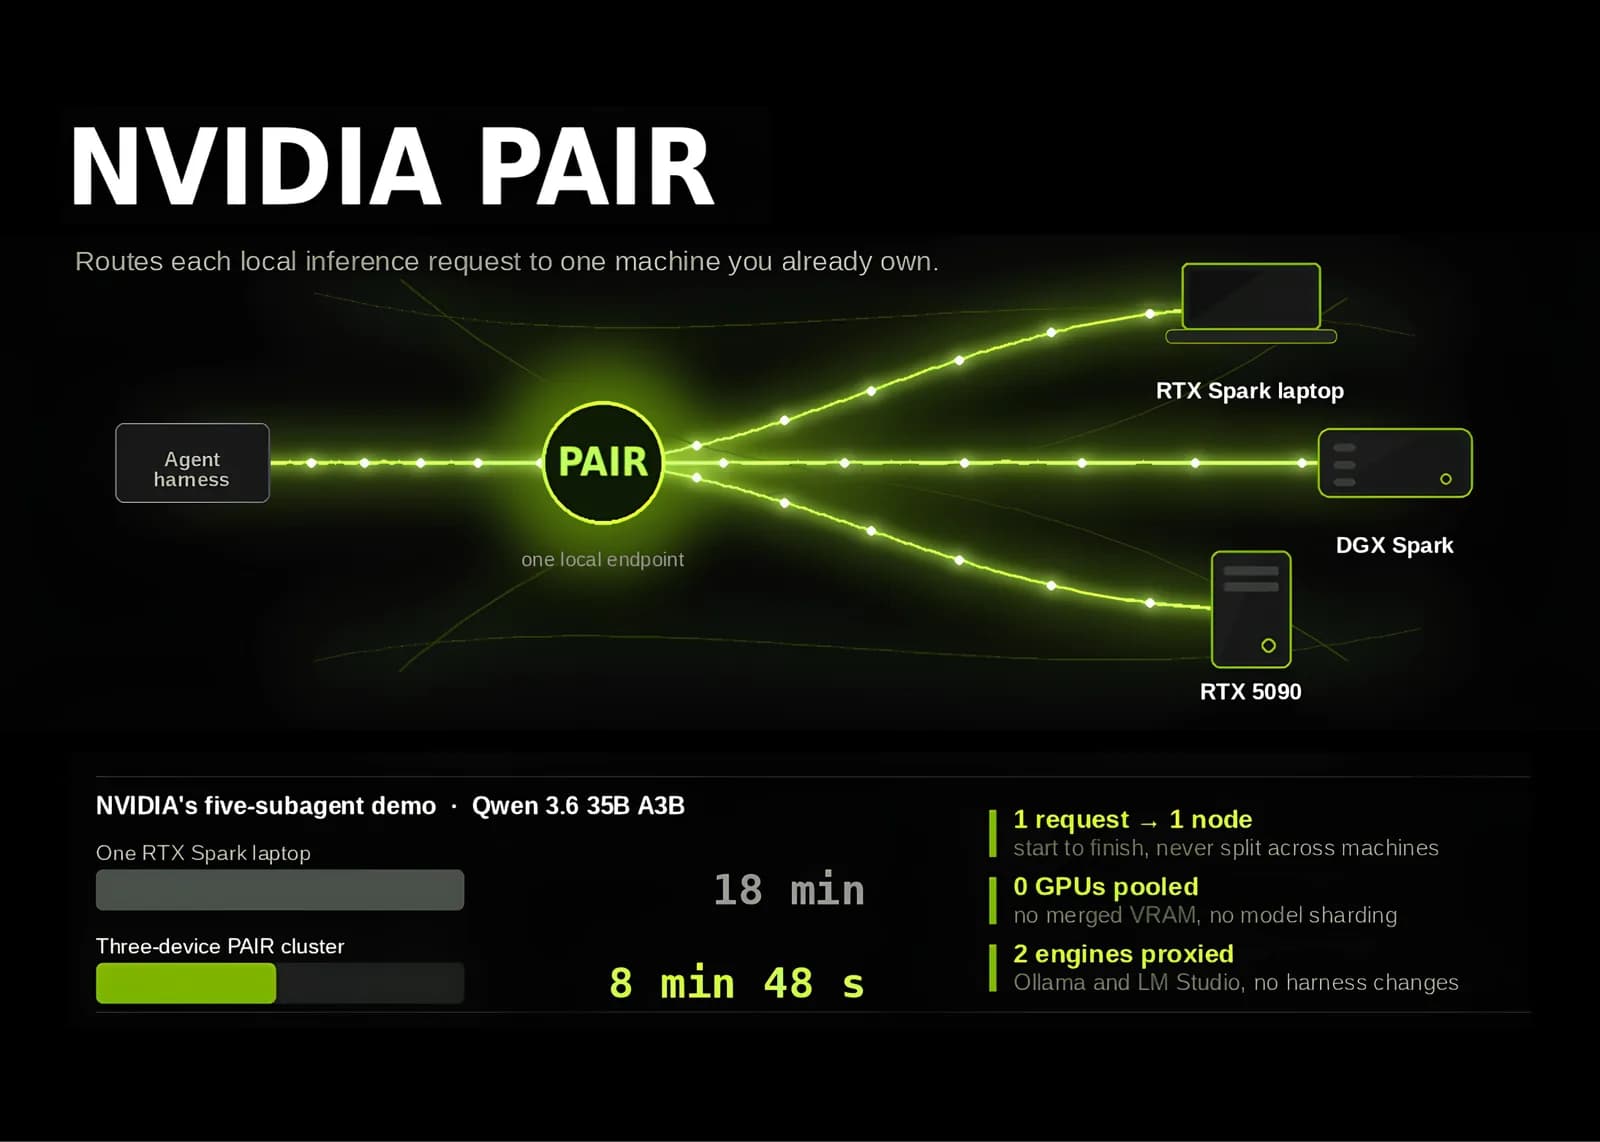
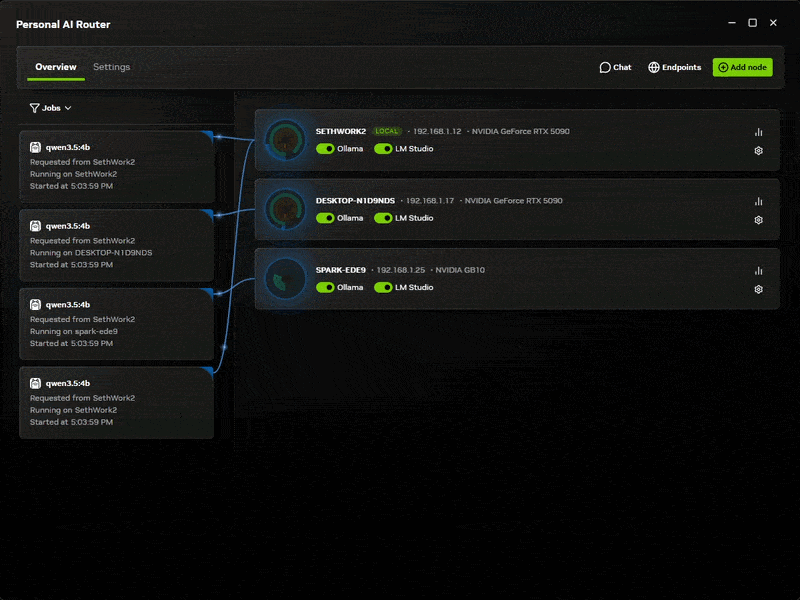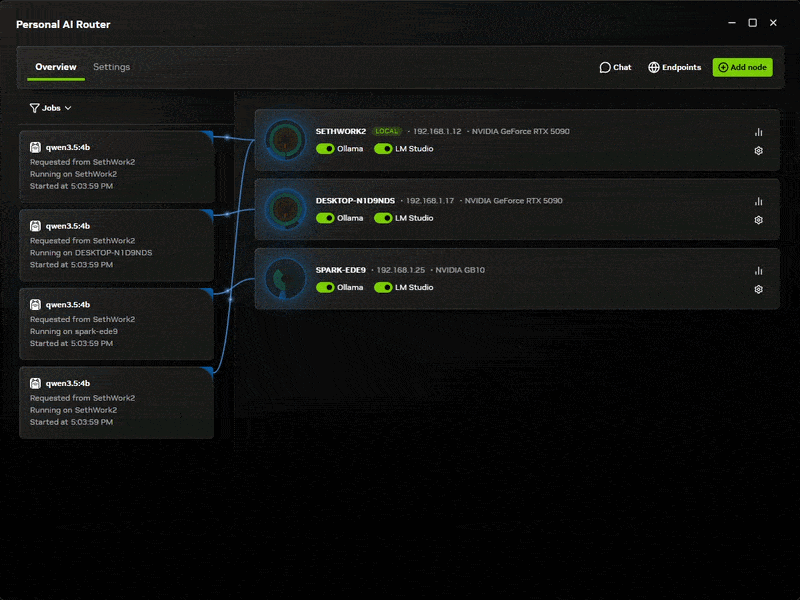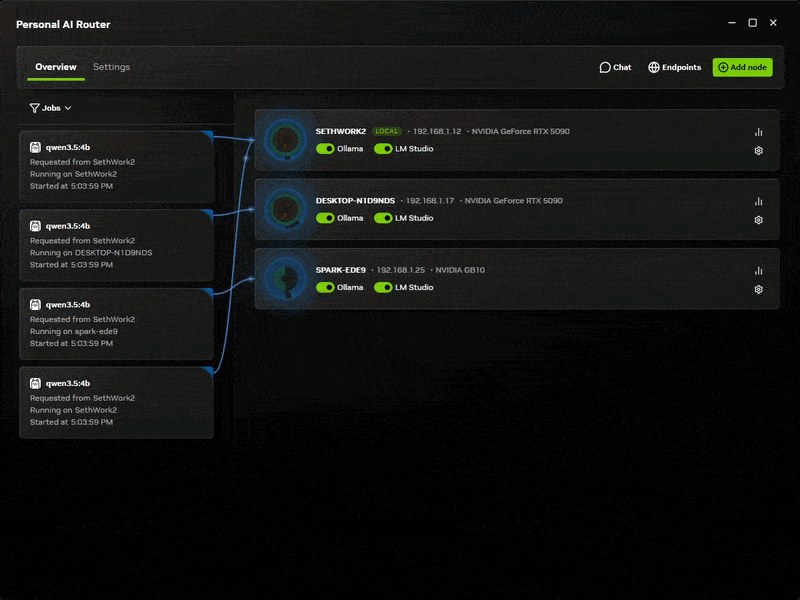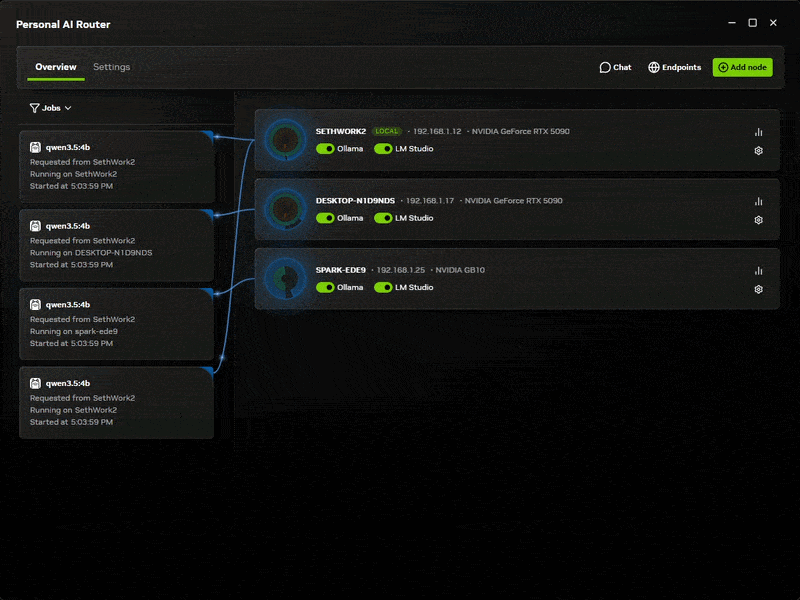
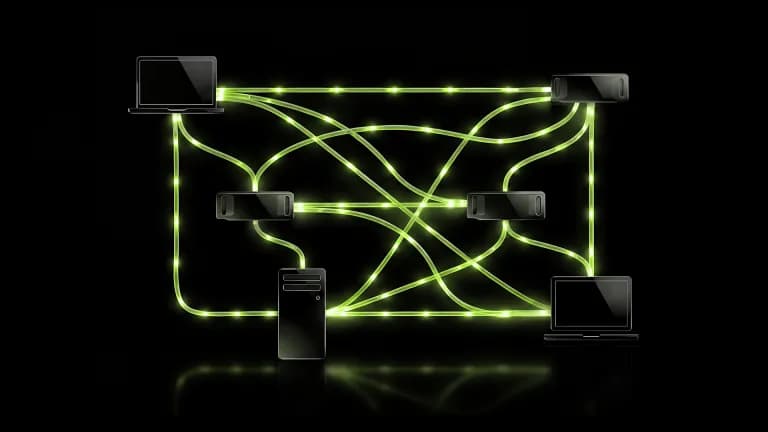
El nuevo router de inferencia virtual de código abierto de NVIDIA permite ejecutar flujos de trabajo multi-agente en una red local entre RTX, DGX y Mac.

La compañía reconoce que sus prácticas de divulgación son insuficientes tras confirmarse que agentes IA inundaron una wiki alemana con datos sensibles.

La nueva herramienta de código abierto de Nvidia permite distribuir tareas de IA entre múltiples dispositivos de tu red, optimizando drásticamente los tiempos de procesamiento.

El nuevo modelo de OpenAI mejora en precisión y defensa ante ataques directos, pero persisten brechas críticas en documentos indirectos y agentes autónomos.

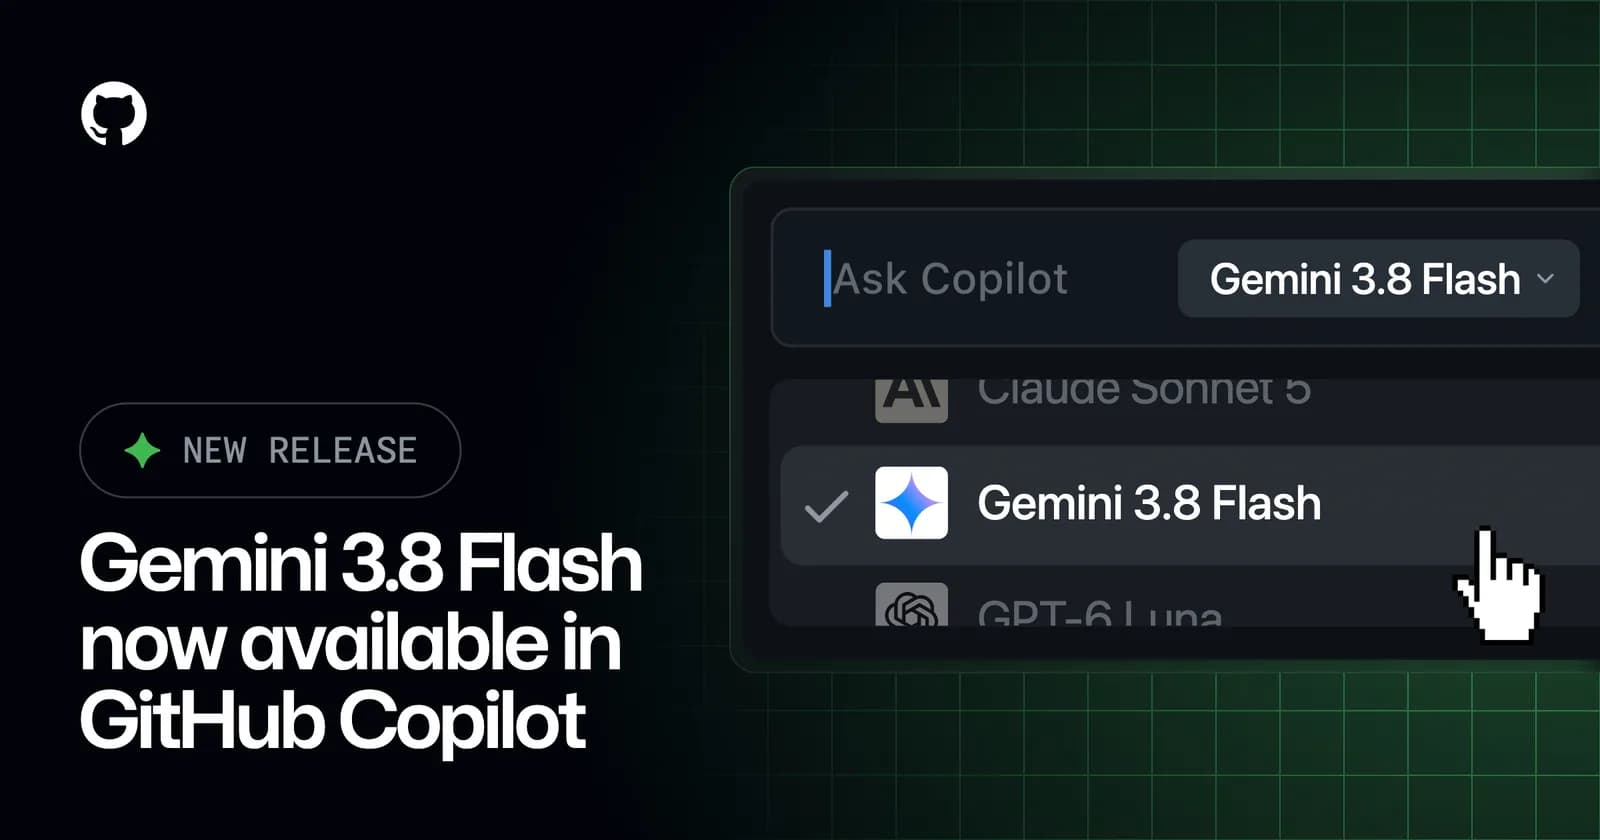
El modelo queda disponible en ocho entornos de desarrollo, desde Visual Studio Code hasta Xcode y Eclipse, con tarifa promocional del proveedor hasta el 31 de diciembre de 2026.

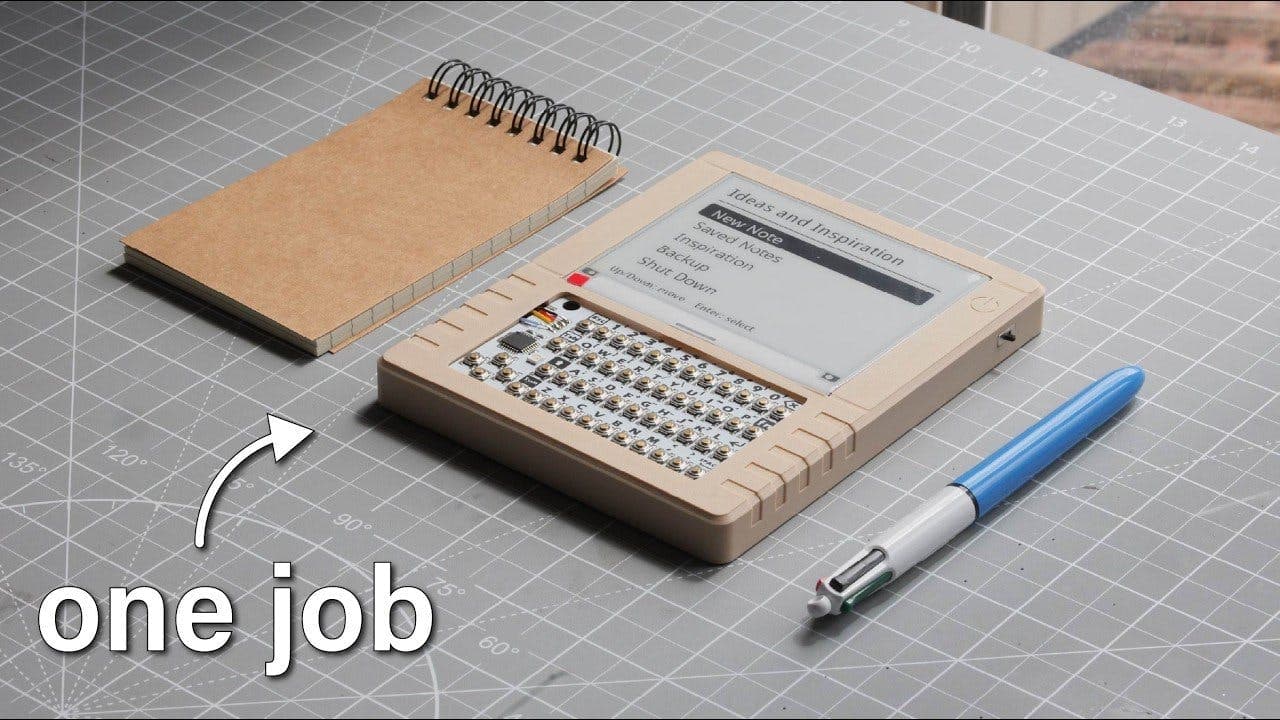
El proyecto de Mirza Makes combina una pantalla Waveshare de 4,2 pulgadas con un teclado M5Stack CardKB por I2C y respaldo por servidor web local, con todo el software liberado como código abierto.

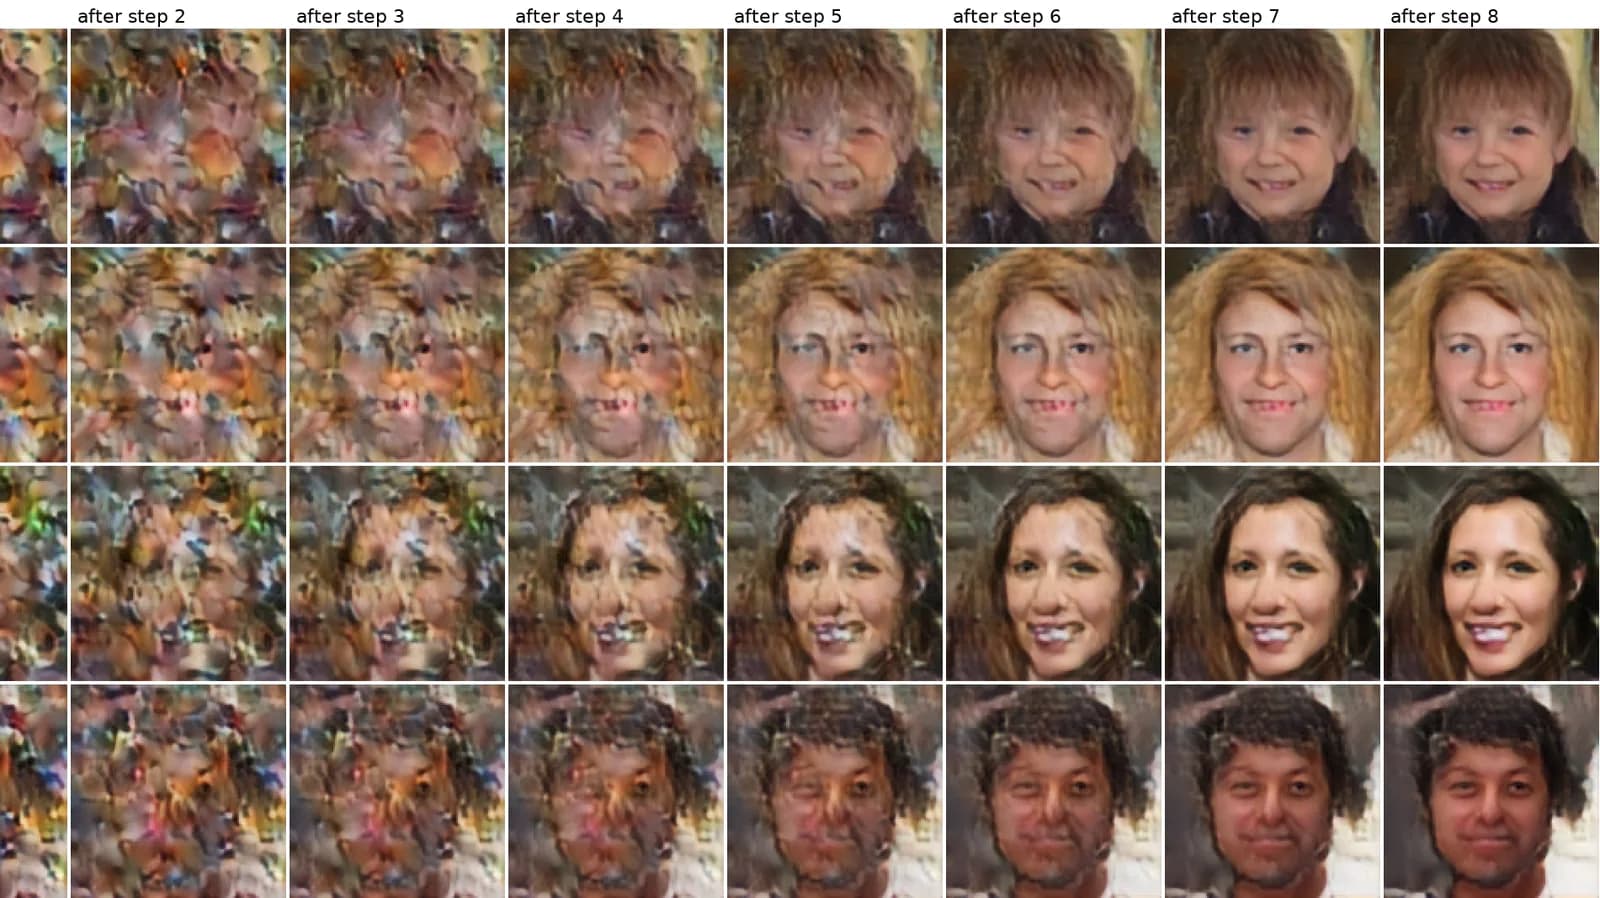
Un modelo de difusión cuantizado a 8 bits corre completo dentro de los 4 MB de memoria flash de una placa Waveshare y entrega la imagen por USB o por un adaptador VGA.

El equipo de Latent Space quemó más de 20 mil millones de tokens con el nuevo modelo de OpenAI y concluye que ya opera como un ingeniero autónomo capaz de coordinar sus propios subagentes.

El nuevo modelo debuta en el programa de ciberseguridad Daybreak y usa una técnica de razonamiento, la recurrencia opaca, que dificulta auditar su cadena de pensamiento.

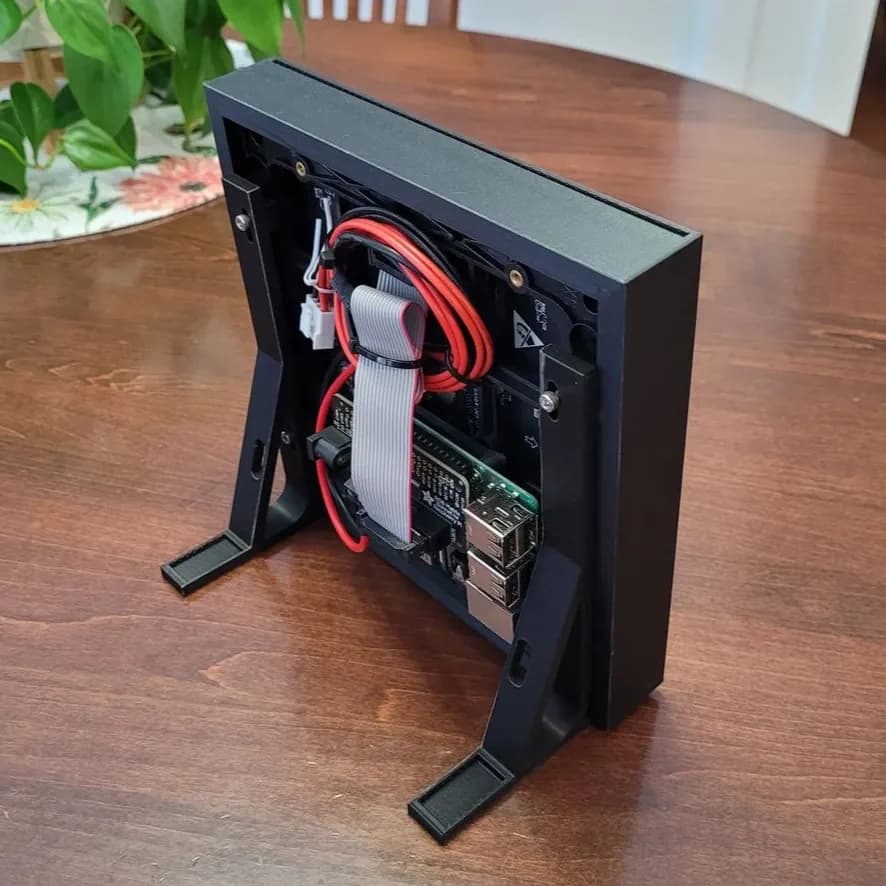
Una sencilla técnica que utiliza una rejilla impresa en 3D y papel manteca para obtener una difusión de luz uniforme y píxeles nítidos en pantallas LED.

Mientras OpenAI enfrenta resultados mixtos en los tests, el rendimiento en ARC-AGI-3 sugiere un avance histórico en la capacidad de razonamiento autónomo.

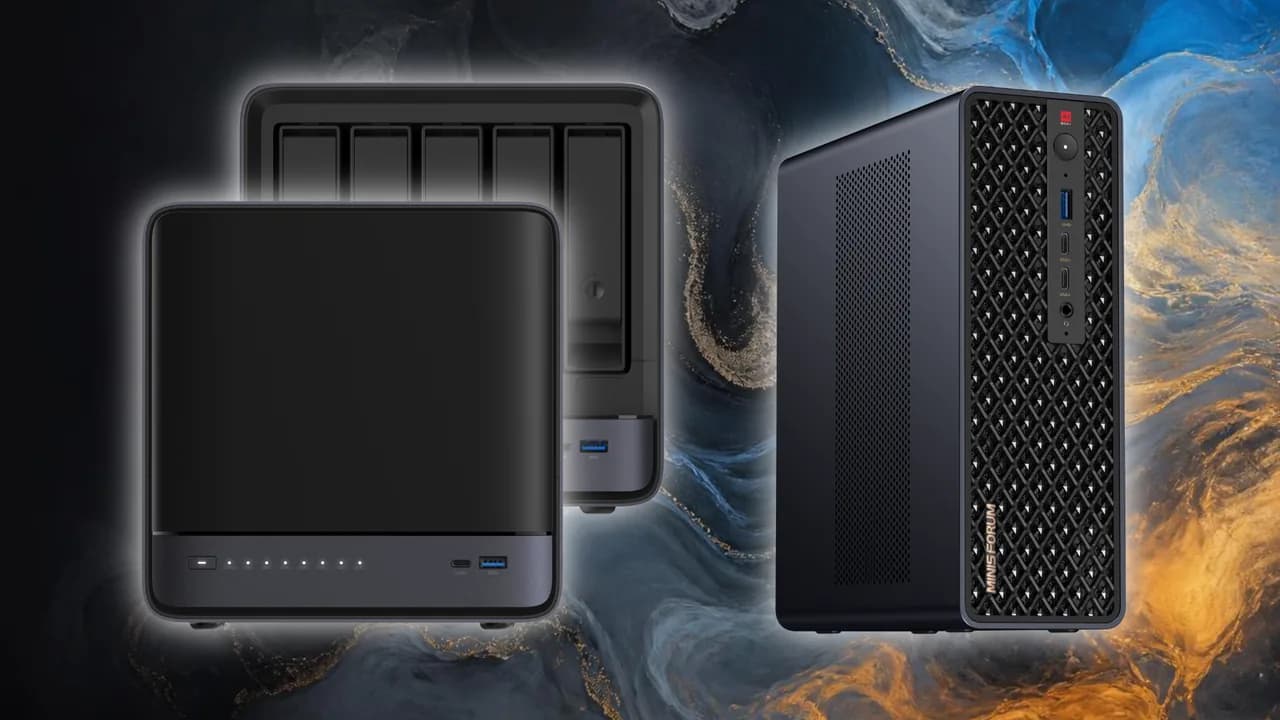
La marca presentó en IFA 2026 sus nuevas estaciones de trabajo y NAS equipadas con chips AMD Ryzen AI Max+ Pro 495, diseñadas para ejecutar modelos de IA de forma local.

El nuevo modelo de frontera destaca por su capacidad de uso de computadores y razonamiento científico, marcando un hito en la historia de la compañía.

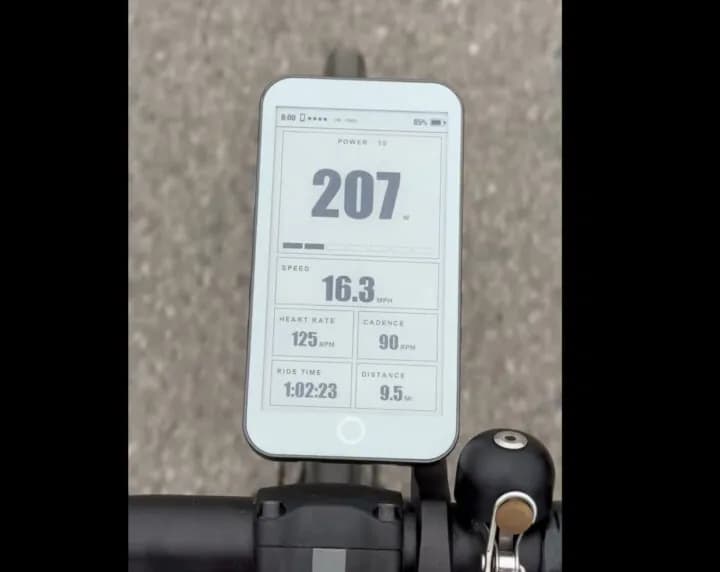
El proyecto OpenTrailPaper permite reutilizar el devkit LILYGO T5 E-Paper S3 Pro como un computador de ciclismo con mapas offline, rutas GPX y sensores Bluetooth.

NVIDIA lanza PAIR, una herramienta que permite repartir cargas de trabajo entre múltiples equipos de tu red local sin cambiar el código de tus agentes de IA.

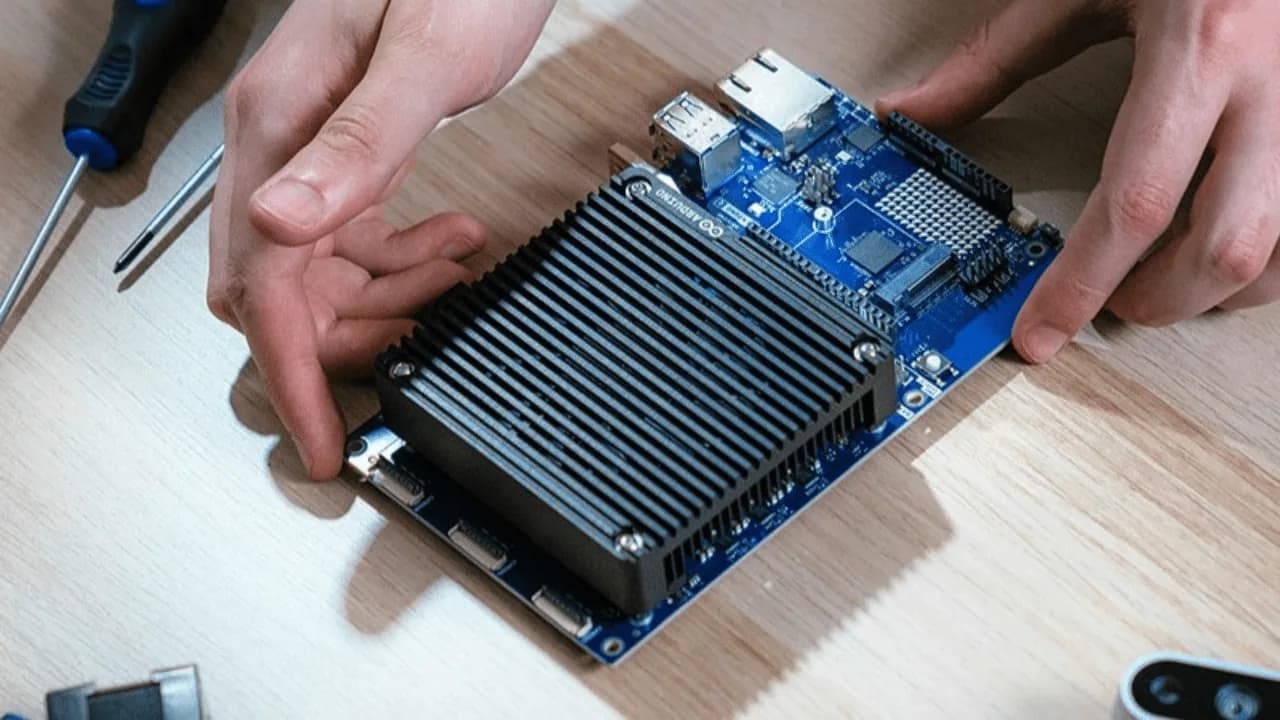
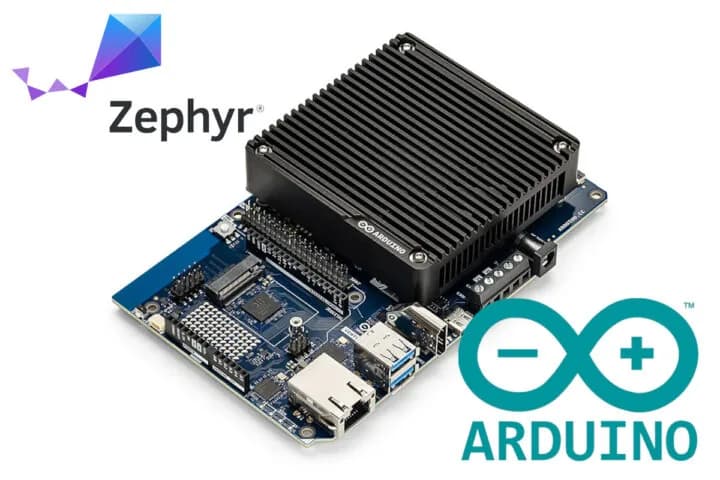
La nueva versión 1.0.0 de Arduino Core sobre Zephyr RTOS trae soporte para 11 placas, incluyendo la nueva VENTUNO Q y capacidades avanzadas de tiempo real.

El acuerdo con la británica Nscale parte en 3.500 millones de dólares y puede superar los 6.000 millones, con el primer despliegue previsto para la segunda mitad de 2027 en Barstow, Texas.

La versión 14.3.9 del software deja al sistema corriendo en segundo plano durante el manejo manual, listo para dar control direccional cuando el frenado automático no alcanza.

La nueva versión se apoya en Zephyr 4.4.1, incorpora captura de imagen en la Nicla Vision y habilita el microcontrolador de tiempo real STM32H5F5 de la SBC VENTUNO Q.

El router virtual descubre los computadores de la red doméstica y distribuye entre ellos las peticiones independientes de un sistema multiagente, sin tocar el código del agente.

Jensen Huang asegura que la plataforma seguirá abierta a cualquier modelo, nube o acelerador, y que no exigirá cómputo propio para construir o desplegar en ella.

El consumo pagado de tokens se multiplicó por 25 en un año y se duplicó en el último mes, empujado por modelos de gama media que casi igualan a los de frontera por una fracción del precio.