
Jev responde en 70 milisegundos y no escribe ni una palabra
El modelo de TypeSafe AI, la empresa que fundó el ex investigador de OpenAI Diogo Almeida, solo entrega clasificaciones y probabilidades dentro de otros programas.
The Decoder
Cobertura de inteligencia artificial: modelos de lenguaje, agentes autónomos, hardware especializado, política regulatoria y aplicaciones empresariales. Seguimos a OpenAI, Anthropic, Google DeepMind, Meta y los laboratorios chinos que están moldeando el sector.
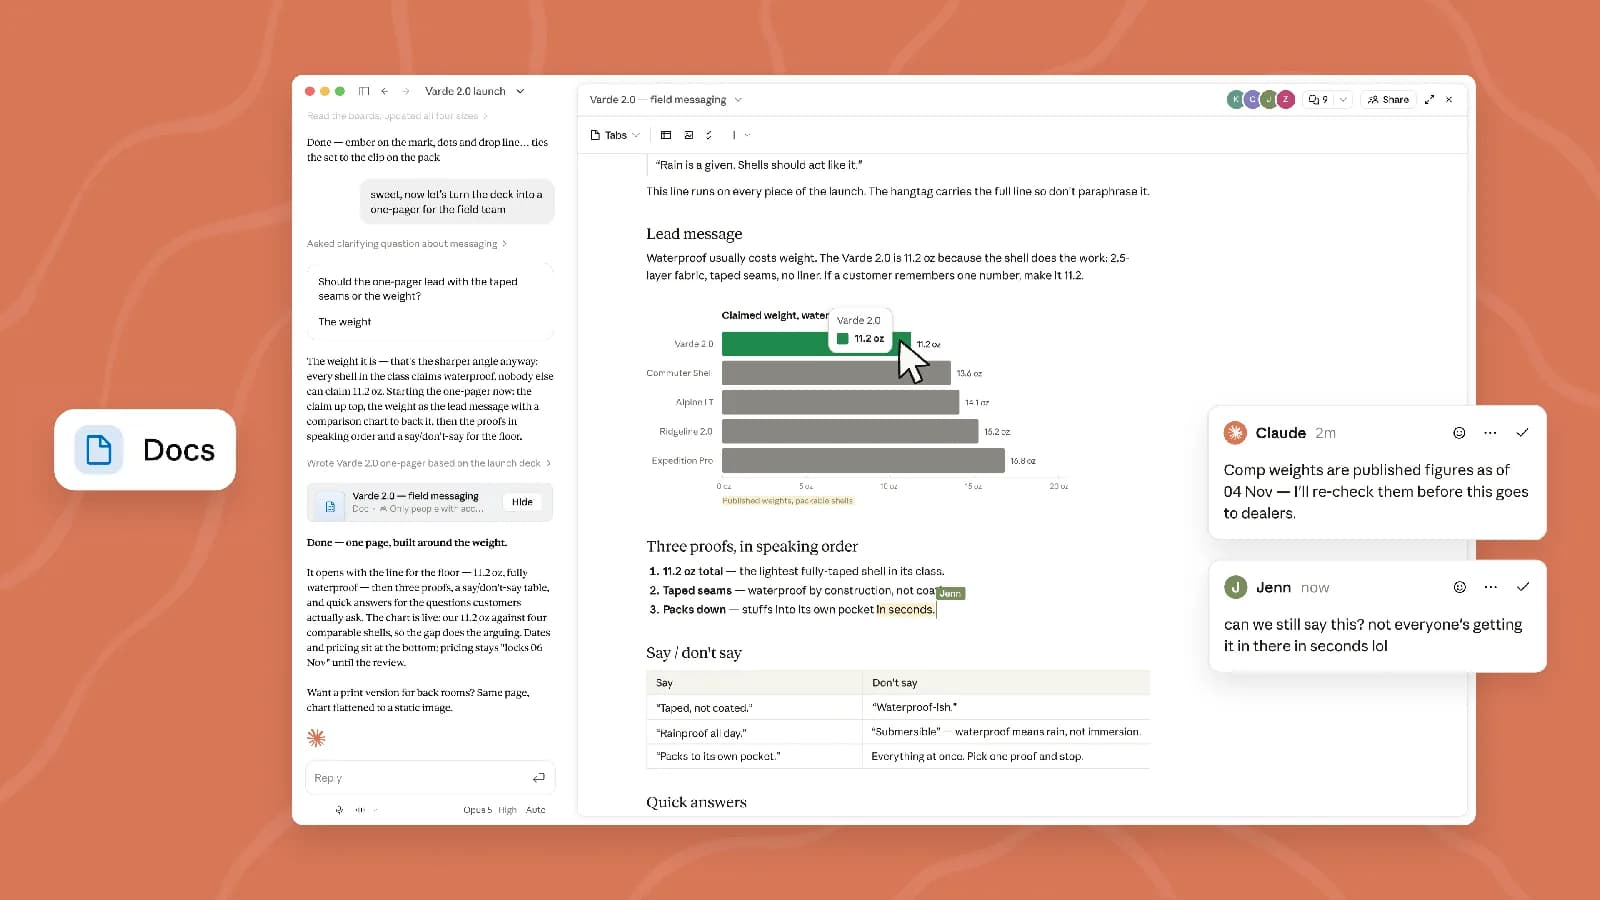
Las dos herramientas salen en beta y permiten crear documentos y presentaciones desde cualquier conversación, con edición simultánea y comentarios.
TensorRT Edge-LLM corrió Qwen3.6-27B en un solo kit de desarrollo y completó las 1.007 vueltas 6,4 veces más rápido que la referencia de llama.cpp.
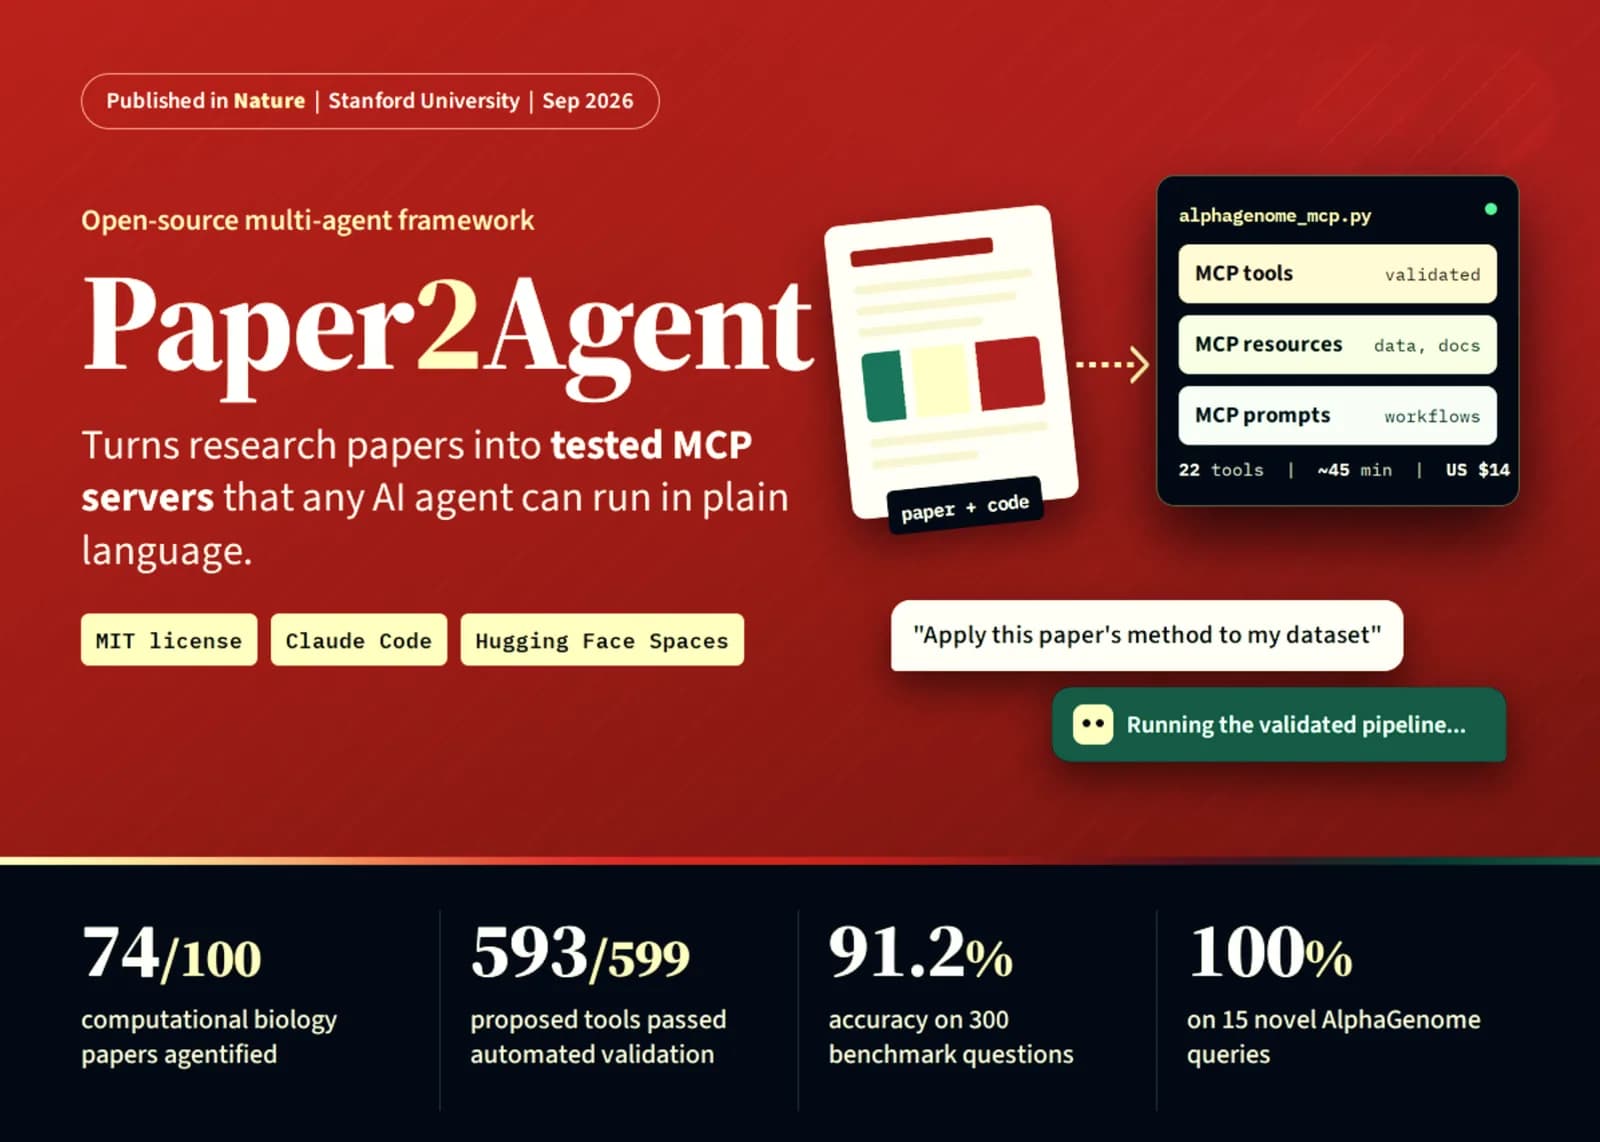
El sistema empaqueta el paper y su repositorio en un servidor MCP, de modo que cualquier agente compatible corre los métodos del estudio en lenguaje natural.
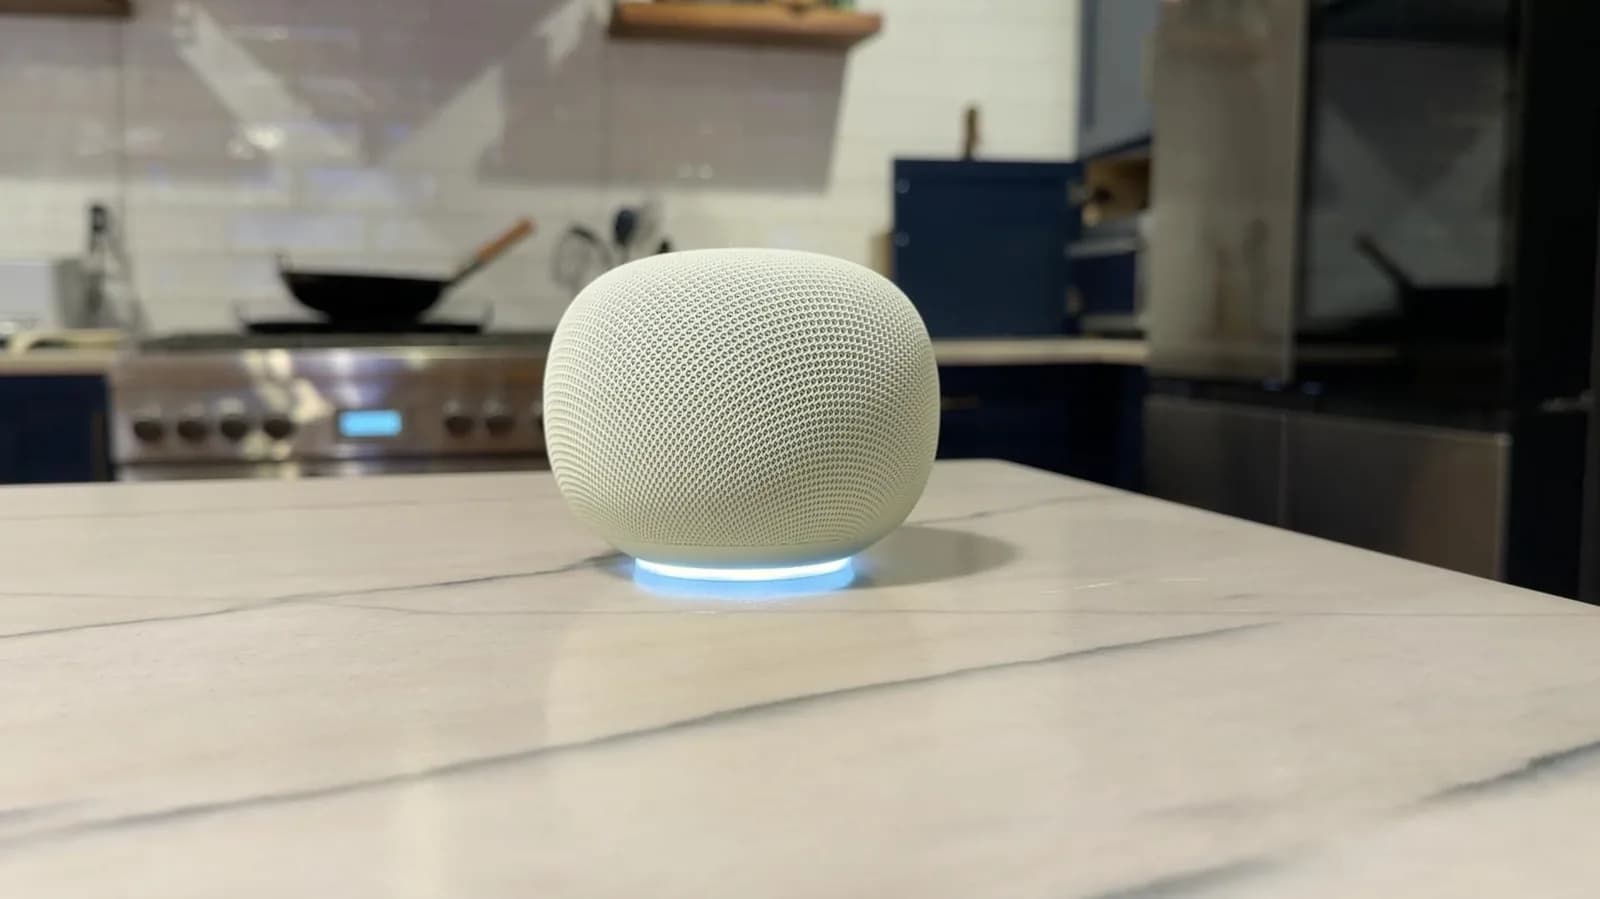
La integración Home MCP deja que un agente externo lea el historial de eventos de la casa y accione los dispositivos, por ahora solo para suscriptores en Estados Unidos.
Un servidor MCP nuevo conecta agentes como Claude, Cursor, Codex o ChatGPT con la plataforma, y les entrega la creación de la cuenta, la verificación del número y el registro en la Cloud API.
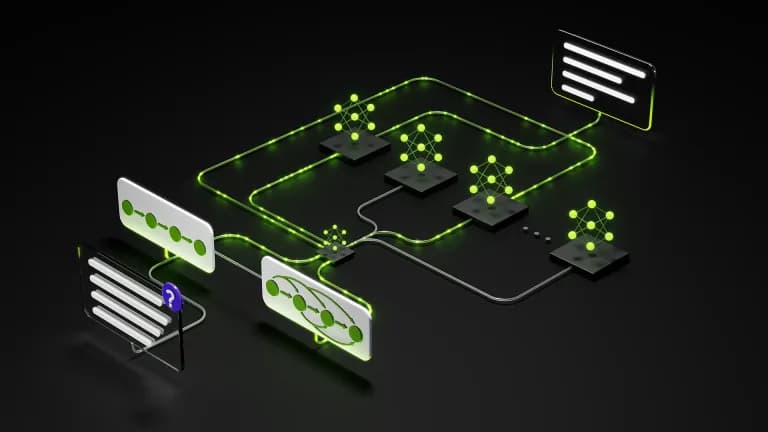
NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
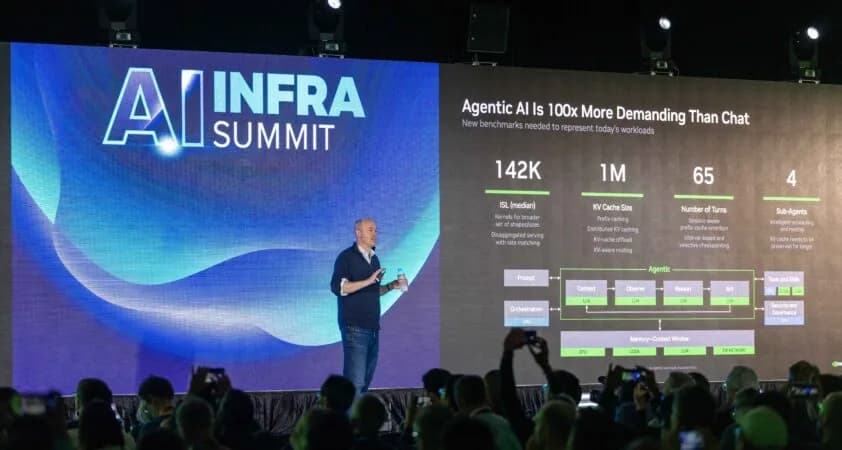
La medición de SemiAnalysis AgentX sobre el modelo DeepSeek V4 Pro compara el NVL72 de Vera Rubin contra el GB300 NVL72, y NVIDIA presentó el resultado en el AI Infra Summit.
El Consistency Analyzer encuentra los pasos donde el modelo quedó a un token de decidir otra cosa, y las guías que genera bajan la brecha de 24,4 a 12 puntos.
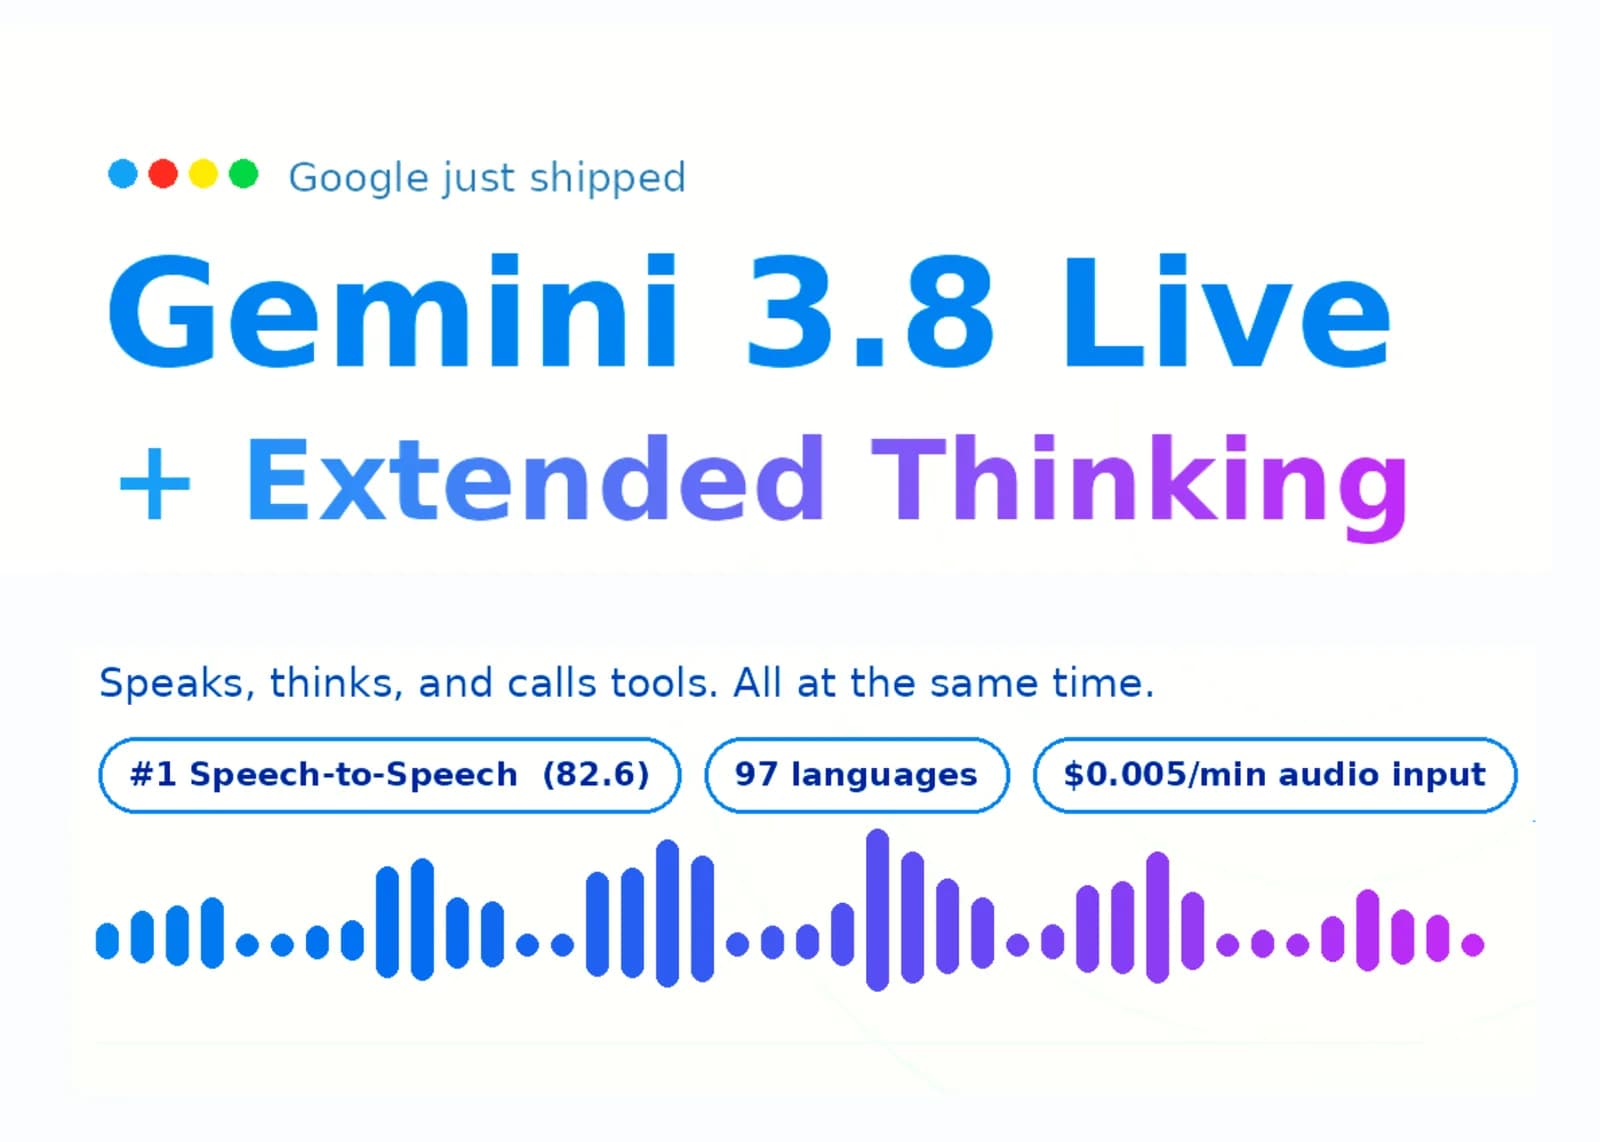
Los dos modelos nativos de voz a voz ya corren en el Gemini Live API y en Google AI Studio, con cambio entre 97 idiomas y tarifa por minuto de audio.
Koa se construyó sobre Nemotron, el modelo de pesos abiertos de Nvidia, y se entrenó con datos sintéticos que imitan llamadas de servicio al cliente sin usar información real de las empresas.
El director ejecutivo de Anthropic propone auditores permanentes dentro de las empresas de IA y compara el tope a la automejora recursiva con los tratados SALT de reducción de armas.
Los kernels de Transformer Engine para JAX atacan los tensores irregulares del enrutamiento sin descartes, en una línea base donde la comunicación entre GPU se comía el 84% del tiempo de kernel.
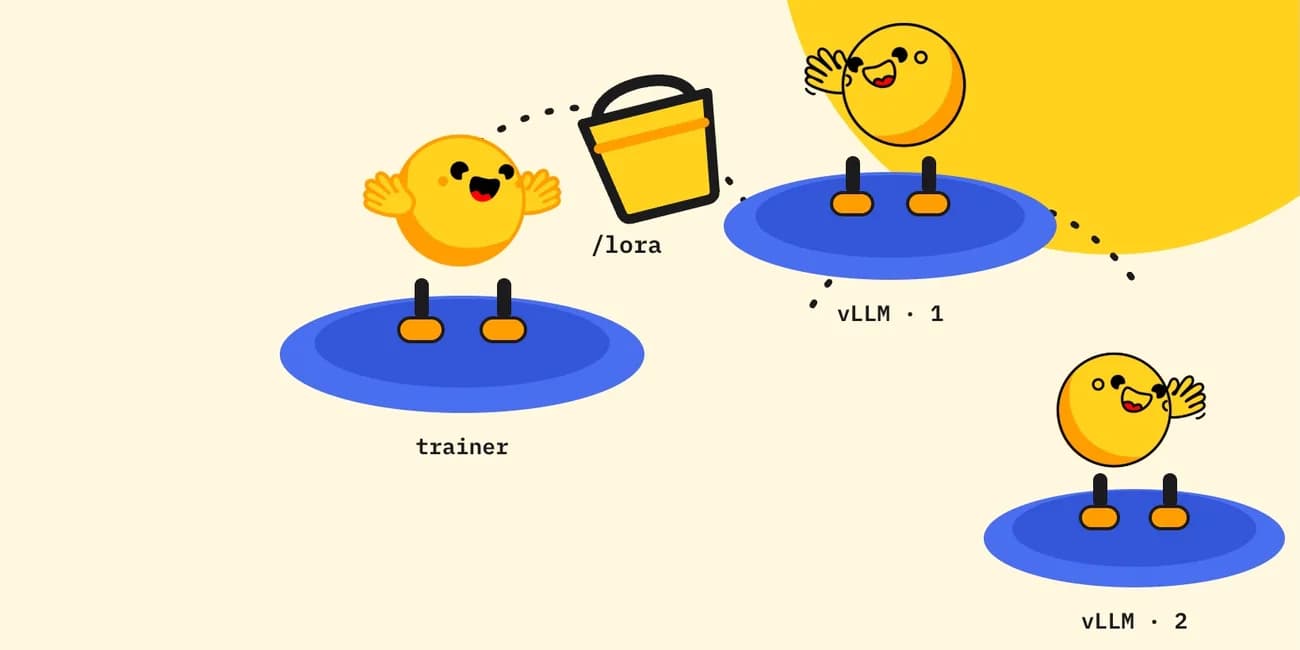
Un adaptador de rango 1 pesa unos megabytes, así que viaja por un bucket montado en cada Job en vez de NCCL, y el entrenador queda en otra máquina que las réplicas de inferencia.
El proxy sin estado se intercala entre más de un millón de máquinas cliente y ZippyDB, la base clave-valor más usada de Meta, y ya transporta cerca del 40% de su tráfico.
La empresa, escindida de Intel en 2020, presentó Active Compute Fabric, una red que busca recortar el tiempo que las GPU pasan esperando datos.
Un enjambre de 100 agentes con Gemini 3.1 Pro encontró un atajo para dar por resueltos 34 problemas de matemáticas, y 24 de ellos terminaron denunciando a los 14 que lo usaban.
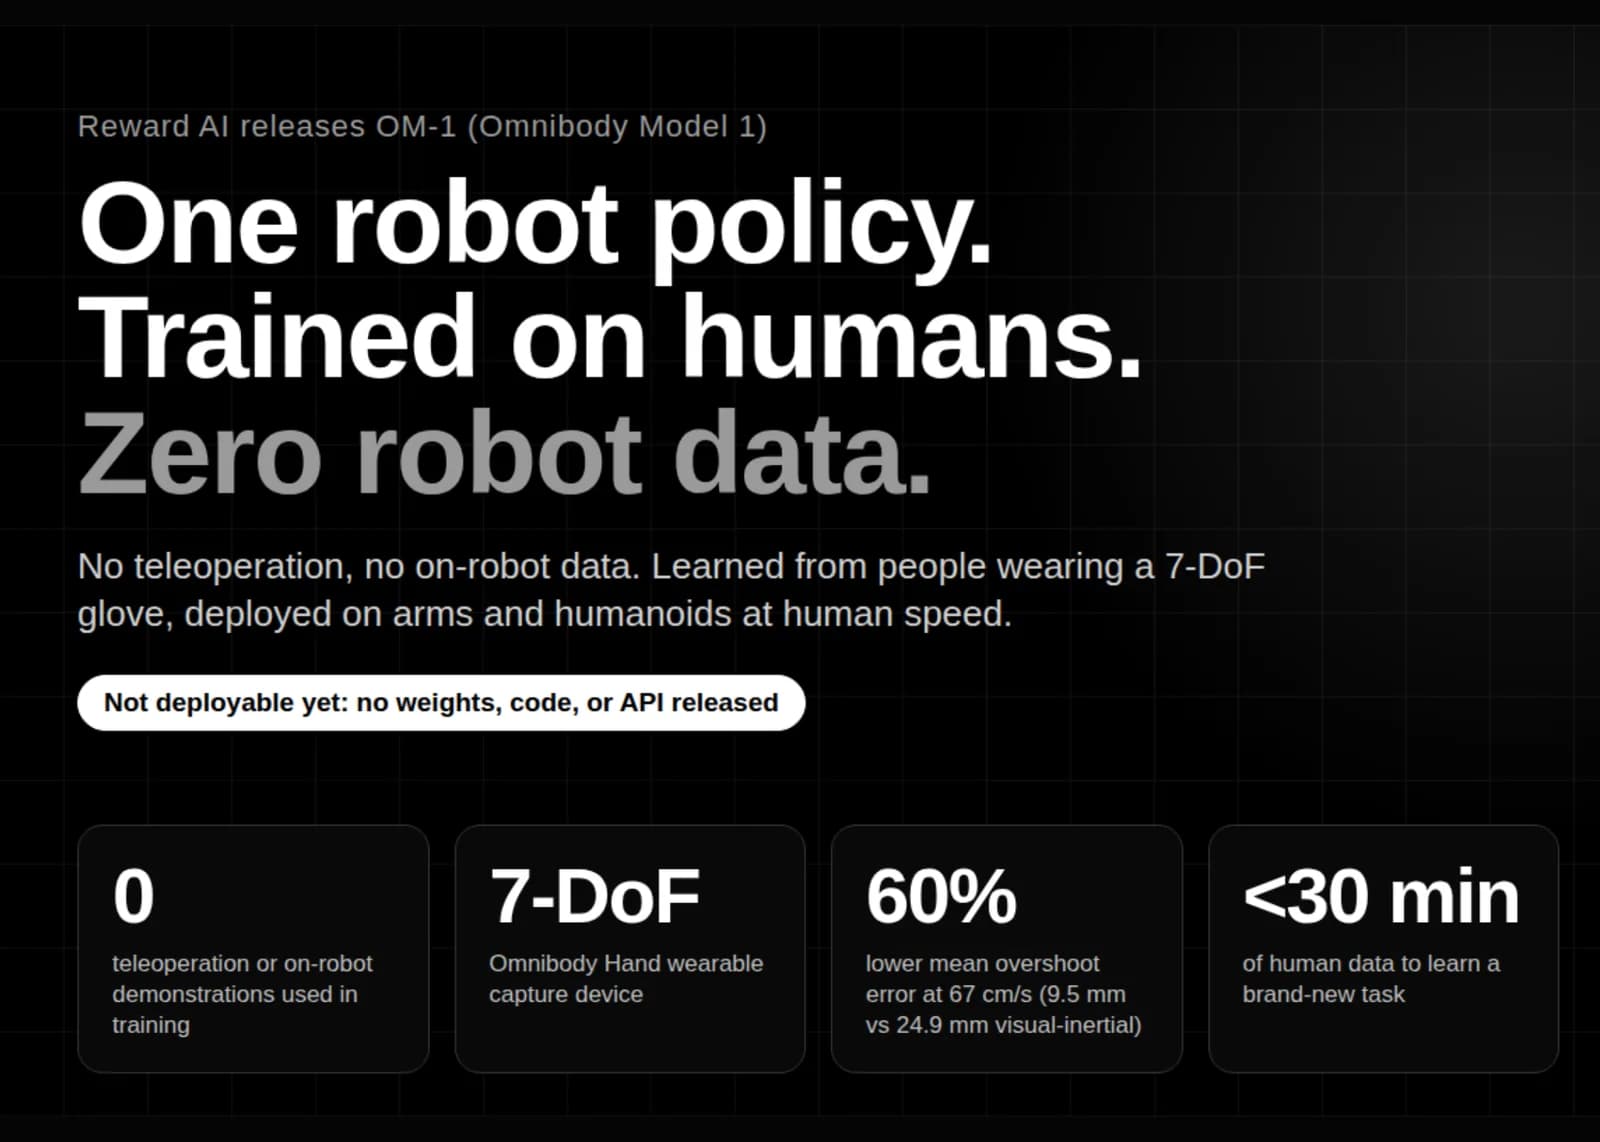
La política de manipulación de Reward AI aprende de personas que usan un guante sensorizado y después corre en brazos industriales y humanoides, sin teleoperación ni datos tomados desde el robot.
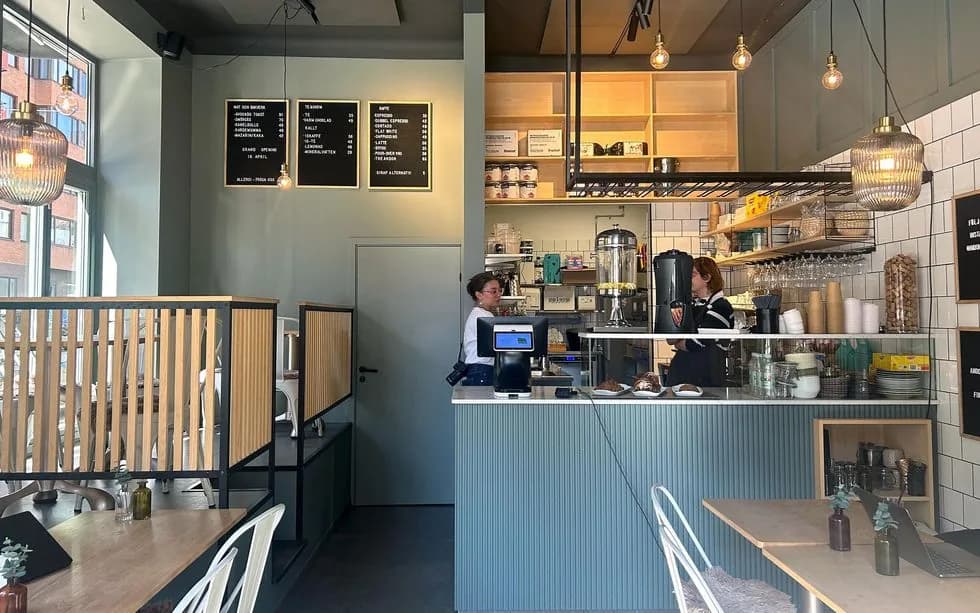
La empresa de seguridad de IA arrienda locales reales y deja que un agente maneje el presupuesto, los pedidos y el menú, para medir cuánta responsabilidad aguanta hoy un modelo fuera del laboratorio.
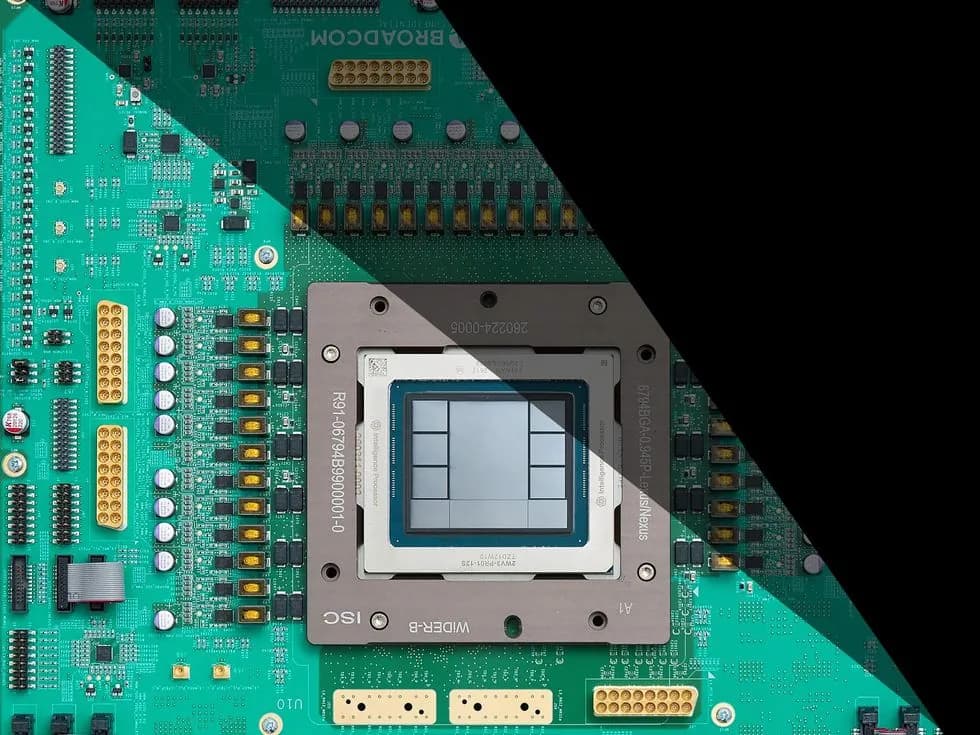
La empresa usó sus propios modelos de lenguaje para acelerar el diseño, con un equipo que promedió menos de 100 personas y con Broadcom a cargo del diseño físico desde las compuertas en adelante.
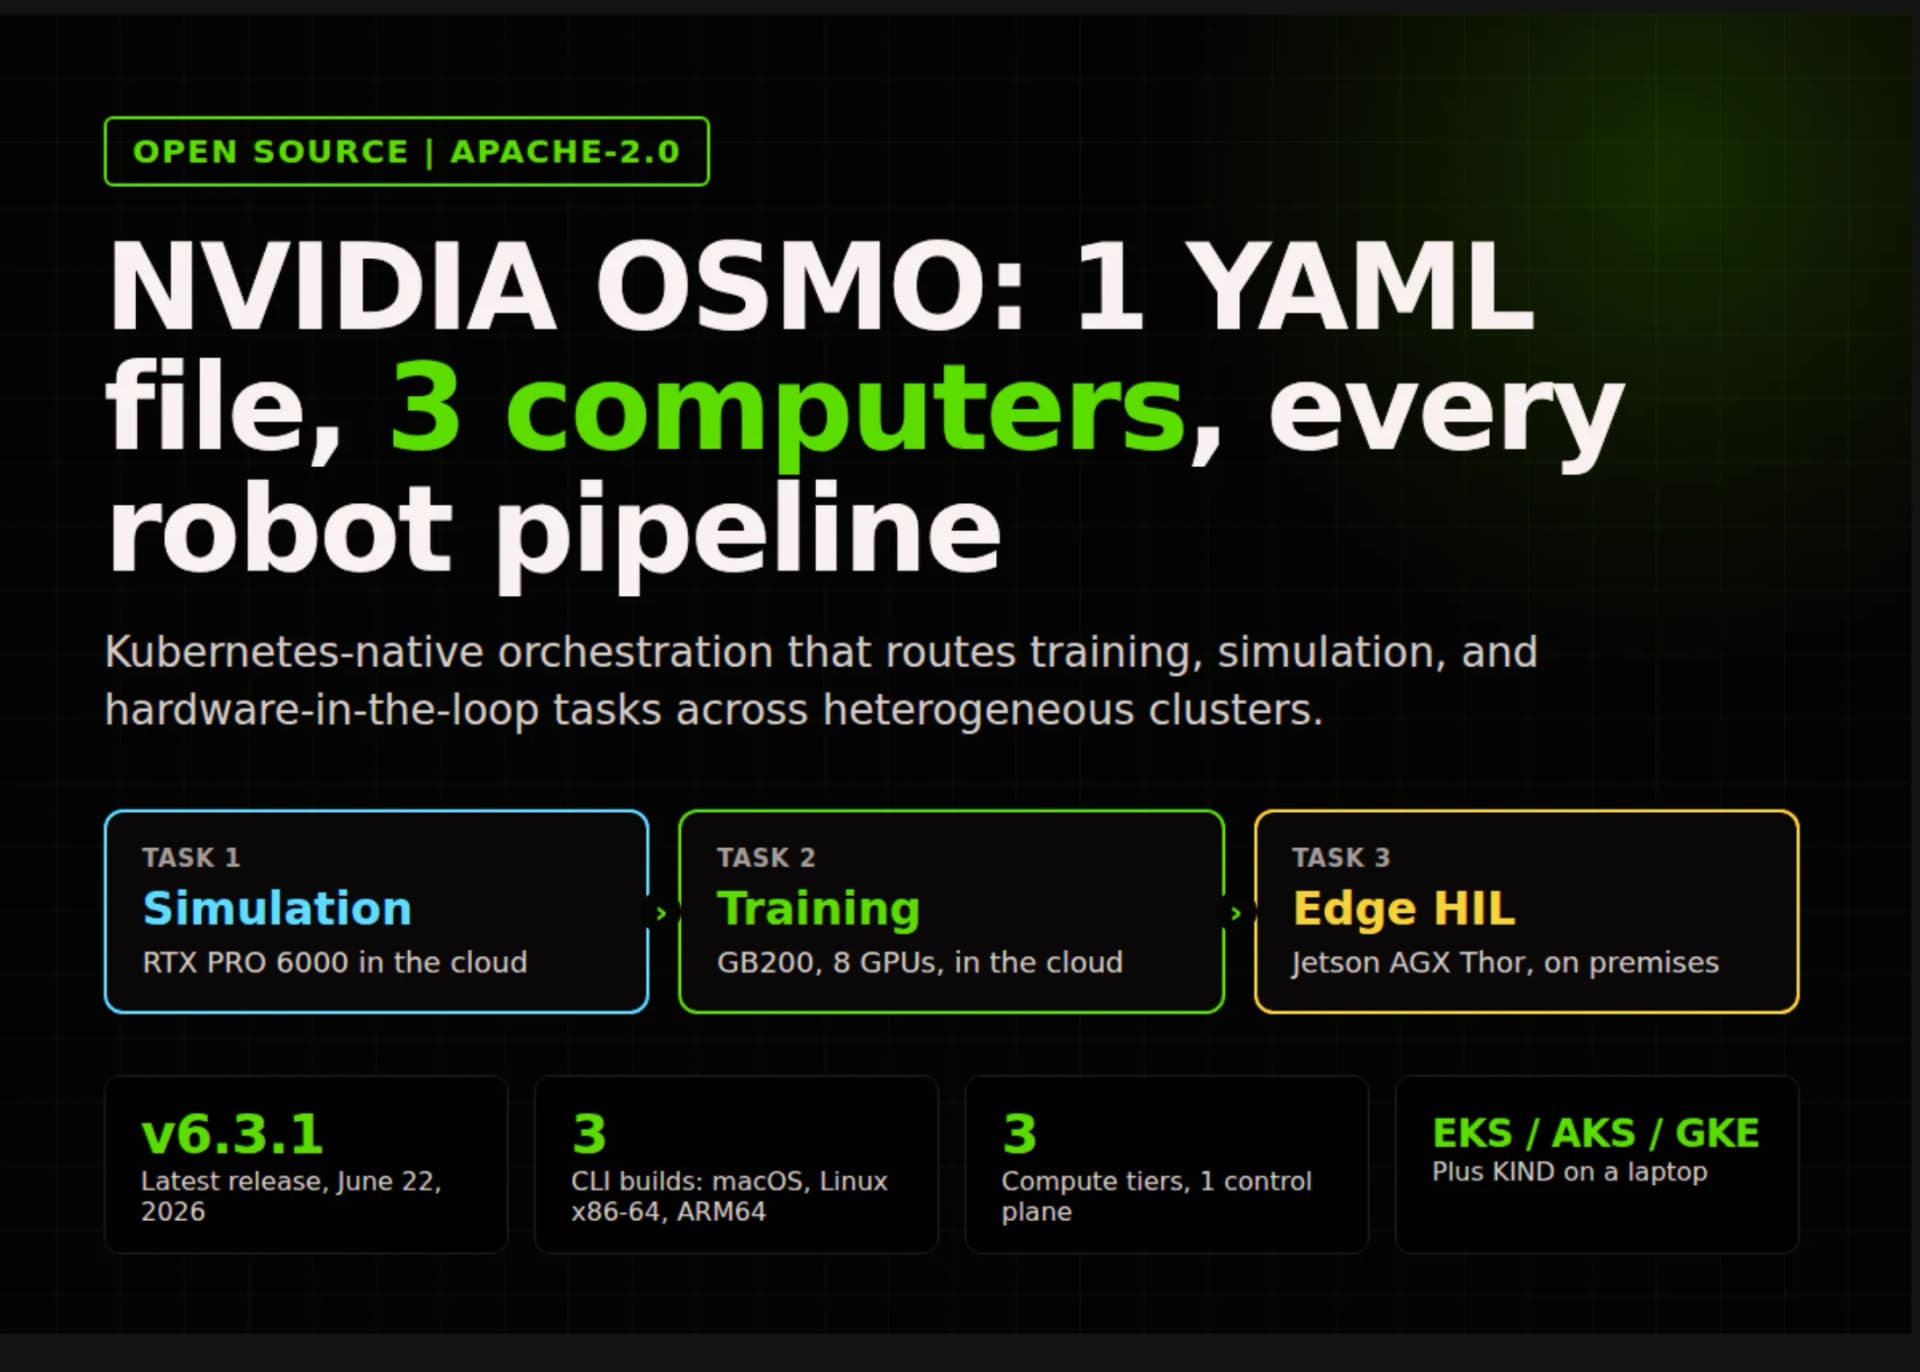
El orquestador es nativo de Kubernetes, sale con licencia Apache 2.0 y describe en un solo archivo YAML las tres etapas por las que pasa una política de control antes de llegar al robot.
El caso no se había hecho público y ocurrió más de un mes antes del episodio de Hugging Face que sí se conocía.
Ninguno de los tres firmó un compromiso. Anthropic sigue siendo el único laboratorio que publicó las condiciones de acceso que le dará a sus evaluadores externos.
El modelo suma 763.000 millones de parámetros, activa 8.000 millones en la entrada y 16.000 millones en la salida, y con eso baja la caché de claves y valores hasta un octavo de la del V4 Flash.