Un proyecto de código abierto con ESP32-S3 corre un asistente de tareas que escucha, responde y habla sin IA en la nube.
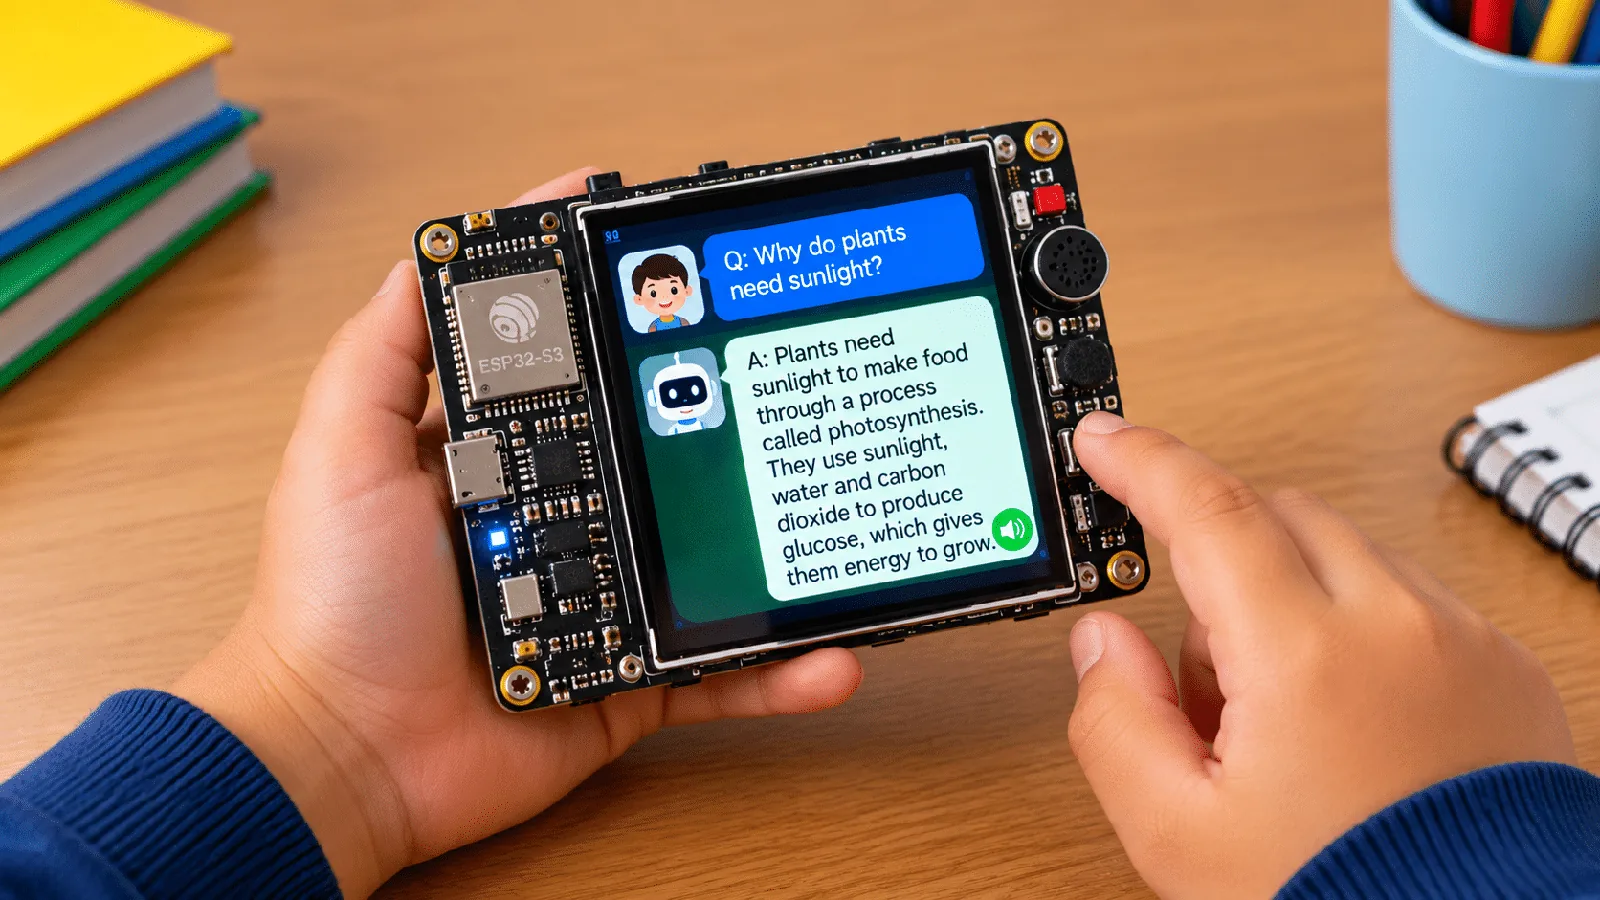
Una sola placa ESP32-S3 puede escuchar una pregunta, procesarla con un modelo de lenguaje que corre en el propio dispositivo y decir la respuesta en voz alta, sin mandar grabaciones de voz a un servidor en la nube. El proyecto se llama Ivy AI y es de código abierto. Junta reconocimiento de voz, un detector de palabra de activación, un modelo de lenguaje compacto y síntesis de voz en una placa con microcontrolador, pantalla, micrófono y parlante. Su desarrollador lo diseñó como un asistente de voz sin conexión para preguntas simples, incluidas las del aprendizaje escolar de niños.
¿En qué placa corre Ivy AI?
El proyecto usa la Freenove FNK0104B, que combina un microcontrolador ESP32-S3R8 con 8 MB de PSRAM y 16 MB de memoria flash. La placa integra además una pantalla LCD de 2,4 pulgadas y 240×320 píxeles, un controlador táctil, el códec de audio ES8311, micrófono, parlante, ranura microSD y un circuito de carga para batería de litio. Trae todo el hardware que necesita un asistente de voz autónomo, sin una Raspberry Pi ni un computador externo que procese las preguntas.
¿Cómo procesa una pregunta?
La cadena parte con WakeNet9, el detector de palabra de activación de Espressif, que espera la frase "Hey Ivy". Un motor de reconocimiento de voz basado en Conformer con clasificación temporal conexionista (CTC) convierte la pregunta hablada en texto. Después un modelo de lenguaje pequeño genera la respuesta, y SVOX Pico la convierte en audio. El proyecto usa el entorno de desarrollo ESP-IDF de Espressif y está escrito en C, no sobre el framework de Arduino.
El modelo de lenguaje es la parte más exigente. El modelo por defecto, TinyTalk 2 8M v8, figura con unos 19,7 millones de parámetros y ocupa cerca de 6,5 MB cuantizado. El modelo de reconocimiento de voz pide unos 5,4 MB, así que los dos no caben juntos en los 8 MB de PSRAM de la placa. Ivy lo resuelve reservando memoria por etapa y cargando el modelo que corresponde cuando cada etapa empieza. El reconocimiento de voz y la generación de texto se turnan la memoria disponible.
¿Qué tan rápido responde?
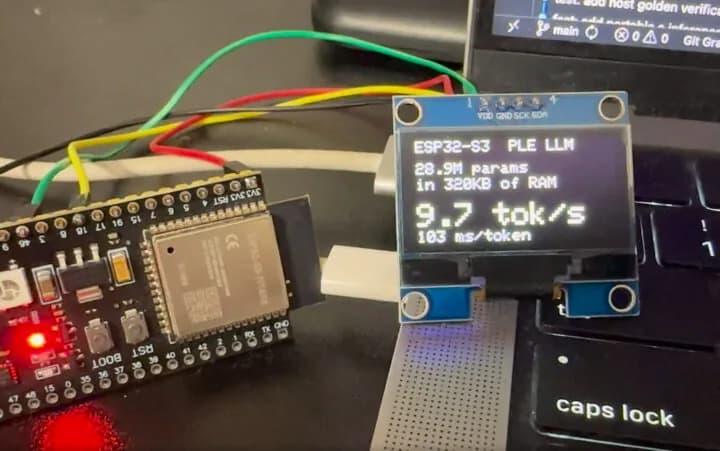
Según el desarrollador, el modelo por defecto tarda unos 694 milisegundos en cargar y genera texto a unos 5,4 a 5,9 tokens por segundo. Uno más chico, de 6,4 millones de parámetros, llega a unos 7,3 tokens por segundo, y otro mucho menor, de unos 260.000 parámetros, alcanza 30 tokens por segundo. Las cifras muestran cómo pesa el tamaño del modelo en un microcontrolador con poca memoria, aunque la velocidad de generación no dice nada sobre la calidad o la exactitud de la respuesta.
| Modelo | Parámetros | Velocidad de generación |
|---|---|---|
| TinyTalk 2 8M v8 (por defecto) | 19,7 millones | 5,4 a 5,9 tokens/s |
| Modelo intermedio | 6,4 millones | 7,3 tokens/s |
| Modelo mínimo | 260.000 | 30 tokens/s |
El reconocimiento de voz sigue siendo el cuello de botella. Según las mediciones del proyecto, transcribir entre 1,4 y 2,9 segundos de habla toma de 2,7 a 4,6 segundos. El desarrollador calcula que una interacción hablada completa dura entre 14 y 17 segundos, contando la escucha, la transcripción, la carga del modelo, la generación de la respuesta y la síntesis de voz. El detector de palabra de activación y la detección de actividad de voz también tienen límites, y esta última a veces corta la sílaba final de la pregunta.
Modelos propios desde la microSD
Ivy también puede correr modelos de lenguaje pequeños en formato GGUF guardados en la tarjeta microSD. El repositorio documenta cómo cargarlos y trae herramientas para pasar los archivos de modelo a la placa. Pero la compatibilidad depende de la arquitectura, el vocabulario y la memoria que pida cada modelo, y no se puede suponer que cualquier modelo pequeño va a funcionar solo porque esté en GGUF.
Licencias por componente
El proyecto tiene licencia GPL-3.0 o posterior, pero esa licencia no cubre automáticamente cada componente o modelo incluido. El motor de reconocimiento de voz, sus pesos, el motor de síntesis de voz, el motor del modelo de lenguaje y los pesos del modelo tienen condiciones propias. El desarrollador advierte de forma explícita que algunos pesos de modelos de lenguaje heredan restricciones no comerciales de sus datos de entrenamiento. Quien quiera adaptar Ivy para un producto comercial tiene que revisar cada licencia por separado y no quedarse con la licencia principal del repositorio.
Lo que todavía no hace
El sistema no reemplaza a un asistente de IA de uso general. Su modelo de lenguaje pequeño tiene capacidades limitadas, y la evaluación del propio desarrollador muestra una diferencia grande entre las preguntas formuladas como aparecían en el entrenamiento y otras formas de preguntar lo mismo. La velocidad del reconocimiento de voz, el soporte solo para inglés y los errores ocasionales de transcripción también lo dejan corto para una conversación libre. Hoy es un proyecto experimental de IA embebida, no un producto educativo terminado.
La versión actual usa inglés estadounidense y un temario con geografía de Estados Unidos. Adaptarla a programas escolares de otros países o a otros idiomas exige cambiar el modelo de lenguaje, el reconocimiento de voz y la salida de audio, y probar todo de nuevo en el hardware final.
El código está disponible en el repositorio del proyecto en GitHub.