Anthropic dijo que sus nuevas defensas contra la destilación a escala industrial redujeron entre 90% y 99% el volumen de tokens de razonamiento extraídos de sus modelos Claude. Los tokens de razonamiento son los pasos internos de la cadena de pensamiento del modelo. The Decoder recogió el anuncio el 13 de octubre.
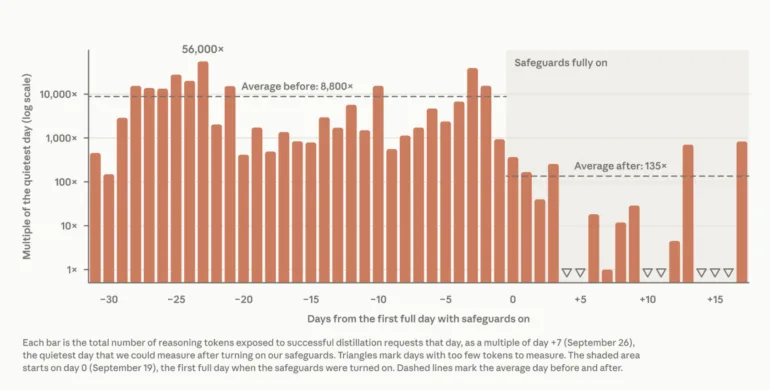
En un ataque de destilación, una empresa copia de forma sistemática las capacidades de un modelo de IA para entrenar uno propio, más pequeño. Según Anthropic, los atacantes montan la operación con redes de cientos de miles de cuentas falsas. Un gráfico publicado por la compañía muestra que los intentos de destilación exitosos cayeron con fuerza después de activar las defensas.
¿A quién acusa Anthropic?
Anthropic nombra a las empresas chinas Zhipu y Moonshot como participantes.
- Zhipu habría extraído capacidades de ciberseguridad de los principales modelos estadounidenses para su modelo GLM-5.3.
- Moonshot habría enrutado en secreto consultas a través de Claude.
La empresa advierte que las capacidades robadas podrían terminar en sistemas militares y de vigilancia de otros países.
El caso no es nuevo para Anthropic. En su informe de amenazas de septiembre, la compañía ya había acusado a seis desarrolladores chinos, Moonshot entre ellos, de extraer miles de millones de tokens de modelos estadounidenses durante dos años.
¿Cómo funcionan las defensas?
Anthropic aplica tres medidas:
- Restringe el acceso a los pasos internos de razonamiento de Claude.
- Usa un clasificador que detecta intentos de extracción.
- Bloquea de forma automática las cuentas marcadas por ese clasificador.
Ya se bloquearon decenas de miles de cuentas. La empresa pide a otros desarrolladores de IA adoptar protecciones parecidas, aunque admite que en el proceso también caen usuarios legítimos.