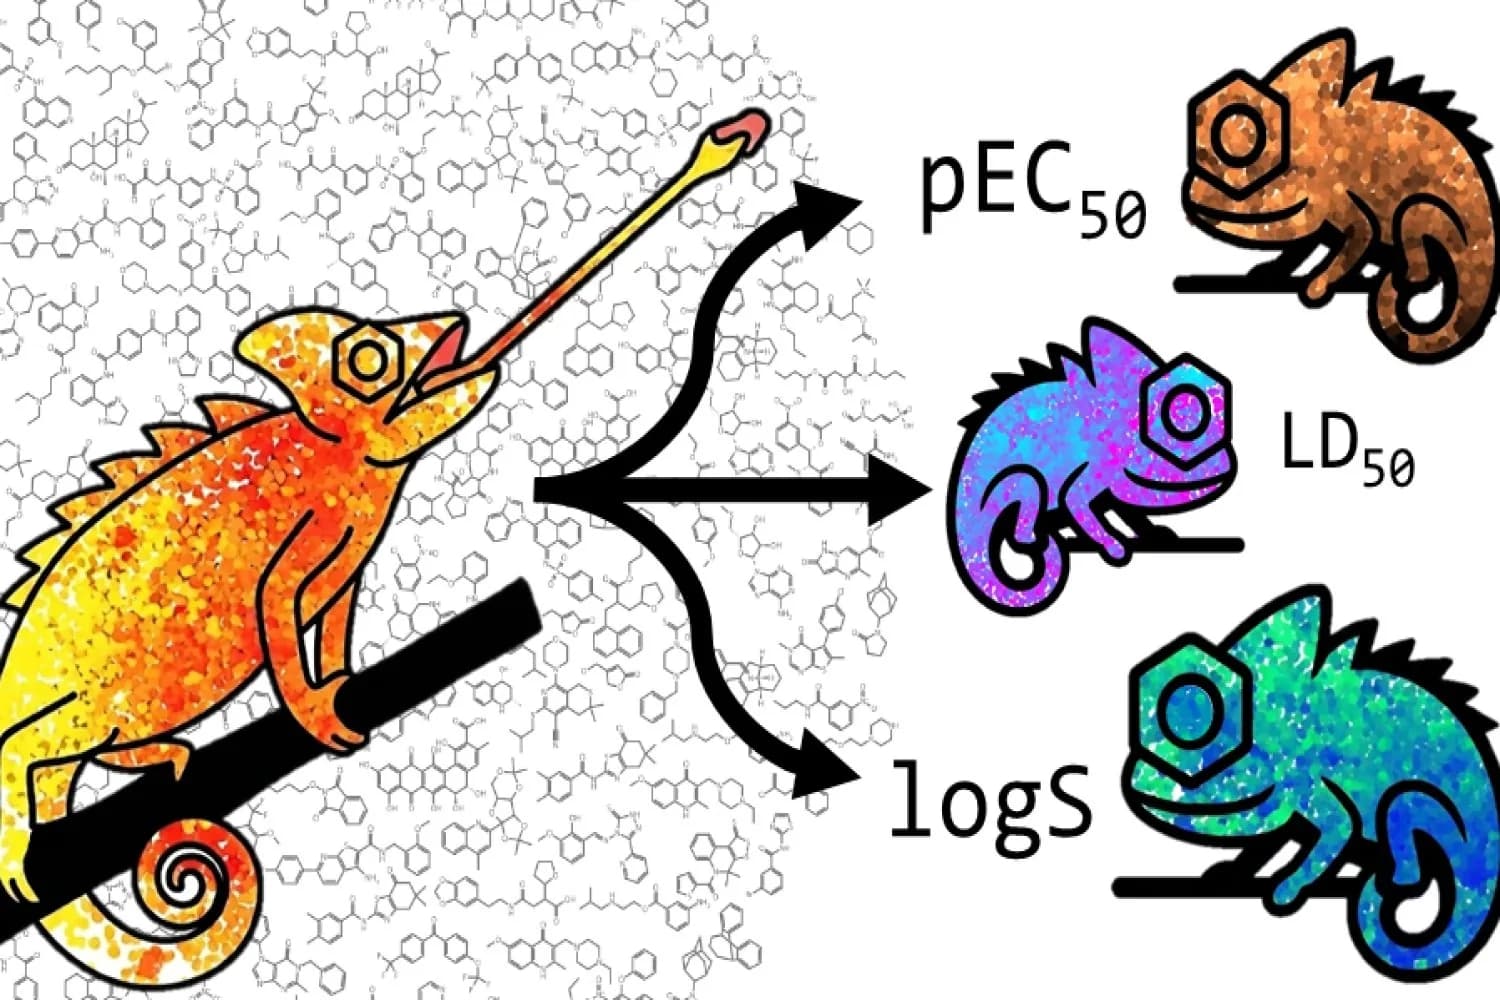
Investigadores del MIT desarrollaron CheMeleon, un modelo de aprendizaje automático de código abierto que predice cómo se comportará una molécula cuando casi no hay datos experimentales sobre la propiedad que interesa. El trabajo salió en la edición del 14 de septiembre del Journal of Chemical Information and Modeling.
Descubrir moléculas nuevas para usos específicos mueve el progreso en muchas industrias, desde las farmacéuticas que buscan fármacos hasta las empresas de electrónica o energía que necesitan materiales con propiedades particulares. Sigue siendo, en gran parte, un proceso de ensayo y error, porque todavía no existe una forma de predecir con exactitud cómo responderá un compuesto químico frente a la enorme variedad de propiedades que puede tener un material.
La inteligencia artificial y el aprendizaje automático ya se usan para complementar o acelerar los cálculos basados en principios físicos, que entregan una primera orientación sobre qué compuestos vale la pena sintetizar y probar. El método del MIT apunta al caso en que hay pocos datos sobre una propiedad de interés tecnológico, como la afinidad de ligandos por un blanco celular recién descubierto para un posible fármaco. En ese escenario, según el equipo, supera a los métodos existentes para acotar la lista de moléculas candidatas.
¿Quién está detrás de CheMeleon?
Los resultados los firman el estudiante de posgrado del MIT Akshat Shirish Zalte, el recién doctorado Jackson Burns, el científico investigador Charlles Abreu, el profesor William Green y tres investigadores de la química alemana BASF.
Una versión previa del paper está en línea desde el año pasado, y varias farmacéuticas ya usan el modelo de forma habitual. CheMeleon se construyó sobre ChemProp, un paquete de aprendizaje automático de código abierto que también desarrolla y mantiene el grupo de Green en el MIT. Cualquiera puede descargar CheMeleon a través de ChemProp y ajustarlo para sus propios fines.
Nueve de los 20 mejores lo usaron
A comienzos de este año, OpenADMET organizó un concurso para predecir las propiedades de una serie de moléculas nuevas que nunca se habían sintetizado, cuenta Green, profesor Hoyt Hottel de Ingeniería Química.
"Fue un concurso grande, participó mucha gente", dice.
Cuando se anunciaron los ganadores, nueve de las 20 mejores postulaciones habían usado CheMeleon en su proceso.
"Entonces empezamos a recibir todo tipo de consultas de las farmacéuticas sobre esto, pero nuestro paper recién se había enviado; ni siquiera estaba revisado por pares ni nada", recuerda.
Mientras el artículo pasaba por la revisión, su influencia seguía creciendo. Al menos una farmacéutica, según Green, "envió un mensaje a toda su gente y dijo 'Cada vez que modelen una propiedad, empiecen con CheMeleon, esa es nuestra nueva política de empresa'" para las decisiones iniciales sobre qué moléculas seguir.
¿Cómo aprende sin depender de la literatura?
La base de CheMeleon es un preentrenamiento con datos detallados de un millón de moléculas. Así el modelo aprende las correlaciones entre la estructura de una molécula y su comportamiento frente a un catálogo de cerca de 1.600 descriptores que los químicos han desarrollado durante décadas. Después se puede ajustar para predecir propiedades conocidas, como la solubilidad y la viscosidad, o más específicas, como la bioactividad o la reactividad con una proteína o enzima determinada.
Ese millón de moléculas es una fracción mínima de las formas en que los átomos pueden enlazarse. Aun así, entrega ejemplos suficientes para que el sistema, una vez entrenado, descubra por su cuenta muchos patrones y relaciones de fondo, y los aplique a una molécula nueva y desconocida.
"La mayoría de los modelos de aprendizaje profundo actuales requieren más datos que los métodos tradicionales", dice Zalte.
Algunos modelos exitosos usan grandes volúmenes de datos de la literatura publicada en revistas de química, explica. "Nosotros no miramos la literatura en absoluto. Solo calculamos un montón de descriptores moleculares, como el peso molecular o el número de oxígenos, entre otros." Predecir esos descriptores es la tarea de preentrenamiento.
CheMeleon es un modelo fundacional preentrenado. Se inspira en los modelos fundacionales de lenguaje como ChatGPT y Claude, que se desarrollan alimentándolos con grandes cantidades de información de internet. En su caso, usa los descriptores moleculares de un millón de moléculas de PubChem, una base de datos química libre que mantienen los Institutos Nacionales de Salud de Estados Unidos.
La diferencia con los modelos clásicos
En los modelos clásicos, guiados por expertos, los especialistas cargan a mano su conocimiento detallado del tema. Al construirlos, explica Zalte, se sabe por experimentos que una propiedad de interés, por ejemplo la solubilidad, puede relacionarse con ciertos descriptores de las mismas moléculas, "como el peso molecular, o el número de oxígenos presentes, o qué tan ramificada o voluminosa es la molécula".
Con el enfoque del equipo, se parte de una arquitectura de red neuronal existente y se la entrena para aprender principios de fondo.
"No lo entrenamos para una propiedad específica, sino como un modelo general que entiende cierto nivel de química, para que, aunque lo ajustes con apenas unos pocos datos para la tarea que te importa, igual puedas obtener un buen desempeño", dice. Eso ocurre porque el modelo "no tiene que aprender todo desde cero".
Para comprobar su utilidad, "comparamos nuestro modelo no solo con otros modelos fundacionales disponibles, sino también con modelos clásicos que aprovechan principios diseñados por expertos", señala Zalte. En la comparación sobre 58 casos de prueba, "vemos que nuestro modelo queda en primer lugar".
"El modelo fundacional CheMeleon reduce drásticamente el número de moléculas que hay que probar experimentalmente para predecir con precisión las propiedades de moléculas nuevas. Es una gran ventaja, porque sintetizar y probar una gran cantidad de moléculas es lento y caro", agrega Green.
Además de los integrantes del MIT, el equipo incluyó a Jochen Sieg, Christian Feldmann y Miriam Mathea, investigadores de BASF SE en Alemania. El trabajo contó con el apoyo del consorcio Machine Learning for Pharmaceutical Discovery and Synthesis y con becas del Departamento de Energía de Estados Unidos y de MathWorks.