El Allen Institute for AI (Ai2) presentó ToyBlocks, un marco de simulación abierto construido alrededor de un brazo robótico y bloques sobre una mesa. Es el primero de lo que el instituto llama FoundationWorlds, mundos simulados y controlados para estudiar robótica. Ai2 publicó el código, los datos, los modelos y la documentación.
Los robots ya aprenden a doblar ropa, ordenar piezas y manipular objetos que no conocen. Pero esas demostraciones suelen ser acotadas y no explican qué aprendió el robot ni por qué falla.
Para estudiar un sistema complejo, los científicos suelen partir con un ambiente pequeño y controlado, como una placa de Petri o un terrario, donde pueden variar las condiciones y observar los efectos. Según Ai2, la robótica necesita ambientes así, donde se pueda cambiar los datos de entrenamiento o el diseño del modelo, repetir una prueba y rastrear la causa de una falla.
Cada FoundationWorld combina un mundo simulado y controlado, pensado para estudiar la robótica en un entorno específico, con herramientas para generar tareas y demostraciones de entrenamiento de forma automática, y con métricas para medir el comportamiento del robot en el tiempo. Sirven para estudiar, por ejemplo, cómo mejoran los modelos a medida que hay más datos de entrenamiento, o cómo combinar mejor el razonamiento de alto nivel con el control físico preciso.
El escenario de ToyBlocks es simple a propósito, pero el robot igual tiene que razonar sobre cómo interactúan los bloques y cómo ordenarlos mientras los empuja, los da vuelta y los apila.
ToyBlocks genera demostraciones, es decir, grabaciones de un robot que completa tareas en simulación, sin necesidad de teleoperación, el proceso lento en que una persona controla el robot a distancia. Los investigadores pueden variar esas experiencias de entrenamiento. Un equipo podría generar más demostraciones de empujar o de dar vuelta bloques y después evaluar el desempeño en tareas que dejó fuera del entrenamiento. Ai2 quiere extender el enfoque a ambientes cada vez más complejos.
¿Cómo funciona ToyBlocks?
ToyBlocks se apoya en trabajos anteriores de Ai2 sobre aprendizaje robótico abierto, como MolmoAct 2, MolmoBot y MolmoSpaces. Como FoundationWorld, cumple cuatro requisitos:
1. Física y apariencia realistas. 2. Generación automática de tareas y demostraciones a escala. 3. Desafíos que combinan razonamiento con destreza. 4. Cobertura amplia de las tareas posibles dentro del dominio.
En dominios abiertos hay que modelar una variedad enorme de objetos e interacciones, y eso hace imposible cumplir los cuatro requisitos a la vez. El alcance acotado de ToyBlocks sí lo permite. Dentro de ese escenario, los investigadores pueden estudiar cómo un robot aprende cualquier tarea razonable, con la confianza de que el brazo y los bloques simulados se comportan de forma muy parecida a sus equivalentes físicos.
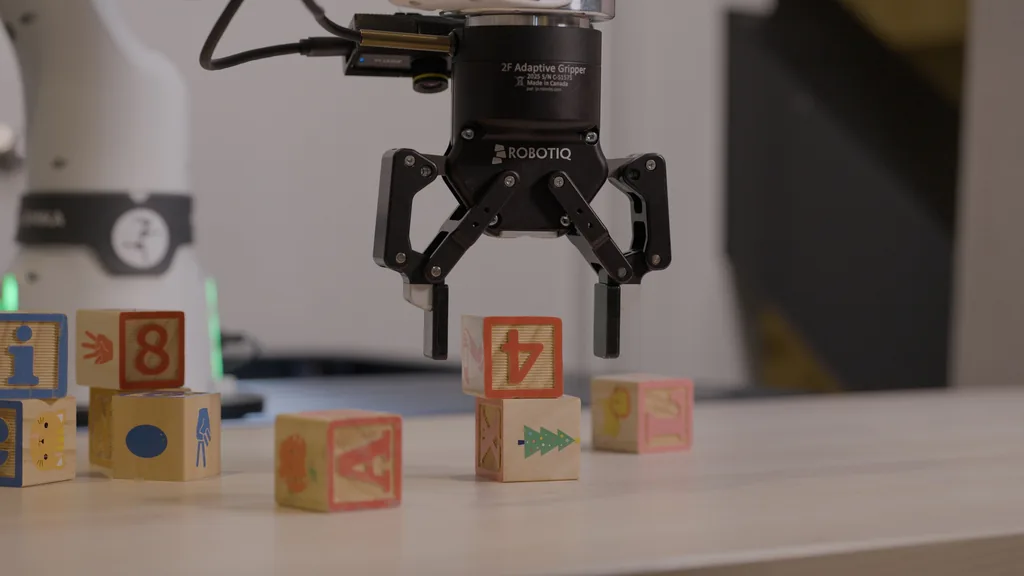
Pinza de un robot real sobre bloques de madera en el montaje de ToyBlocks.
No se trata solo de tomar y apilar bloques. Las caras de los bloques llevan dibujos y letras, lo que permite tareas de búsqueda, clasificación y ordenamiento. Un robot puede tener que girar un bloque para ver una cara oculta antes de decidir dónde va. La aleatorización del dominio, que cambia de escena en escena el tamaño de los bloques, la altura de la mesa y otras propiedades físicas, pone a prueba cómo generalizan los modelos cuando cambia la geometría.
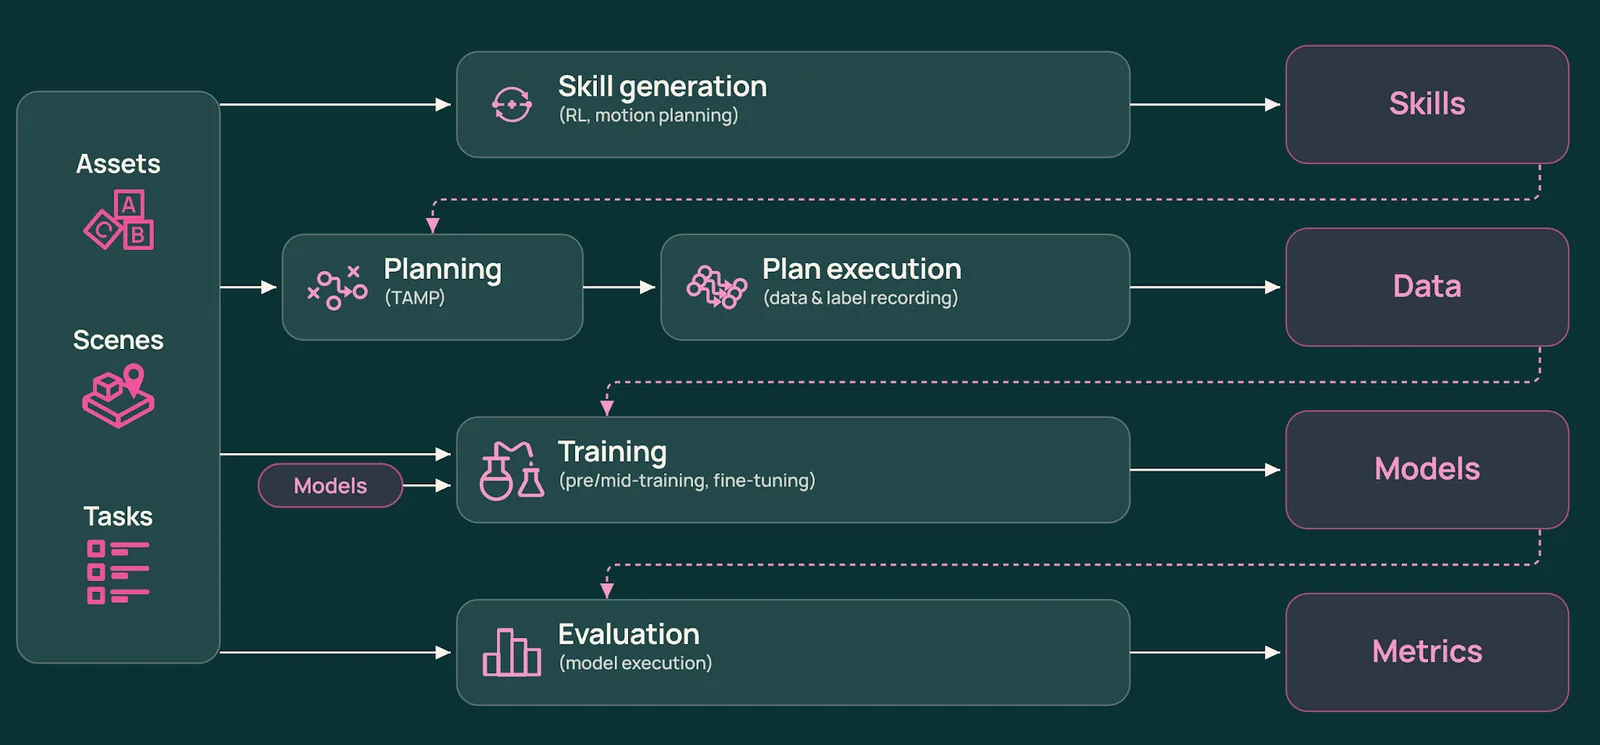
ToyBlocks genera de forma automática habilidades (comportamientos para tareas cortas) y demostraciones de tareas que sirven para entrenar modelos o ajustarlos con entrenamiento adicional. Los modelos de razonamiento de alto nivel deciden qué hacer y los modelos de acción de bajo nivel controlan los movimientos del robot.
Habilidades con aprendizaje por refuerzo
ToyBlocks usa aprendizaje por refuerzo y planificación de movimiento, que calcula cómo debe moverse el robot, para generar habilidades de tareas de horizonte corto, es decir, secuencias breves de acciones. El entrenamiento de habilidades corre en Isaac Lab, el marco abierto de Nvidia para aprendizaje robótico en simulación.
Por ensayo y error, esas políticas, que son los modelos que eligen las acciones del robot, aprenden habilidades sin agarre, como empujar un bloque por la mesa o darlo vuelta sobre otra cara sin levantarlo. La generación de habilidades puede usar información privilegiada, valores que el simulador entrega directo pero que un robot real no tiene, como la posición y orientación exactas de un bloque, en vez de estimarlos desde imágenes de cámara. Así se generan de forma automática habilidades que en el mundo real exigirían teleoperación.
Para generar datos de demostración, un planificador de tareas y movimiento (TAMP) elige y ordena las habilidades necesarias para resolver una tarea y planifica los movimientos del robot entre ellas. Al ejecutar cada plan en simulación se obtiene un conjunto de demostraciones grabadas, con etiquetas que indican qué tarea o habilidad realiza el robot. ToyBlocks escala la generación de datos ejecutando cientos de esos planes en paralelo en una sola GPU, y llega a 24 veces la velocidad del tiempo real.
Actuar a partir de las lecturas de los sensores agrega un problema de percepción. El modelo tiene que estimar la pose de un bloque, su posición y orientación, un dato que el simulador podría entregar directo. Para reflejar las condiciones reales, ToyBlocks entrena modelos que van de las observaciones crudas de los sensores a las acciones.
En una de las demostraciones, Molmo 2, un modelo de alto nivel, elige habilidades como girar y dar vuelta, y señala el bloque que corresponde con una interfaz de puntero. ManiFlow, un modelo de bajo nivel, controla el brazo simulado para ejecutar esas órdenes.
Qué se puede medir
El generador de datos controlable permite armar mezclas de entrenamiento que refuercen ciertas habilidades o cubran huecos de un conjunto de datos. Los investigadores pueden estudiar cuántos datos necesita un modelo y qué experiencias lo ayudan a generalizar a tareas que no vio. Podrían probar, por ejemplo, si sumar demostraciones de rotación y de tomar y dejar mejora la habilidad de dar vuelta bloques, o variar la proporción de ejemplos dentro y fuera de una región del espacio de trabajo, y evaluar esas decisiones en tareas excluidas del entrenamiento.
La evaluación entrega métricas que van más allá de la tasa de éxito, como la velocidad de ejecución, la fuerza aplicada sobre los objetos y el avance de la tarea medido con las mismas especificaciones que usa el módulo de planificación.
Una interfaz web permite conectar Claude u otro modelo de frontera y usar lenguaje natural para dar instrucciones al robot o probar tareas. Es una forma de ver cómo planifica y actúa un modelo sin saber de robótica.
Investigación sobre ToyBlocks
Las evaluaciones de Ai2 usan ToyBlocks para estudiar cómo influyen los datos y los métodos de entrenamiento en el desempeño, el razonamiento espacial, la generalización a letras y apariencias nuevas de los bloques, la planificación de varios pasos, la transferencia a robots físicos y los modelos de frontera que actúan con herramientas. Cada usuario puede diseñar sus propias tareas y medidas, por ejemplo para ver si un modelo rinde mejor cuando elige objetos señalándolos o cuando recibe órdenes de texto como "toma el bloque amarillo".
Modelos de acción de bajo nivel
Los modelos de acción de bajo nivel, como los modelos de visión, lenguaje y acción (VLA), convierten instrucciones en lenguaje y observaciones visuales en acciones del robot.
La promesa de los VLA es que, preentrenados con grandes conjuntos de datos, pueden generalizar rápido a escenarios distintos o a un espacio de trabajo específico. La evidencia es contradictoria. Algunos estudios muestran que estos modelos son frágiles ante cambios como otra disposición de objetos u otra iluminación, y otros muestran que generalizan bien. Ai2 sostiene que esos estudios suelen usar datos del mundo real con poca flexibilidad en las variaciones espaciales, y que ToyBlocks permite probarlo en un escenario simple, fácil de reproducir y con diversidad real de tareas.
Las pruebas de generalización varían las secuencias de habilidades que exige una instrucción, las letras o colores de los bloques y la cantidad de bloques en la escena. Un estudio de apilado puede dejar fuera del entrenamiento las torres de cuatro bloques y después ver si el modelo combina movimientos conocidos para construirlas. Los estudios de espacio de trabajo separan el desempeño en posiciones nuevas dentro de la región de entrenamiento del desempeño fuera de sus bordes, donde el modelo tiene que extrapolar.
Ai2 usó cuatro tareas, apilar, desapilar, dar vuelta y girar. Para cada una midió la interpolación, con configuraciones nuevas dentro del rango de entrenamiento, y la extrapolación, con configuraciones fuera de ese rango. Un ejemplo es entrenar con objetos que aparecen solo en la región izquierda y evaluar en la derecha, o entrenar con torres de 2 y 5 bloques y evaluar con torres de 3 y 4.
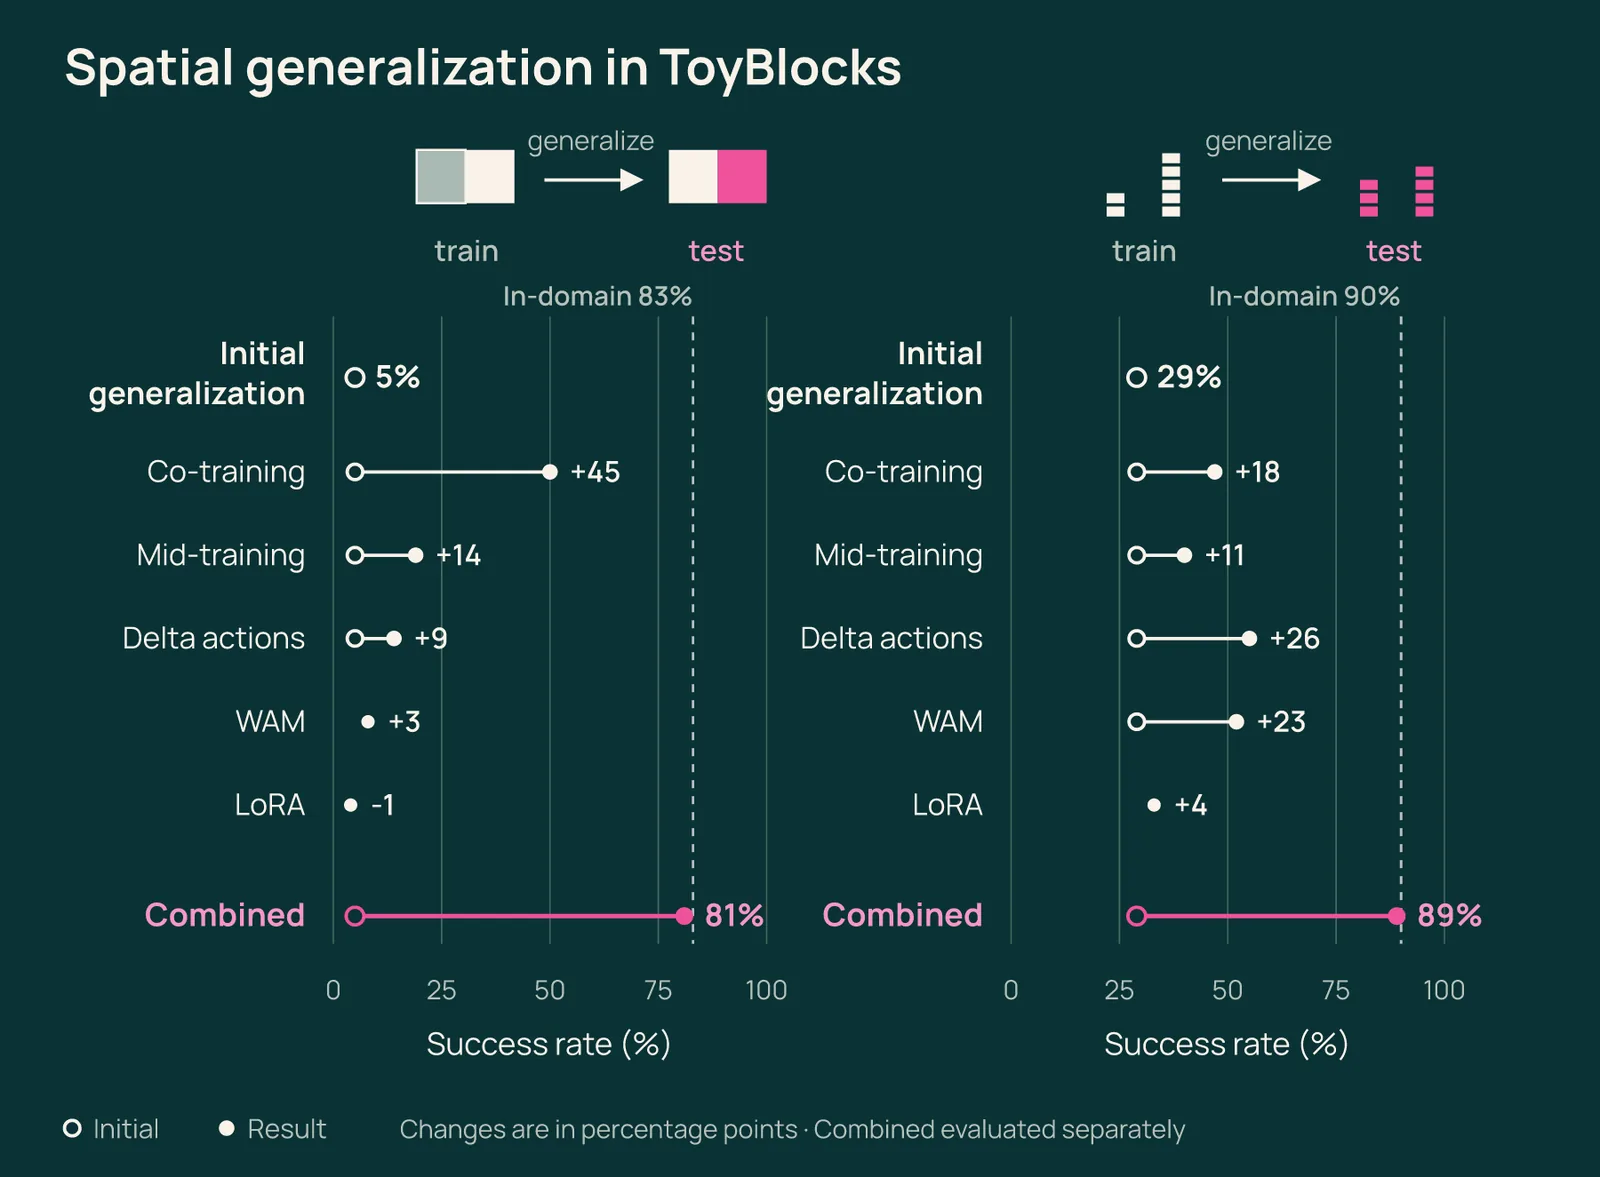
Estudios de generalización espacial para modelos VLA, con resultados de ManiFlow, π0.5 y MolmoAct 2. Pese al preentrenamiento a gran escala, estos modelos de acción generalizan mal en los resultados iniciales. La etiqueta LoRA del gráfico corresponde a adaptación de bajo rango, un método de ajuste fino que entrena un conjunto pequeño de actualizaciones de pesos.
Según Ai2, la generalización de los modelos de acción está lejos de resolverse, y ToyBlocks sirve como banco de pruebas para explorar técnicas que la mejoren de forma sistemática.
Razonamiento de alto nivel
Las tareas de horizonte largo, que exigen muchos pasos, permiten medir qué tan bien planifica un modelo una secuencia de acciones. El marco permite crear ese tipo de tareas y también oráculos, componentes de referencia que entregan el plan o la acción correctos, tanto en el nivel alto como en el bajo. Con eso se puede aislar si una falla vino de la planificación o de la ejecución.
Un ejemplo es formar la palabra "Ai2" con una torre de bloques. Como las letras pueden no estar a la vista, el agente primero tiene que elegir acciones que le revelen información y después planificar y ejecutar la secuencia para armar la torre.