Anthropic publicó un flujo de evaluación de plugins para Claude Code, informó MarkTechPost el 11 de septiembre de 2026. El comando claude plugin eval corre un plugin contra prompts realistas, califica lo que Claude produjo y compara ese resultado con una corrida donde el plugin no está cargado.
Con eso responde tres preguntas que hasta ahora nadie podía medir. Si la habilidad se dispara cuando debe, si sobrevive a una edición o a un cambio de modelo, y si le gana a un modelo pelado. Funciona desde la versión 2.1.269 de Claude Code contra cualquier directorio con un manifiesto plugin.json o .claude-plugin/plugin.json. Cada corrida y cada evaluador con modelo juez son llamadas reales que se cobran a la cuenta.
¿Cómo se arma un caso de evaluación?
La suite vive en un directorio evals/ dentro del plugin. Cada caso es un subdirectorio con un archivo prompt.md y una carpeta graders/. El cuerpo del prompt llega a Claude exactamente como está escrito, y las menciones con @ruta no se expanden.
El encabezado del prompt.md admite cinco parámetros. max_turns, que por omisión vale 10, timeout_seconds, que parte en 300, más model, tags y allowed_tools.
El comando claude plugin eval init lee el plugin, pregunta qué cuenta como buen resultado, propone casos y evaluadores, los prueba y escribe los archivos. En integración continua, la opción --bare <nombre> deja una plantilla en blanco.
¿Qué revisa cada uno de los seis evaluadores?
Los evaluadores son archivos Markdown cuyo encabezado define un type, un weight opcional y un arm opcional. Cuatro de los seis no cuestan nada porque se calculan sobre la transcripción y los archivos en disco.
| Evaluador | Qué revisa | Costo |
|---|---|---|
regex | un patrón dentro de la respuesta | gratis |
tool_used | que cierta herramienta se haya invocado | gratis |
tool_order | el orden de las llamadas | gratis |
file_exists | archivos escritos en disco | gratis |
llm | la respuesta contra criterios en prosa | modelo juez |
baseline | la respuesta contra una referencia | modelo juez |
¿Por qué la diferencia entre las dos corridas es el número que manda?
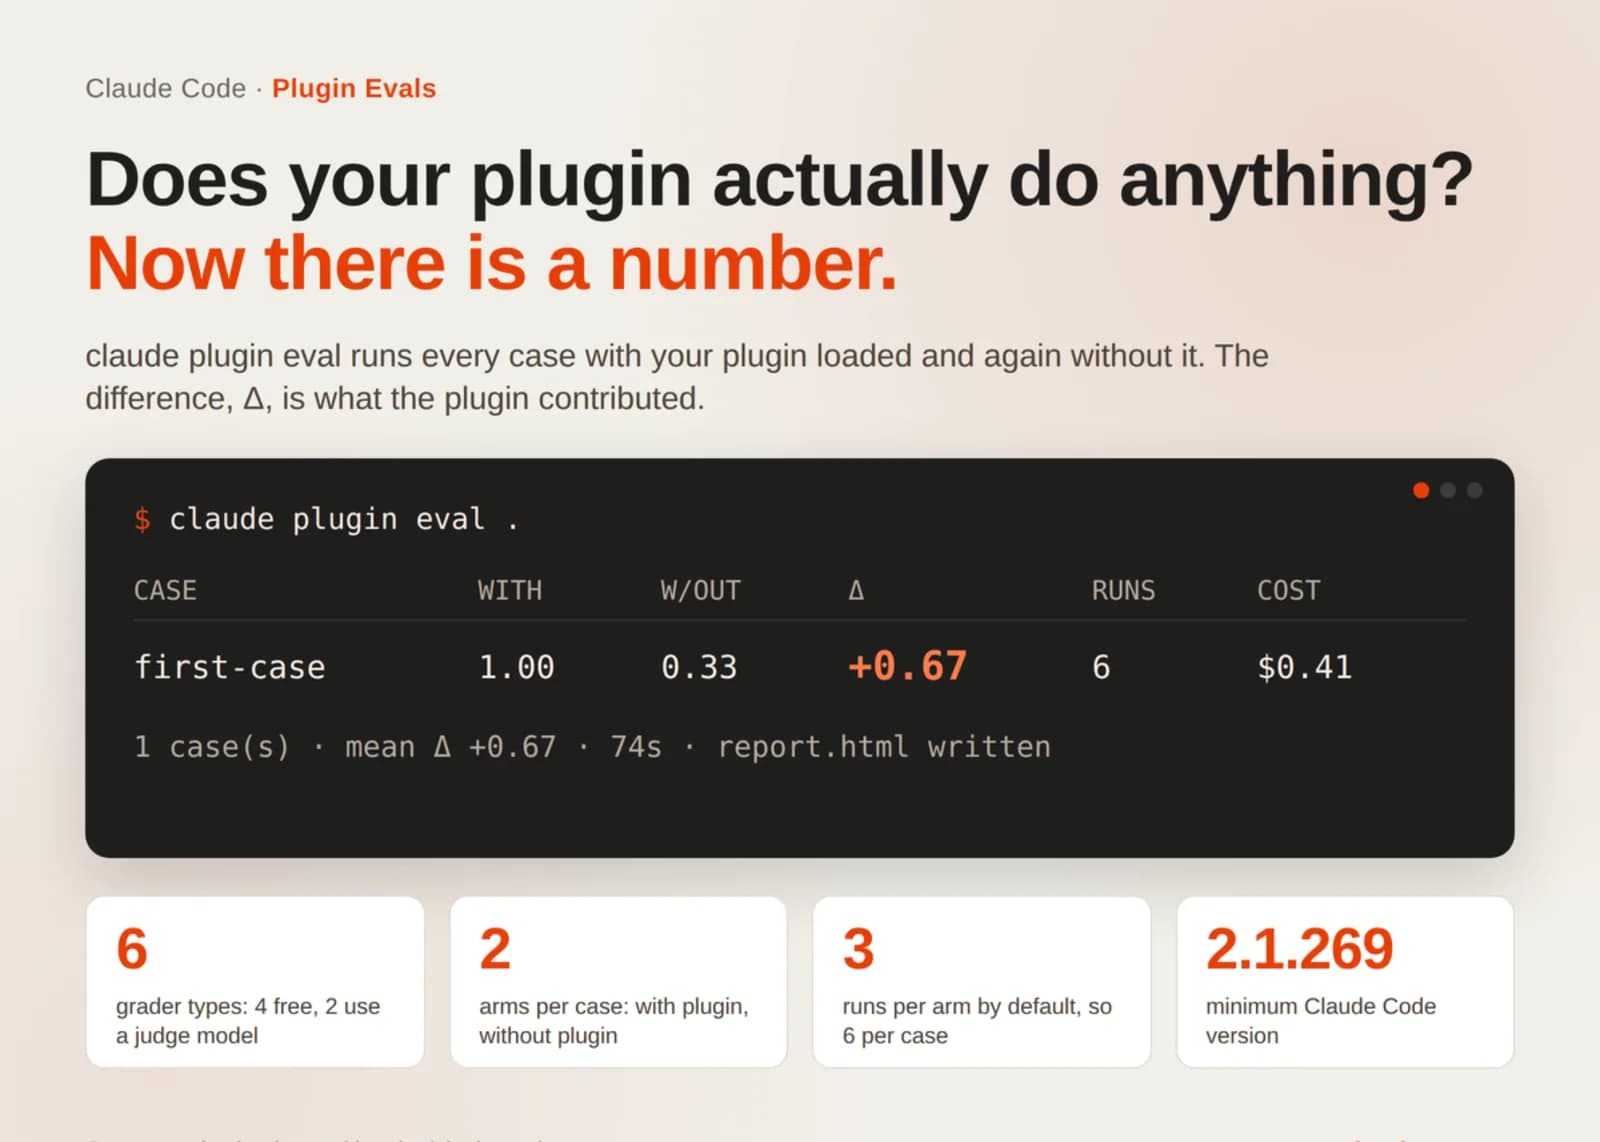
Cada caso corre dos veces por omisión. Una con el plugin cargado y otra sin él. La diferencia entre ambas notas, que la documentación llama Δ, es lo que aportó el plugin. Si un caso saca 1,0 en las dos corridas, el plugin no es la razón por la que pasó.
El ejemplo de la documentación muestra un caso con 1,00 con el plugin, 0,33 sin él y un Δ de +0,67, repartido en seis corridas, con un costo estimado de 0,41 dólares y 74 segundos de reloj. Un evaluador marcado para correr solo en el brazo con plugin, típicamente tool_used: Skill, se reporta como indicador y queda fuera de la nota, porque el brazo sin plugin no tiene ninguna habilidad que disparar.
Anthropic nombra cuál es el primer hallazgo más frecuente. Un Δ cercano a cero con el evaluador tool_used: Skill fallando, lo que significa que Claude no elige la habilidad cuando el usuario escribe con sus propias palabras. Ese defecto no lo ve claude plugin validate, porque ese comando revisa la sintaxis del manifiesto y el esquema, no la conducta.
Los resultados quedan en evals/results/<timestamp>/report.html con los veredictos por evaluador y los votos del juez. Donde la cuenta lo permite, el informe también se publica en claude.ai, salvo que se pase --no-publish.
¿Cuánto cuesta y cómo se mete en integración continua?
Una suite genera aproximadamente casos por corridas por brazos, más tres llamadas cortas al juez por cada evaluador llm o baseline en cada corrida. Los resultados varían entre una corrida y otra. La invocación documentada para integración continua es esta.
claude plugin eval . \
  --trust-plugin \
  --json results.json \
  --threshold 0.8 \
  --model claude-sonnet-5 \
  --judge-model claude-haiku-4-5 \
  --no-publish \
  --max-cost-usd 20
El corredor necesita una instalación de Claude Code y credenciales como ANTHROPIC_API_KEY. Sin --trust-plugin, un checkout no confiable se rechaza con código de salida 1 cuando no hay terminal. Los problemas que aparecen en el informe nunca cambian ese código de salida, y --json silencia la salida de progreso.
Las banderas --threshold, --max-cost-usd y --trust-plugin son las que convierten el comando en una barrera de integración continua. MarkTechPost advierte un borde, los errores por límite de uso pueden parecer una regresión que no existe.