El proyecto Kernels de Hugging Face ya tiene soporte para Helion. Esta nota recorre cómo construir, autoajustar y distribuir kernels de Helion portables y de buen rendimiento a través de ese proyecto, de modo que quien los consuma pueda hacerlo sin fricción.
¿Qué es Helion?
Helion es un lenguaje de dominio específico de alto nivel para escribir kernels portables y de alto rendimiento para aprendizaje de máquinas. El modelo de programación suele describirse como "PyTorch con teselas": el kernel opera sobre tensores de PyTorch y las operaciones a nivel de tesela se especifican con operadores de tensor corrientes. Como ejemplo rápido, la siguiente función muestra una multiplicación de matrices teselada implementada en Helion:
import torch, helion, helion.language as hl

@helion.kernel()
def matmul(x: torch.Tensor, y: torch.Tensor) -> torch.Tensor:
    m, k = x.size()
    k, n = y.size()
    out = torch.empty([m, n], dtype=x.dtype, device=x.device)

    for tile_m, tile_n in hl.tile([m, n]):
        acc = hl.zeros([tile_m, tile_n], dtype=torch.float32)
        for tile_k in hl.tile(k):
            acc = torch.addmm(acc, x[tile_m, tile_k], y[tile_k, tile_n])
        out[tile_m, tile_n] = acc

    return out
Lo que hace deseable a Helion no es solo su sintaxis concisa, sino lo que deja deliberadamente sin especificar. Cuando se escribe hl.tile, se indica únicamente que el espacio de iteración debe teselarse, no de qué tamaño son las teselas ni cómo se traen sus datos desde memoria. Helion convierte esas decisiones en un espacio de búsqueda que se autoajusta.
El punto clave es que el autoajustador no barre solamente parámetros numéricos como el tamaño de tesela: también busca entre estrategias de traducción a bajo nivel, es decir, la implementación concreta del kernel. Qué patrón de acceso a memoria usar (aritmética de punteros, punteros de bloque, TMA), cómo ordenar y aplanar los bucles anidados, si una reducción debe ser persistente o iterada, y más. En Triton o en CUDA, cambiar entre esas opciones implica reescribir el kernel completo; en Helion la opción óptima se encuentra de forma algorítmica.
Ese proceso de autoajuste explica por qué un kernel de Helion puede superar a uno escrito a mano en un lenguaje de más bajo nivel cuando se compara sobre un conjunto amplio de formas de tensor. Dicho eso, el autoajuste a veces es lento, así que conviene tener una manera establecida de distribuir un kernel junto a sus configuraciones ya ajustadas. Ahí entra el proyecto Kernels.
¿Qué problema resuelve el proyecto Kernels?
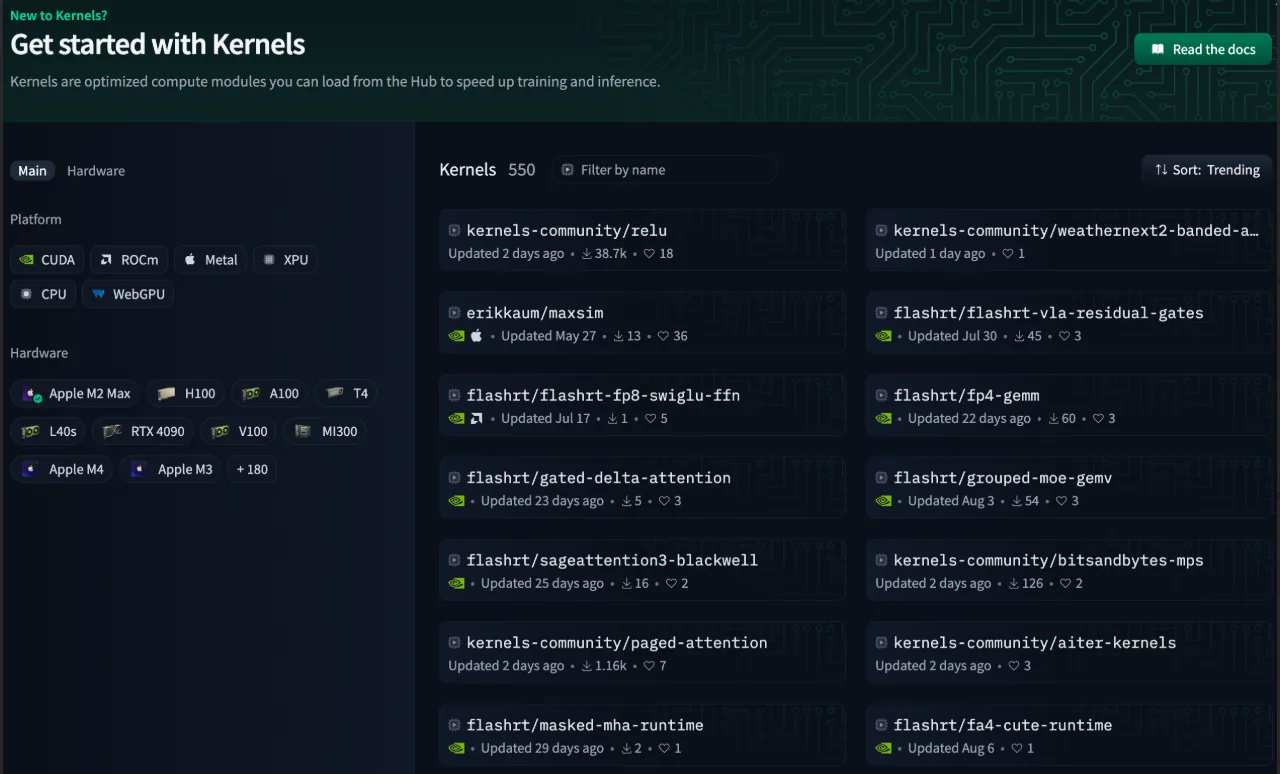
El panorama actual de empaquetado y distribución de kernels está fragmentado: estructuras de código inconsistentes, herramientas dispares y compatibilidad limitada. La consecuencia es que los usuarios enfrentan tiempos de compilación penosos, incluso cuando existen paquetes precompilados.
El proyecto Kernels aborda esos problemas estableciendo un proceso unificado de empaquetado y construcción, tanto para kernels compilados de antemano como en tiempo de ejecución. Se divide en dos componentes:
kernel-builder: una herramienta para que los desarrolladores empaqueten y distribuyan kernels de forma confiable entre distintas versiones del framework y configuraciones de sistema. Impone estándares que aseguran estructuras predecibles, reproducibilidad de la construcción, compatibilidad nativa con PyTorch y facilidad para compartir con la comunidad.kernels: una biblioteca de Python orientada al consumidor que permite cargar kernels listos para usar sin lidiar con dependencias, mediante una llamada simple comoget_kernel("org/name", version=1), tal como se descarga un modelo o un conjunto de datos desde el Hub.
Un ejemplo de cómo se carga el popular kernel Flash-Attention 3:
from kernels import get_kernel

kernel_module = get_kernel("kernels-community/flash-attn3", version=1)
flash_attn_func = kernel_module.flash_attn_func

flash_attn_func(...)
El proyecto entrega binarios precompilados para una matriz amplia de compatibilidad. Eso resulta útil sobre todo cuando el repositorio original del kernel no ofrece una construcción específica.
Cómo se empaqueta un kernel de Helion
Los kernels de Helion son Python plano. Se compilan solos la primera vez que se los llama, así que no hay nada que kernel-builder deba compilar de antemano. Helion entrega utilidades para ajustarlos a cargas de trabajo y hardware específicos, de modo que se ajusten una vez y se reutilicen después. También son kernels noarch: se distribuye el código fuente y Helion hace el resto en la máquina del usuario.
El andamiaje inicial se genera con kernel-builder init, indicando los backends deseados (CUDA, ROCm, XPU). Como el andamiaje asume un kernel compilado, se eliminan las partes que no se usan y quedan tres archivos por editar: build.toml, el módulo de Python con el kernel y flake.nix.
En build.toml, dos declaraciones merecen atención: python-depends = ["helion"], que registra que el kernel necesita Helion en tiempo de ejecución (al cargarlo, kernels verifica que sea importable y entrega un error claro si no lo es), y [torch-noarch], que indica que no hay compilación previa.
La construcción y publicación al Hub se hacen con kernel-builder build-and-upload .. El resultado produce un directorio por backend, cada uno con su __init__.py y un metadata.json generado que arrastra la dependencia de Helion hacia adelante.
Configuraciones preajustadas: el aporte práctico
Para asegurar que el kernel rinda bien con distintas formas de entrada y distintas generaciones de GPU, conviene preajustarlo. El flujo tiene tres pasos: ajustar el kernel sobre un conjunto representativo de formas, dejar que Helion construya un árbol de decisión que mapee cada forma a su mejor configuración, y distribuir ese árbol junto al kernel.
Al cargarlo, Helion lee el árbol (almacenado como un archivo de Python plano junto al código fuente del kernel) y elige una configuración por llamada, sin ajustar nada en la máquina del usuario. El cambio en el código es un decorador: se pasa de @helion.kernel(config=...) a @helion.aot_kernel(static_shapes=True).
Después se escribe un guion pequeño que llame al kernel con cada forma que se quiera cubrir y se entrega al ejecutor de Helion:
python -m helion.autotuner.aot_runner \
    --phase all --goal max_slowdown --threshold 1.01 --max-configs 8 \
    -- python bench.py
El ejecutor cumple tres fases. Recolección: autoajusta cada forma de manera independiente. Medición: vuelve a medir cada configuración descubierta sobre cada forma. Construcción: selecciona el conjunto más pequeño de configuraciones que mantiene cada forma dentro del umbral respecto de su propio óptimo (1,01 equivale a quedar dentro del 1%), hasta el máximo indicado. Si una sola configuración satisface todas las formas, eso es todo lo que se distribuye; si las formas divergen, se obtiene un árbol con varias.
¿Cuánto rinde en la práctica?
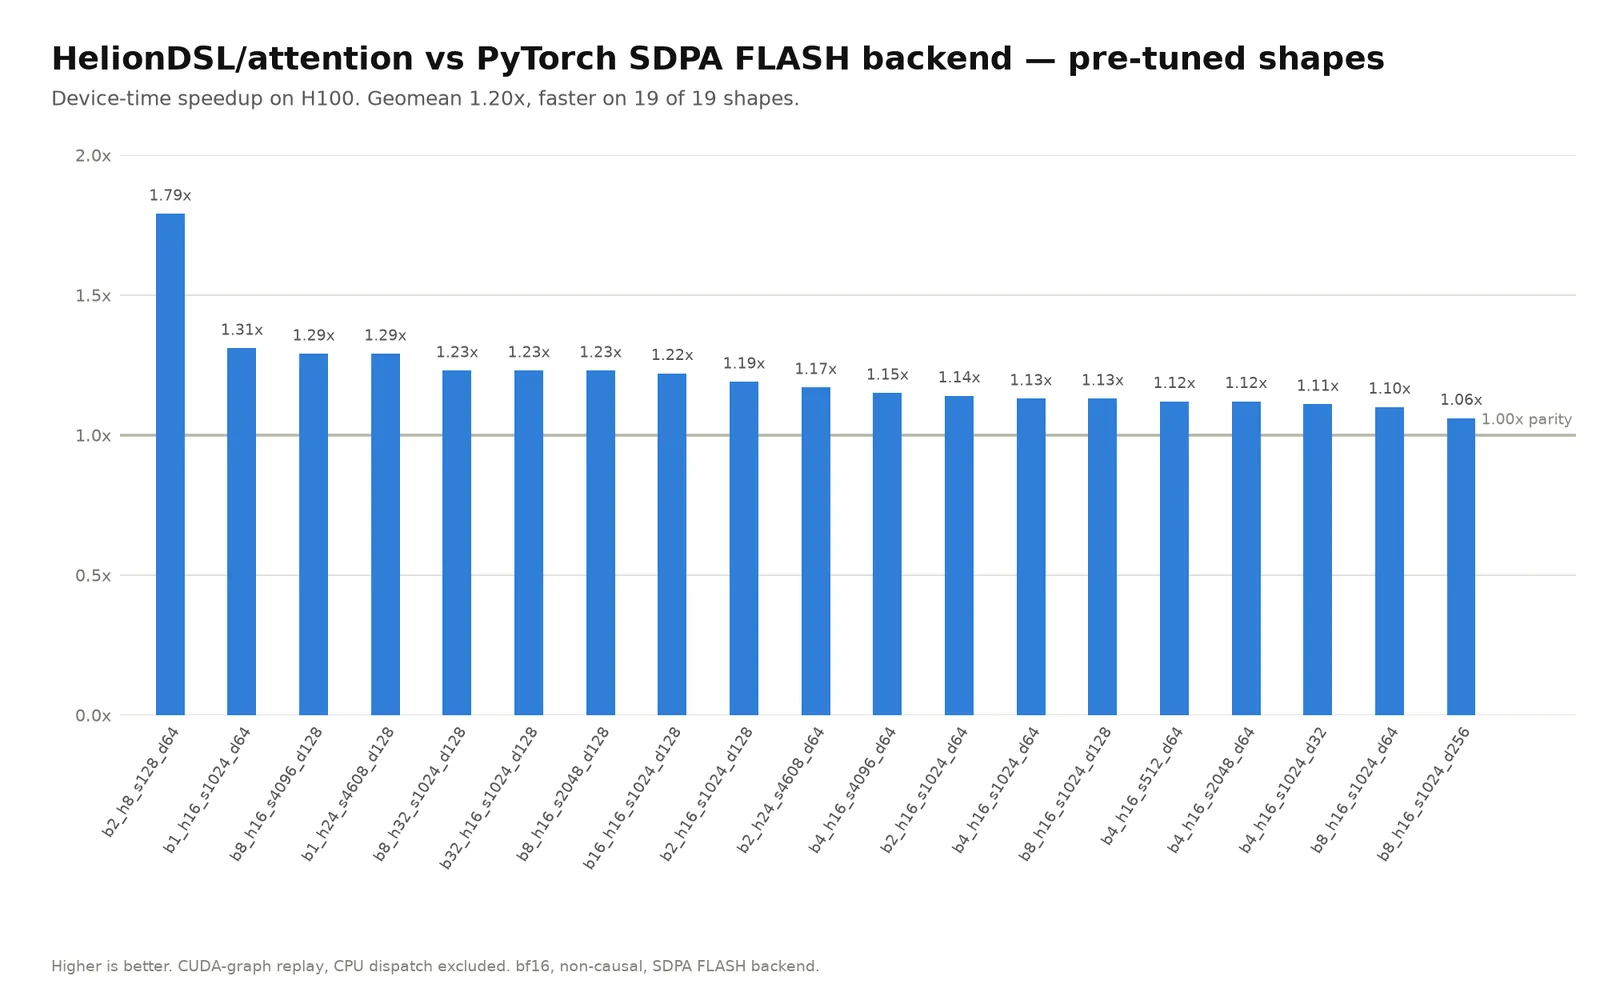
En HelionDSL/attention se muestra un kernel de atención de Helion preajustado y distribuido vía Kernels, con configuraciones para NVIDIA H100. Comparado contra el backend FLASH de la implementación scaled_dot_product_attention de PyTorch sobre una H100, el kernel distribuido supera a SDPA en 19 de 19 formas preajustadas, con una aceleración media geométrica de 1,20. Sobre formas reservadas que no se vieron durante el ajuste, supera a SDPA en 9 de 10 formas, con una aceleración media geométrica de 1,17.
Para dimensionar qué significa ese 1,20 en costo: sobre una instancia con H100, cuyo arriendo por hora ronda los 3 dólares en los proveedores grandes, un 20% de aceleración en la capa de atención se traduce en una reducción proporcional del tiempo de inferencia facturado. Para equipos de la región que arriendan cómputo por hora en vez de operar hardware propio, ese margen suele pesar más que en una infraestructura amortizada.