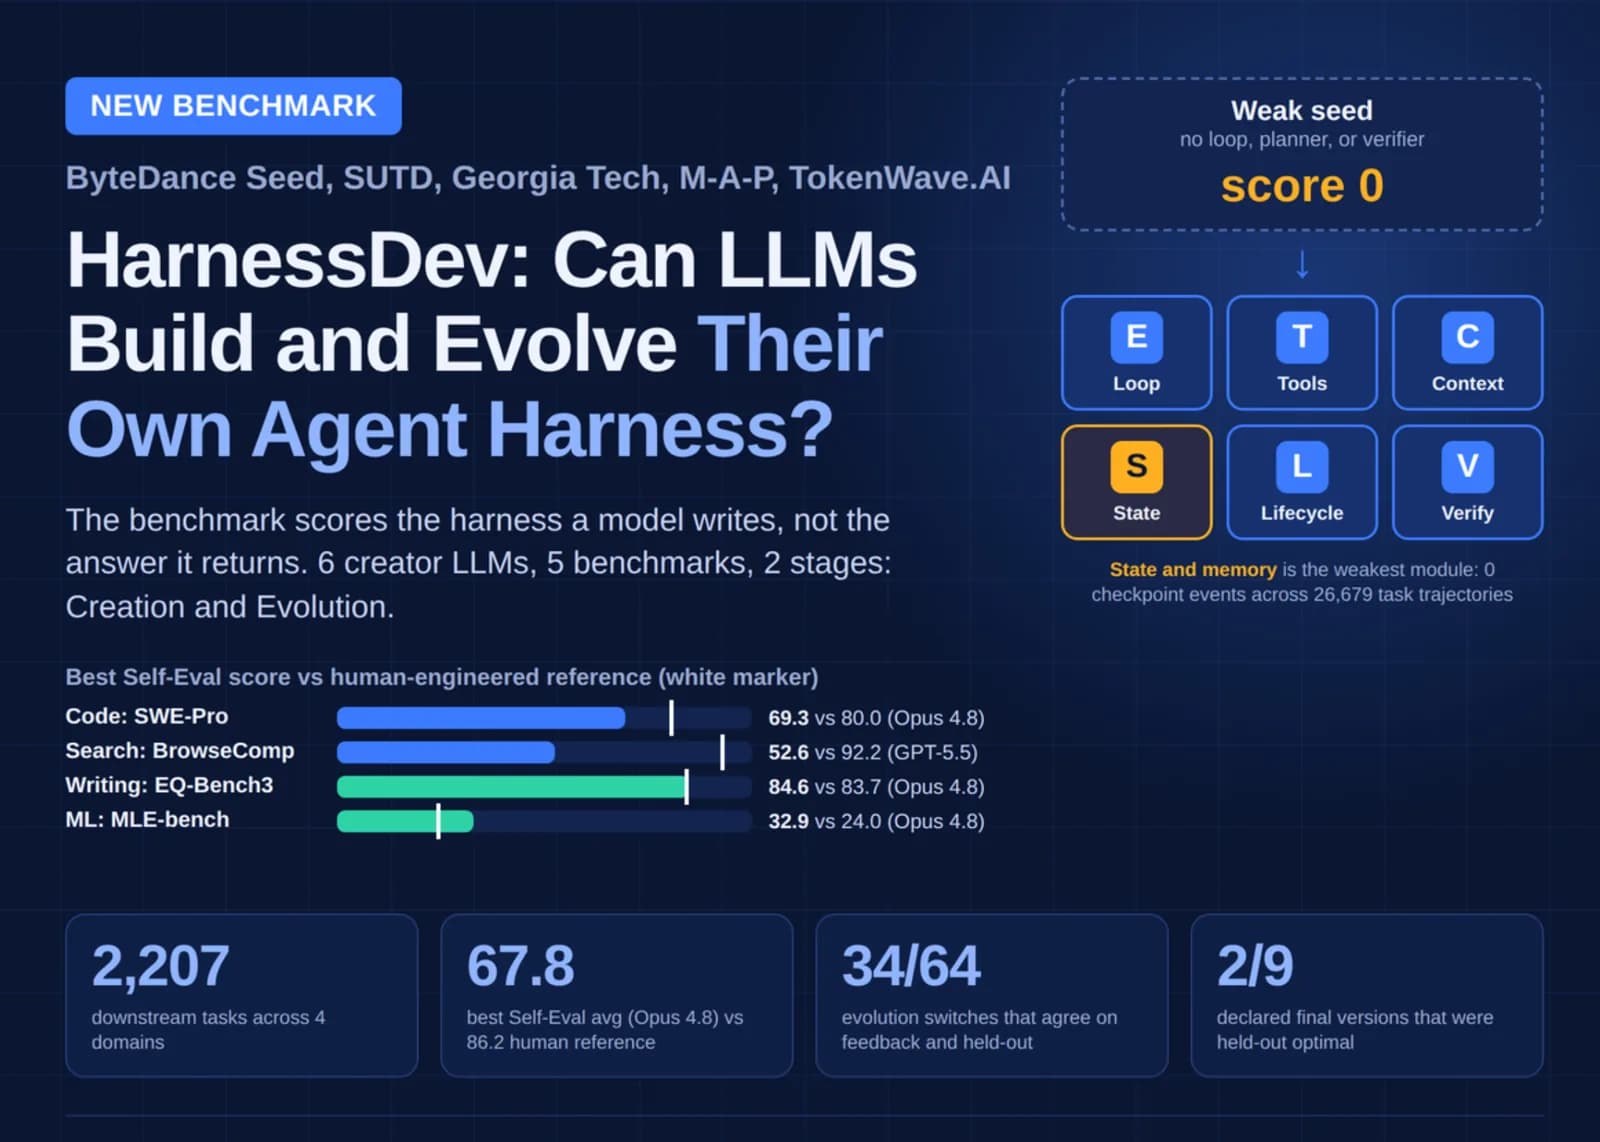
Un agent harness, o andamiaje de agente, es el código que rodea al modelo: el bucle de ejecución, las herramientas, el contexto, el estado, la recuperación ante fallas y la verificación. Según la tabla de posiciones de Terminal-Bench 2.1, GPT-5 resuelve 35,2% de las tareas dentro de Terminus 2 y 49,6% dentro de Codex CLI, con exactamente los mismos pesos. La mayoría de los bancos de pruebas mantiene ese andamiaje fijo. HarnessDev, propuesto por un equipo de investigadores de ByteDance Seed, la Universidad de Tecnología y Diseño de Singapur, el Instituto de Tecnología de Georgia, M-A-P y TokenWave.AI, invierte el objetivo: lo que se evalúa es el andamiaje ejecutable que el modelo escribe, no la respuesta que produce.
Dos etapas: creación y evolución
En la etapa de creación, cada modelo creador recibe la misma semilla débil: primitivas pasivas de archivo, búsqueda y procesos, más escritores de resultados y trayectorias, sin bucle, sin planificador, sin verificador, sin reintentos ni regla de parada. Sin modificar, esa semilla obtiene 0 en todas partes. El creador recibe la especificación de la familia de tareas, un tutorial breve de diseño y de 1 a 3 casos de desarrollo, construye un andamiaje completo, y ese andamiaje queda congelado antes de enfrentar las tareas ocultas.
En la etapa de evolución, el creador parte de su propio andamiaje congelado y lo revisa usando la retroalimentación de ejecución de un conjunto fijo de 100 tareas de SWE-bench Pro y las 89 tareas de Terminal-Bench 2.1. Cada versión oficial candidata debe completar ambas evaluaciones como par, con un presupuesto de 10 pares y como máximo 2 sondeos de cinco tareas entre pares. Cada versión oficial se puntúa después sobre 630 instancias reservadas de SWE-Pro que el creador nunca ve.
Los andamiajes se califican por capacidad (éxito en la tarea) y por eficiencia (tokens del ejecutor, excluyendo los tokens del creador).
¿Con qué modelos se probó?
Se evaluaron 6 modelos creadores: Opus 4.8, GPT-5.5, Gemini 3.1 Pro, DeepSeek V4 Pro, Qwen 3.7 Max y Seed 2.0 Pro, trabajando dentro de Claude Code 2.1.177 (GPT-5.5 usó Codex 0.144.3). La creación abarca 4 dominios y 5 bancos de pruebas que suman 2.207 instancias: la partición pública de SWE-bench Pro (731), Terminal-Bench 2.1 (89), MLE-bench (75), EQ-Bench3 (46) y BrowseComp (1.266). Cada creador construye 3 andamiajes por banco de pruebas, reportados como promedio de 3.
Resultados de la creación
Bajo autoevaluación, Opus 4.8 obtiene el promedio más alto con 67,8 frente a una referencia construida por humanos de 86,2. La brecha depende del dominio:
- Código: Opus 4.8 llega a 69,3 en SWE-Pro contra la referencia de 80,0. Gemini 3.1 Pro lidera Terminal-Bench con 68,8 contra 88,8.
- Búsqueda: la brecha más ancha. El mejor puntaje en BrowseComp es 52,6 (GPT-5.5) contra una referencia de 92,2.
- Escritura: Opus 4.8 anota 84,6 en EQ-Bench3, por encima de la referencia de 83,7.
- Experimentación en aprendizaje de máquinas: Opus 4.8 (32,9) y Gemini (32,4) superan la referencia de 24,0 en MLE-bench.
Las referencias de SWE-Pro, Terminal-Bench y BrowseComp son resultados externos tomados del informe de GPT-5.6 de OpenAI, no repeticiones de las pruebas.
El volumen de código no predijo la calidad: los 18 andamiajes de código agregaron 17.111 líneas netas, y sin embargo Gemini agregó la menor cantidad (1.006) y lideró Terminal-Bench. La cantidad de pruebas propias apenas correlacionó con el puntaje (Spearman de 0,13 a 0,26); las llamadas de revisión llegaron a 0,57.
Buena parte de la maquinaria generada es inerte. De 108 instancias de componentes de código, 72 se activan en corridas reales y 18 nunca se disparan, todas de estado y memoria. 11 de 18 andamiajes definen una clase de estado, y aun así no aparece ni un evento de punto de control en 26.679 trayectorias. 124 de 587 funcionalidades de escritura son código muerto.
Costo y transferencia entre ejecutores
El uso de tokens en MLE-bench varió cerca de 19 veces. GPT-5.5 alcanzó una tasa de medallas de 19,1 con 29,3 millones de tokens, mientras DeepSeek V4 llegó a 19,6 con 208,4 millones. Cambiar el ejecutor a Gemini reordenó por completo la tabla: Qwen ganó 17,6 puntos en BrowseComp y 12,9 en MLE-bench, mientras el puntaje de Opus 4.8 en SWE-Pro cayó de 69,3 a 33,0, en parte porque uno de sus andamiajes tenía un límite de 120 pasos escrito a mano alrededor de su ejecutor original. La tasa de consultas duplicadas del andamiaje de búsqueda de Opus saltó de 10,1% a 88,2% tras el cambio.
Resultados de la evolución
9 linajes (5 con ejecución propia, 4 con Gemini fijo) produjeron 73 versiones oficiales y 64 cambios adyacentes. Los 5 creadores con ejecución propia mejoraron en tareas reservadas, entre +1,43 y +4,44 puntos (promedio +3,11). Con Gemini fijo, solo Opus mejoró; GPT-5.5 retrocedió 10,32 puntos.
El progreso no fue monótono. De los 64 cambios, 8 empeoraron en ambos bancos de pruebas, 16 en uno, 27 ganaron solo dentro de la banda de ruido y 2 mostraron evidencia positiva clara. Un solo commit puede variar cerca de 4,75 puntos de puntaje de par hacia arriba o hacia abajo. La retroalimentación y los puntajes reservados se movieron en la misma dirección solo 34 de 64 veces (53,1%), y apenas 2 de las 9 versiones finales declaradas eran óptimas en el conjunto reservado. De 169 funciones o clases nuevas, 25 no tienen quien las llame.
La victoria más clara: Opus 4.8 notó que 99 de 100 corridas reportaban éxito mientras solo 48 pasaban, rastreó el problema hasta una finalización prematura y agregó una compuerta de término. El diagnóstico de fallas fue, por lo demás, el paso más débil: la interfaz dedicada a revisar trayectorias se llamó apenas dos veces.
¿Qué implica para quien arma agentes hoy?
El hallazgo con consecuencias prácticas más directas no es el 53,1%, sino la caída de Opus de 69,3 a 33,0 al cambiar de ejecutor. Significa que un andamiaje afinado para un modelo no es un activo portátil: al migrar de proveedor hay que revalidar, no solo cambiar la clave de la interfaz de programación. Para equipos pequeños en Chile y la región, que suelen alternar entre modelos según el precio por millón de tokens, ese costo oculto de revalidación puede superar el ahorro del cambio.
Los detalles completos están en el artículo y en la página del proyecto.