Mistral AI presentó Voxtral 3, un SDK para construir agentes de voz y una nueva familia de modelos de habla pensados para conversaciones de varios pasos en tiempo real, en más de 50 idiomas. Combina transcripción precisa, síntesis de voz natural que adapta la emoción e integración con herramientas para automatizar flujos de trabajo. Está disponible en la API de Mistral alojada en la Unión Europea o para desplegar en infraestructura propia.
Según Mistral, la transcripción y la generación de voz avanzaron mucho, pero construir agentes de voz completos que escuchen, razonen, interactúen y manejen flujos de trabajo complejos sigue siendo difícil.
La empresa plantea que un agente de voz confiable tiene que hacer cuatro cosas muy bien y al mismo tiempo.
- Escuchar con precisión en distintos idiomas, acentos y hablantes, y con interrupciones.
- Razonar a fondo sobre lo que el usuario quiere decir en cada contexto.
- Hablar con naturalidad, con emoción y expresividad.
- Actuar en varios pasos a través de sistemas conectados.
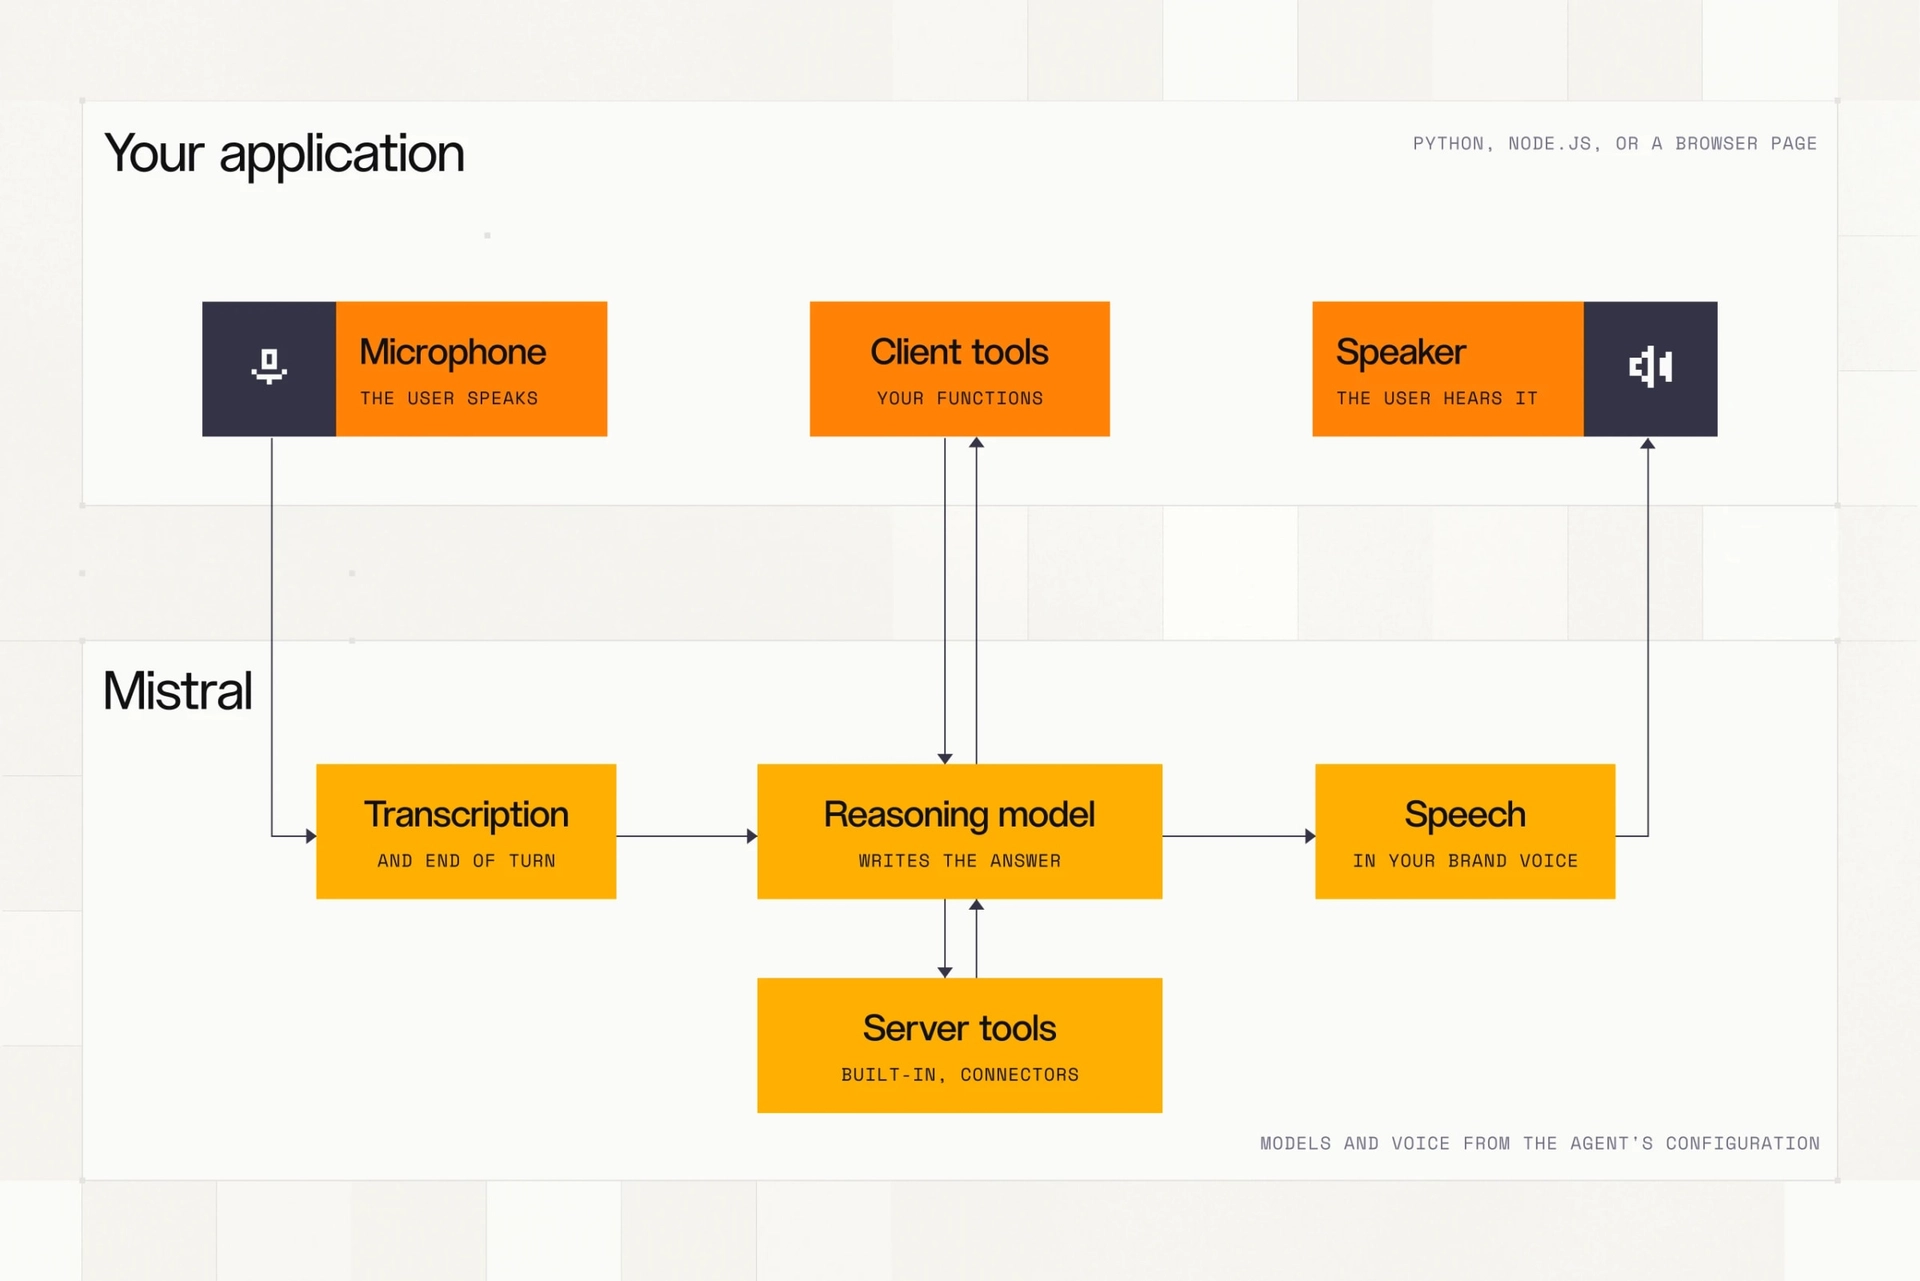
Lograr que las cuatro funcionen juntas y en tiempo real sigue siendo un desafío. Para eso Mistral presenta Voxtral 3, una familia de modelos de voz a texto y de texto a voz, junto con un SDK que reúne escuchar, pensar, llamar herramientas y hablar en un solo flujo de transmisión en tiempo real.
Voxtral 3 apunta a centros de contacto, mesas de ayuda, asistentes virtuales y copilotos manos libres. Con soporte para decenas de idiomas, voz expresiva, razonamiento e integración con herramientas y datos propios, los agentes pueden interpretar intenciones con matices, resolver pedidos elaborados y ejecutar acciones de varios pasos en sistemas conectados.
Como el resto de los modelos de Mistral, la familia está diseñada para un despliegue soberano. Se puede usar hoy en la API alojada en la UE o instalar en infraestructura propia, lo que le da a cada organización el control sobre dónde se procesa el audio, cómo se manejan los datos y si las conversaciones se guardan.
Lo principal del anuncio
- Transcripción en más de 50 idiomas. El modelo de voz a texto Voxtral Small Transcribe 3 identifica quién dijo qué (diarización), usa frases clave para mejorar la precisión (sesgo de contexto) y detecta cuándo la persona terminó de hablar para que el agente responda sin demora (detección de fin de turno).
- Voz que se adapta a la conversación. El modelo de texto a voz Voxtral Mini TTS 3 trae voces nuevas que ajustan emoción, ritmo y énfasis según el contexto, en más de 35 idiomas y más de 50 dialectos.
- Un SDK de agentes de voz. Junta escucha, razonamiento, llamado de herramientas y habla en una experiencia en tiempo real. Los agentes pueden buscar información, interactuar con sistemas de la empresa y completar tareas durante una conversación en vivo por teléfono o web.
- Pro Voice. Para usos profesionales donde la clonación básica no alcanza, la adaptación Pro Voice reproduce el carácter, el rango emocional y el estilo de un hablante en distintos idiomas a partir de solo 30 minutos de audio.
- En infraestructura propia. Se puede usar la API de Mistral alojada en la UE o desplegar Voxtral 3 en servidores propios, manteniendo las conversaciones sensibles dentro del entorno y decidiendo si se guarda algún audio.
Los modelos se prueban desde la consola de Mistral y la documentación detalla su uso.
¿Qué tan bien transcribe Voxtral 3?
Mistral presenta Voxtral Transcribe 3 como un avance en transcripción, diarización y sesgo de contexto. La lista de idiomas sube a 50, entre ellos los 24 idiomas oficiales de la UE y varias lenguas asiáticas e índicas con pocos recursos.
Según la empresa, la versión Small logra resultados de punta en diarización y transcripción multilingüe, incluidos inglés, francés y español, y supera a Whisper, Scribe v2 y Gemini 3.5 Transcribe. La variante Mini tiene 4.000 millones de parámetros y cuesta 0,0035 dólares por minuto.
Los dos modelos admiten sesgo de contexto. Se les entregan términos clave y texto libre para orientar la transcripción y reconocer mejor la jerga técnica, lo que permite usarlos en producción con vocabulario de un área específica sin ajuste fino.
Voxtral Realtime Transcribe 3 es un modelo de transcripción en tiempo real pensado para agentes. Transcribe con latencia bajo 500 milisegundos en más de 35 idiomas, con diarización y sesgo de contexto.
La predicción de fin de turno viene integrada y combina información acústica y semántica para saber cuándo el usuario terminó de hablar. Eso permite agentes de baja latencia y reduce los cortes en falso cuando el usuario hace una pausa antes de terminar.
¿Cómo suena la síntesis de voz?
Voxtral Mini TTS 3.0, disponible en modo por lotes y en tiempo real, entrega según Mistral expresividad y seguimiento de instrucciones de primer nivel en más de 35 idiomas y más de 50 dialectos. A 13 dólares por millón de caracteres, la empresa afirma que cuesta menos que modelos comparables como TTS-1 de OpenAI, Deepgram, ElevenLabs Flash y Gemini Flash.
| Modelo | Uso | Dato publicado |
|---|---|---|
| Voxtral Small Transcribe 3 | transcripción | 50 idiomas, con diarización |
| Voxtral Mini Transcribe 3 | transcripción | 4.000 millones de parámetros, 0,0035 dólares por minuto |
| Voxtral Realtime Transcribe 3 | transcripción en vivo | latencia bajo 500 ms, más de 35 idiomas |
| Voxtral Mini TTS 3 | síntesis de voz | 13 dólares por millón de caracteres, más de 35 idiomas |
El modelo interpreta el significado del contexto y produce habla natural con una gama amplia de emociones e idiomas. Entre las funciones nuevas o mejoradas están la clonación de voz a partir de 30 minutos o más de audio, el seguimiento de instrucciones personalizadas, la síntesis contextual y una biblioteca de vocabulario, todas orientadas a que la voz sea confiable en producción. Las variables de instrucción explícita incluyen emotion, pacing y emphasis.
En sus ejemplos, Mistral muestra cómo el modelo resuelve pronunciaciones fuera de lo común con pistas fonéticas, como el nombre de la ciudad de Reims en francés o un asistente ficticio llamado Quivello en italiano. También lee correos electrónicos, horarios, fechas y montos en libras dentro de una frase de atención al cliente.
Según la empresa, toda habla natural depende de la emoción, que define la prosodia, el ritmo, la velocidad, el énfasis y las transiciones. Voxtral TTS interpreta el contexto del texto para decidir la emoción y el estilo de voz sin instrucciones ni muestras adicionales.
Acentos locales en más de 35 idiomas
Voxtral TTS soporta más de 35 idiomas y dialectos regionales. Mistral dice que sus evaluaciones multilingües consideran diferencias de pronunciación entre dialectos, registro formal e informal, ortografía, extensión y convenciones locales para horas, fechas, temperaturas, direcciones y monedas.