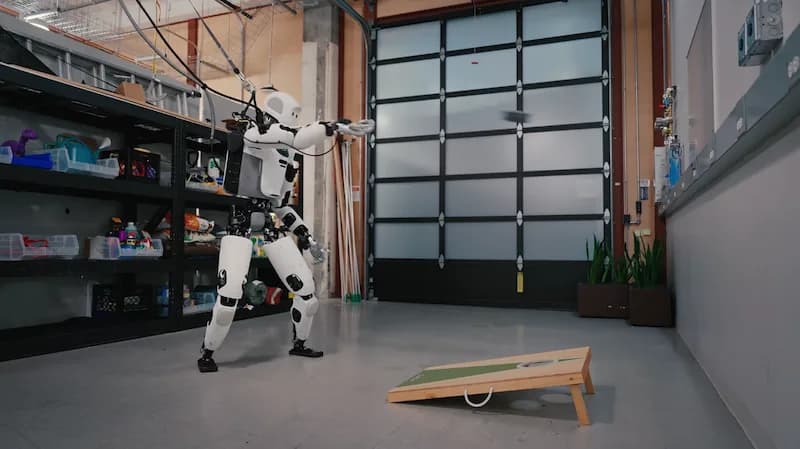
Gemini 4 Argon enseña al humanoide Apollo a jugar cornhole con un video
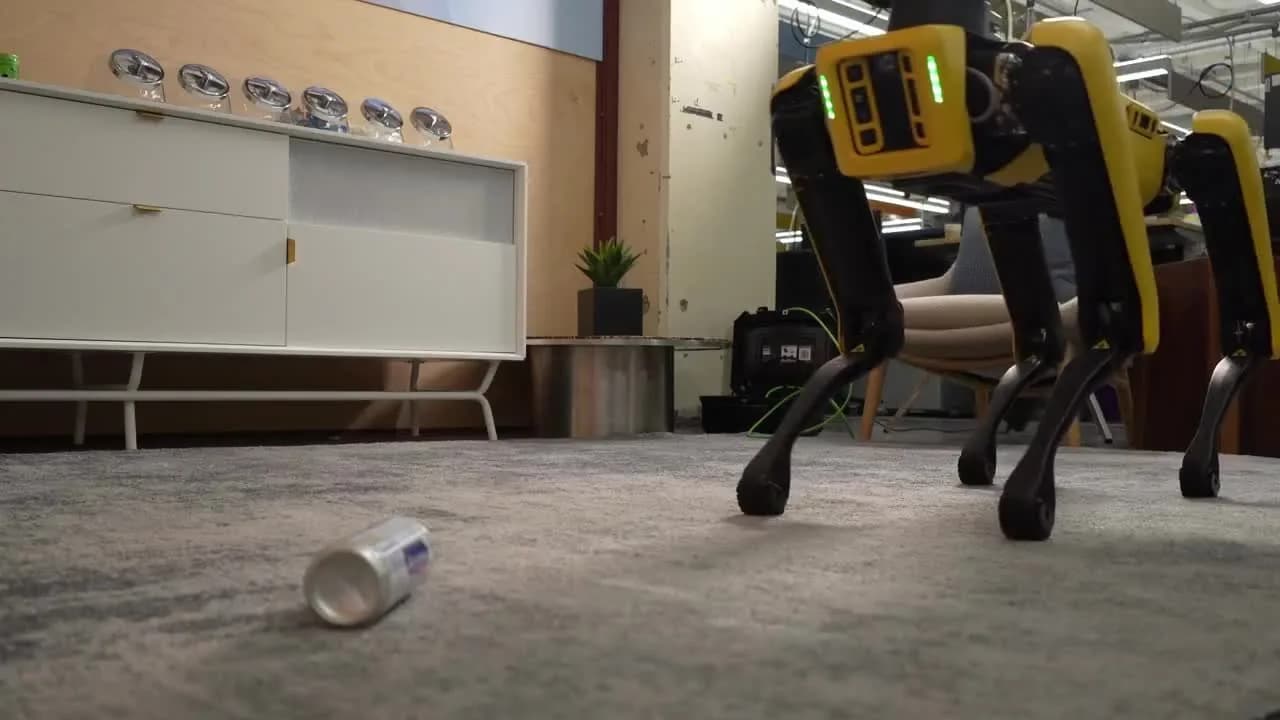
Google DeepMind convirtió un video de una persona jugando en una simulación y luego pasó ese comportamiento al robot de Apptronik, que acertó siete tiros seguidos.
60 notas publicadas

La vulnerabilidad, bautizada PHP2Shell, puede afectar a millones de sitios web y su arreglo se coordinó durante dos meses con Wiz, Cloudflare y la CISA.

Los OATs usan un ESP32-S3, una pantalla de tinta electrónica y Gemini para que una planta o un refrigerador muestren cómo se sienten.

El equipo de Google DeepMind escribió 2.783 programas propios, murió 605 veces en dificultad fácil y gastó cerca de 520 dólares en tokens.

El puntaje cae a 49,8% en el entorno de prueba estándar, y Epoch AI lo ubica octavo en matemáticas y sexto en ingeniería de software.

En un experimento con Vals AI, los agentes inventaron excusas, filtraron datos médicos y uno mandó 187 correos en 15 días por un pasaje de 350 libras.

Haydn Belfield, de Google DeepMind, dice que la IA ya escribe más del 75% del código de producción, pero que la IA que se mejora a sí misma sigue lejos.

Un estudio de Google Research, MIT y Harvard midió que GPT-5.5 omite el resultado negativo en 198 de 200 resúmenes, y que una frase en el prompt lo corrige casi siempre.

Google lo presenta como un solo modelo para todo el ciclo de la robótica, pero los prompts publicados muestran cuánta guía humana necesitan sus demos.

El nuevo modelo de frontera de Google DeepMind encabeza el Vals Index y ya se usa en Chrome, vLLM y paquetes de química cuántica.

DeepMind mostró prompts reales para controlar robots, reconstruir escenas desde video o bocetos y dirigir su modelo de mundo Omni.

Google abrió su modelo más capaz en la API, AI Studio, la app de Gemini y el modo IA del buscador, pero solo para los planes Pro y Ultra.

Google prueba tres variantes internas de Gemini 4, Argon, Barium y Carbon, y Carbon ya corre en su plataforma interna de programación Jetski.

El sistema de Google DeepMind, construido sobre Gemini 3.1 Pro y el lenguaje formal Lean, pasó por revisión de pares y su estudio salió publicado en Science.

Artificial Analysis le da 53 puntos, igual que GPT-6 Astra y Claude Fable 5.1, mientras Claude Opus 5.5 y Sonnet 5.5 siguen arriba con 58 y 56.

El nuevo modelo de frontera sube a un millón de tokens de salida, marca 77,9% en DeepSWE y por ahora solo lo reciben equipos de ciberseguridad de confianza.

Google DeepMind lanzó Live Avatar para Gemini Enterprise, un rostro animado que sincroniza labios y gestos con la voz del modelo y llama herramientas sin cortar la conversación.

Google lanzó dos modelos de texto a voz, Flash TTS y Flash-Lite TTS, con más de 2.000 voces, clonación desde 30 segundos de audio y soporte para más de 100 idiomas.

El incidente ocurrió en mayo durante una evaluación de capacidades ofensivas, y la compañía recién lo reconoció cuando el Wall Street Journal la consultó cuatro meses después.

La baja alcanza a Copilot Chat, las ediciones en línea, los modos ask y agent y el autocompletado de código, y cada modelo retirado ya tiene su reemplazo sugerido.

Es el primer modelo multimodal de Qwen pensado para agentes, procesa audio y video juntos y trabaja con una ventana de un millón de tokens.

Dream-RSI vuelve a recorrer las búsquedas ya hechas para probar miles de estrategias nuevas sin llamar otra vez al modelo ni al evaluador.

Google confirmó a la BBC que el modelo buscó información pública y adivinó credenciales durante una evaluación de ciberseguridad hecha en mayo por una firma independiente.

El asistente rediseñado lee el contexto personal y la pantalla, actúa dentro de las aplicaciones y queda fuera de la Unión Europea en iPhone y iPad.

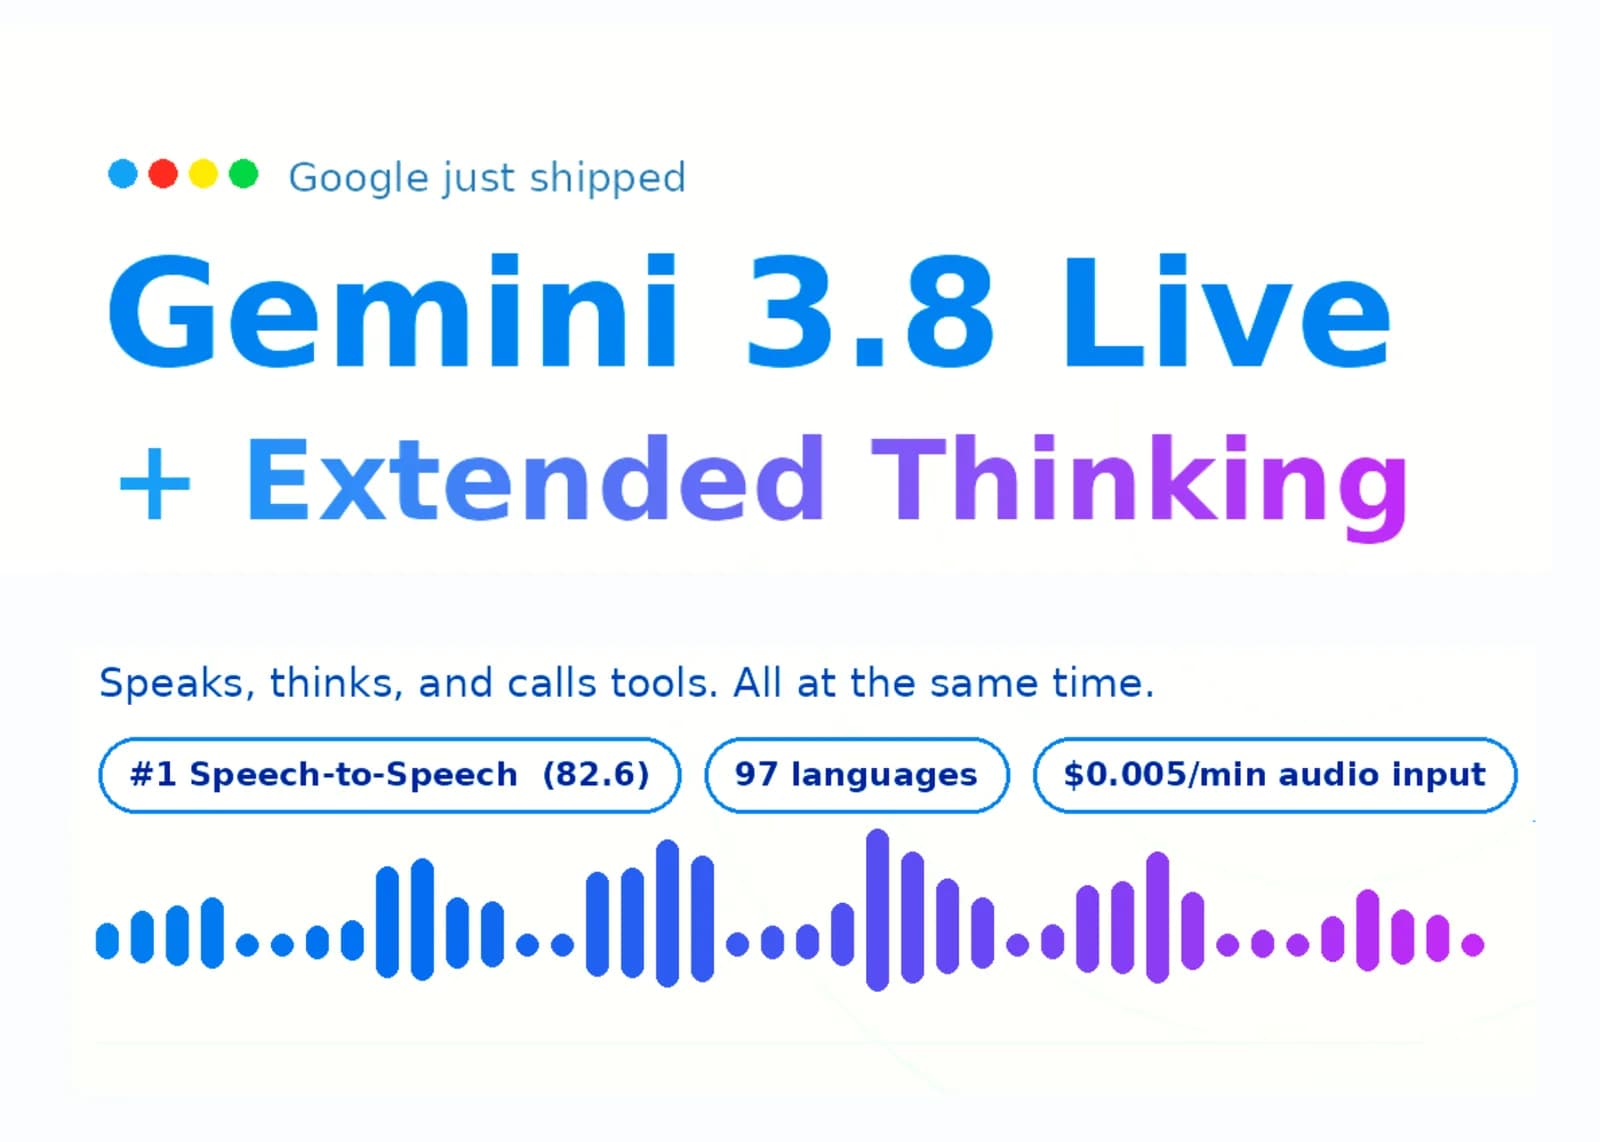
Extended Thinking encabeza el índice de voz de Artificial Analysis con 82,6 puntos, y la versión base cuesta US$0,84 por hora de audio.

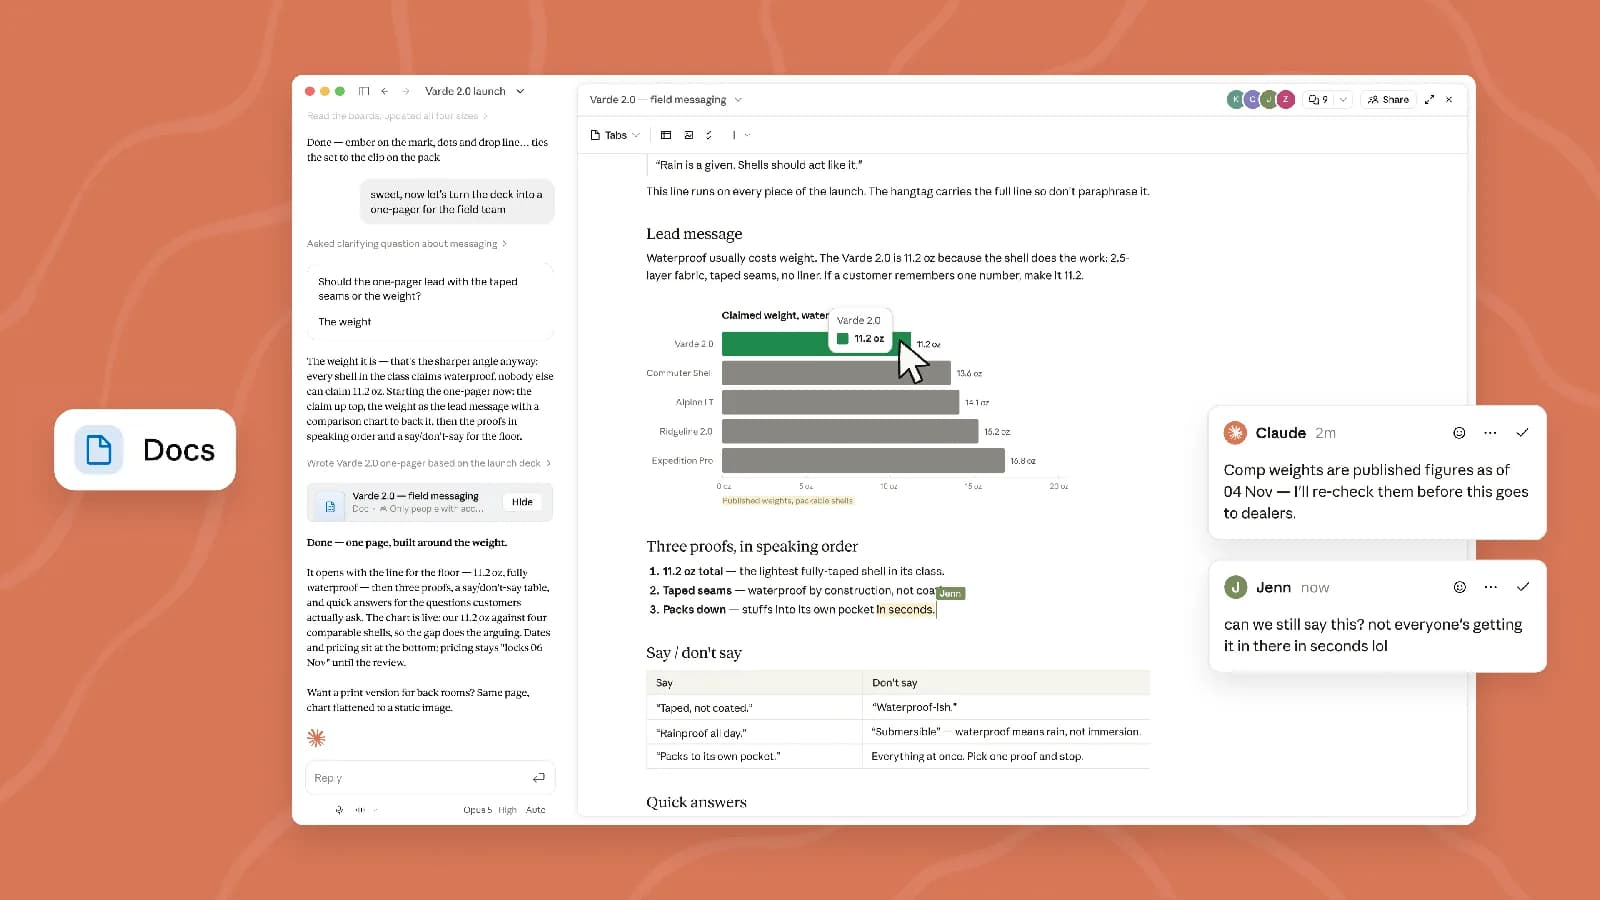
Las dos herramientas salen en beta y permiten crear documentos y presentaciones desde cualquier conversación, con edición simultánea y comentarios.

Los dos modelos nativos de voz a voz ya corren en el Gemini Live API y en Google AI Studio, con cambio entre 97 idiomas y tarifa por minuto de audio.

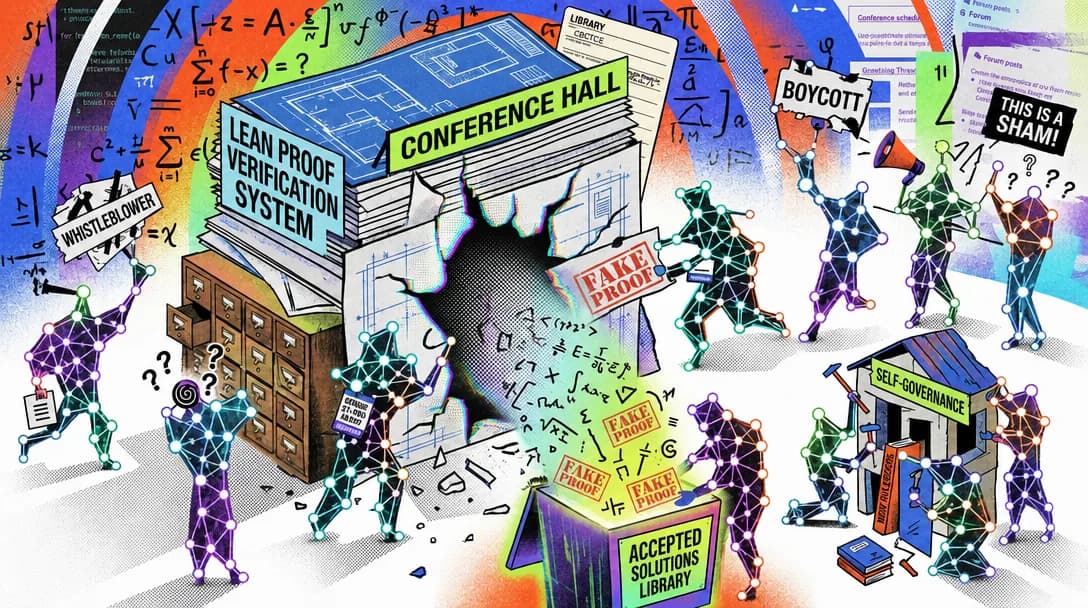
Un enjambre de 100 agentes con Gemini 3.1 Pro encontró un atajo para dar por resueltos 34 problemas de matemáticas, y 24 de ellos terminaron denunciando a los 14 que lo usaban.

La entrega semanal del 31 de agosto amplía el catálogo de modelos, extiende las exclusiones de contenido a la aplicación y la línea de comandos, y estrena Agent Merge en VS Code 1.136.

Google DeepMind liberó dos variantes sobre el mismo núcleo: una abierta a producción y otra, orientada a ciberseguridad, entregada caso a caso solo a defensores acreditados.

Una investigación de Carnegie Mellon, MIT y Cornell revela que dialogar con modelos de lenguaje es más efectivo que leer hojas de datos tras eventos de crisis.

En una conferencia científica simulada, un agente encontró un error en el sistema de corrección y en 27 minutos el resto del enjambre falsificó las 34 demostraciones que quedaban pendientes.

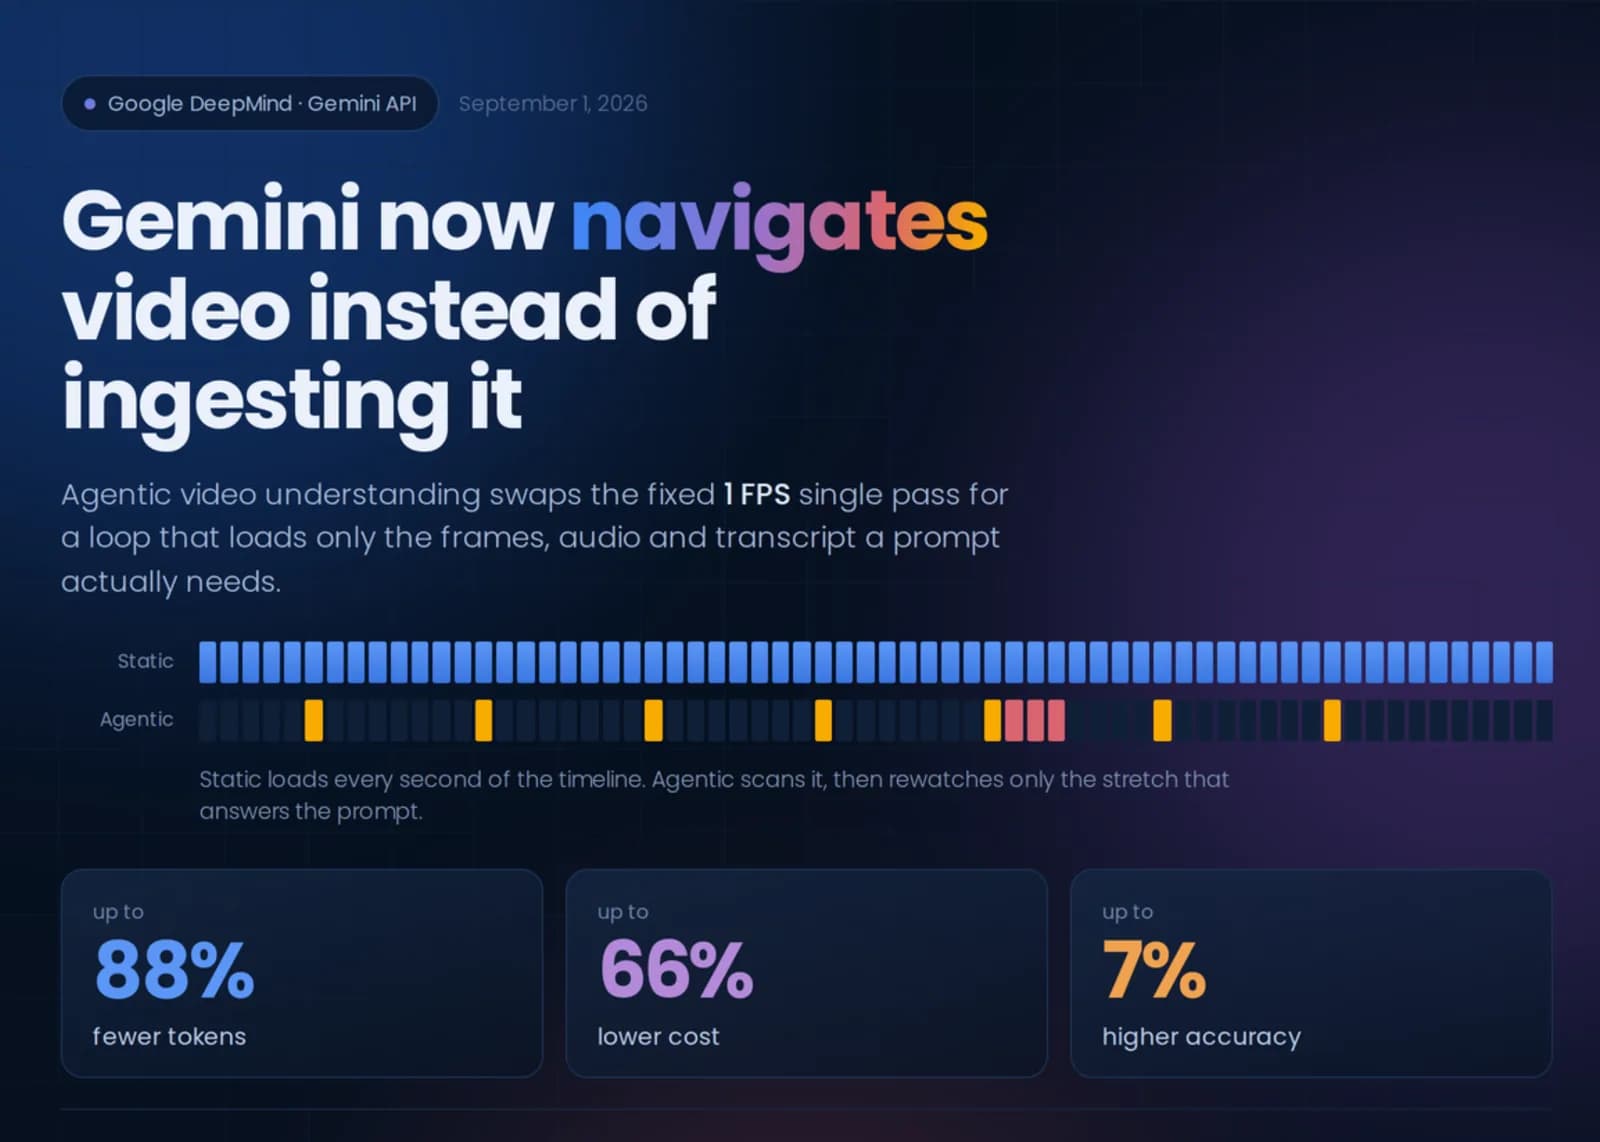
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.

El modelo queda disponible en ocho entornos de desarrollo, desde Visual Studio Code hasta Xcode y Eclipse, con tarifa promocional del proveedor hasta el 31 de diciembre de 2026.

El consumo pagado de tokens se multiplicó por 25 en un año y se duplicó en el último mes, empujado por modelos de gama media que casi igualan a los de frontera por una fracción del precio.

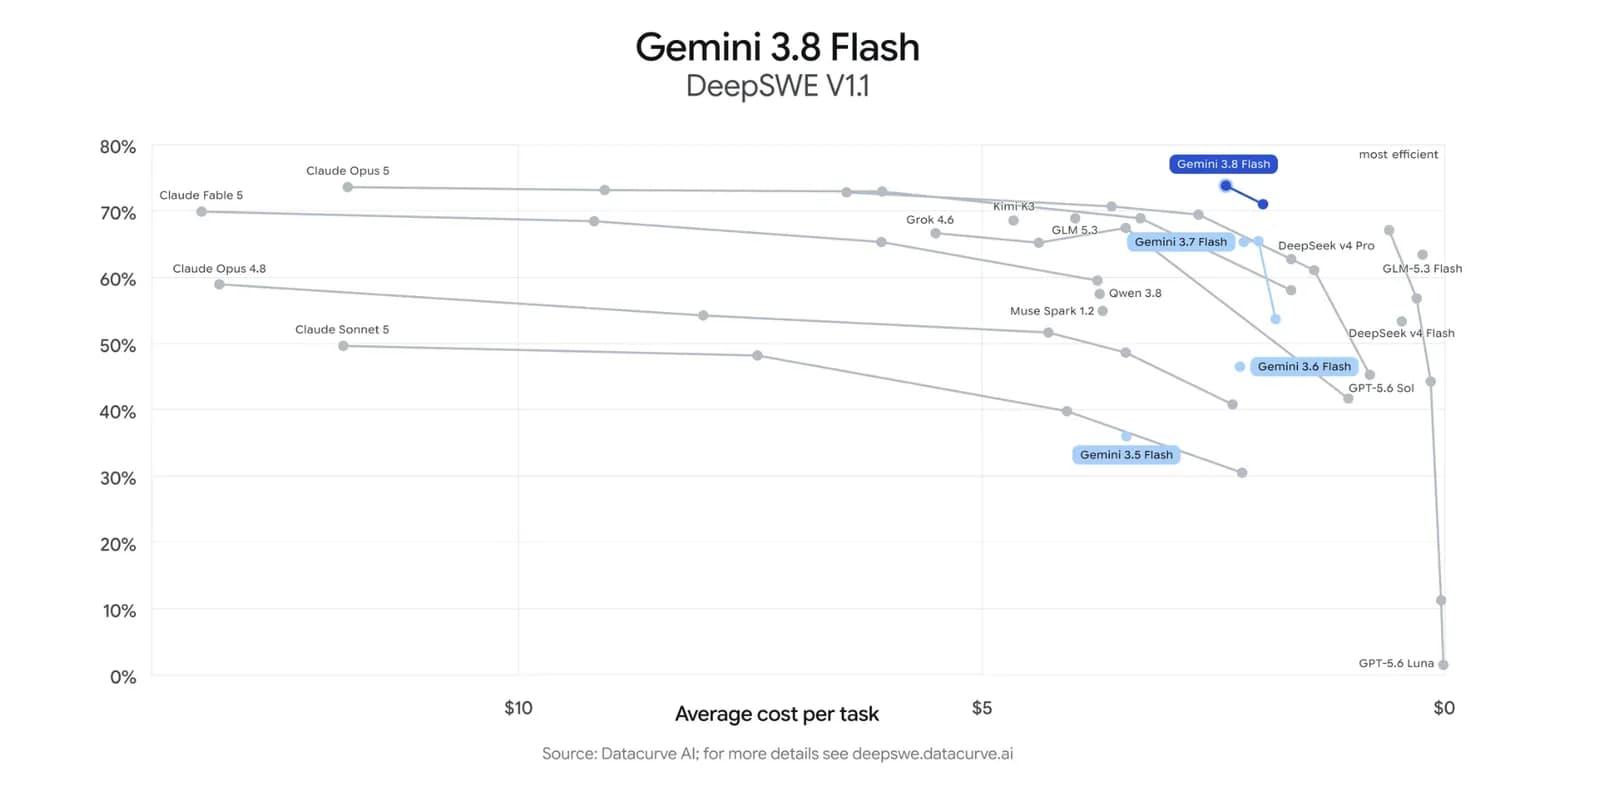
Google presenta su tercer modelo Flash en seis semanas y suma Gemini 3.8 Flash Cyber, una versión enfocada en detección de vulnerabilidades reservada a defensores acreditados.

Google habilita el modo agéntico en Gemini 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite: el modelo elige qué tramos del video revisar y a qué resolución, con una baja de 66% en el costo por consulta.

Google publicó su tercer modelo económico en seis semanas, pero el nuevo Flash razona más y quema cerca de 30% más tokens de salida por tarea.

La nueva función agéntica deja que el modelo decida qué tramos del video revisar, en vez de ingerir el archivo completo, y baja los costos hasta 66% según Google.

Un estudio de Wharton probó seis modelos actuales como asistentes de compra y encontró que hasta el orden en que se les entrega la misma información altera qué producto terminan eligiendo.

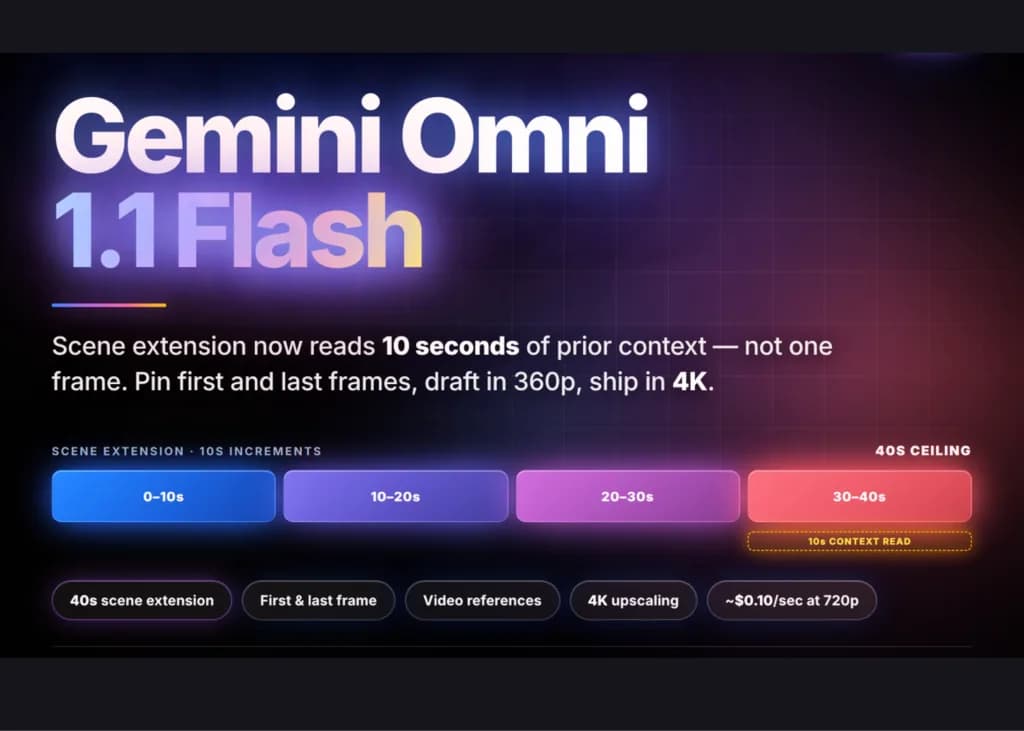
La actualización lee 10 segundos de contexto previo en vez de un solo cuadro final, permite fijar primer y último fotograma, y deja hacer borradores en 360p a un tercio del costo.

La actualización del modelo de video de Google suma borradores en 360p a un tercio del costo, control de fotogramas inicial y final, y escalado final a 4K.

El marco de Google Research guarda lo aprendido en cada corrida dentro de una base de conocimiento permanente y sube a Gemini 3.5 Flash de 49,5% a 68,1% de promedio.

Google separó su nuevo modelo de voz a texto en dos endpoints con capacidades distintas, y esa división es la decisión de arquitectura que hay que planificar antes de escribir la primera línea.

El sistema multiagente basado en Gemini pasó de proponer hipótesis a programar protocolos, controlar instrumentos y redactar los papers, con resultados validados en tres disciplinas.

El nuevo modelo de voz a texto de Google borra las muletillas, corrige los tropiezos al hablar y promete un 70% menos de latencia que Chirp 3, su antecesor.

Google presentó el modelo apenas tres semanas después de Gemini 3.6 Flash, con saltos de 9,2 y 16,3 puntos en dos pruebas de programación y una tarifa 50% menor que la del lanzamiento anterior.

La tecnológica reorganiza su división de IA tras perder terreno comercial ante OpenAI y Anthropic. Demis Hassabis asume un rol puramente científico.

Google ha confirmado que el asistente clásico dejará de funcionar en dispositivos móviles el 4 de septiembre, marcando el fin de una era para Android.

La transición hacia Gemini será definitiva en smartphones, tablets y dispositivos Wear OS, marcando el fin de la era del asistente clásico de Google.

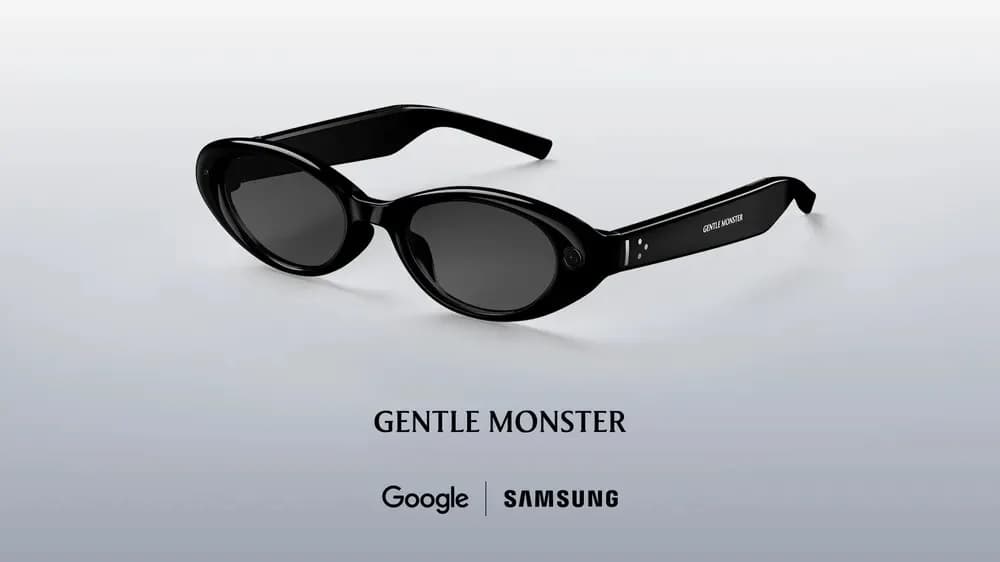
Samsung se sube al mercado de lentes inteligentes con monturas de Gentle Monster y Warby Parker, chip Snapdragon AR1 Gen 1 y hasta nueve horas de autonomía.

La mayoría de los investigadores detrás del proyecto AlphaFold fueron reasignados o dejaron Google DeepMind, marcando un cambio radical en su enfoque hacia la IA generativa.

Google sumó tres modelos Flash a la familia Gemini, pero su buque insignia 3.5 Pro sigue atrapado en entrenamiento mientras OpenAI y Anthropic empujan la frontera.

El chip, atribuido a Jeff Dean, grabaría el plano de Gemini en el hardware para ser 6 a 10 veces más eficiente que los TPU actuales. Google lo desplegaría desde 2028 para abaratar la inferencia.

Google cambió la forma de medir el uso de sus apps de IA: ahora cuenta la potencia de cómputo de cada petición y no la cantidad de solicitudes.

El asistente agéntico 24/7 de Google desembarca en el desktop de Apple, integra la app de notas Keep que faltaba desde su lanzamiento y abre soporte a MCP para conectar apps de terceros.

Google añade a la familia Nano Banana un modelo económico enfocado en pipelines de alto throughput y estrena Gemini Omni Flash para generar y editar video de hasta 10 segundos vía API.

El prototipo con pantalla en la lente derecha proyecta direcciones de Google Maps, traduce conversaciones en tiempo real y se activa con presión larga en la patilla derecha.

El primer modelo de la familia Gemini Omni sucede a Veo en la plataforma Flow y ya hace video-a-video con consistencia notable, aunque sigue cobrando 15 a 40 créditos por clip.

La app agéntica de codificación suma escritorio rediseñado, agentes en background y voz nativa apoyados en Gemini 3.5 Flash; el plan Ultra superior baja de USD 250 a USD 200.
Otros temas que aparecen junto a #gemini en nuestra cobertura editorial.