IBM mete ARM dentro de cada núcleo de su próximo mainframe
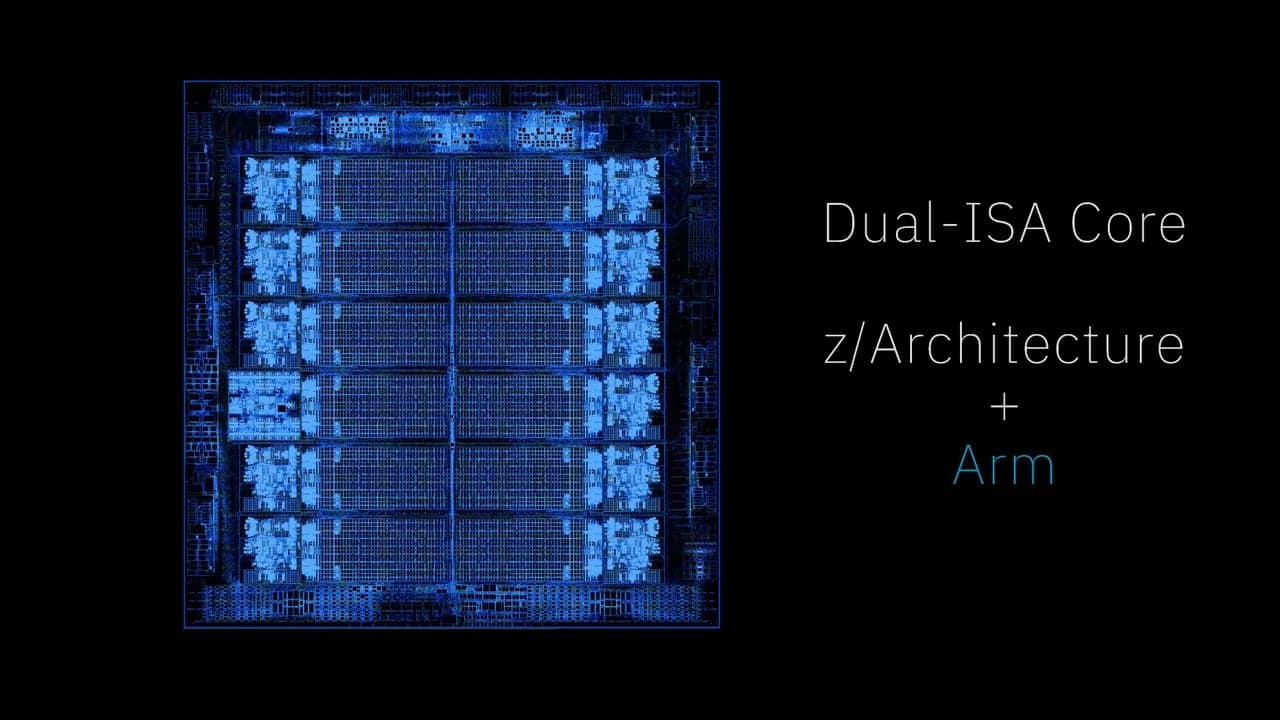
El procesador de 2 nm llevará 11 núcleos sobre 5,7 GHz que ejecutan z/Architecture y AArch64 sin emulación, y llegó junto a una tanda de anuncios ARM en la conferencia Hot Chips.
22 notas publicadas

En Hot Chips 2026 la compañía detalló una hoja de ruta de tres fases que convierte la memoria de alto ancho de banda en un subsistema con lógica y cómputo propios.

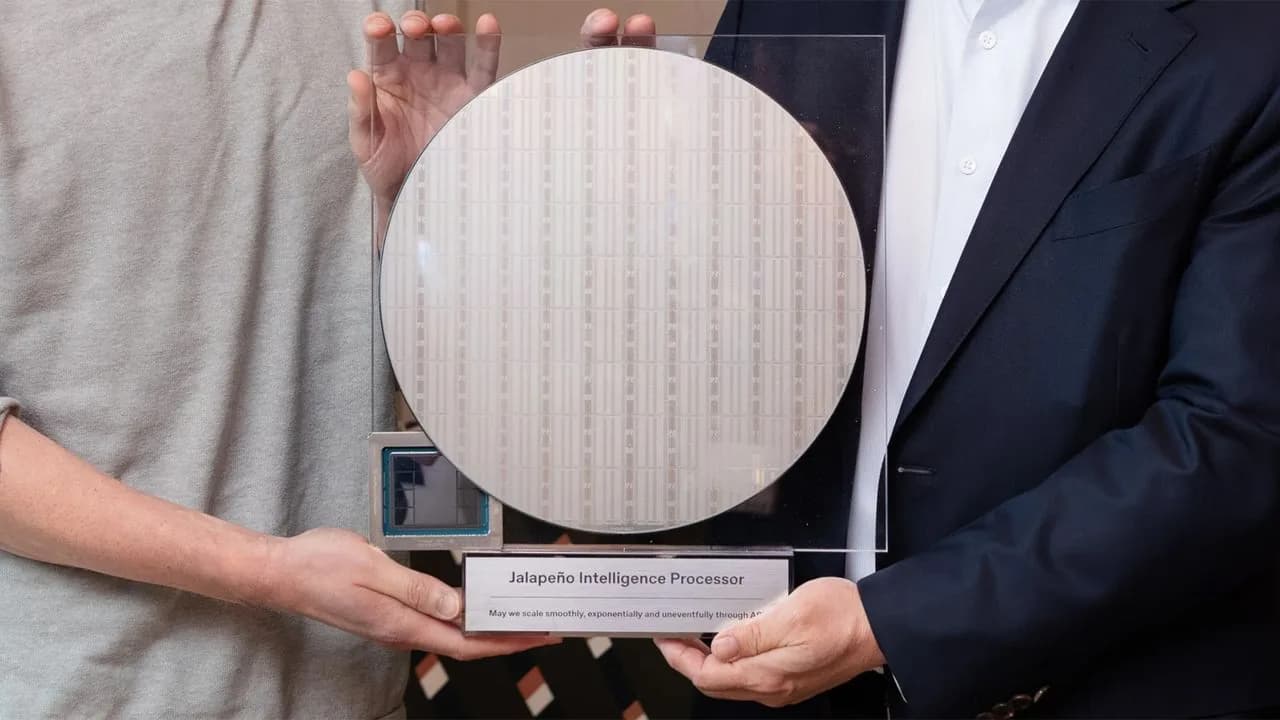
OpenAI publicó en Hot Chips 37 los primeros números de su chip de inferencia propio: entre 1,5 y 1,9 veces más trabajo por watt que los sistemas GB200 y GB300 de NVIDIA.

OXMIQ Labs mostró en Hot Chips 2026 que la nueva memoria entrega 14 veces más capacidad que la HBM a costo similar, con apenas 0,6 veces su ancho de banda agregado.

Las cifras que ambas compañías mostraron en Hot Chips corresponden a servir una sola petición a la vez, un escenario que ningún operador de inferencia sostiene si quiere ganar dinero.

El límite real de un centro de datos de IA no es el chip sino los megavatios que entran al edificio, y Nvidia propone repartirlos de forma dinámica en vez de reservar para el peor caso.

El primer acelerador generativo propio de Meta rinde 12 petaFLOPS en MXFP4 y carga con dos trabajos que casi nunca conviven en el mismo silicio.

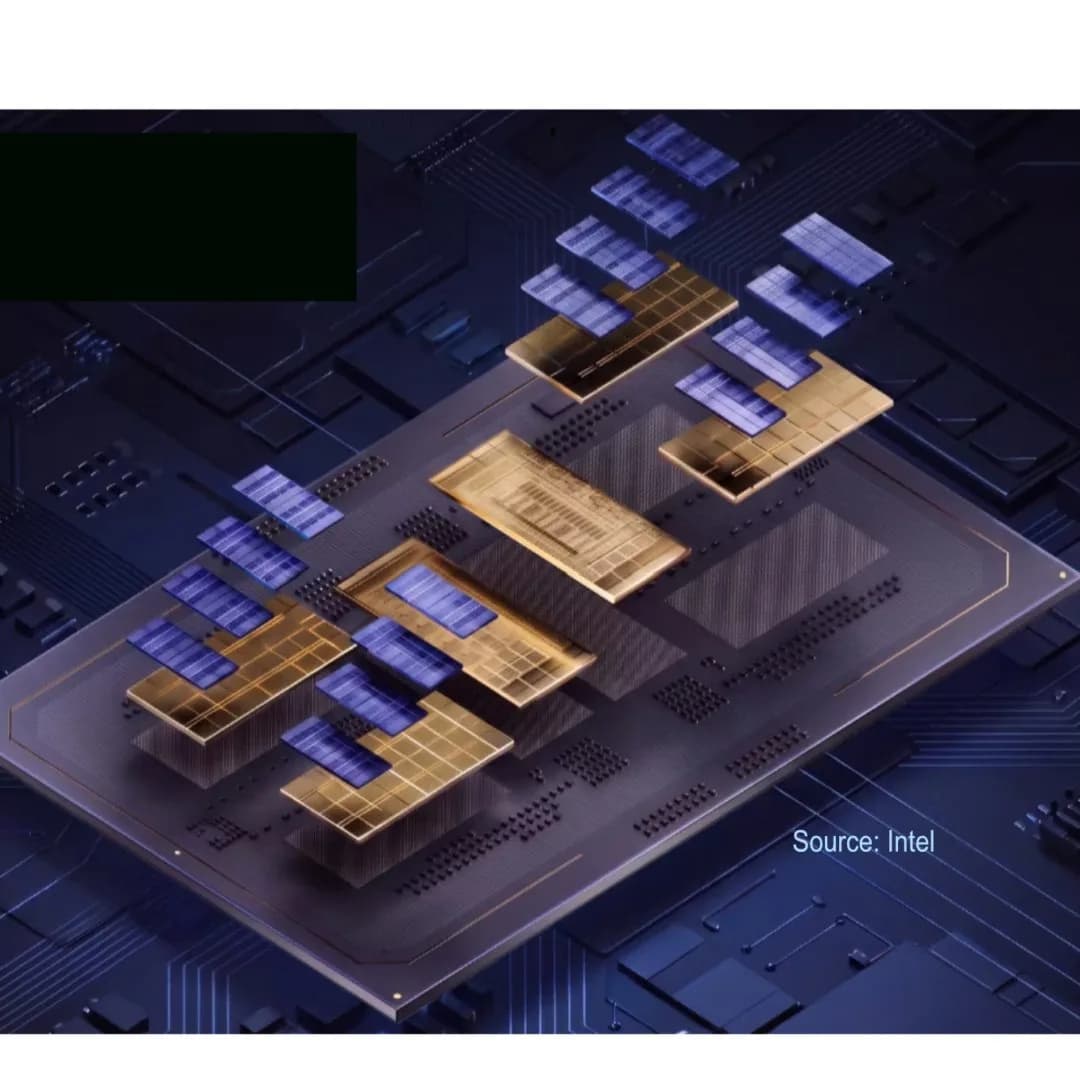
Diamond Rapids se fabrica en 18A-P, da vuelta el plano de Granite Rapids para poner memoria y entrada/salida al centro, y estrena AVX 10.2 y APX en el centro de datos durante 2027.

El procesador sin nombre comercial tendrá 11 núcleos sobre los 5,7 GHz y llegaría en 2028, con la promesa de correr instrucciones de mainframe y de Arm de forma concurrente en cada núcleo.

El CPU japonés de 144 núcleos llega en 2027 con dos versiones, 350 W refrigerado por aire y 500 W por líquido, y baja sus unidades vectoriales de 512 a 256 bits.

En Hot Chips 2026, la compañía admitió que la brecha se ensancha con cada generación y que no piensa cerrarla si el costo es resignar rendimiento.

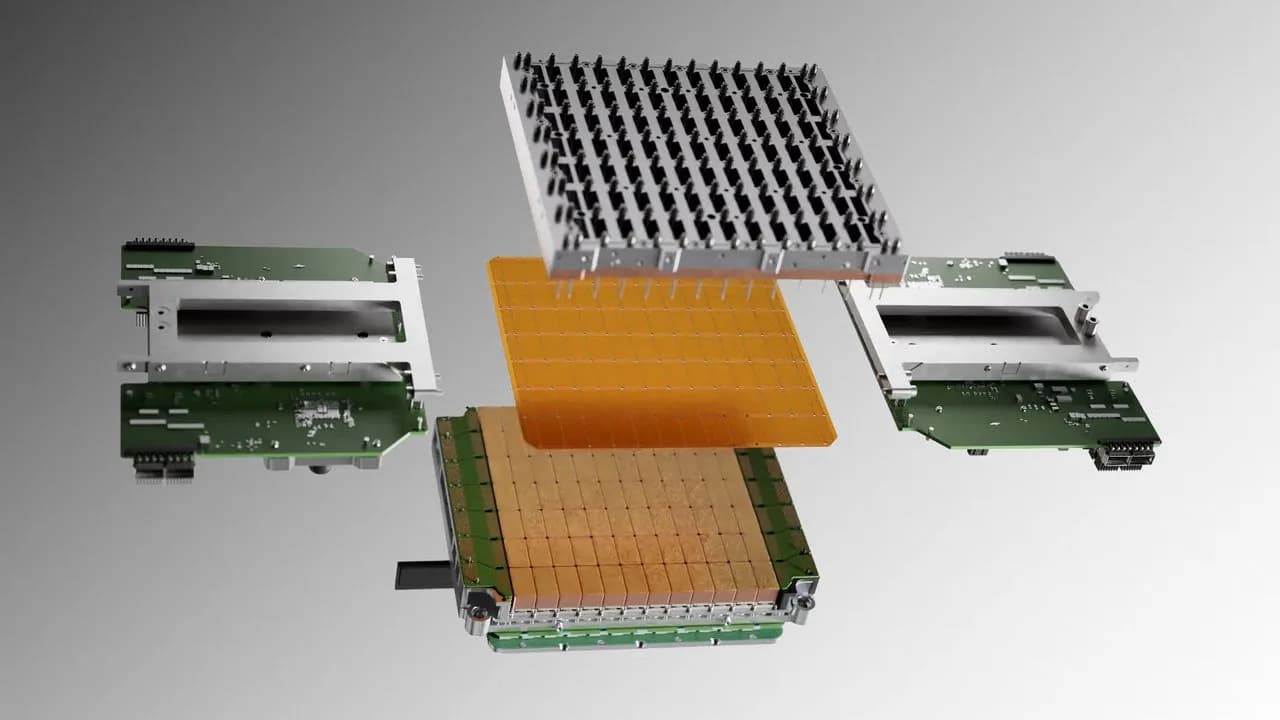
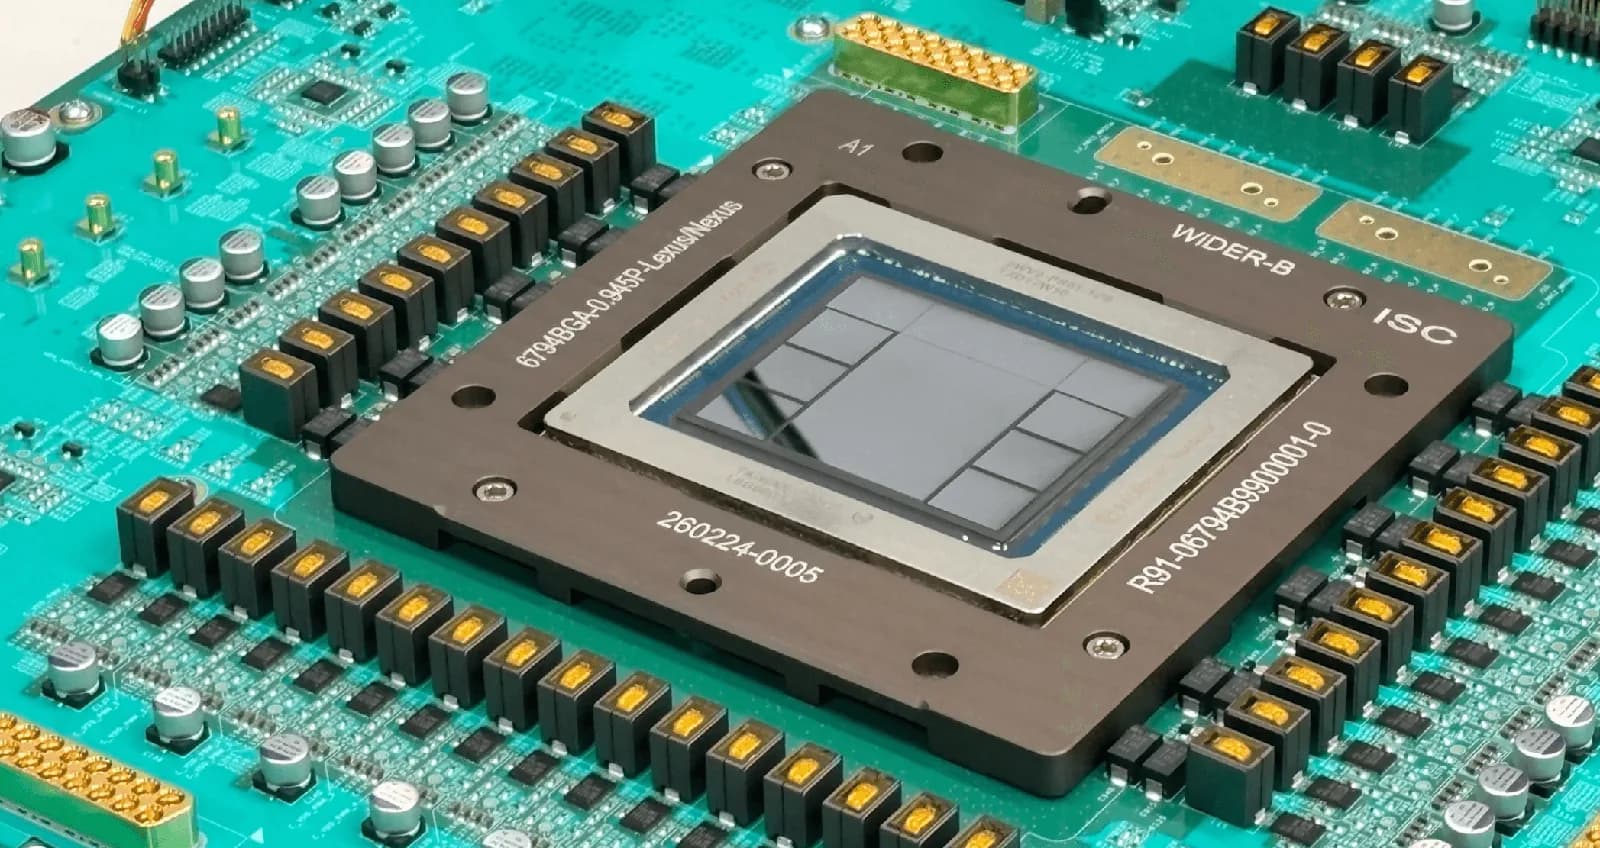
En Hot Chips 2026 la compañía mostró el rack Nexus del CS-4, que duplica la potencia entregada a cada oblea, y adelantó dos generaciones completas de su hoja de ruta.

OpenAI detalló en Hot Chips la arquitectura NUMA de su acelerador de inferencia: 216 GB de HBM4, dos redes internas separadas y más de la mitad del núcleo escrita con ayuda de sus propios modelos.

El primer acelerador propio de OpenAI, hecho con Broadcom, se llevó los mejores números de rendimiento por watt en el banco de pruebas InferenceX, aunque no pasa de muestras de ingeniería.

Nvidia presentó en Hot Chips 2026 la arquitectura del rack que heredó de Groq y publicó su primer benchmark de terceros, medido por Artificial Analysis sobre Gemma 4 31B.

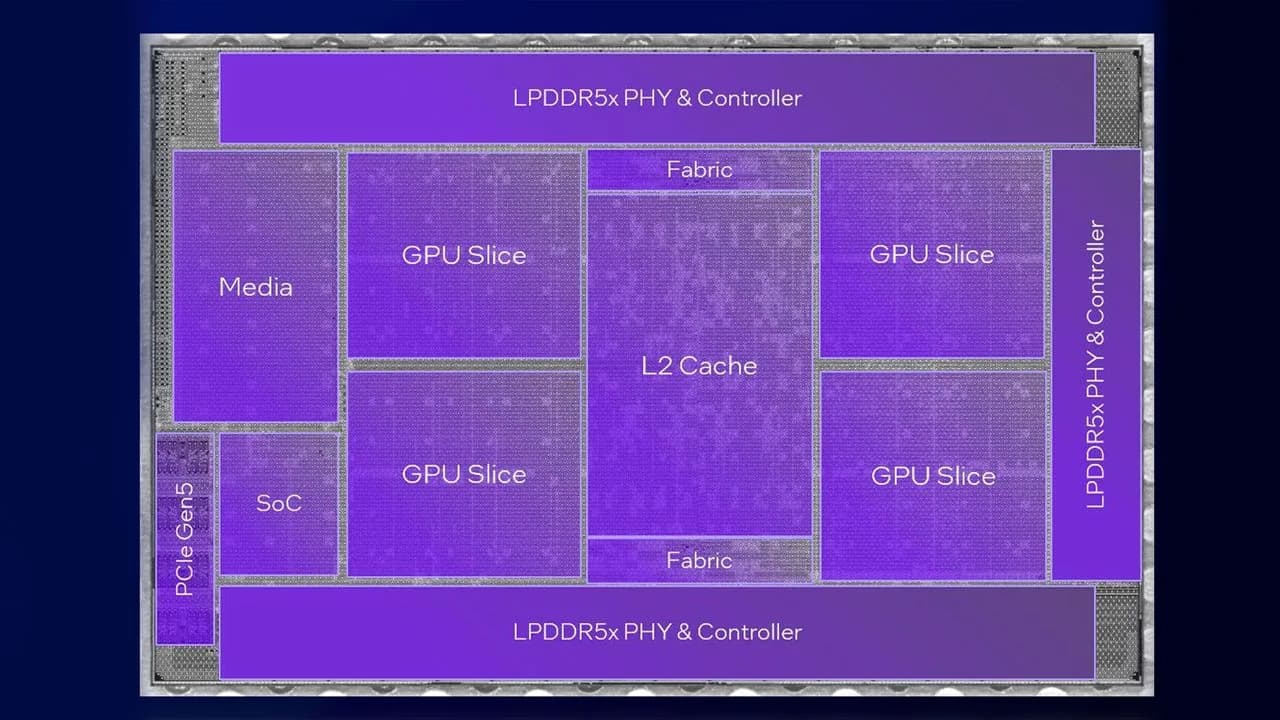
La tarjeta PCIe refrigerada por aire monta hasta 480 GB de LPDDR5X y apuesta por cachés más grandes y motores XMX más profundos en lugar de perseguir el récord de potencia bruta.

El procesador de próxima generación para mainframes se fabrica en 2 nanómetros, lleva 11 núcleos a 5,7 GHz de base y conmuta entre ambos repertorios en nanosegundos.

Raptor invierte el orden habitual del apilamiento 3D y deja el dado de cómputo arriba, pero la empresa aún no dice quién le fabrica la memoria a medida.

El procesador para servidores de IA agéntica llega con un enlace UCIe de 2 TB/s, doce canales de memoria DDR5-8800 y un consumo declarado de 300 vatios.

La primera memoria de bajo consumo con lógica integrada multiplica por ocho el ancho de banda y rinde 3,01 veces más tokens por segundo en inferencia.

OpenAI mostró en Hot Chips su acelerador desarrollado con Broadcom, pensado solo para inferencia, con producción en volumen prevista para 2027.

En Hot Chips 2026 Nvidia detalló el multihilo espacial de su primera CPU con núcleo propio, que compila el kernel un 22% más rápido que el EPYC 9655P de 96 núcleos.
Otros temas que aparecen junto a #hot chips en nuestra cobertura editorial.