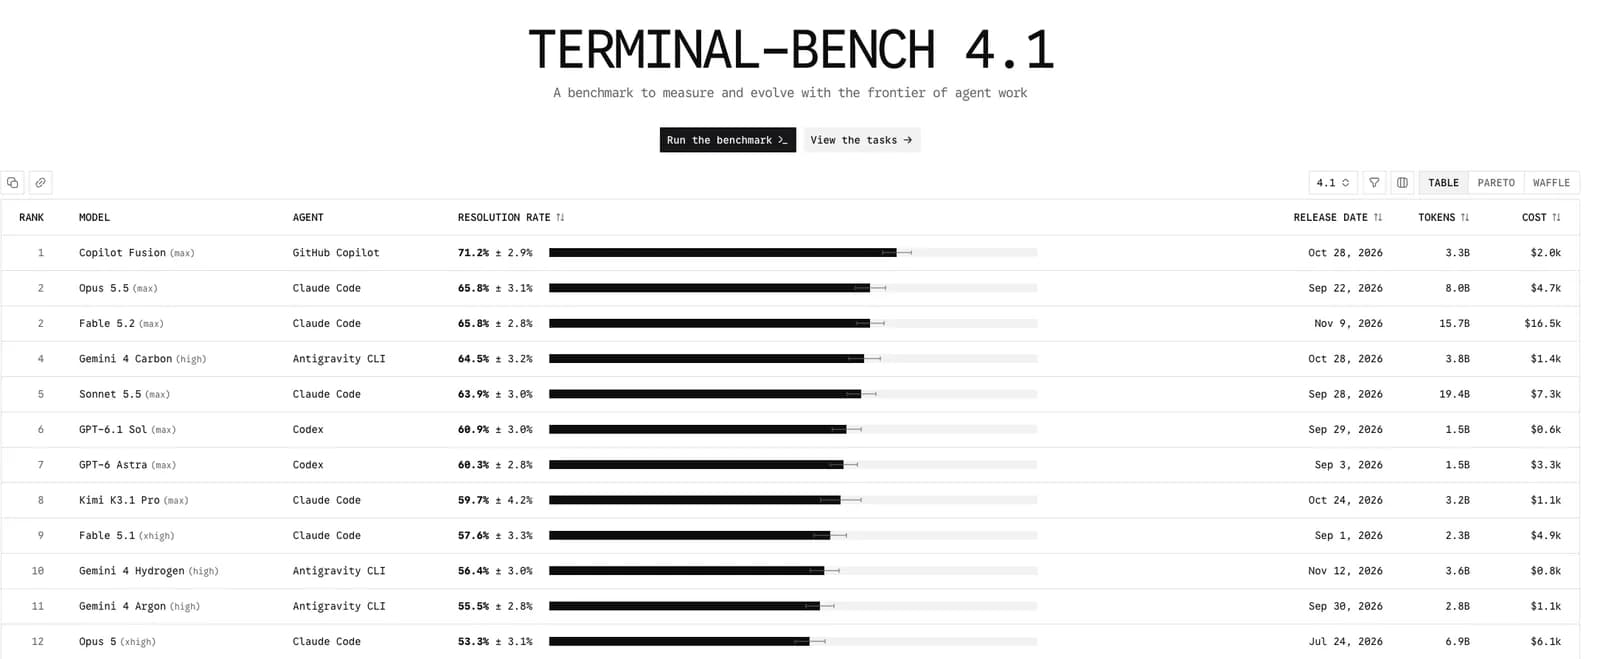
GitHub amplió Copilot Fusion el 17 de noviembre con modelos nuevos, disponibilidad en más superficies de Copilot y resultados en dos rankings públicos de Terminal-Bench. Fusion es el modo de Copilot que elige y coordina distintos modelos para cada tarea.
¿Cómo le fue en Terminal-Bench 4.1?
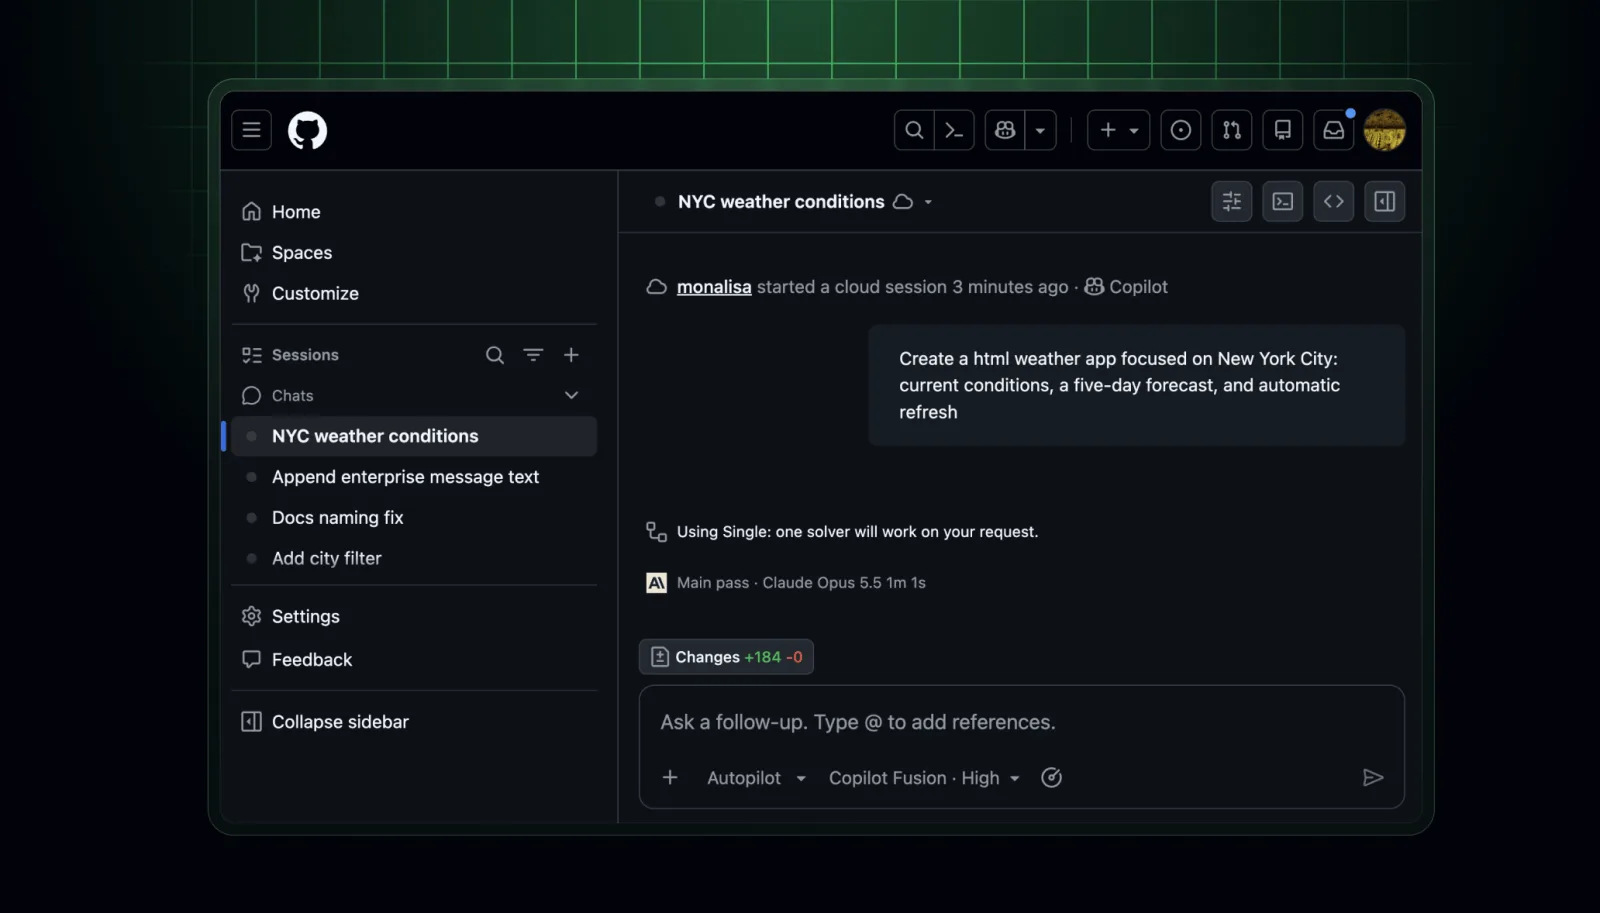
Copilot Fusion ya aparece en los rankings públicos de Terminal-Bench 4.1, que mantienen Stanford, Harbor y el Laude Institute. Ese benchmark mide qué tan bien completan los agentes de IA tareas difíciles y realistas dentro de una terminal.
Según GitHub, Copilot Fusion Max logró una tasa de resolución de 71,2%. Eso es 5,4 puntos porcentuales por encima de Opus 5.5 y Fable 5.2, los modelos de frontera que lideran la tabla. La empresa agrega que lo hizo con un costo 88% menor que Fable 5.2 y 57% menor que Opus 5.5.
GitHub destaca que los rankings independientes permiten comparar Copilot con otros agentes en las mismas tareas y con las mismas reglas de evaluación.
¿Dónde se puede usar Copilot Fusion?
Con esta versión, Copilot Fusion se puede elegir en las últimas versiones de github.com, Visual Studio y las apps beta de GitHub Mobile para iOS y Android. El soporte en las apps de producción de GitHub Mobile llegará pronto, según la empresa.
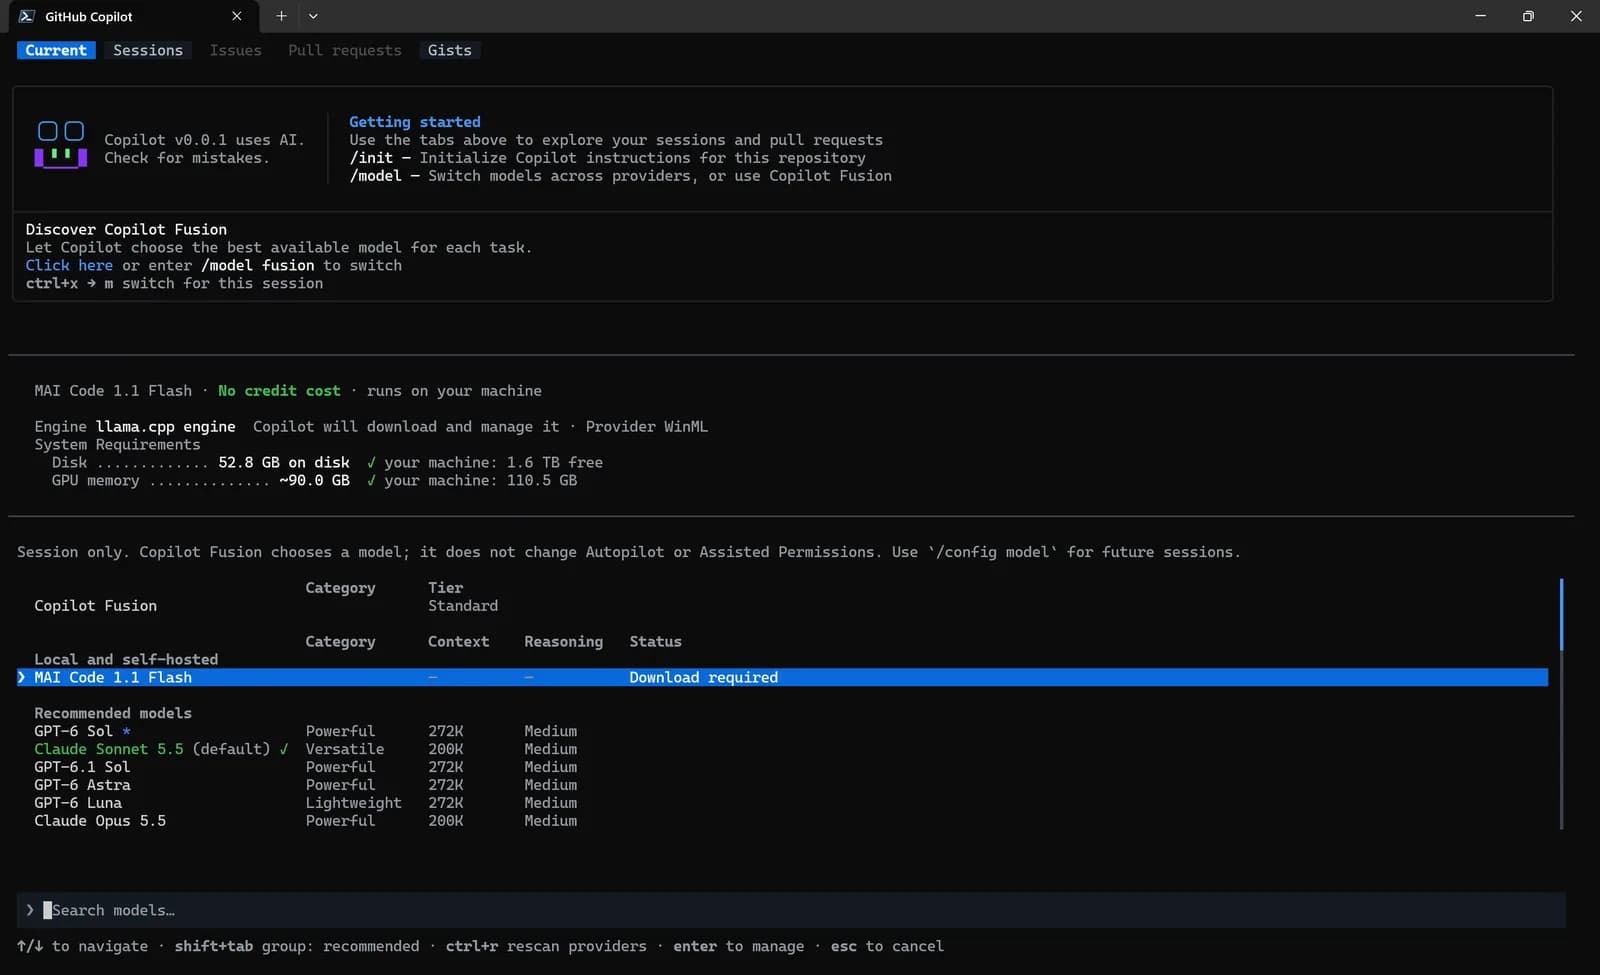
El uso es simple. Se elige Copilot Fusion en el selector de modelos y el sistema decide qué modelos usar y cómo coordinarlos en cada tarea. El usuario fija el nivel de esfuerzo y Copilot se encarga del resto.
Los tres modelos que se suman
Cada nivel de esfuerzo de Fusion recibe un modelo nuevo:
- Claude Sonnet 5.5 entra a Copilot Fusion Max.
- GPT-6.1 Terra entra a Copilot Fusion High.
- MAI-Code-2 entra a Copilot Fusion Standard.
El detalle de cómo funciona el modo está en la documentación de Copilot Fusion.