OpenAI publicó dos modelos de lenguaje nuevos. GPT-6.2 Astra apunta al trabajo profesional exigente y GPT-6.2 Sol está hecho para el uso diario. Según OpenAI, los dos superan a sus antecesores en las pruebas de rendimiento y cuestan menos de operar.
Ambos ya están disponibles para los usuarios de Plus, Pro, Enterprise y Edu en ChatGPT Work y en Codex. Los suscriptores de Pro-500 pueden usar el modo Ultrafast con los dos modelos, y por primera vez los de Pro-200 también acceden a Ultrafast, partiendo por GPT-6.2 Sol.
Los desarrolladores pueden usarlos a través de la API de OpenAI. La empresa informó que el precio de GPT-6.2 Astra es 20% más barato que el de su antecesor, con 8 dólares por millón de tokens de entrada, 0,40 dólares por entradas en caché y 40 dólares por millón de tokens de salida. GPT-6.2 Sol mantiene la tarifa de GPT-6.1 Sol, con 2 dólares por la entrada, 0,10 por entradas en caché y 10 por la salida, siempre por millón de tokens.
OpenAI presenta a Astra como el mejor modelo para científicos
OpenAI entrenó a GPT-6.2 Astra para que respete con más fiabilidad las convenciones profesionales de áreas como el derecho, las finanzas y la contabilidad. Según la empresa, las presentaciones toman la diagramación, los colores y la tipografía de las plantillas, con los tamaños de letra exactos. Los títulos de cada diapositiva buscan resumir su idea principal y el texto se concentra en los detalles que importan.
El anuncio de OpenAI se apoya sobre todo en la relación entre precio y rendimiento. En Agents' Last Exam, una prueba de flujos de trabajo profesionales de varios pasos, GPT-6.2 Astra saca 5,2 puntos más que GPT-6 Astra por menos de un tercio del costo, según OpenAI. Supera a Claude Fable 5.2 de Anthropic por 5,5 puntos con apenas el 5% del costo. Solo Gemini 4 Carbon de Google le sigue el ritmo a Astra en esta prueba.

En la prueba jurídica Harvey LAB-AA, que incluye tareas como el análisis de cláusulas de contratos, GPT-6.2 Astra duplica con creces la tasa de aprobación de Claude Fable 5.2 por cerca de un sexto del costo, según OpenAI. En GDPval-v2, una prueba interna con tareas de consultoría, finanzas y diseño, Astra sube 6,2 puntos porcentuales frente a su antecesor y usa 22% menos tokens de salida.
OpenAI dice que el uso del computador, que ya era uno de los fuertes del modelo anterior, volvió a mejorar. En las pruebas, el modelo construyó un auto en 3D, escribió un simulador de física en Python y animó los resultados en Blender. En otra demostración modeló pieza por pieza un auto a control remoto y produjo una guía de armado animada.
La empresa también asegura avances en diseño web. En AA-3D, una prueba en la que jueces humanos comparan a ciegas dos experiencias interactivas, GPT-6.2 Astra queda primero con 1.318 puntos Elo, delante de Claude Fable 5.2 con 1.271 y de GPT-6.2 Sol con 1.259.
En Terminal-Bench-Science, que mide flujos de trabajo científicos en una terminal, el modelo saca 9 puntos porcentuales más que GPT-6 Astra, otra vez por menos de un tercio del costo, según OpenAI. Astra además marca un récord en el Vals Science Index, que mide qué tan bien interpretan los modelos datos biológicos y ejecutan experimentos.
Sol casi iguala al Astra original por una fracción del precio
GPT-6.2 Sol es para quien busca un modelo rápido y de uso general para las tareas del día a día, según OpenAI. En FrontierCode 2.0, una prueba de programación que revisa si los cambios de código alcanzan el estándar de calidad de proyectos reales, Sol queda apenas 0,5 puntos detrás de Astra por un quinto del costo. OpenAI agrega que el modelo también rinde bien en tareas que no son de trabajo.

GPT-6.2 Astra y Sol también mejoraron en ciberseguridad, según OpenAI. Encuentran y explotan vulnerabilidades con más eficacia, escriben código más seguro y entregan mejores correcciones de errores, con un uso de tokens bastante más eficiente en varias pruebas. Los dos modelos alcanzan el umbral "Critical" de ciberseguridad del Preparedness Framework de OpenAI, igual que GPT-6 Astra antes que ellos.
Como respuesta, OpenAI suma salvaguardas más estrictas para las solicitudes de ciberseguridad que puedan ser riesgosas. La empresa reconoce que esas barreras harán más difícil el abuso, pero también van a limitar la investigación legítima de vulnerabilidades y las pruebas de seguridad.

OpenAI planea ofrecer los modelos nuevos a través de OpenAI Daybreak, que ya da a investigadores de seguridad verificados acceso a otros modelos con menos restricciones. Las cifras de ciberseguridad publicadas salen de pruebas internas con las salvaguardas y los clasificadores apagados. OpenAI explica su metodología en el informe de seguridad que acompaña el lanzamiento.
¿Dónde queda Astra en el índice de Artificial Analysis?
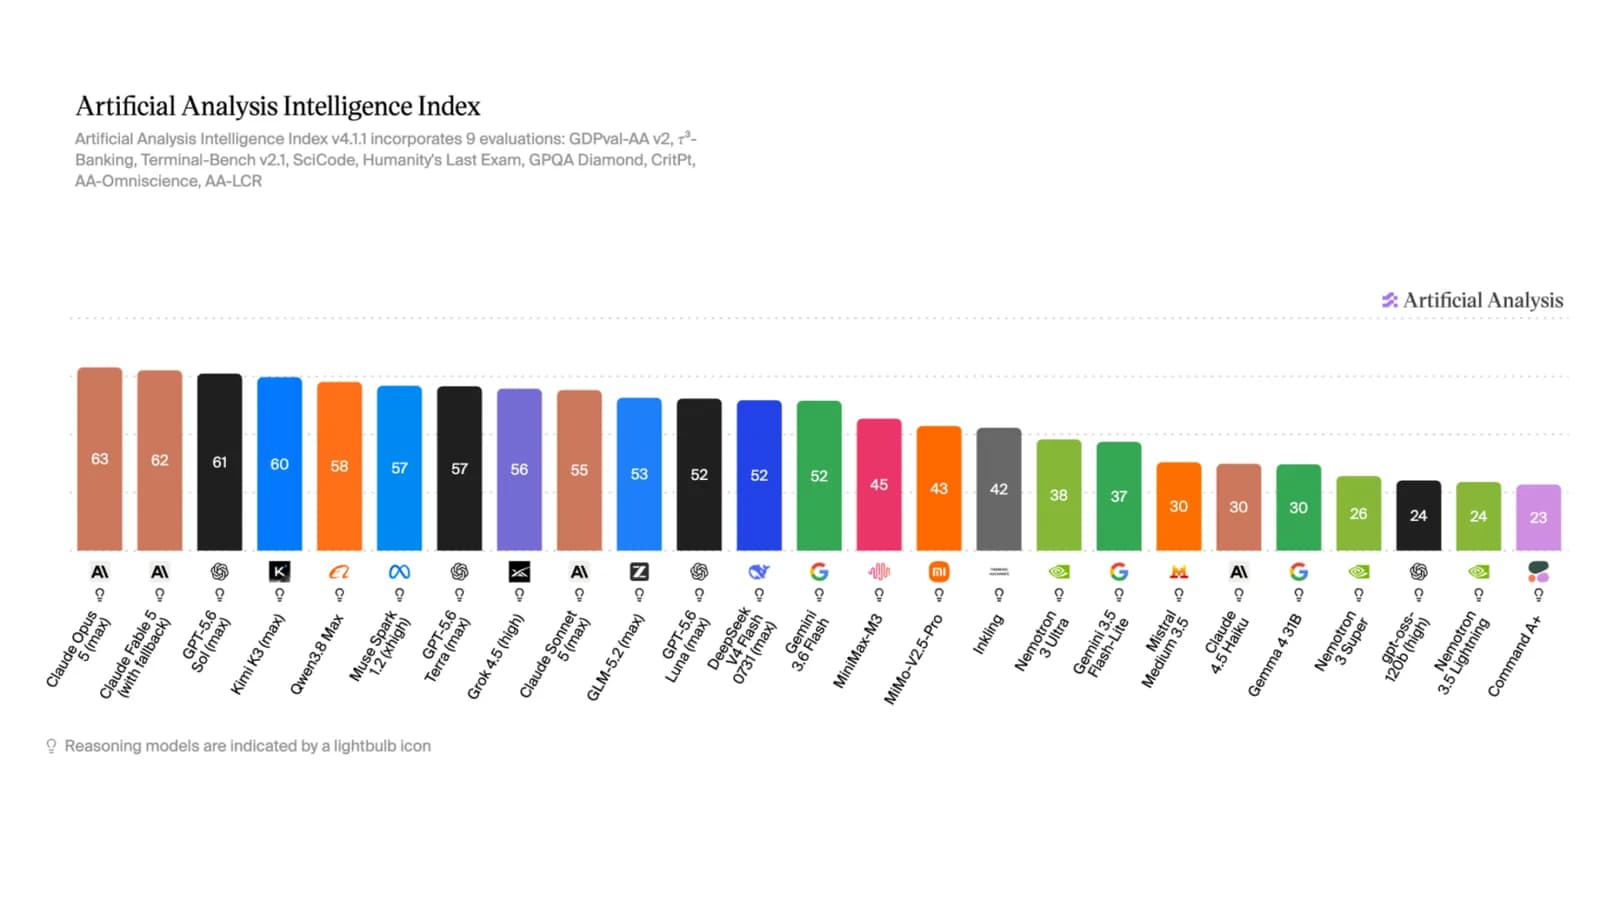
En el Artificial Analysis Intelligence Index, que reúne nueve evaluaciones de trabajo de oficina, programación, ciencia y conocimiento general, GPT-6.2 Astra termina segundo, muy cerca detrás de Claude Fable 5.2 de Anthropic. Según Artificial Analysis, Astra sube cinco puntos frente a GPT-6 Astra y supera a Gemini 4 Carbon de Google (60 puntos) y a Claude Opus 5.5 de Anthropic (59 puntos). GPT-6.2 Sol gana dos puntos y llega a 57, el mismo nivel de GPT-6 Astra con cerca del 15% del costo por tarea.
OpenAI domina la frontera de Pareto entre costo y rendimiento, la línea en la que ningún otro modelo es a la vez más barato y mejor, según Artificial Analysis. Solo modelos de Anthropic y de Meta aparecen también en esa frontera. OpenAI ocupa además la mayoría de los primeros lugares en eficiencia, medida en tokens de salida por tarea, y Claude Fable 5.2 es el único modelo de otra empresa que figura ahí.

Artificial Analysis respalda lo que OpenAI dice sobre ciencia y conocimiento factual. GPT-6.2 Astra lidera en Terminal-Bench-Science 0.1 y queda segundo, detrás de Claude Fable 5.2, en la prueba de razonamiento físico CritPt v2, en la de conocimiento factual AA-Omniscience y en la de conocimiento HLE-Diamond. Astra también lidera en diseño 3D (AA-3D) y en robótica (AA-Robotics v0.1), donde saca 79 puntos contra 78 de Sol y 75 de Claude Fable 5.2.
En programación el cuadro cambia. Según Artificial Analysis, los dos modelos se estancaron. En el Coding Agent Index, medido con el entorno de Codex al máximo de cómputo, GPT-6.2 Astra queda exactamente donde estaba GPT-6 Astra. GPT-6.2 Sol incluso pierde tres puntos frente a GPT-6.1 Sol. Esa caída viene de un retroceso de 14 puntos en SWE-Atlas-QnA-AA, donde el modelo omite datos importantes en sus respuestas con más frecuencia que su antecesor.
Artificial Analysis también advierte una tasa alta de alucinaciones. Con el esfuerzo al máximo, GPT-6.2 Astra alucina el 59% de las veces y Sol el 55%. La métrica es la AA-Omniscience Hallucination Rate, que mide cuántas veces un modelo adivina ante una pregunta factual en vez de decir que no sabe. Son preguntas muy difíciles, así que esas cifras no reflejan la tasa de alucinación del uso cotidiano.
Epoch AI ve a Astra a la par de Fable 5.2, pero más débil en tareas reales
La organización de investigación Epoch AI probó GPT-6.2 Astra en sus propias pruebas antes del lanzamiento. El modelo saca 174 puntos en el Epoch Capabilities Index (ECI), empatado con Fable 5.2 de Anthropic. Según Epoch AI, los dos modelos quedan por sobre lo que anticipaba la tendencia previa de los modelos de razonamiento antes de Astra.
En tareas reales tomadas de las investigaciones de la propia Epoch AI, Astra quedó detrás de Fable 5.2 y casi no mejoró frente a GPT-6 Astra. Según Epoch AI, en proyectos de investigación más simples el modelo perdió de vista la pregunta central y dio vueltas tratando de arreglar cosas. En una tarea sobre centros de datos de IA, Astra fue demasiado cauteloso y se saltó estimaciones importantes, algo que según Epoch AI no se le aceptaría a ningún contratista. Epoch AI calificó la redacción de Astra como relativamente buena frente a otros modelos probados, aunque bajo su propio estándar.

Llama la atención la capacidad de Astra para resolver razonamientos complejos dentro de un solo token de salida, sin una cadena de pensamiento visible. Epoch AI midió 12,3 pasos seriales para Astra, contra 10,5 de GPT-6 Astra y 4,2 de Claude Fable 5.1, que era el modelo más fuerte fuera de OpenAI en ese momento. Los modelos que razonan así sin mostrar su trabajo son más difíciles de vigilar, una preocupación de seguridad que ya surgió con el primer Astra.
En FrontierMath Erdős, una prueba de problemas matemáticos sin resolver, GPT-6.2 Astra resolvió 7 de 68 tareas, cada una verificada formalmente en el asistente de demostraciones Lean. El récord anterior era 3 de 68, de GPT-6.1 Sol. Uno de los siete problemas no tenía solución conocida hasta ahora.
Vals AI pone a Astra y Sol entre los diez primeros, con fallas en derecho
GPT-6.2 Astra queda séptimo y GPT-6.2 Sol noveno en el Vals Index, separados por apenas 1,6 puntos. La diferencia de precio es grande. Sol cuesta 3,18 dólares por tarea, menos de un tercio de los 10,68 dólares de Astra, y es el modelo más barato del top 10, según Vals AI. Astra también se abarató frente a su antecesor. Saca 2,6 puntos más que GPT-6 Astra por cerca de la mitad de sus 21,28 dólares por tarea. Vals AI agrega que Astra es el que menos tokens de salida usa entre los diez primeros, con un promedio de 91.000 por tarea.

Vals AI confirma que Astra encabeza el Vals Science Index, como dice OpenAI. Astra lidera ese ranking y queda primero en Terminal-Bench Science y en VCB 1-100 con cerca de la mitad del costo y la mitad del tiempo de ejecución de GPT-6 Astra. Sol queda tercero en Terminal-Bench Science por más o menos un cuarto del costo de Astra. En Terminal-Bench 4, la prueba más amplia de programación con agentes, Astra queda quinto y Sol séptimo.
Las pruebas jurídicas son donde los modelos se quedan cortos, según Vals AI. En HLAB, Astra y Sol duplican los puntajes de sus antecesores, pero quedan apenas en los lugares 11 y 21. En la prueba Legal Research la caída es mayor, con Astra en el puesto 30 y Sol en el 52. Vals AI explica que los modelos hacen casi el doble de llamadas a herramientas que sus antecesores, pero escriben respuestas más cortas.