Si recién empiezas con el fuzzing y quieres aprender primero lo básico, GitHub ofrece su curso Fuzzing 101 en gh.io/fuzzing101.
GitHub Security Lab publicó el 24 de septiembre Fuzzing Taskflow, un pipeline autónomo de fuzzing para proyectos en C y C++ que maneja un agente de IA, según el blog de GitHub. Su autor, investigador del laboratorio, parte de una constatación. El fuzzing continuo no resuelve todos los problemas por arte de magia, y hasta proyectos que llevan años inscritos en OSS-Fuzz siguen escondiendo bugs críticos.
La razón casi siempre es la misma. Alguien tiene que vigilar la cobertura, escribir harnesses nuevos para el código al que nadie llega y clasificar los fallos que salen al otro lado. El fuzzing sigue necesitando a una persona en el ciclo, y la pregunta que se hizo el autor fue cuánto de ese trabajo humano se le puede pasar a un agente basado en un LLM.
Basta con apuntar la herramienta a un repositorio de GitHub. El agente identifica los puntos de entrada adecuados, analiza el sistema de compilación, escribe los harnesses, corre AFL++, lee los informes de cobertura, mejora los harnesses, clasifica cada fallo y escribe un informe de vulnerabilidad por cada bug único, todo sin que nadie lo supervise.
Fuzzing Taskflow está construido sobre GitHub Security Lab Taskflow Agent, el framework del laboratorio para escribir automatizaciones de seguridad guiadas por LLM. El pipeline se expresa como un conjunto de taskflows que un agente ejecuta de principio a fin.
¿Cómo se ejecuta?
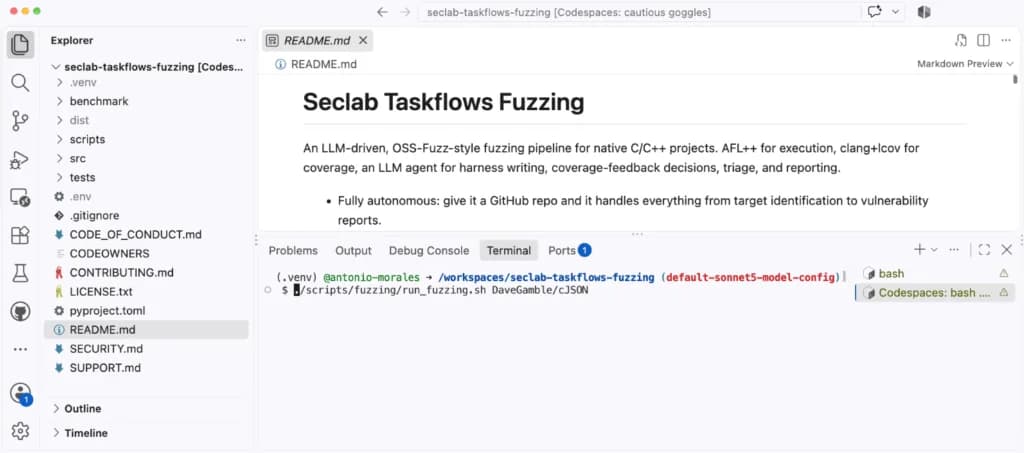
La forma más simple es ir a github.com/GitHubSecurityLab/seclab-taskflows-fuzzing](https://github.com/GitHubSecurityLab/seclab-taskflows-fuzzing) y abrir un codespace. Después se corre el script así.
./scripts/fuzzing/run_fuzzing.sh PROJECT./scripts/fuzzing/run_fuzzing.sh tukaani-project/xzEl único argumento es el identificador owner/repo de GitHub. Desde ahí el agente se encarga solo de los pasos previos.
- Instalar software como AFL
- Clonar el repositorio
- Identificar las funciones más relevantes del código
- Crear objetivos de fuzzing para esas funciones
Para una prueba rápida antes de comprometerse con una campaña larga, se puede apuntar a algo pequeño.
./scripts/fuzzing/run_fuzzing.sh DaveGamble/cJSONEl autor hace una advertencia antes de correrlo. El taskflow ejecuta afl-fuzz, clang y comandos de compilación arbitrarios elegidos por el LLM directamente en el host, sin un contenedor de por medio. Un agente con inyección de prompt podría, en principio, hacer cualquier cosa que pueda hacer tu usuario. Por eso pide correrlo solo dentro de un entorno desechable, como un Codespace o una máquina virtual temporal, y sin privilegios elevados.
Elección del modelo
Algunos modelos de frontera aplican salvaguardas de seguridad a sus respuestas. Para este taskflow, GitHub usa Claude Sonnet 5 por defecto porque pasó todas sus pruebas internas sin problemas. Se puede elegir otro modelo editando el archivo src/seclab_taskflows_fuzzing/configs/model_config.yaml.
La arquitectura en un minuto
El sistema tiene tres capas.
- Un controlador en shell (run_fuzzing.sh) que encadena las etapas del pipeline.
- Un conjunto de YAML de taskflow, uno por etapa, que en la práctica son los prompts que le dicen al agente qué hacer en cada paso.
- Un conjunto de herramientas MCP que el agente llama para hacer el trabajo real, como correr AFL, compilar un harness, guardar un fallo o leer un informe de cobertura.
La regla de diseño que más le importaba al autor es una separación limpia de responsabilidades. El agente decide y las herramientas MCP ejecutan. El agente elige qué someter a fuzzing, qué harness escribir y qué brecha de cobertura perseguir después, mientras las herramientas solo exponen primitivas como run_afl_for o compile_harness. El agente nunca llama a AFL ni a clang directamente, sino que arma el pipeline con esas piezas. Todo el estado vive en una base de datos SQLite (fuzz_context.db), así que las etapas nunca se pasan datos en memoria, solo a través de la base.
Hay un detalle pequeño que pesa. Cada harness se compila dos veces. La instrumentación de aristas de AFL sirve para guiar al fuzzer pero no produce informes de cobertura legibles para una persona. Por eso cada harness se convierte en un binario .afl (compilado con afl-clang-lto -fsanitize=address,undefined) y en un binario .cov (compilado con clang -fprofile-instr-generate -fcoverage-mapping). El .afl hace el fuzzing y el .cov vuelve a ejecutar después la cola de AFL para producir la cobertura real por línea de código y por rama.
El ciclo de retroalimentación de cobertura
Es el corazón del pipeline y la parte que automatiza más directamente el trabajo manual. Quien haya intentado mejorar a mano la cobertura de un fuzzer sabe que es un proceso iterativo como este.
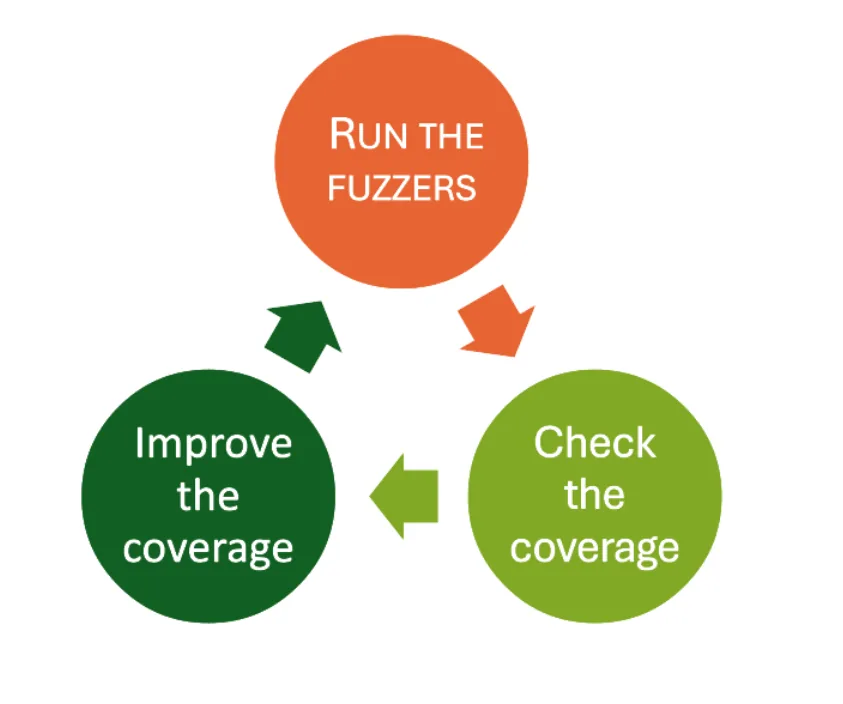
Antes, el paso de revisar la cobertura lo hacía el autor leyendo a mano un informe LCOV en busca de ramas sin cubrir. El de mejorarla también, escribiendo un harness nuevo o armando una entrada nueva. Fuzzing Taskflow le entrega los dos pasos al agente.
En cada iteración, y para cada harness, el agente corre AFL durante un tiempo fijado, vuelve a ejecutar la cola contra el binario .cov para obtener un informe de cobertura real y lee la lista de ramas sin cubrir. Según lo que encuentra, elige una de estas acciones.
- Agregar una semilla nueva armada para llegar a una rama sin cubrir
- Editar el código del harness para que llame a una API adicional
- Enriquecer automáticamente el diccionario de AFL con las constantes mágicas contra las que compara una condición
- Saltarse la brecha si es una ruta de error poco usada o código de terceros que no vale la pena perseguir
El tiempo asignado se duplica en cada iteración.
30 s, 60 s, 120 s, 240 s, 480 s y 960 s (cerca de 32 minutos por objetivo)
La idea es gastar rondas cortas y baratas al principio, cuando hay mucha cobertura fácil de ganar, y rondas más largas después, cuando el fuzzer necesita más tiempo para romper una condición difícil.
Igual que en el trabajo manual, hay que decidir cuándo parar. El ciclo usa detección de meseta. Cuando dos iteraciones seguidas ganan cada una menos que un umbral configurable (1% absoluto de cobertura de líneas por defecto), el ciclo concluye que llegó a rendimientos decrecientes y pasa al siguiente objetivo. Así el agente no quema horas de cómputo exprimiendo la última fracción de un punto porcentual.
¿Cómo genera entradas con estructura?
Los mutadores por defecto de AFL, que trabajan a nivel de bytes (inversión de bits, aritmética, empalme de bloques), funcionan bien con formatos binarios pero les cuesta con entradas de texto estructurado. La solución clásica es escribir a mano mutadores personalizados para cada formato, un trabajo tedioso. El pipeline trae cuatro mecanismos complementarios para producir entradas que respetan la estructura.
1. Diccionarios y mutadores personalizados por formato. Para los objetivos cuyo formato de entrada reconoce (JSON, XML, expresiones regulares, PNG y TLV binario con prefijo de largo), el taskflow trae diccionarios de AFL listos y archivos en C de LLVMFuzzerCustomMutator. El mutador de JSON empalma tokens y duplica bloques con corchetes balanceados. El de XML conoce etiquetas, entidades y los tokens del ataque billion laughs, y el de expresiones regulares lleva patrones ReDoS reales. Cada mutador le devuelve la mitad de sus mutaciones al mutador de bytes por defecto de AFL, para conservar la aleatoriedad del motor en vez de pelear contra ella.
2. Un diccionario a nivel de código fuente. Para los formatos que no reconoce, el pipeline genera un mutador personalizado en el momento, revisando los archivos .c y .h del propio objetivo. Extrae literales de texto y constantes numéricas de 32 bits (de #define, case y enum), filtra el ruido y los usa como tokens para empalmar. La intuición es simple. Los valores mágicos que revisa un parser suelen estar escritos en algún lugar de su propio código.
3. Un diccionario de AFL generado en forma dinámica y enriquecido según la cobertura. El mismo conjunto de tokens del código se emite también como diccionario clásico de AFL antes de la primera iteración, con las constantes numéricas en ambos órdenes de bytes, para que el fuzzer pueda satisfacer un memcmp contra un valor mágico de 4 bytes sin importar el orden de bytes del host. Después de cada paso de cobertura, el pipeline mira las condiciones cercanas a las líneas sin cubrir (strncmp, memcmp, case 0xN, == 'X') y agrega los tokens nuevos que encuentra. El diccionario crece literalmente hacia el código al que el fuzzer todavía no llega.
4. Un operador de empalme de corpus. El mutador también puede cargar archivos de un directorio de corpus y empalmar subregiones aleatorias de ellos en la entrada. Es un operador de recombinación que el modo havoc estándar de AFL no hace bien.
Un corpus que se conserva
Una de las cosas que mata en silencio la eficiencia del fuzzing es botar el avance. Si cada corrida parte desde las semillas originales, se vuelve a pagar una y otra vez el costo de redescubrir las mismas rutas.
Para evitarlo, cada harness tiene un directorio de corpus estable que sobrevive entre iteraciones y entre campañas completas.
<workspace>/corpus/harness_<id>/Al final de cada iteración, la cola de AFL se fusiona con ese directorio y pasa por afl-cmin para acotar su tamaño. Las entradas interesantes de ayer pasan a la corrida de hoy, y las que se encontraron en la campaña de la semana pasada pasan a esta. Si se detiene y se reinicia una campaña, no se pierde nada.
Clasificación de fallos e informes de vulnerabilidad
Encontrar un fallo es solo la mitad del trabajo. Quien haya hecho análisis de causa raíz sabe que clasificar suele ser la parte más tediosa del proceso, y es el otro punto donde el agente rinde.
Cuando termina el ciclo de fuzzing, corren tres etapas automáticas. Primero, cada fallo se minimiza con afl-tmin, se vuelve a ejecutar bajo ASan para capturar la traza de la pila y se deduplica con un stack-top hash, que usa los marcos superiores normalizados y les quita plantillas, espacios de nombres en línea y sufijos de LTO para que los fallos idénticos en lo semántico se agrupen. Segundo, los fallos ya conocidos se vuelven a ejecutar contra el binario actual para ver si una corrección del proyecto original los resolvió. Tercero, el agente lee el código del harness y la función que falla, recorre la cadena de llamadas hacia atrás desde la API pública y escribe un informe en markdown por cada fallo.
Cada informe asigna uno de estos veredictos.
- vulnerability
- library_hardening
- harness_bug
- assertion_failure
Distinguir una vulnerability real, alcanzable y explotable a través de una API pública, de un simple harness_bug, donde el error está en el harness y no en la biblioteca, es justo el tipo de juicio que antes obligaba al autor a sentarse a seguir el código a mano. Cada informe incluye un análisis de causa raíz con referencias archivo:línea, un argumento de alcanzabilidad, una evaluación de explotabilidad, una corrección sugerida en formato diff unificado y un esbozo de prueba de regresión.
Los parches sugeridos vienen marcados como "requiere revisión" por una razón. El análisis del agente está limitado por lo que el modelo entiende del código objetivo, y se equivoca. El autor pide tratar los veredictos como un punto de partida muy bien preparado para una persona, no como un resultado final.
Panel en vivo
Correr una campaña autónoma sin poder ver lo que hace es incómodo, así que el pipeline publica todo en un panel HTML en vivo. Arranca solo en segundo plano apenas se lanza una campaña, en el puerto 8765. En un Codespace ese puerto se reenvía automáticamente, así que se puede abrir en cualquier navegador y seguir el avance de la campaña en tiempo real.