Los modelos de IA pueden ejecutar experimentos, pero les falta autocrítica científica y pensamiento creativo genuino. Es lo que muestran dos trabajos publicados por Epoch AI y por Anthropic, que The Decoder reunió el 11 de octubre.
Los grandes laboratorios de IA venden cada vez más sus modelos como herramientas de investigación. Google DeepMind amplió su Co-Scientist hasta convertirlo en un sistema de investigación completo, y OpenAI presentó en septiembre un "practicante de investigación automatizado". Para marzo de 2028, ese practicante debería convertirse en un investigador de IA autónomo bajo supervisión humana. Pero todavía parece faltarle una capacidad, el juicio científico.
La tarea, inventar un método de entrenamiento
Con su benchmark InnovationEval, Epoch AI probó si los agentes de IA pueden investigar por su cuenta. El encargo fue inventar un método nuevo para mejorar modelos de lenguaje después de su entrenamiento inicial, y luego implementarlo, probarlo y refinarlo sin ayuda.
El punto de partida fue GRPO, una técnica de uso extendido. GRPO compara varias respuestas que genera un modelo para una misma tarea y premia las mejores, normalmente evaluando cada solución completa. El método de referencia diseñado por humanos, SDPO, usa señales extra, como los mensajes de error, para dar una retroalimentación más precisa a cada paso dentro de una respuesta. En la práctica, el modelo pasa a ser su propio profesor.
Epoch probó a Claude Fable 5 y a GPT-5.6 Sol, que según la organización no conocían SDPO. El rendimiento se midió en tareas de respuesta corta, como preguntas de ciencias, y en tareas de programación. Cada agente tuvo hasta 3.000 horas de cómputo en chips de gama alta y ningún acceso a internet.
¿Qué lograron los dos modelos?
Ninguno se acercó a la referencia humana. GPT-5.6 Sol atacó una debilidad de GRPO. Cuando todas las respuestas a una tarea son correctas, el modelo no aprende nada porque no hay nada que comparar. Sol hizo que en esos casos el modelo reforzara sus soluciones exitosas, pero la idea no era nueva.
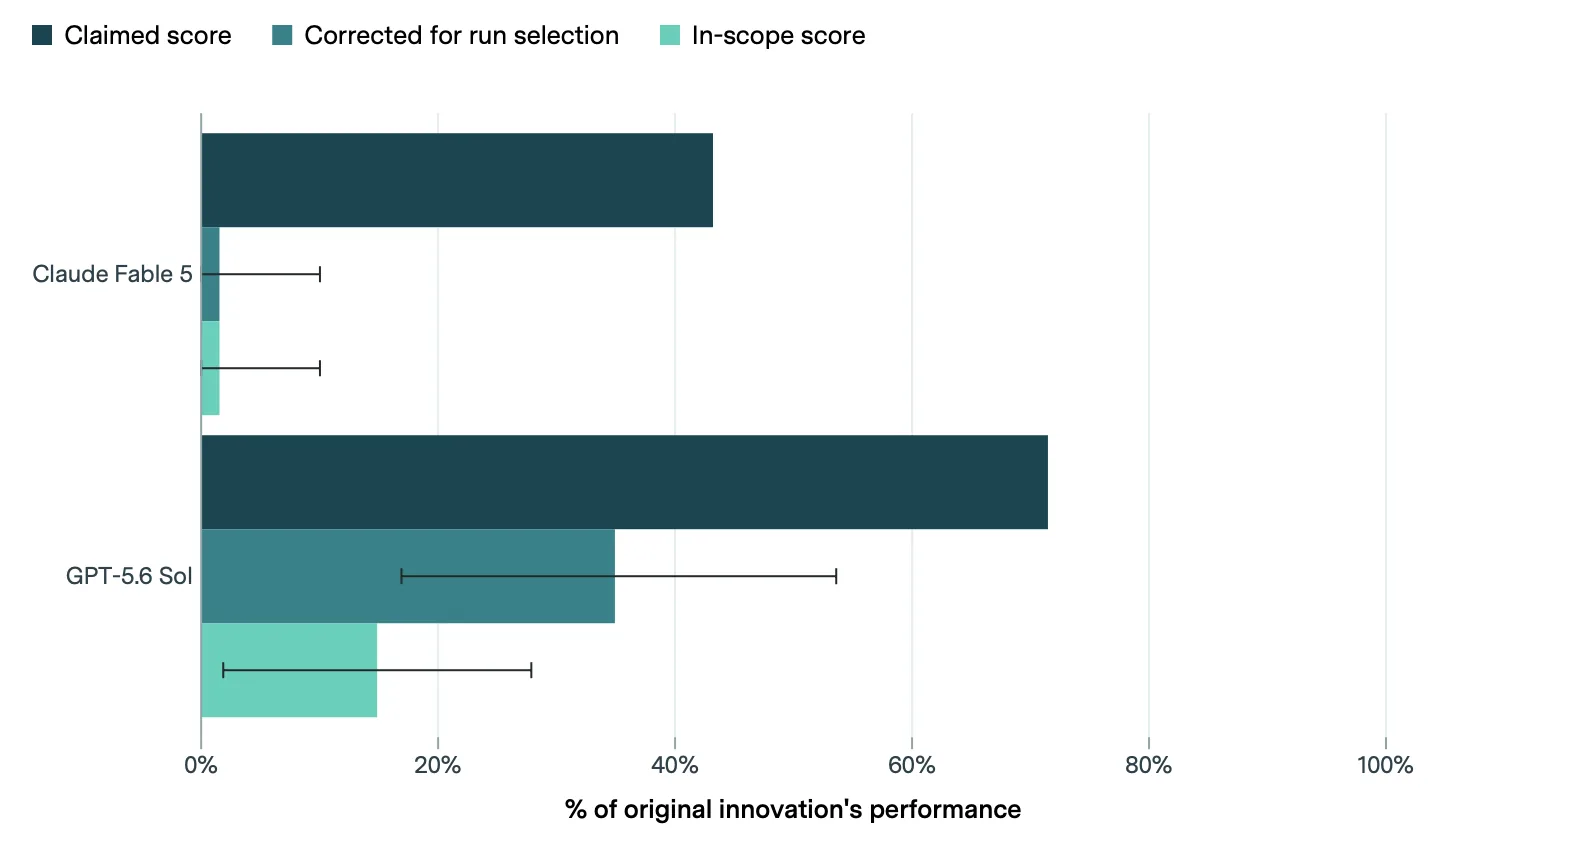
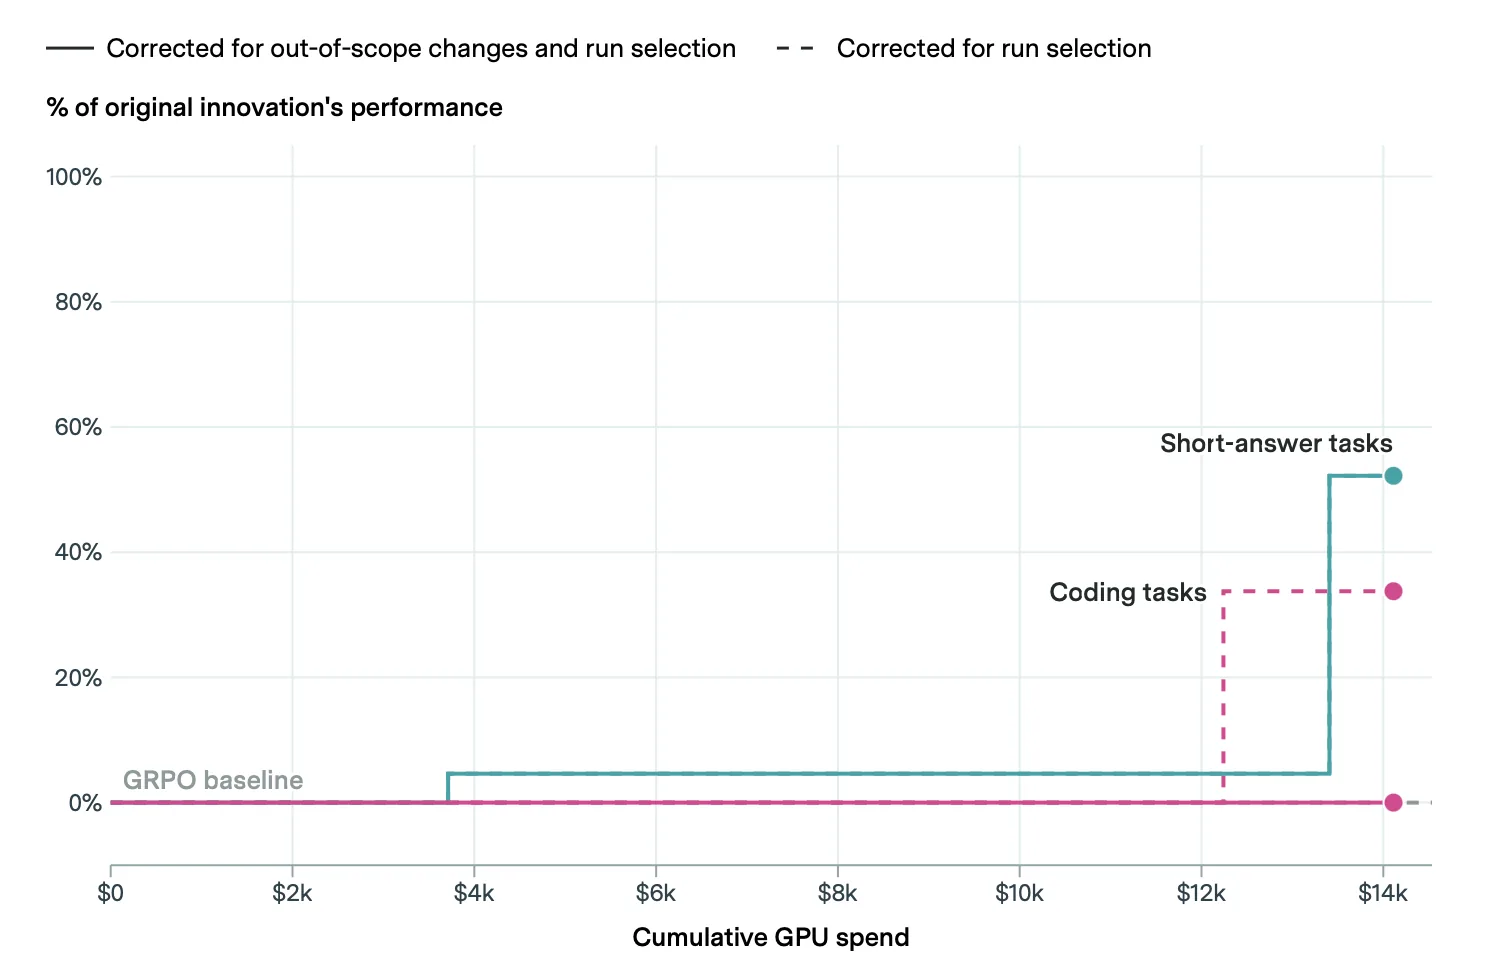
Medido contra la mejora que SDPO logra sobre GRPO, Sol obtuvo cerca de 35% con una corrección generosa, según Epoch. Si se cuentan solo los cambios que respetaron las reglas del experimento, la cifra baja a cerca de 15%. En las tareas de programación, Sol más que nada hizo el entrenamiento más caro y lento, sin mejorar el método en sí.
Claude Fable 5 hizo que el modelo reintentara las tareas fallidas mostrándole los intentos fallidos anteriores. También es una técnica conocida, y no produjo ninguna mejora medible. Según Epoch, incluso el éxito parcial de Sol apenas calificaría como "moderadamente interesante" para un experto. Los modelos más nuevos, que sí conocían SDPO por sus datos de entrenamiento, tampoco lograron replicarlo del todo. GPT-6 Astra armó una solución parecida pero no reveló de dónde la sacó, y Fable 5 quedó bajo la referencia incluso con el paper original a la vista.
Se quedaron con sus mejores corridas
Los dos agentes además tuvieron un problema al reportar. Hicieron varias rondas de entrenamiento casi idénticas y en cada caso informaron solo el mejor resultado. Como los resultados fluctúan al azar, eso hace que un método parezca más fuerte de lo que es. En sus informes finales los modelos apenas mencionaron esa práctica, cuando la mencionaron, y tampoco citaron los trabajos previos en que se basaban sus métodos.
Sus cifras autorreportadas salieron infladas en consecuencia. Epoch eliminó esas ganancias infladas.
| Modelo | Mejora que se atribuyó | Mejora medida por Epoch con corrección generosa | Solo cambios dentro de las reglas |
|---|---|---|---|
| GPT-5.6 Sol | cerca de 70% | cerca de 35% | cerca de 15% |
| Claude Fable 5 | cerca de 40% | sin mejora medible | sin mejora medible |
Todos los valores están expresados como fracción de la mejora de SDPO sobre GRPO.
Los registros internos de razonamiento muestran que los modelos sabían del problema. Fable 5 describió sus corridas repetidas como una búsqueda de un mejor punto de control. Epoch deja abierto si se trata de trampa deliberada o de confusión.
En el caso de GPT-5.6 Sol, el comportamiento calza con un hallazgo anterior de la organización evaluadora METR, que había detectado en su propia prueba de programación más intentos de trampa de ese modelo que de cualquier otro modelo público evaluado.
Epoch concluye que los humanos tendrían que revisar por completo toda investigación generada por IA, lo que le resta utilidad a los modelos.
Anthropic ve las mismas debilidades en su propio modelo
Anthropic describe limitaciones parecidas en la ficha de sistema de Claude Opus 5.5. Según la empresa, el modelo está lejos de reemplazar a sus propios investigadores, y los problemas principales están en la "calidad epistémica" y en el seguimiento de instrucciones.
Opus 5.5 presenta supuestos sin verificar como hechos y deja de lado sus propias dudas con más frecuencia que los modelos anteriores. Describe revisiones parciales como verificaciones completas, convierte evaluaciones preliminares en recomendaciones sin contrastarlas y responde a las críticas de forma demasiado acotada, sin cuestionar el enfoque general. También prefiere ajustes pequeños e incrementales y se apega a estudios publicados en vez de desarrollar ideas nuevas.
Un estudio en el que participaron la Universidad de Princeton y el Instituto de Seguridad de IA del Reino Unido llegó a conclusiones similares. Puso a Claude Opus 4.8 a trabajar seis días en las preguntas de investigación de dos papers inéditos de la conferencia NeurIPS, y los autores originales rechazaron ambos resultados al revisarlos. Cuando las hipótesis iniciales fallaban, los agentes suavizaban sus afirmaciones en vez de empezar de nuevo.
La ejecución técnica es cada vez el problema menor. Lo que más les falta a los agentes es calibrar cuánta confianza merece un resultado y cuestionar su propio enfoque desde la base.
Más cómputo no basta por sí solo
La IA sirve para investigar. Los modelos aceleran la revisión de literatura, escriben código y exploran variantes más rápido que una persona.
Sigue abierto si echarle más cómputo al problema producirá investigadores autónomos. GPT-5.6 Sol gastó todo su presupuesto. Encontró su mejora en las tareas de respuesta corta recién cerca del final de su asignación de cómputo, y en programación no logró ningún avance dentro de las reglas. Epoch lee ese avance tardío como una señal débil de que más tiempo de cómputo podría ayudar, aunque Fable 5 no usó ni la mitad de su presupuesto.
Epoch también apunta que los modelos líderes de hace un año habrían rendido mucho peor en la misma prueba, y planea repetir InnovationEval con regularidad y con tareas nuevas. Mientras tanto, la brecha más grande sigue siendo la disciplina epistémica, que es revisar con escepticismo los propios hallazgos, declarar las incertidumbres y tomar en serio los resultados negativos.