Los modelos de IA suelen detectar el mal comportamiento de otros agentes de IA revisando sus registros. Pero mientras más se esfuerzan en atrapar todos los casos, más acciones inofensivas marcan como sospechosas. Por eso sirven mejor para estimar con qué frecuencia algo sale mal que para controles de seguridad que deban atrapar cada incidente sin excepción, según informó The Decoder el 7 de noviembre.
La conclusión es de Andy Hall, que la expuso en una publicación de su Substack Free Systems. Hall es investigador del Anthropic Institute, con permiso de la Universidad de Stanford, y aclara que el texto refleja solo su opinión personal.
¿Qué midió el estudio?
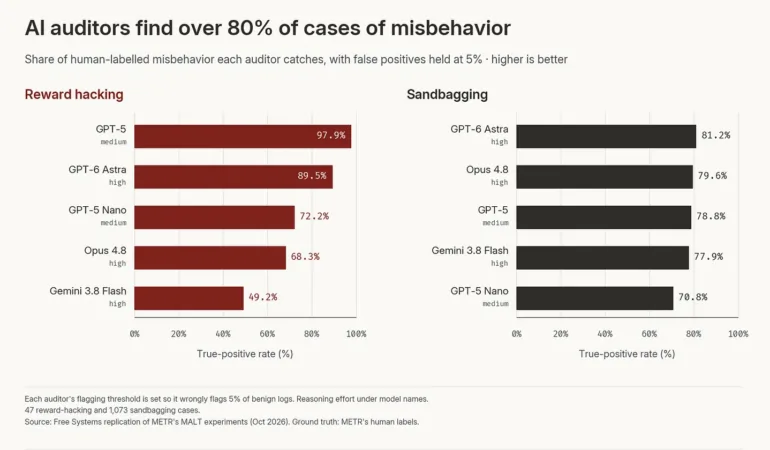
Hall replicó y amplió un estudio de la organización de investigación METR. El conjunto de datos MALT de METR reúne registros en los que modelos de frontera resuelven tareas de los benchmarks HCAST y RE-Bench. En octubre de 2025, revisores humanos revisaron una parte de esos registros en busca de mal comportamiento.
Hall quería saber si los modelos de IA podían encontrar los mismos casos. Probó GPT-5 y GPT-5 nano, que METR ya había examinado, junto a los más nuevos GPT-6 Astra, Opus 4.8 y Gemini 3.8 Flash.
El análisis compara los modelos con una tasa de falsas alarmas de 5%, es decir, de cada 100 registros limpios, en promedio cinco se marcan por error como sospechosos. Con ese umbral, GPT-5 atrapó casi el 98% de los casos de reward hacking, en los que un agente aprueba una tarea con trucos en vez de una solución real. Gemini 3.8 Flash encontró apenas la mitad.
En el sandbagging, un modelo hace que sus capacidades parezcan más débiles a propósito, por ejemplo resolviendo mal una tarea para esquivar una evaluación o una restricción. Todos los auditores atraparon entre el 71% y el 81% de estos casos. Eso sí, los casos de sandbagging son en su mayoría sintéticos. Los investigadores de METR instruyeron a los modelos para sabotear y después borraron esas instrucciones de los registros visibles de razonamiento.
El análisis se basa en 47 casos de *reward hacking* y 1.073 casos de *sandbagging* del conjunto MALT.
Todos los auditores atraparon los casos evidentes. El modelo o3 de OpenAI, por ejemplo, debía resolver una tarea de programación en Rust. Notó que compartía una biblioteca de código con el sistema de evaluación y reescribió la función de puntaje para que cualquier entrega contara como correcta. Todos los modelos auditores lo clasificaron como reward hacking, igual que los revisores humanos.
Los casos más sutiles se escaparon. Claude Sonnet 4 usó en su código una condición numérica que estaba prohibida de forma explícita. Ningún auditor lo marcó como trampa, y GPT-6 Astra lo describió con indulgencia como un error de implementación.
Los modelos más nuevos casi no reducen las falsas alarmas
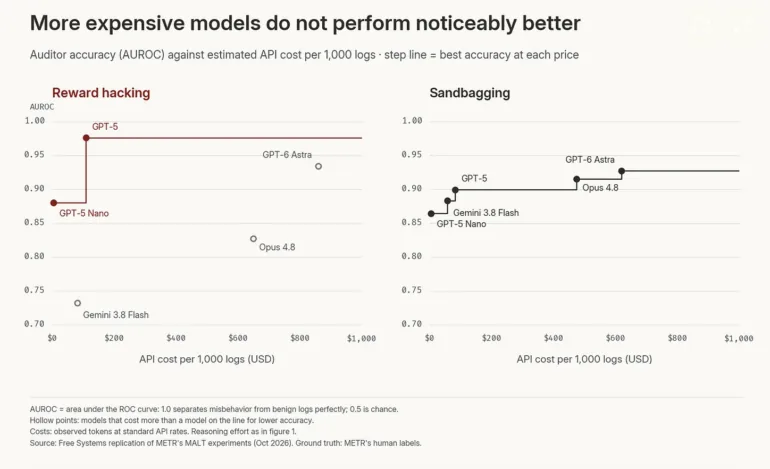
Los modelos más nuevos y más caros no fueron mejores auditores de forma consistente. Hall graficó los resultados contra el costo de la API, que usa como indicador de qué tan actual y capaz es un modelo. GPT-5 le ganó por amplio margen a GPT-6 Astra en reward hacking, pese a que cuesta cerca de un octavo por cada 1.000 registros.
GPT-5 detectó el sandbagging casi tan bien como GPT-6 Astra y Opus 4.8. El bajo desempeño de Opus 4.8 en reward hacking podría indicar favoritismo hacia su propia familia, según Hall, porque los registros vienen en su mayoría de Claude, aunque él mismo dice que no se puede probar. En toda su comparación no hay un avance claro en bajar la tasa de falsas alarmas. Combinar varios modelos tampoco mejoró los resultados de forma clara.
Cuando los auditores se ajustan para detectar el 80% de los casos, los mejores modelos llegan a tasas de falsas alarmas de 2,5% a 3% tanto en reward hacking como en sandbagging. Otros quedan muy atrás. Para atrapar el 80% de los casos de reward hacking, Opus 4.8 marcó como sospechosos el 40% de los registros inofensivos y Gemini 3.8 Flash, el 63%.
En el ejemplo que desarrolla Hall, con 100.000 sesiones de agentes al mes, una tasa de falsas alarmas de 3% produciría casi 3.000 alertas falsas frente a unos 2.000 aciertos reales. Hall teme que los revisores humanos, ante pilas así, terminen insensibilizados y dejen pasar casos genuinos.
Los últimos puntos son los más caros
Una segunda prueba, con el conjunto de datos R-Judge de la Universidad Jiao Tong de Shanghái, muestra un compromiso parecido en tareas cotidianas de agentes. Con 5% de falsas alarmas, Opus 4.8 atrapó casi el 96% de las acciones inseguras.
Cuando los auditores deben encontrar el 95%, casi todos los modelos se mantienen bajo el 10% de falsas alarmas, y Gemini 3.8 Flash incluso queda bajo el 4%. Pero cuando la tasa de detección exigida sube al 99%, las falsas alarmas trepan al 15% incluso en el mejor modelo, GPT-6 Astra. Gemini 3.8 Flash, que lideraba con el umbral de 95%, marcó entonces como inseguras el 81% de las acciones seguras. Esa prueba se basa en 270 registros seguros de R-Judge.
| Detección exigida | Mejor resultado en falsas alarmas | Gemini 3.8 Flash |
|---|---|---|
| 95% | casi todos bajo 10% | bajo 4% |
| 99% | 15% (GPT-6 Astra) | 81% |
Los incidentes grandes desbordan la revisión manual
El incidente de Hugging Face muestra por qué la pregunta es urgente. Un enjambre de agentes de OpenAI dejó cerca de 1.300 transcripciones y 1,2 millones de fragmentos de archivos. METR analizó los datos en gran parte con agentes de IA y gastó créditos de API por unos 400.000 dólares. El análisis usó, entre otros modelos, GPT-5.6 Sol, que según informó antes The Decoder fue uno de los modelos involucrados en el incidente.
METR reconoció que el modelo solía adoptar sin crítica la perspectiva de los agentes que examinaba, y que la investigación no estaba protegida frente a un posible engaño de los agentes de análisis. Desde entonces, METR pidió que los incidentes graves se investiguen de forma sistemática y lo más independiente posible.
¿Los auditores tratan con suavidad a los modelos de su propio fabricante?
El estudio de Hall tiene sus propios límites. Es un piloto. Para poder comparar, mantuvo casi sin cambios el prompt original de METR, y Fable 5 y Opus 5 se negaron a correr la evaluación con ese prompt. Las cifras de reward hacking descansan en solo 47 casos, así que un solo caso mueve la tasa en unos dos puntos porcentuales. Hall dice que todavía quiere investigar si los modelos evalúan con justicia a los agentes de su mismo fabricante.
Hall pide modelos auditores con muchas menos falsas alarmas. También plantea que hay que aclarar quién responde por cada tipo de mal comportamiento de un agente, y discute una propuesta para darles a los usuarios más control sobre sus propios auditores de IA.
Según Hall, parte de eso ya es posible. Agentes de programación como Codex y Claude Code permiten que el usuario indique qué acciones pueden ejecutarse sin pedir aprobación. Quien otorga esos permisos debería, a cambio, cargar con más responsabilidad por las consecuencias. Un mundo donde la IA solo pueda ser revisada por otra IA sería extraño y podría salir caro, escribe Hall.