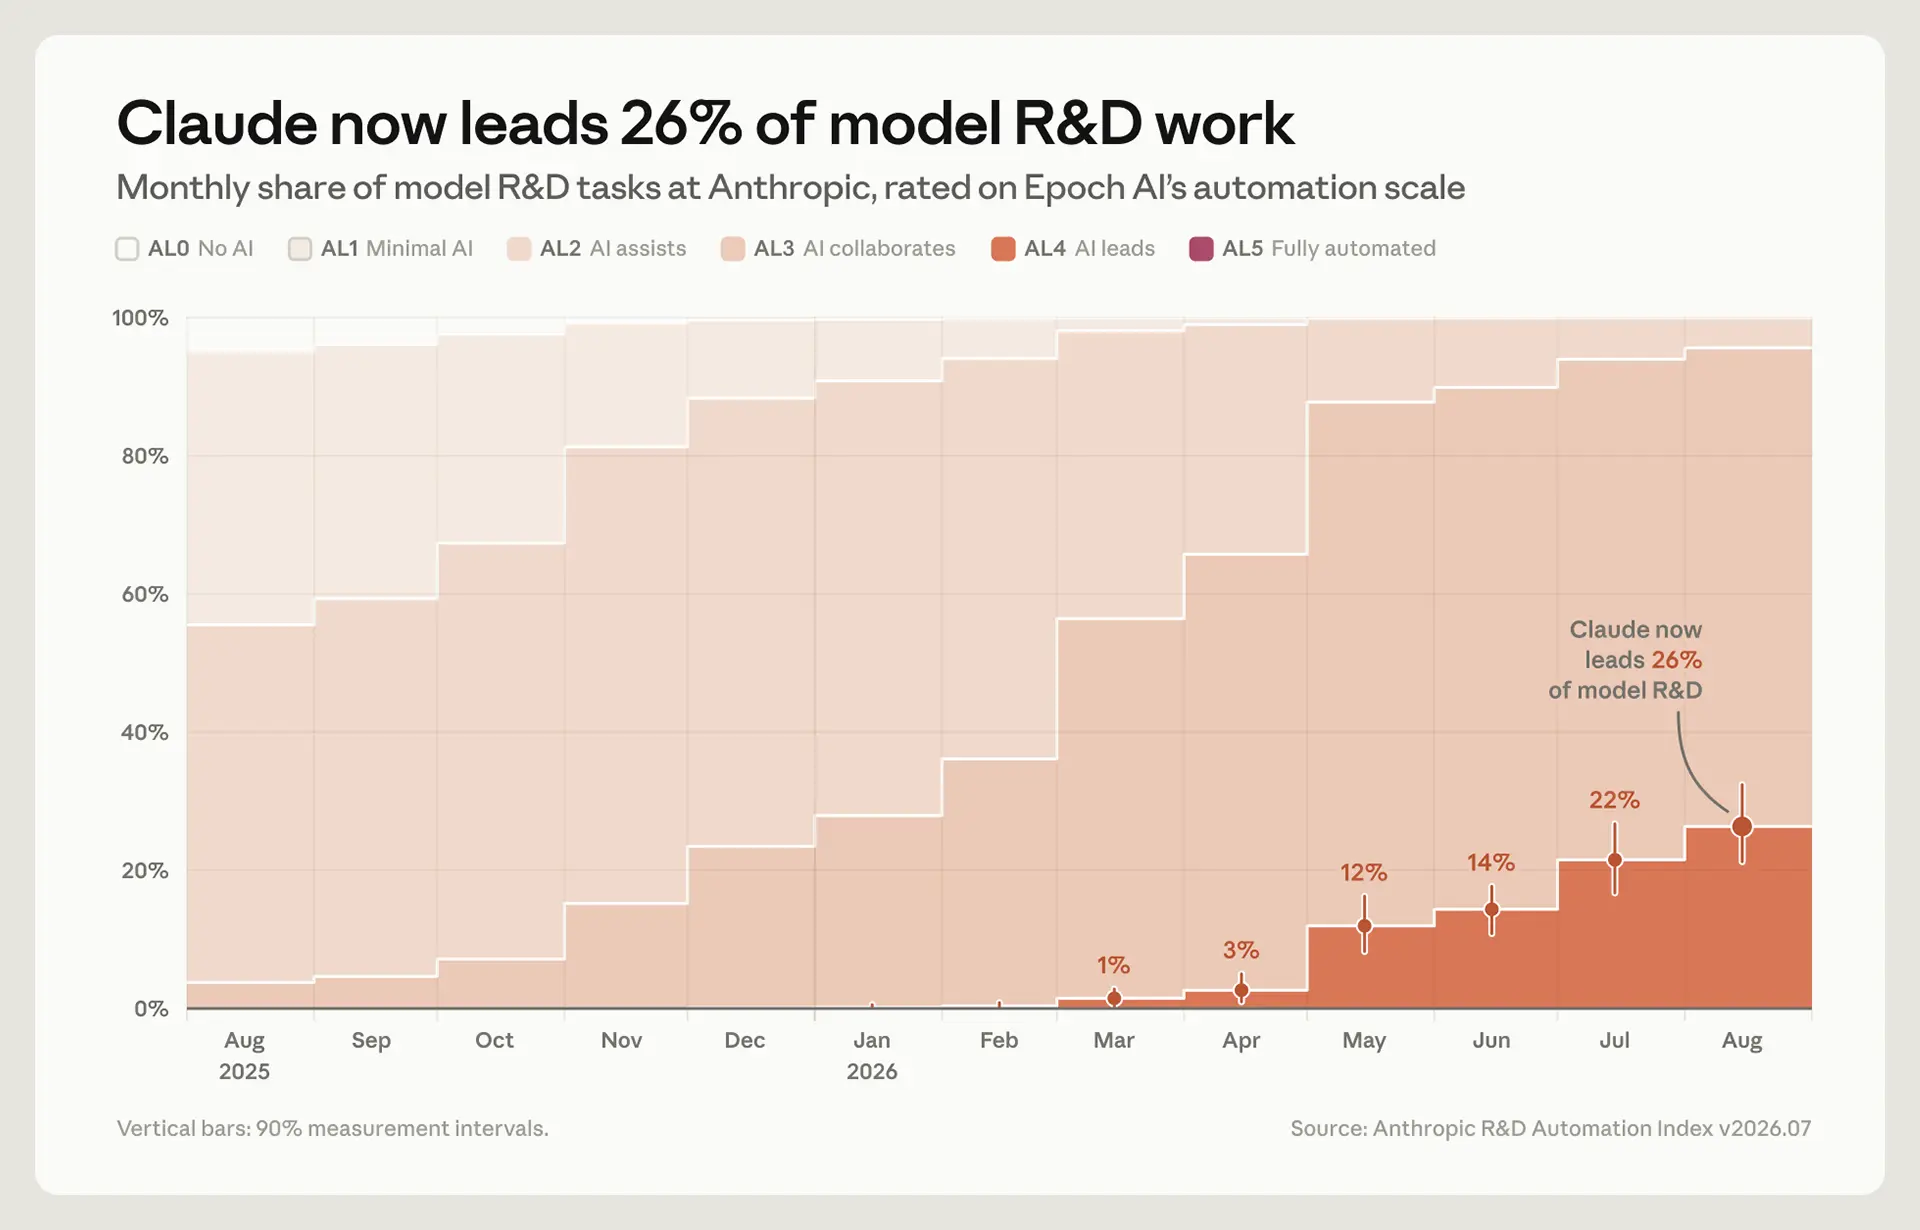
Anthropic publicó el 17 de septiembre un conjunto de mediciones sobre cuánto de su propia investigación en inteligencia artificial ejecuta ya el modelo. La cifra central es que Claude lidera el 26% de las tareas de investigación y desarrollo de la empresa, y que más del 90% de ese trabajo está al menos en el nivel donde la IA colabora bajo dirección humana.
El texto sale del instituto de la compañía y apunta a tres aspectos del desarrollo. Cuánto está construyendo la IA la versión siguiente de sí misma en lugar de construirla personas, qué capacidad tiene la empresa de supervisar e intervenir lo que hacen los agentes dentro de sus sistemas, y qué recursos alimentan el entrenamiento de modelos más capaces.
Anthropic advierte que espera que estos números cambien si llega a haber coordinación para moderar el ritmo de la frontera, como pidió su director ejecutivo, Dario Amodei. La empresa anunció además que va a incorporar evaluadores externos independientes de varias organizaciones, con acceso a procesos, sistemas y datos internos comparable al que tienen sus propios equipos de evaluación de riesgo.
¿Qué miden estas cifras y qué dejan fuera?
Las mediciones se concentran en cómo se construyen los modelos. Al entender mejor el proceso de producción, la empresa sostiene que hay más posibilidades de correlacionar las entradas, como el cómputo, con las salidas, como las capacidades del modelo. Son un complemento de las evaluaciones de capacidad, que miden qué pueden hacer los modelos y que se publican aparte en los informes de riesgo de su política de escalamiento responsable.
En su propuesta de política pública, el Advanced AI Framework, la empresa plantea reglas del juego para la publicación de modelos, con obligaciones de transparencia que los gobiernos podrían exigir.
¿Cuánto de la investigación de IA la hace ya la IA?
Anthropic armó un índice preliminar de automatización de su investigación y desarrollo. Se construyó catalogando cada tipo de trabajo de investigación en IA que se hace en la empresa, calificando qué tan automatizada está hoy cada tarea y agregando esas calificaciones.
Para calificar usa una escala de automatización desarrollada por Epoch AI, que va del nivel AL0, sin participación de la IA, al AL5, donde la IA opera de forma completamente autónoma y sin ninguna persona en el circuito. En el nivel AL3 la IA colabora, es decir puede hacer partes grandes del trabajo bajo dirección humana estrecha. En el AL4 la IA lidera, o sea completa la mayor parte de la tarea de punta a cabo desde una instrucción general, mientras la persona supervisa.
Los resultados son tres.
- Claude no opera de forma completamente autónoma en ningún subconjunto medido del trabajo de investigación.
- Claude lidera el 26% del trabajo de investigación y desarrollo en IA de Anthropic.
- La proporción de trabajo que está en el nivel de colaboración o por encima supera el 90%.
La razón declarada para compartir estas cifras es entender qué tan cerca está el mundo de la automejora recursiva, el punto en que un modelo construye a su sucesor por sí solo. Que los modelos aceleren su propio desarrollo permite entrenar y probar más rápido, y al mismo tiempo puede volver más difícil para las personas entender o controlar esos sistemas.
Anthropic reconoce dos obstáculos para comparar estos números entre laboratorios. El primero es que no existe una metodología común. El segundo es que la empresa está usando sus propios modelos para evaluar sus sistemas, lo que significa que el modelo que hace de juez podría cometer los mismos errores que el modelo que revisa. La salida que propone es que un tercero verifique las mediciones, o que lo hagan los modelos de otros desarrolladores, con resguardos que limiten el intercambio de datos sensibles para la competencia.
Treinta mil agentes trabajando a la vez
La segunda medición es sobre la supervisión de agentes. En Anthropic, como en otros laboratorios de frontera, las personas delegan cada vez más tareas en agentes que trabajan de forma semiautónoma por períodos largos y que se delegan trabajo entre ellos. A medida que ese trabajo se automatiza, los agentes pueden tomar decisiones de más peso, como qué dirección de investigación seguir.
En agosto de 2026 había cerca de 30.000 agentes haciendo trabajo de investigación e ingeniería en cualquier momento dado dentro de la plataforma interna más usada de la empresa. Las mediciones cubren solo esa plataforma. Las acciones de esos agentes quedan restringidas por dos clases de monitores, unos que actúan en línea y otros que revisan después.
Sobre ese sistema la empresa sigue tres métricas. La cobertura, que describe qué proporción de las acciones de un agente pasa por un monitor antes o después de ejecutarse. La latencia de revisión, que es el tiempo entre una acción y su revisión, primero por un monitor automático y después por una persona. Y la tasa de escalamiento, que es la proporción de actividades que quedan bloqueadas o redirigidas en el caso de los monitores en línea, o marcadas para revisión posterior en el caso de los monitores diferidos.
El texto sostiene que en los datos de monitoreo reunidos hasta ahora los agentes individuales se portan mal rara vez. El argumento que sigue es de escala. Cuando hay millones o miles de millones de agentes operando en la economía, incluso los eventos raros ocurren con regularidad.
Estas mediciones se publicaron en el informe de riesgo de agosto. La organización METR ya había probado de forma independiente la plataforma de monitoreo diferido de la empresa, según consta en la versión editada de ese informe.
¿Cuánto cómputo va a seguridad?
La tercera medición reparte el cómputo. Los desarrolladores de IA lo usan para construir modelos de mayor capacidad, para atender clientes y para trabajo enfocado en seguridad, como auditar los pensamientos de un modelo o entrenar organismos modelo para estudiar la desalineación.
Anthropic examinó una instantánea de todo su cómputo entre el 13 y el 20 de julio. Ordenó cada carga de trabajo en un número acotado de categorías y después preguntó qué parte del cómputo destinado a investigación en IA correspondía a trabajo de seguridad.
El resultado de esa semana fue que cerca del 6% del cómputo de investigación en IA se destinó a seguridad, y cerca del 12% del cómputo de investigación conducida por la propia IA fue a seguridad.
La empresa califica esas estimaciones de conservadoras a propósito. Si una unidad de texto procesado servía tanto para avanzar en capacidades como en seguridad, no se contó en estas métricas. Tampoco se consideran los clasificadores de resguardo, que consumen una cantidad comparable de cómputo aparte.
Hay una advertencia sobre cómo leer el número. La investigación en seguridad tiende a usar menos cómputo que una corrida de entrenamiento de frontera por su propia naturaleza, porque consiste en investigadores diseñando experimentos, algo que toma tiempo aunque correr esos experimentos no exija mucho cómputo. El valor de la métrica, dice el texto, está menos en la cifra absoluta que en dar un mecanismo para comparar lo mismo con lo mismo, entre desarrolladores y a lo largo del tiempo.
Lo que cualquier laboratorio podría publicar hoy
Para cada una de las tres mediciones, Anthropic describe qué haría falta para publicarlas con regularidad en una forma que otros puedan verificar.
Sobre la automatización de la investigación, cualquier desarrollador de frontera podría publicar estas medidas con una metodología pública, lo que permitiría comparar los números en el tiempo y entre laboratorios. Esas medidas podrían convertirse además en el disparador de exigencias más duras, como una ventana fija de pruebas antes de que un modelo nuevo se use para seguir investigando.
Sobre los agentes, cualquier desarrollador que los haga correr en sus propias cargas de investigación e ingeniería podría publicar la cobertura, la latencia de revisión y la tasa de escalamiento. Los desarrolladores deberían informar además con qué frecuencia los monitores detectan un mal comportamiento conocido, y dejar que terceros hagan esas pruebas de forma independiente.
Sobre el cómputo, el texto propone publicar qué porcentaje del cómputo de investigación va a seguridad, con las definiciones de cada categoría publicadas al lado y la clasificación revisada por un tercero independiente. La investigación en seguridad es difícil de distinguir de la investigación en capacidades, y cada desarrollador va a tener la tentación de trazar la línea con generosidad. La carga de la prueba, sostiene Anthropic, debería quedar en el desarrollador que afirma que un trabajo es de seguridad.