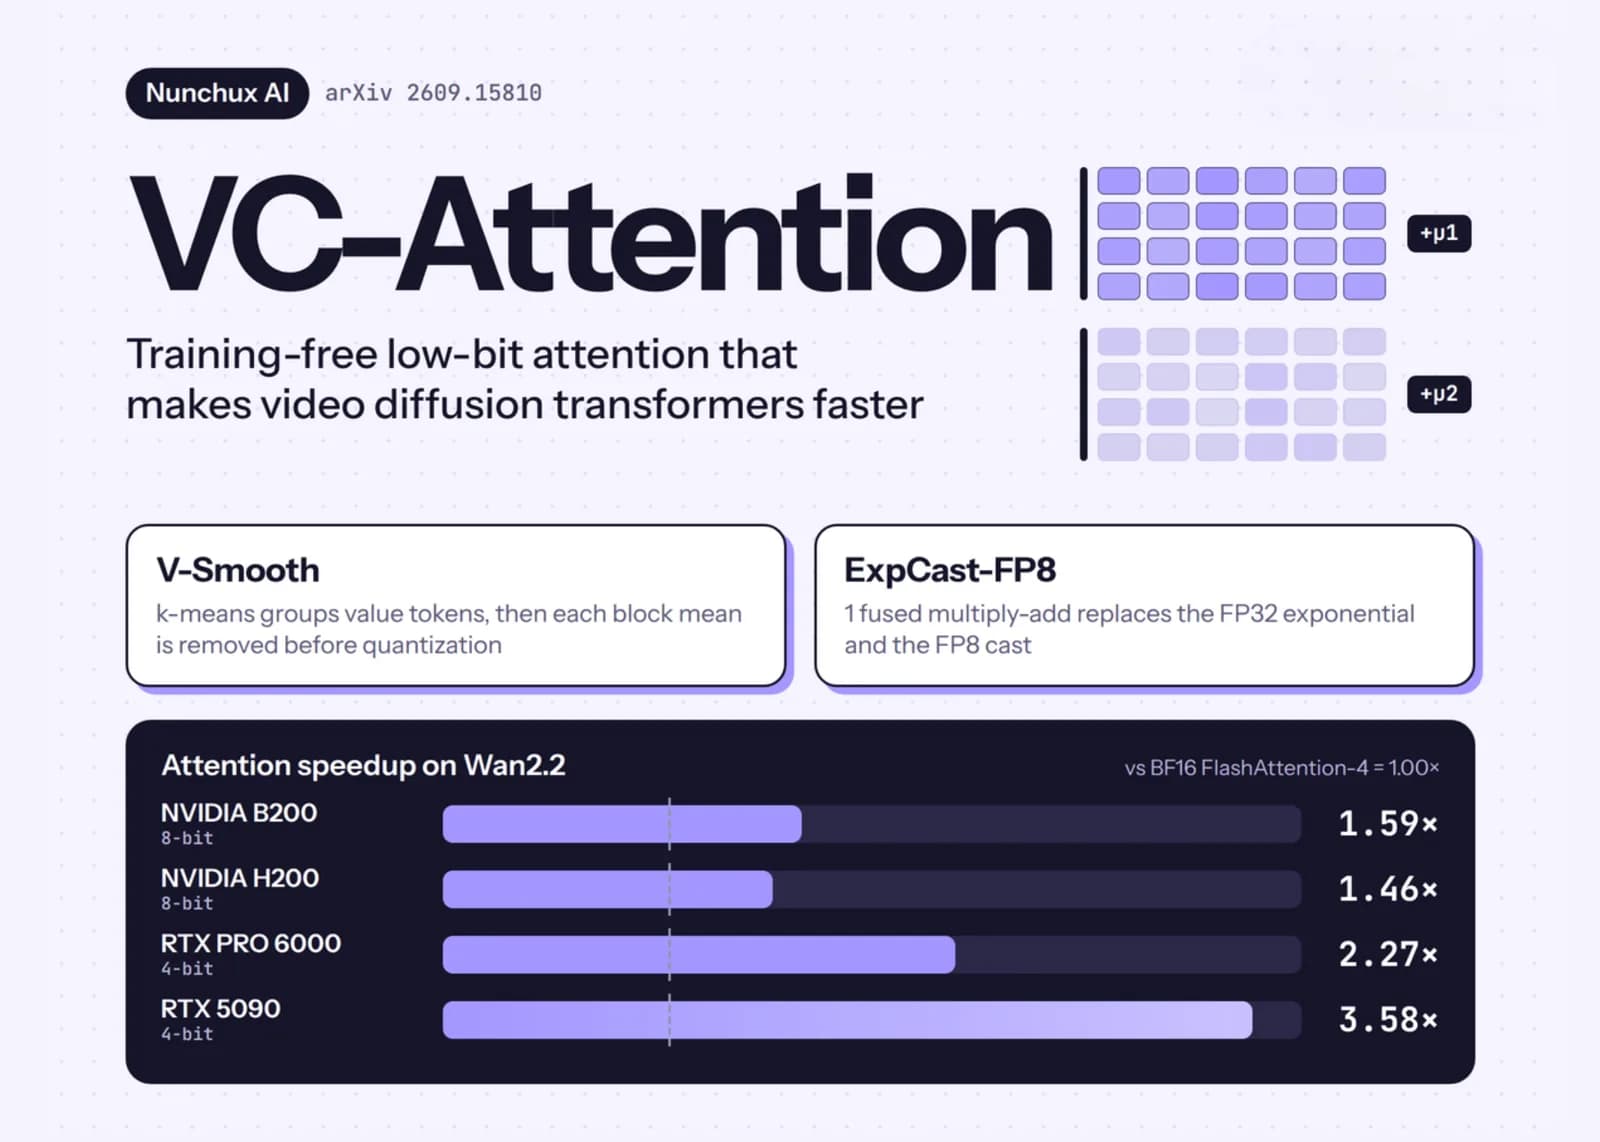
Nunchux AI publicó VC-Attention, un kernel de atención de bajo número de bits y sin entrenamiento, construido para transformadores de difusión de video (DiT). Ataca dos problemas a la vez, el error de cuantización de los valores y la lentitud de la etapa softmax.
¿Por qué la atención es el cuello de botella?
Los DiT de video aplanan un clip en una sola secuencia de tokens espaciotemporales y corren atención completa en cada capa. Un clip de 5 segundos en 720p con Wan2.2-14B abarca cerca de 70.000 tokens. En una RTX 5090, la atención se lleva más del 64% del tiempo de generación. El equipo de investigación afirma que la atención representa unos dos tercios de cada paso de denoising de MiniMax-H3 en un solo B200.
Los Tensor Cores de bajo número de bits aceleran los dos productos matriciales, QK y PV. Quedan dos obstáculos. El primero es que métodos anteriores como SageAttention2 suavizan consultas y claves, y tras ese suavizado y la rotación de QK el término de valores concentra el 82% del error de salida en Wan2.2. El segundo es que el softmax entre ambos productos sigue corriendo en FP32. En B200 y H200, esa exponencial y su conversión a FP8 se vuelven la etapa más larga de la tubería.
V-Smooth y los valores atípicos
Los valores atípicos se concentran en unos pocos tokens y sus canales cambian entre cabezas, capas y pasos. Una rotación de Hadamard preserva las normas de los tokens, así que no los elimina. Rotar V mueve el error de valores apenas un 0,2%.
V-Smooth toma otro camino, en tres etapas:
- Agrupar. Un k-means en línea agrupa los tokens de valor por lote y por cabeza. Claves y valores se permutan juntos, de modo que la salida de la atención no causal queda igual.
- Restar la media. Cada bloque de hardware de 128 tokens resta su propia media. Solo se cuantiza el residuo, con E4M3 por canal a 8 bits o NVFP4 a 4 bits.
- Restaurar. La media se vuelve a sumar usando la suma por fila que el softmax en línea ya mantiene. No hace falta una segunda pasada ni un buffer extra.
Promediado sobre 100 cabezas de Wan2.2, la media del bloque saca el 8% de la energía del bloque en orden de secuencia. Saca el 12% bajo el cubo estático de DeltaQuant y el 36% después de ordenar. Cada media cuesta 0,125 bits por elemento de valor.
El agrupamiento corre solo en el primer 25% de los pasos de denoising y la permutación se reutiliza en 4 pasos adyacentes. Promediado sobre el calendario completo, agrupar cuesta entre 3 y 4% del tiempo de atención.
ExpCast-FP8 contra el softmax
Un byte E4M3 ya está cerca del logaritmo del valor que almacena. Leído como entero, equivale aproximadamente a 8 log2(v) + 56. ExpCast-FP8 escribe entonces el byte directo desde el puntaje en dominio logarítmico con una sola multiplicación y suma fusionada. La constante β = -0,35 centra el error restante, y no se ajusta ninguna constante por modelo.
La ruta directa escribe el mismo byte que la ruta de exponencial en FP32 con conversión posterior en el 79,6% de cada duplicación. En el resto queda a un código de distancia. El paper demuestra una cota de variación total por fila bajo 3,64%, más la cola de subdesbordamiento. Sobre 204.800 filas de atención de Wan2.2, el promedio medido es de 1,6%. ExpCast-FP8 aplica solo al kernel de 8 bits, porque NVFP4 no tiene un mapa afín único de logaritmo a código.
La fusión de la cadena de preprocesamiento, escrita a mano en CuTe y CUDA, baja una llamada de V-Smooth de 42,2 ms a 4,8 ms en B200.
¿Cuánto rinde contra la competencia?
Las pruebas cubren cuatro DiT de video de pesos abiertos, Wan2.2-T2V-A14B, LongCat-Video, HunyuanVideo-1.5 y MiniMax-H3. La fidelidad se mide contra las salidas de FlashAttention-4 en BF16 sobre 100 prompts.
En B200, VC-Attention es 6,02 veces más rápido que SageAttention2, que no trae kernel para Blackwell. En H200 la diferencia baja a 1,16 veces. En tarjetas de estación de trabajo, V-Smooth de 4 bits empata con SageAttention3 en la RTX PRO 6000 y se mantiene dentro del 5% en la RTX 5090, de modo que lo que las separa es la fidelidad.
Los resultados de fidelidad publicados son estos:
- A 8 bits, V-Smooth suma 2,3 dB de PSNR sobre SageAttention2 en Wan2.2 y 2,8 dB en HunyuanVideo-1.5.
- Agregar ExpCast-FP8 devuelve entre 0,7 y 2,1 dB, y aun así supera a SageAttention2 en los cuatro modelos.
- A 4 bits, V-Smooth le gana a SageAttention3 por 2,9 dB en Wan2.2 y por 3,6 dB en LongCat-Video.
- Corrido sin entrenamiento, Attn-QAT queda entre 3,4 y 6,7 dB bajo SageAttention2.
Con MiniMax-H3 a 1344×768, la atención corre 1,60 veces más rápido que FlashAttention-4 en BF16 sobre B200, con 20,2 dB de PSNR frente a los 19,9 dB de SageAttention2. En B300 el paper reporta 1,47 veces contra 1,31 de un kernel FP8 ingenuo, mientras el gráfico del blog anota 1,51 para esa misma tarjeta. Nunchux Attention, la extensión propietaria de la empresa, llega a 1,91 veces en B200 y 1,83 en B300 para la atención de MiniMax-H3.
El método cambia solo el costo por interacción, así que se puede combinar con atención dispersa como Sparse VideoGen y Radial Attention, y también con destilación y ejecución en varias GPU. Nunchux afirma que dará acceso gratuito a MiniMax-H3 a través de su lista de espera Modelverse. El kernel todavía no tiene publicación abierta y la empresa corre su extensión propietaria dentro de su propio stack.