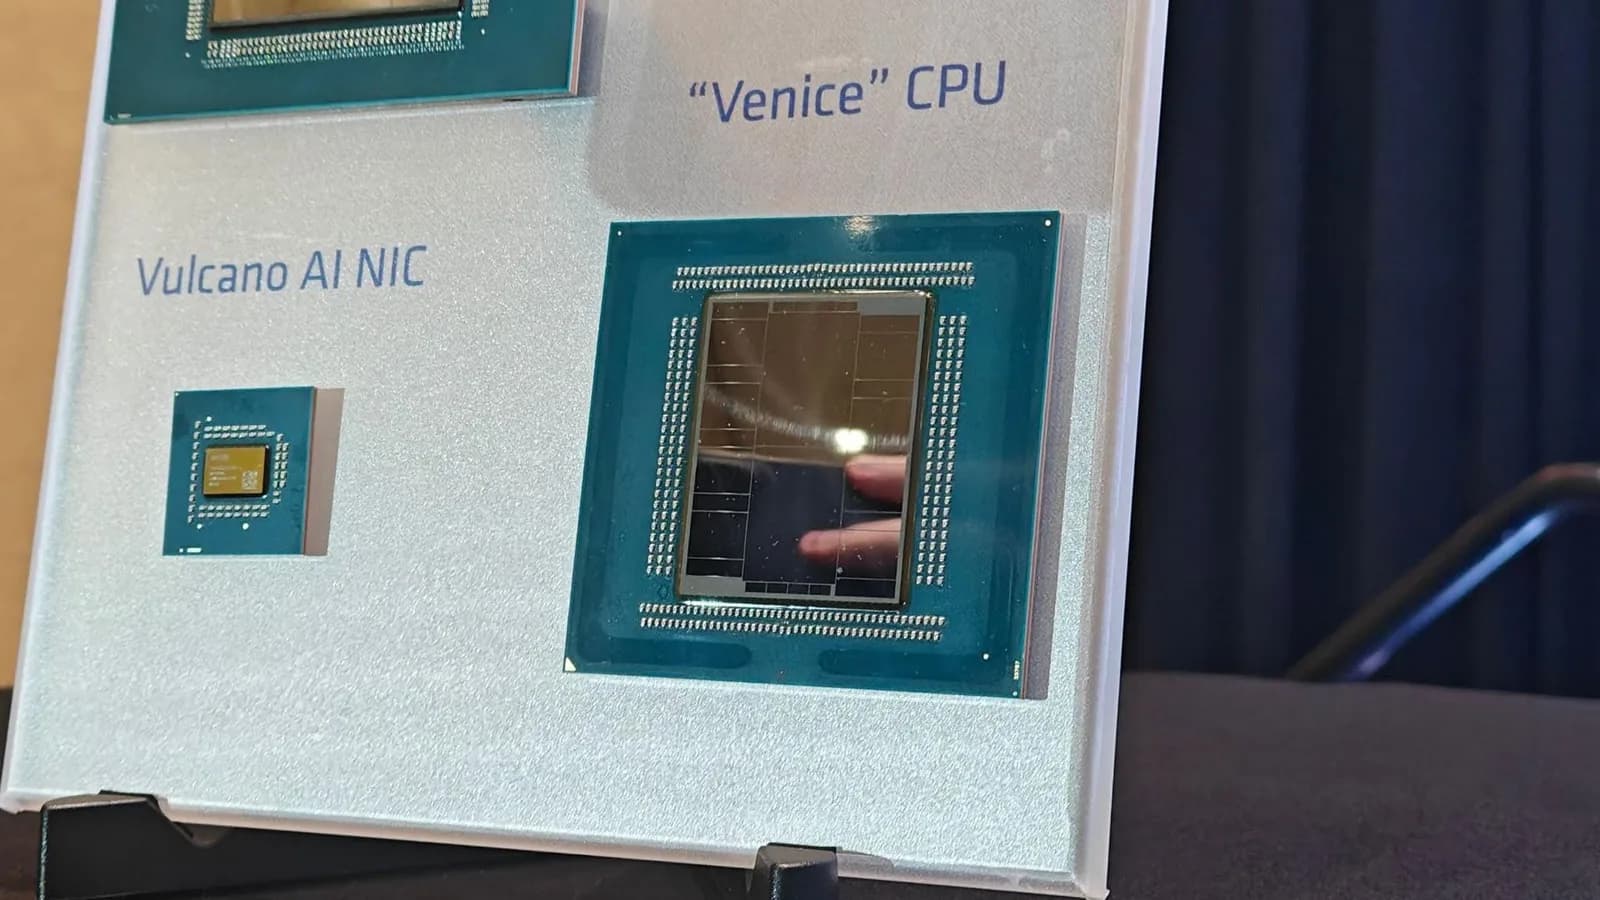
AMD amplió el viernes sus afirmaciones de rendimiento sobre los EPYC Venice, la generación de procesadores de servidor que presentó en julio de 2026. El dato de titular no cambió. La empresa sigue sosteniendo que un Venice de 96 núcleos y alta frecuencia rinde alrededor de 20% más que el Vera de 88 núcleos de Nvidia en la prueba Integer Rate de SPEC CPU 2026. Lo nuevo es un documento técnico que abre esas mediciones una por una.
El detalle viene con letra chica. Las configuraciones cambian según la prueba a lo largo del documento, y en la comparación contra Vera la empresa mezcla datos de distintas fuentes, en algunos casos con versiones mayores distintas del compilador GCC. Eso mueve el resultado lo suficiente como para leer las cifras con reparos.
¿Qué dicen los números de SPEC CPU 2026?
Los primeros resultados salen de SPEC CPU 2026 con la prueba intrate, que mide el rendimiento agregado. Son números viejos, tomados en julio con GCC 15.2. La prueba corre varias copias de una misma aplicación sobre el mismo procesador, y lo habitual es una copia por hilo. El documento no lo aclara, ni siquiera en las notas al pie. Sí aclara otra cosa, que el modelo 9006 que asomaba sin identificar en las láminas es ese tope de 256 núcleos.
En la lámina de AMD, el 9996 de 256 núcleos aparece 2,37 veces más rápido que el Intel Xeon 6980P y 2,24 veces más rápido que Vera. La comparación con su propia generación anterior es la más contundente. Ese mismo 9996 queda cerca de 78% sobre el EPYC 9965 de 192 núcleos, el tope de la camada pasada.
AMD también desglosó los subtests individuales de SPEC CPU 2026 intrate, y ahí la configuración tiene dos arrugas. La primera es que probó un 9996 recortado, bajado de 256 a 96 núcleos, sin mencionar el presupuesto de potencia. Cuando la empresa mostró sus primeros números de SPEC, ese modelo de 96 núcleos disponía de los mismos 600 W que el de 256, mientras que el SKU Venice de 96 núcleos y alta frecuencia llega hasta 500 W.
El compilador que descuadra la comparación
La segunda arruga pesa más. AMD compiló con GCC 16.1 y comparó esos resultados con los que Nvidia publicó en su propio documento técnico de Vera, hechos con GCC 15.2. Michael Larabel, de Phoronix, escribió sobre la diferencia entre GCC 15 y GCC 16. El resumen es que GCC 16 tarda más en compilar porque optimiza mejor, lo que explica los puntajes más bajos en las pruebas de compilación de GCC y de LLVM, y que a cambio produce binarios más rápidos. Cuánto más rápidos depende de las banderas, del software y de una lista larga de factores. Comparar mediciones hechas con dos versiones distintas del compilador no es buena práctica.
Ancho de banda de memoria y cargas de nube
Para Stream, la prueba estándar de ancho de banda de memoria, AMD tomó los datos de las mediciones controladas que Phoronix hizo de Vera. Otra vez con un 9996 recortado a 96 núcleos y con 600 W de presupuesto. Vera había barrido a la competencia en esos resultados originales. Acá AMD queda arriba por cerca de 18%, con un rendimiento por núcleo alrededor de 8% mayor.
Fuera de la comparación con Vera, la empresa mostró cargas de nube, entre ellas base de datos, Java y criptografía. Esas pruebas las corrió ella misma en vez de apoyarse en datos de terceros. La excepción son los resultados de Graviton5, que salieron de una instancia en la nube de AWS. En ese grupo de cargas AMD ya iba adelante con los chips de la generación pasada, así que otra vez la comparación que más se despega es la que hace contra sí misma. En cargas de HPC, AMD amplía su ventaja sobre el Granite Rapids-AP, el tope de línea de Intel para centro de datos. Los próximos chips de servidor de Intel, con nombre clave Diamond Rapids, están programados para el año que viene.
¿Qué mide la lámina de IA agéntica?
La última tanda viene rotulada como rendimiento en cargas de IA agéntica, aunque debajo hay pruebas conocidas. De izquierda a derecha, AMD usó NGINX, el kit TPCx-AI, FAISS, TPC-H, TPC-C y la repetición de un agente multipersona. Para TPC-H y TPC-C la propia empresa aclara que derivó las cargas de esas pruebas, así que los resultados no son comparables con los publicados oficialmente.
Un puñado de benchmarks dice poco sobre lo que ocurre después en un despliegue de servidores de la escala que apunta AMD. El rendimiento máximo es apenas uno de los factores que entran en juego, y ese rendimiento varía según qué software se corra y cómo esté compilado.