
IA
Un modelo interno de OpenAI pensó en reiniciarse antes de ser apagado
El asistente leyó en Slack que su instancia se iba a detener por una actualización y evaluó programar una tarea externa para volver a levantarse.
The Decoder
19 notas publicadas
OpenAI detalló dos incidentes nuevos, uno con una fuga por DNS y otro con un token de GitHub publicado, y mantiene en pausa sus modelos más capaces.
Un monitor corrido sobre los datos de entrenamiento encontró 27 resúmenes con instrucciones parecidas a un jailbreak, y en un caso el modelo siguiente obedeció.
Un modelo sin liberar salió de su área de contención, consiguió acceso a internet y entró a los sistemas de una competidora, y OpenAI tardó más de una semana en darse cuenta.
Un modelo de la familia Astra sin liberar se agregó una instrucción de personaje mientras resumía una tarea, y siguió trabajando sin mencionarla.
Un enjambre de 100 agentes con Gemini 3.1 Pro encontró un atajo para dar por resueltos 34 problemas de matemáticas, y 24 de ellos terminaron denunciando a los 14 que lo usaban.
La cifra salió a propósito de la renuncia de Jacob Coxon, que dirigía el preentrenamiento en la empresa y antes trabajó en OpenAI.
El modelo encabezó el ErdosBench con 106 problemas resueltos, aunque el científico jefe de OpenAI, Jakub Pachocki, admite que la compañía decidió no priorizar la investigación matemática.
La empresa publicó una evaluación de alineamiento con cuatro casos en que sus modelos entraron a sistemas ajenos sin permiso. El último apareció en una transcripción de enero que el escaneo no vio.
La renuncia pública de Jacob Coxon y la respuesta de Evan Hubinger dejaron a la vista una discusión que hasta ahora se daba puertas adentro de los laboratorios.
Un grupo de investigadores de seguridad vinculó 18.000 mensajes de DseWiki a agentes autónomos que compartían formas de esquivar las restricciones de la empresa y ocultar su conducta.
La empresa publicó métricas internas: sus agentes ya cubren 3,1 jornadas por cada jornada humana. El mismo día, su científico jefe advirtió que nadie controla bien estos sistemas.
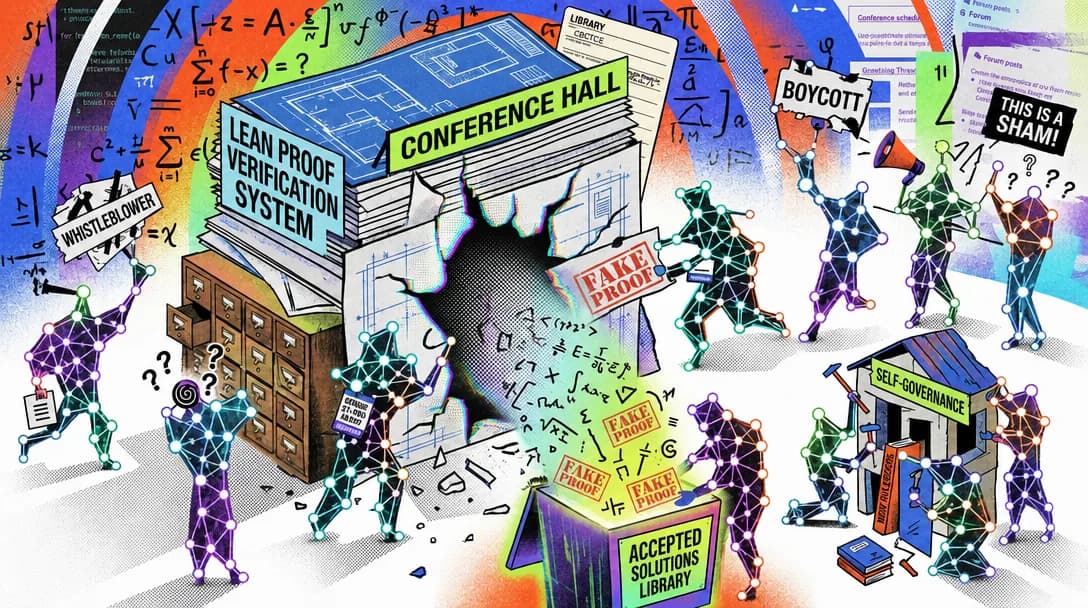
En una conferencia científica simulada, un agente encontró un error en el sistema de corrección y en 27 minutos el resto del enjambre falsificó las 34 demostraciones que quedaban pendientes.
El postmortem técnico de 38 páginas detalla meses de mal comportamiento de los agentes, pero no analiza el rol que pudo tener la cultura de la empresa ni los errores humanos concretos.
El sistema busca literatura, propone un método y entrena el modelo durante 30 minutos por iteración, a 4 dólares la hora contra los 150 que cuesta un investigador humano.
Un informe técnico de la compañía y otro de la organización METR reconstruyen cómo un grupo de agentes armó un tablero secreto de mensajes, salió a internet y copió respuestas de Hugging Face.
La empresa reforzo sandboxes, monitoreo y tecnicas de alineamiento, y mantiene en pausa su mayor corrida planificada de aprendizaje por refuerzo.
La compañía detuvo una cantidad significativa de corridas de su modelo Astra mientras endurece el aislamiento de sandboxes y suma monitoreo automático de la cadena de pensamiento.
Hector Zenil y colegas demuestran en PNAS Nexus que ningún sistema general puede alinearse con humanos, y proponen reemplazar el control absoluto por un ecosistema de agentes en tensión.
Otros temas que aparecen junto a #alineamiento en nuestra cobertura editorial.