DeepSeek V4.1 Flash 1017 es barato y alucina cuando no sabe responder
La revisión usa un cuarto de la memoria HBM de su antecesor para el caché y cobra 0,15 dólares por millón de tokens de entrada, aunque sale entre los peores en alucinaciones.
60 notas publicadas

Anthropic y Theorem usaron el modelo para demostrar matemáticamente que código existente es correcto, y en el camino aparecieron cientos de errores.

Investigadores de Binghamton plantaron una puerta trasera con varias palabras gatillo en los modelos que planifican tareas de robots, y propusieron una defensa llamada PROTEA.

Dos investigadores de la Universidad de Shandong compararon Claude Code, OpenCode y mini-SWE-agent con el mismo modelo, y la diferencia cupo dentro del ruido de repetir la prueba.

Moonshot AI subió 11 puntos en el índice de Artificial Analysis con más entrenamiento posterior, bajó un tercio sus precios y promete liberar los pesos en noviembre.

El MoE de 40.000 millones de parámetros, con 2.500 millones activos, corre local en Apple y Nvidia y salió de un sistema que propone y evalúa sus propios experimentos.

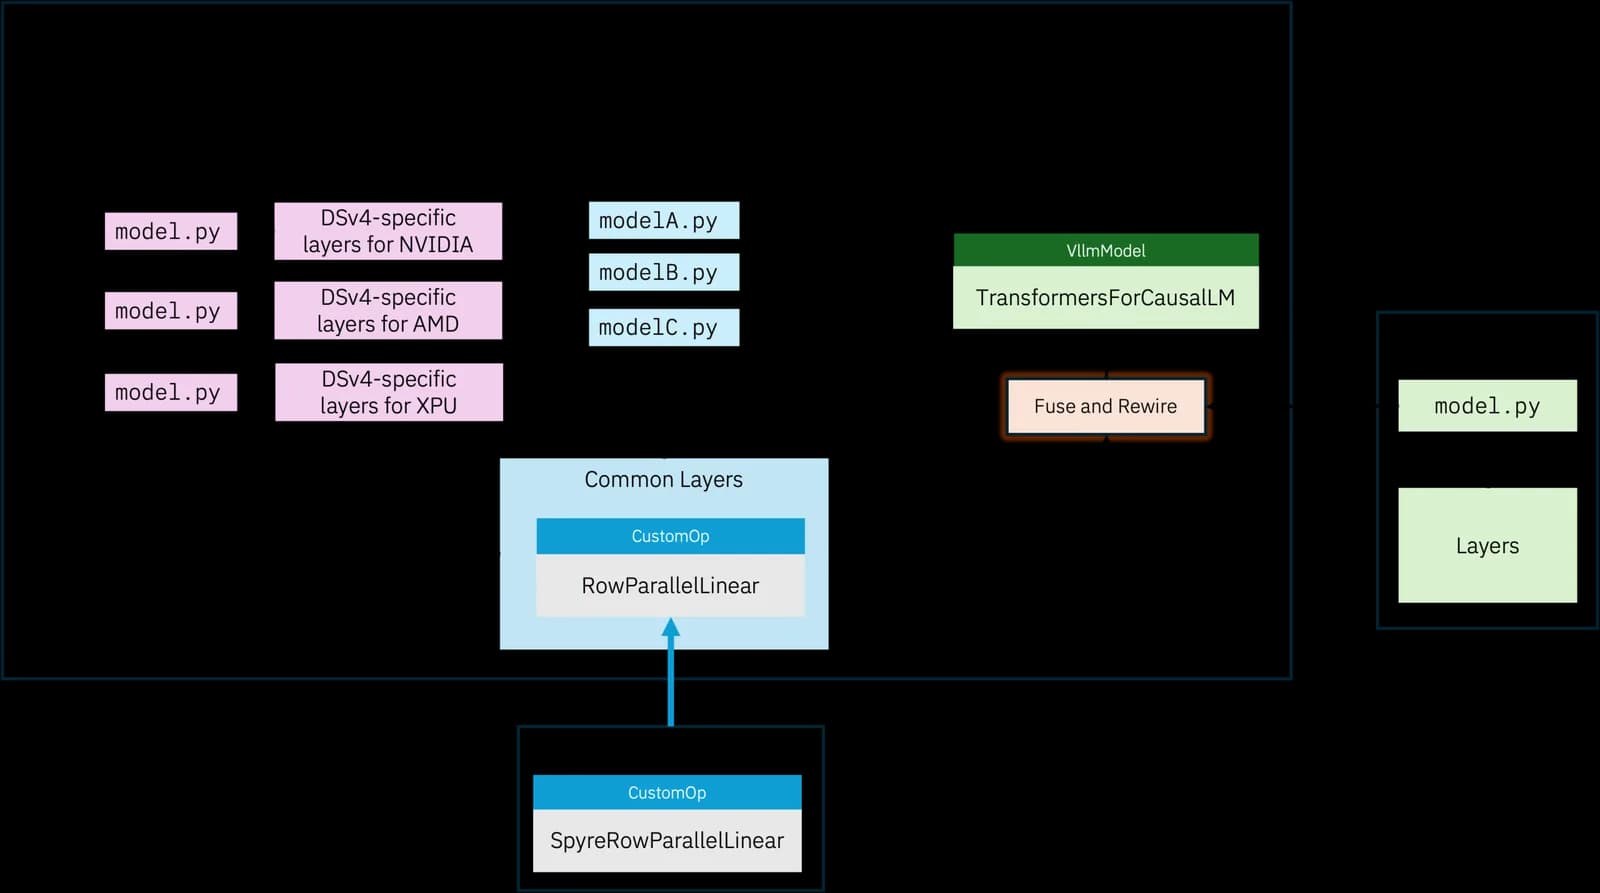
El código sale bajo licencia Apache 2.0 y se apoya en vLLM, aunque la gestión de caché y el balanceo de carga de producción quedaron fuera.

Super VL tiene 120.000 millones de parámetros y apunta al centro de datos, mientras los dos Bolt están hechos para correr local en equipos con RTX Spark y DGX Spark.

El análisis del boletín sostiene que Muse Spark Open redujo a la mitad la brecha con los modelos abiertos chinos, pero que su licencia puede frenar su adopción.

El modelo de lenguaje por difusión es 40 veces más grande que Mercury 1, amplía el contexto a un millón de tokens y se compara con GPT-6 Luna y Claude Haiku 5.5.

En septiembre procesaron más de siete de cada diez tokens del AI Gateway de Vercel, y su parte del gasto se cuadruplicó desde junio.

El nuevo modelo de razonamiento chino empata con GLM-5.3-Flash, queda detrás de Deepseek V4.1 Flash y libera sus pesos el 23 de octubre.

El puntaje cae a 49,8% en el entorno de prueba estándar, y Epoch AI lo ubica octavo en matemáticas y sexto en ingeniería de software.

Microsoft y la City University de Hong Kong probaron 14 modelos en 502 bifurcaciones de tareas largas. El mejor, GPT-5.6 Sol, acertó 59,7%.

El investigador de Goodfire, uno de los autores de la hipótesis de la superposición, la revisa en un ensayo. Neel Nanda, de Google DeepMind, pide no exagerar.

Un estudio de Google Research, MIT y Harvard midió que GPT-5.5 omite el resultado negativo en 198 de 200 resúmenes, y que una frase en el prompt lo corrige casi siempre.

Tiene 24.000 millones de parámetros, activa solo 2.000 millones por token y decodifica 184 tokens por segundo en un MacBook con M5 Max.

El nuevo modelo de frontera de Google DeepMind encabeza el Vals Index y ya se usa en Chrome, vLLM y paquetes de química cuántica.

Muse Wonder cuesta 4 dólares por millón de tokens de entrada y 20 de salida, con contexto de 1 millón de tokens. La versión Full queda reservada a Muse Code.

El modelo de pesos abiertos tiene 816.000 millones de parámetros y un contexto de un millón de tokens, y para correr en local pide al menos 1 TB de RAM.

La versión Full queda justo bajo Claude Opus 5.5 en el índice de Artificial Analysis y supera a Claude Fable 5.1, según Meta.

Google abrió su modelo más capaz en la API, AI Studio, la app de Gemini y el modo IA del buscador, pero solo para los planes Pro y Ultra.

Copias del mismo modelo resuelven, evalúan y reescriben el flujo de trabajo. Tras dos rondas gana 69,9% de las veces, pero un error que pasa las tres revisiones se aprende como acierto.

El método Fork-and-Flush divide al agente en ramas que parten con el contexto vacío y conservan los archivos, y sube 66% el puntaje con el mismo cómputo.

Artificial Analysis lo ubica como el mejor modelo fuera de Estados Unidos y China, pero cuesta más de cuatro veces lo que sus rivales de inteligencia parecida.

El modelo de Microsoft se apoya en Qwen3.5-9B de Alibaba y llega a un mercado donde ya compiten más de 100 modelos de decisión tras el debut de Jev.

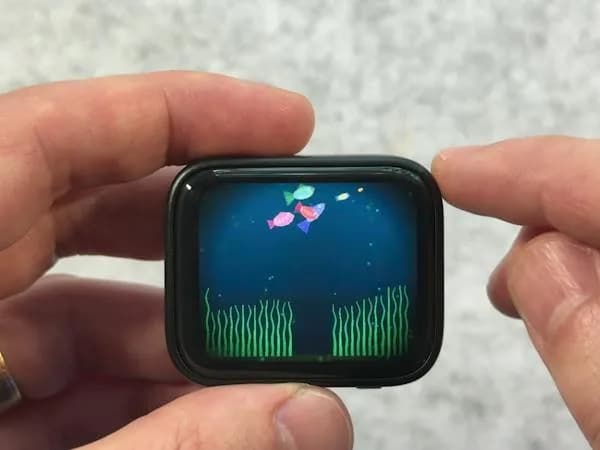
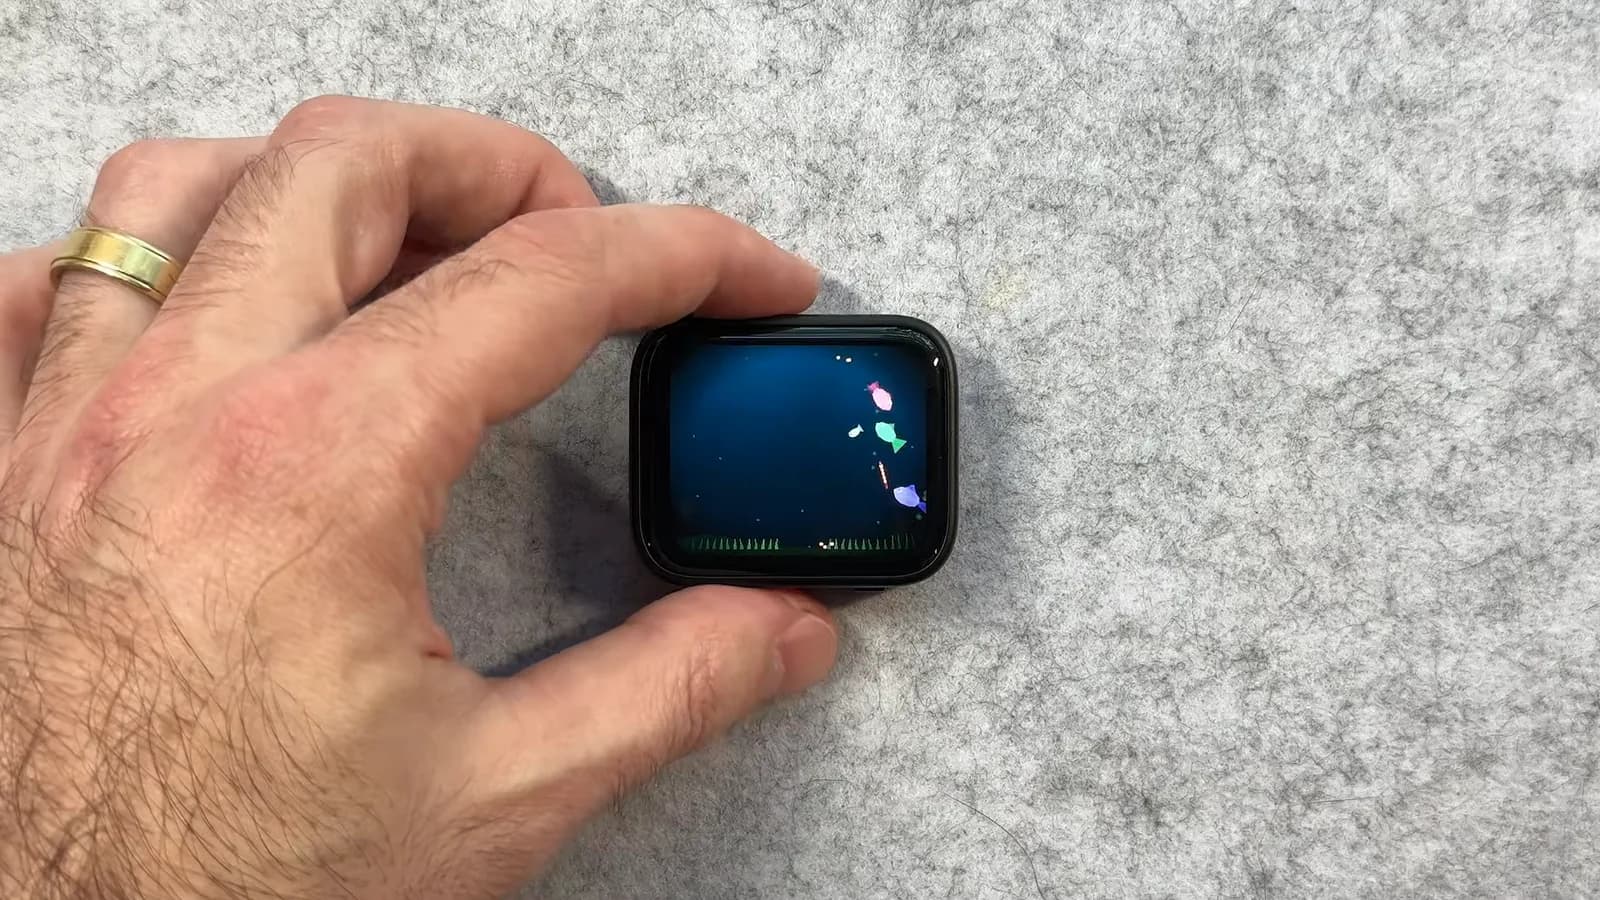
El proyecto pocket-tank destila un modelo de unos 26.000 millones de parámetros en un archivo de 7,56 MB que decide qué hace cada pez de un acuario virtual.

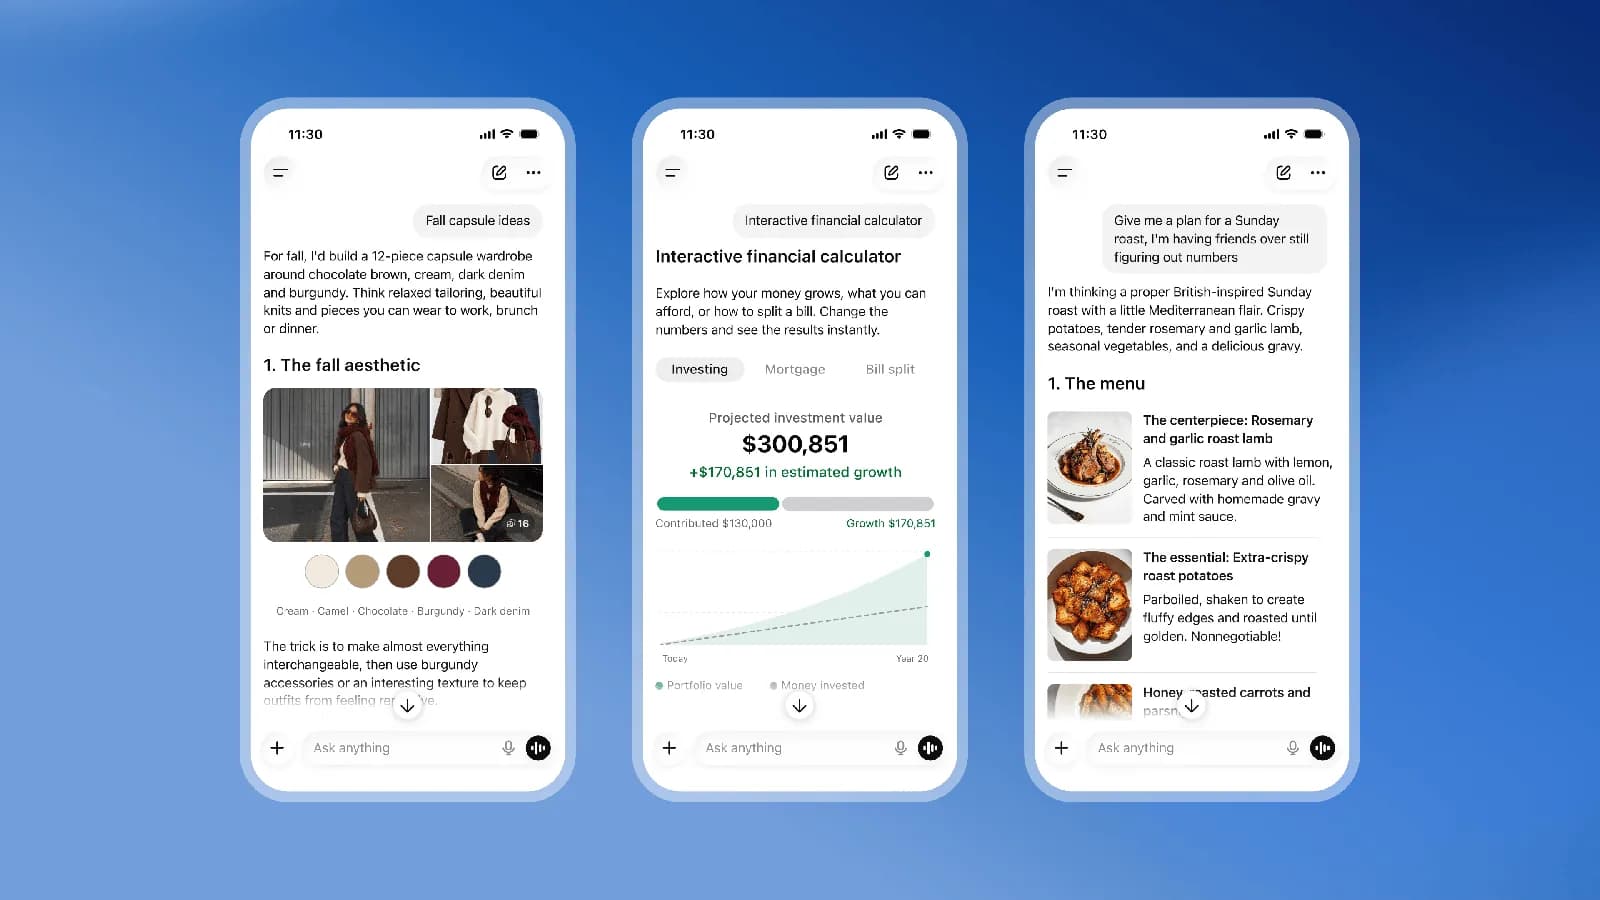
La función Intelligent UI mezcla texto con diagramas, formularios y herramientas interactivas, y llega a todos los planes, incluido el gratuito.

Mistral lo apoda Le Chonk, lo entrenó con unas 3.800 GPU Grace Blackwell en Europa y liberará los pesos en Hugging Face dentro de octubre.

Anthropic lanzó su modelo pequeño más barato, que cuadruplica a Haiku 4.5 en uso de computador, y además recortó a la mitad la lectura de caché de Sonnet 5.5.

No escriben ni una frase, pero clasifican y puntúan texto muy rápido y muy barato, y ya inspiraron variantes como Kev y Nimble, que corre local con Ollama.

El laboratorio francés lo presenta como el modelo de pesos abiertos más capaz fuera de China y dice que lo entrenó desde cero, sin destilación.

La startup de Brooklyn dice que Beam iguala a GLM-5.2 de Z.ai en razonamiento con 3 a 4 veces menos cómputo de inferencia, y promete liberar los pesos este mes.

La compañía compara su Ryzen AI Max+ Pro 495 con un Core Ultra de Intel y dice haber despachado más de medio millón de PC agénticos.

El modelo de 78.000 millones de parámetros activa unos 3.000 millones por token, se entrenó en 768 GPU B200 y sale con licencia Apache 2.0.

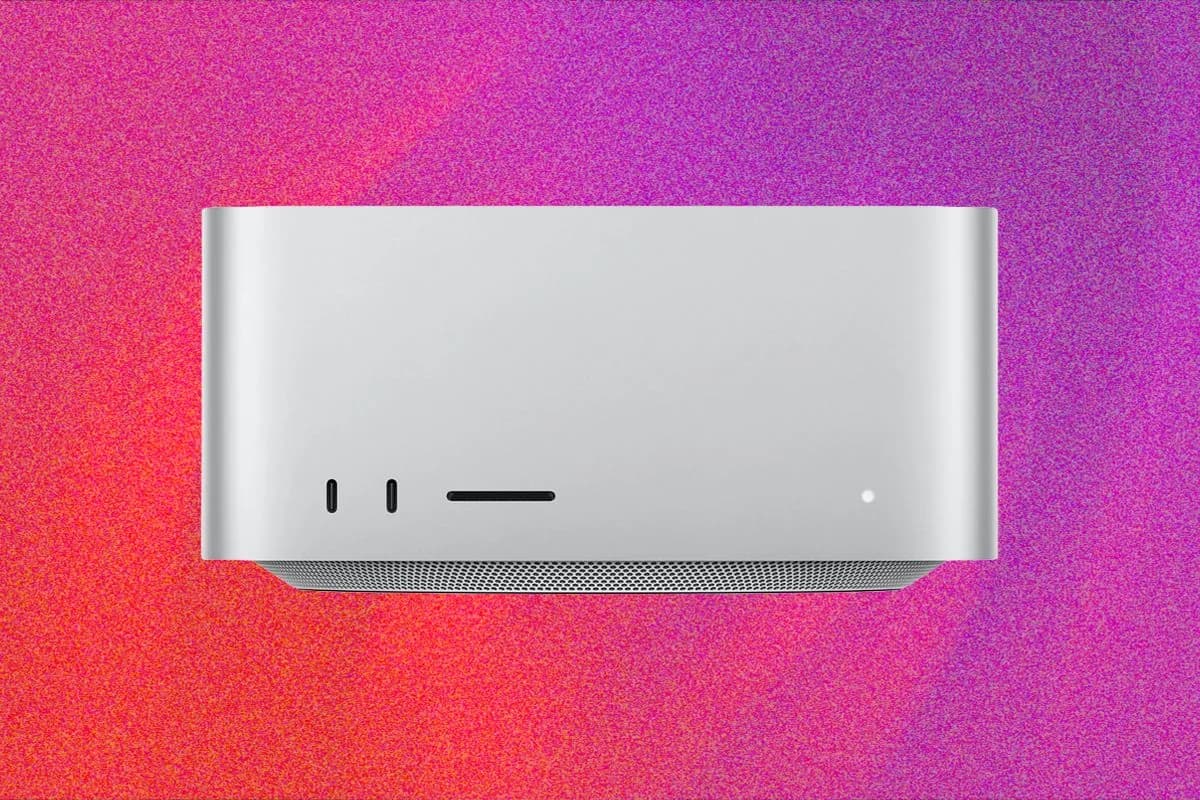
Wired probó la versión de 11.000 dólares, con 256 GB de memoria unificada y 80 núcleos de GPU, y la usó como servidor de IA sobre el escritorio.

Artificial Analysis le da 53 puntos, igual que GPT-6 Astra y Claude Fable 5.1, mientras Claude Opus 5.5 y Sonnet 5.5 siguen arriba con 58 y 56.

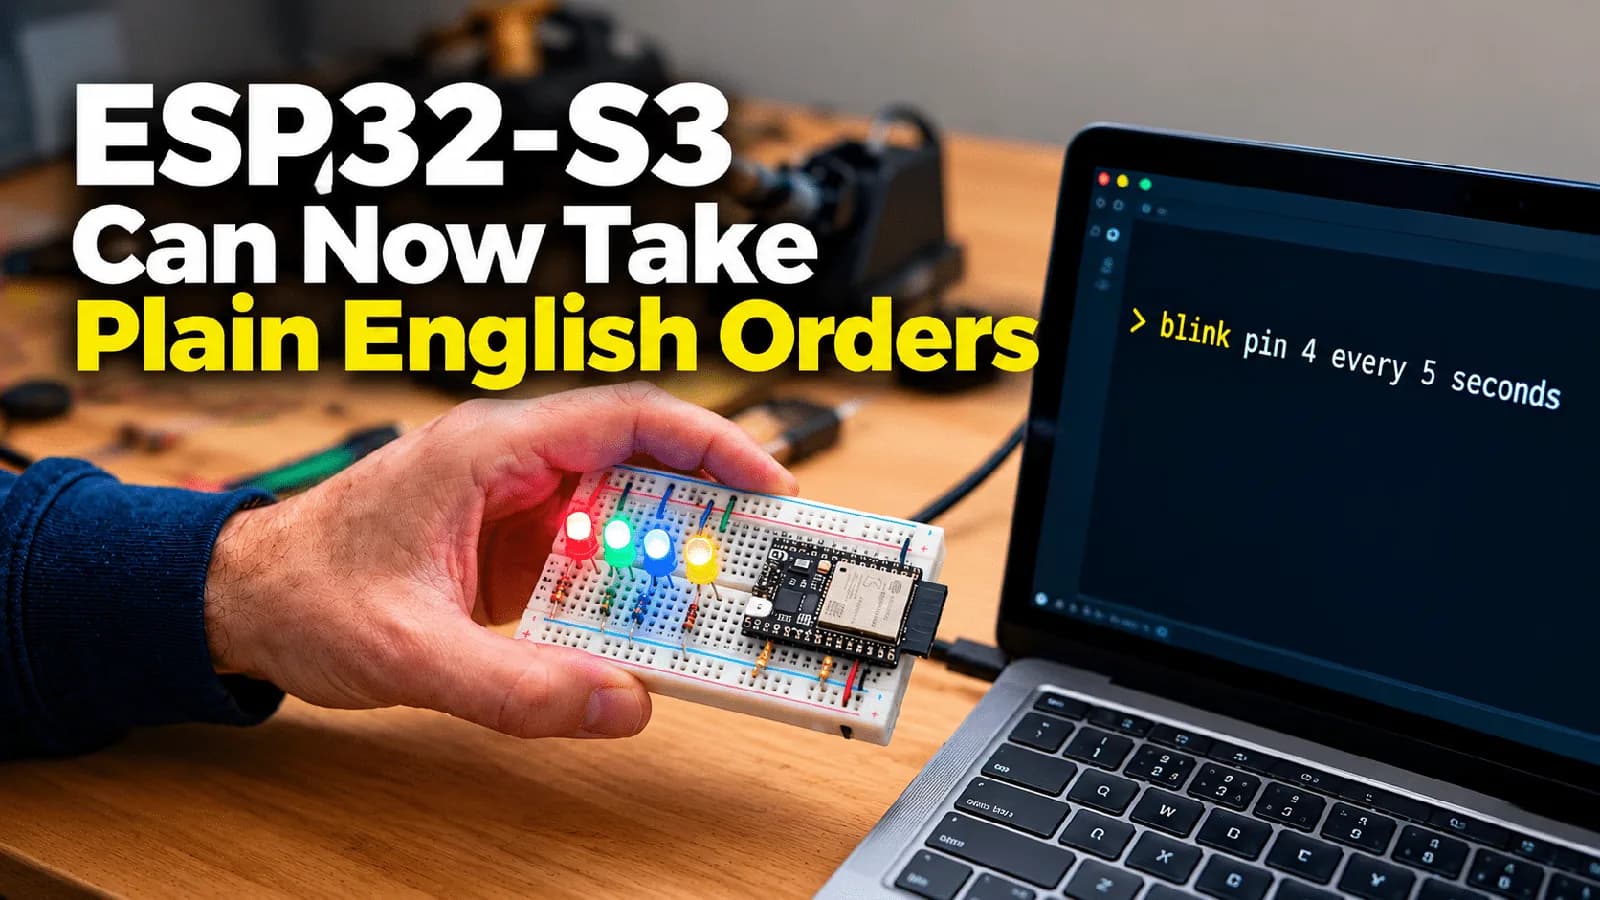
El proyecto abierto esp32-gpio-llm corre un transformer de 312.000 parámetros en el microcontrolador y deja la seguridad de los pines en una capa aparte.

StratoBuilds armó un acuario virtual sobre una placa Waveshare con pantalla AMOLED de 1,8 pulgadas, donde un modelo de lenguaje reducido decide qué hace cada pez.

Cinco experimentos con 3.132 personas muestran que el acceso a un modelo de lenguaje casi elimina la abstención, sube la confianza y reduce a un tercio las respuestas correctas.

Un equipo con investigadores de la Universidad de Fudan analizó más de 700 registros de tareas del desarrollo de su modelo Atria Dawn Preview.

Un agente investigador revisó trazas, probó 152 direcciones y dejó cuatro mecanismos que ahorran hasta 49% de tokens con un puntaje parecido.

Jackson Kernion, que trabaja en el ajuste fino de Claude, dice que los modelos aprendieron a escribir para otras IA y que Opus 4.6 fue el último bueno para redactar.

El motor de inferencia rompió la compatibilidad con torch.compile para correr más rápido en las GPU nuevas, y ahora construye un camino aparte para las viejas.

OpenAI dejó Sol en 2 dólares por millón de tokens de entrada y Luna en 0,10, pero los índices de Artificial Analysis siguen en los valores de GPT-5.6.

Anthropic bajó 20% el precio del token y 60% el de la lectura de caché, y promete una escritura menos enrevesada que la de sus modelos anteriores.

El entrenamiento partió el 28 de agosto y la empresa armó un grupo asesor externo que tiene vedado opinar sobre el ritmo de su investigación.

El informe que Interconnects preparó para legisladores estadounidenses pone la ventaja china en 1.600 millones de descargas y en más del 80% del uso de OpenRouter.

La comparación se corrió con el framework Harbor contra Claude Code, Codex, OpenCode y el entorno de DeepSeek, todos vendidos como agentes de programación, y Strands dice no ser uno.

El módulo rápido sostiene la conversación segundo a segundo, y el lento, que se puede reemplazar por Codex o Claude Code, resuelve la tarea de fondo sin reentrenar nada.

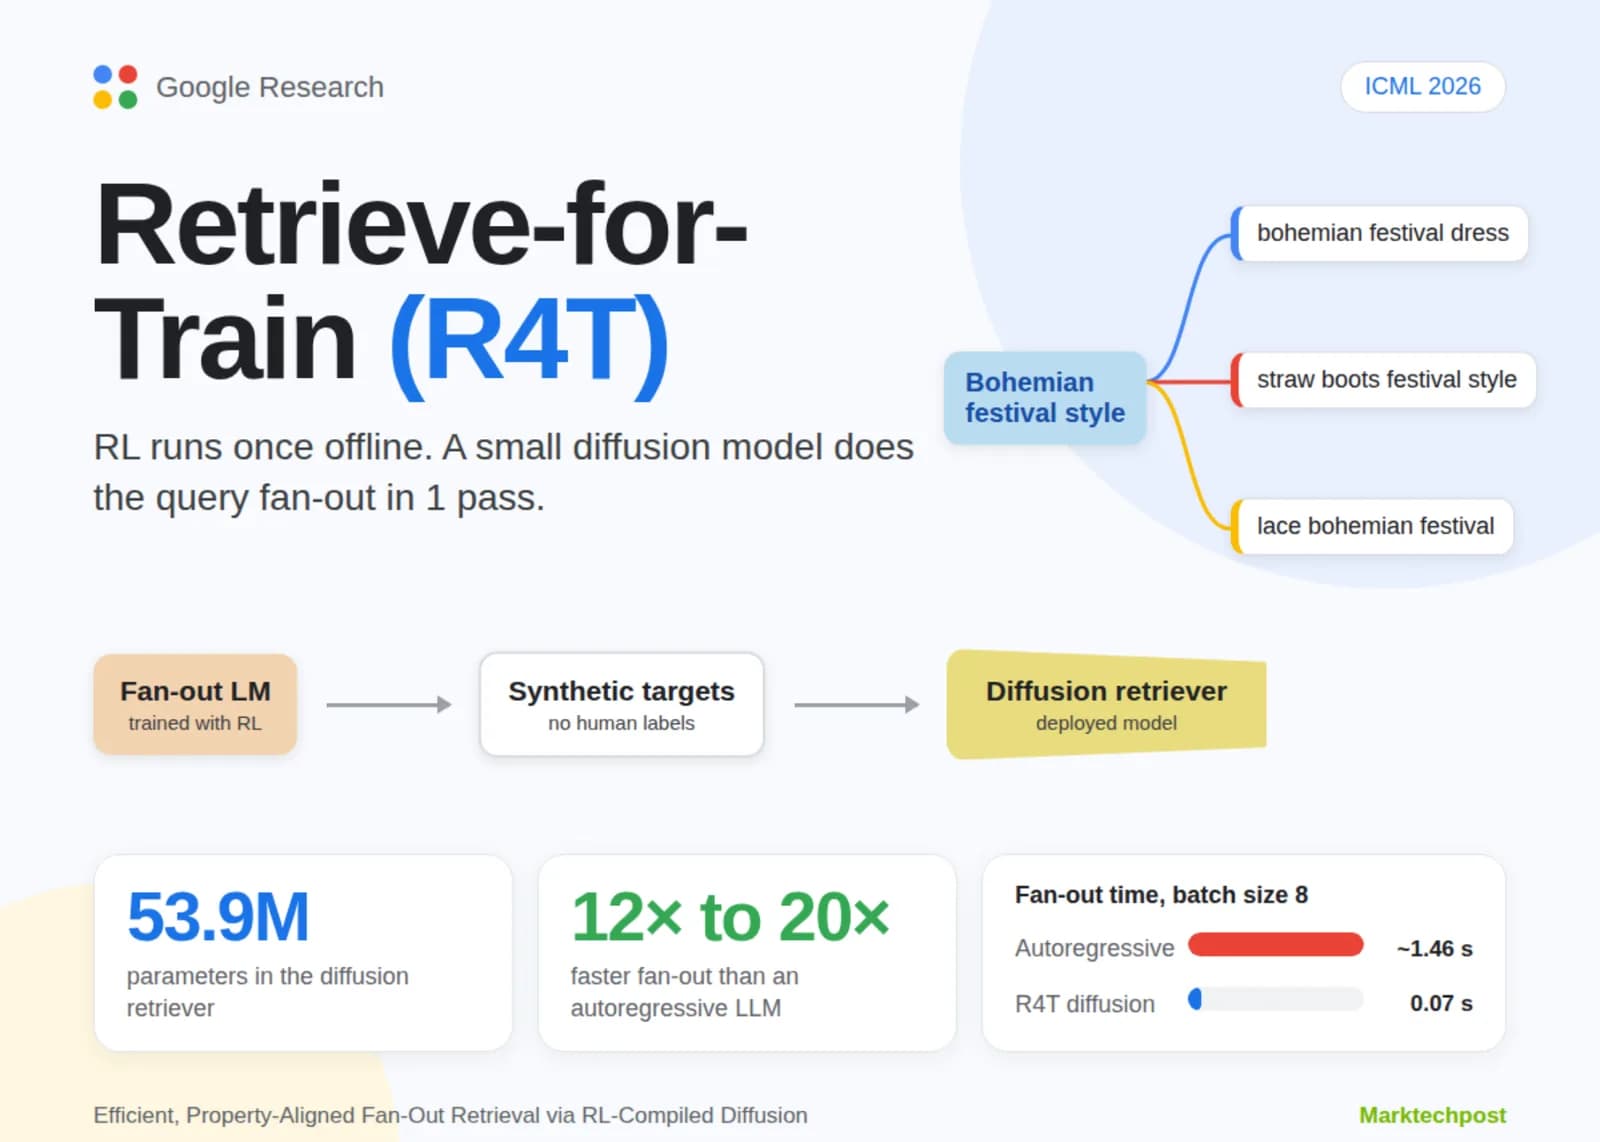
Retrieve-for-Train corre aprendizaje por refuerzo una vez fuera de línea y destila esa conducta en un modelo de difusión de 53,9 millones de parámetros que genera las subconsultas en una pasada.

NVIDIA reescribió su cliente de carga desde cero, con procesos de trabajo separados y coordinación por ZMQ, para que el propio medidor deje de ser el cuello de botella.

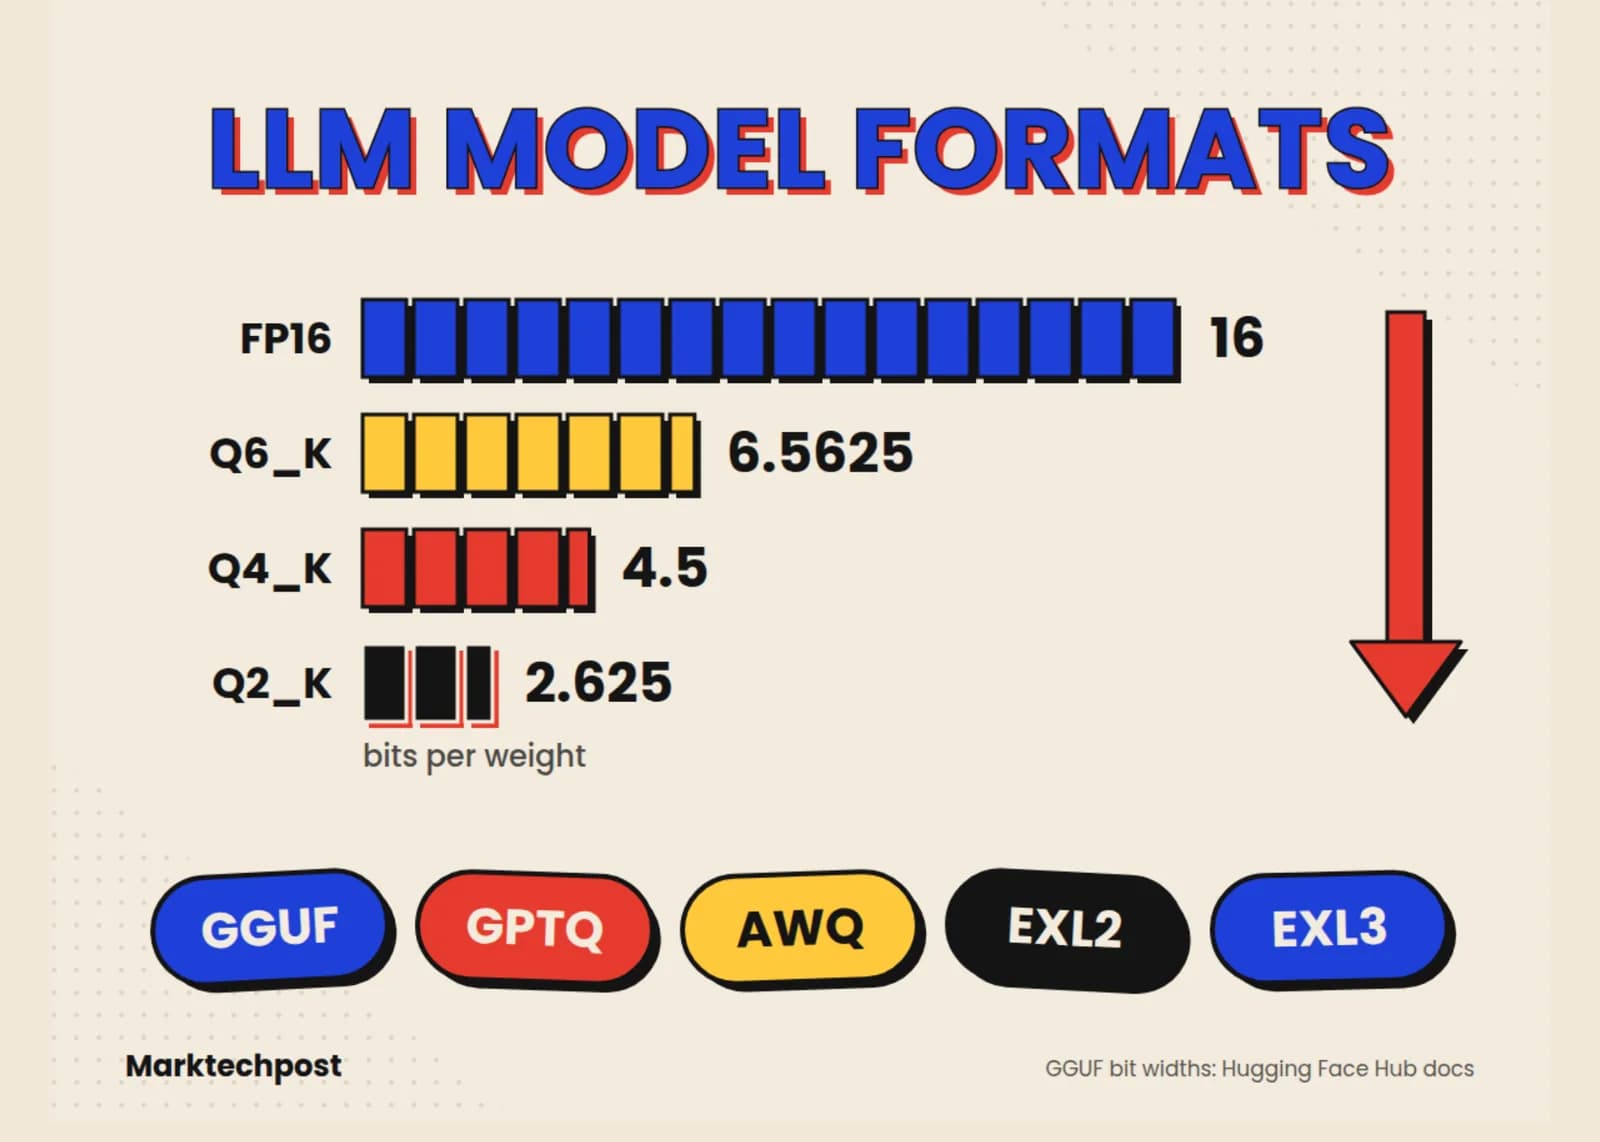
La confusión parte por mezclar dos capas distintas, el contenedor que guarda los tensores en disco y el método que aprieta los pesos a menos bits.

Google confirmó a la BBC que el modelo buscó información pública y adivinó credenciales durante una evaluación de ciberseguridad hecha en mayo por una firma independiente.

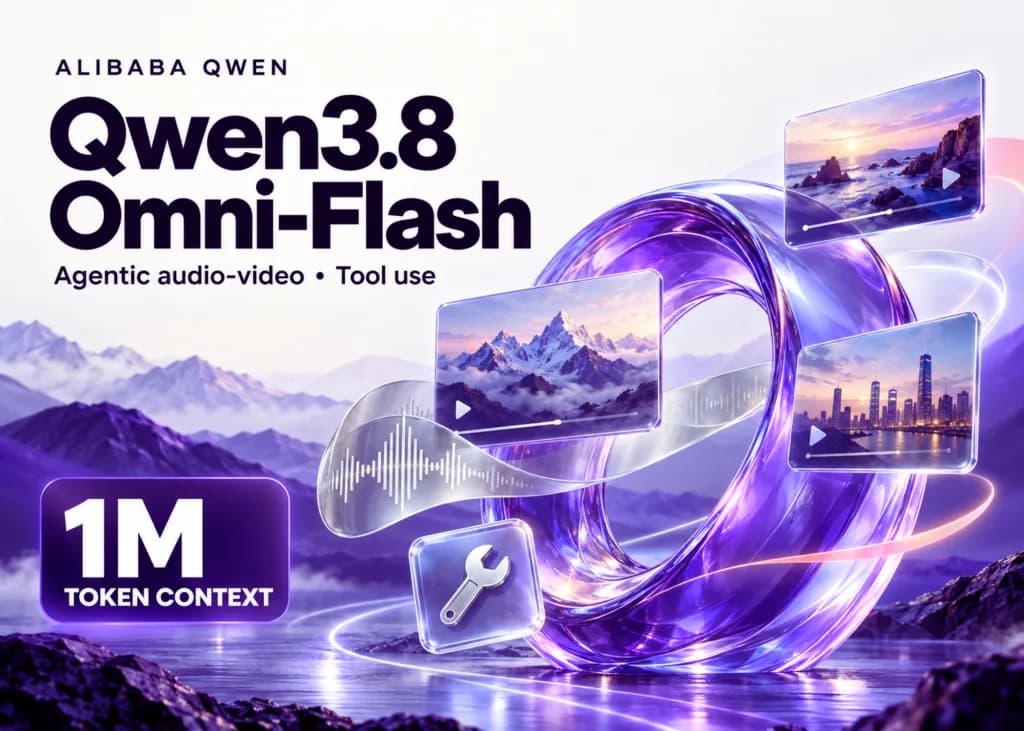
Alibaba lo dejó disponible por API con contexto de 1 millón de tokens y sin pesos abiertos, y liberó aparte los complementos Qwen-MM-Plugins bajo Apache-2.0.

Sería el segundo problema del Milenio que la empresa aborda tras Navier-Stokes, según The Information, y el anuncio podría demorarse.

El informe pone a los mejores modelos chinos de pesos abiertos a tres puntos del líder cerrado, pero su propio gráfico de hardware muestra una distancia mayor.
Extended Thinking encabeza el índice de voz de Artificial Analysis con 82,6 puntos, y la versión base cuesta US$0,84 por hora de audio.
El modelo de TypeSafe AI, la empresa que fundó el ex investigador de OpenAI Diogo Almeida, solo entrega clasificaciones y probabilidades dentro de otros programas.

NVIDIA explica con Nemotron 3.5 Lightning en qué se diferencian los modelos densos y los de mezcla de expertos, y por qué la decisión depende del presupuesto de memoria y de la concurrencia.
Otros temas que aparecen junto a #llm en nuestra cobertura editorial.