Saltar al contenido
Etiqueta

#llm local

9 notas publicadas

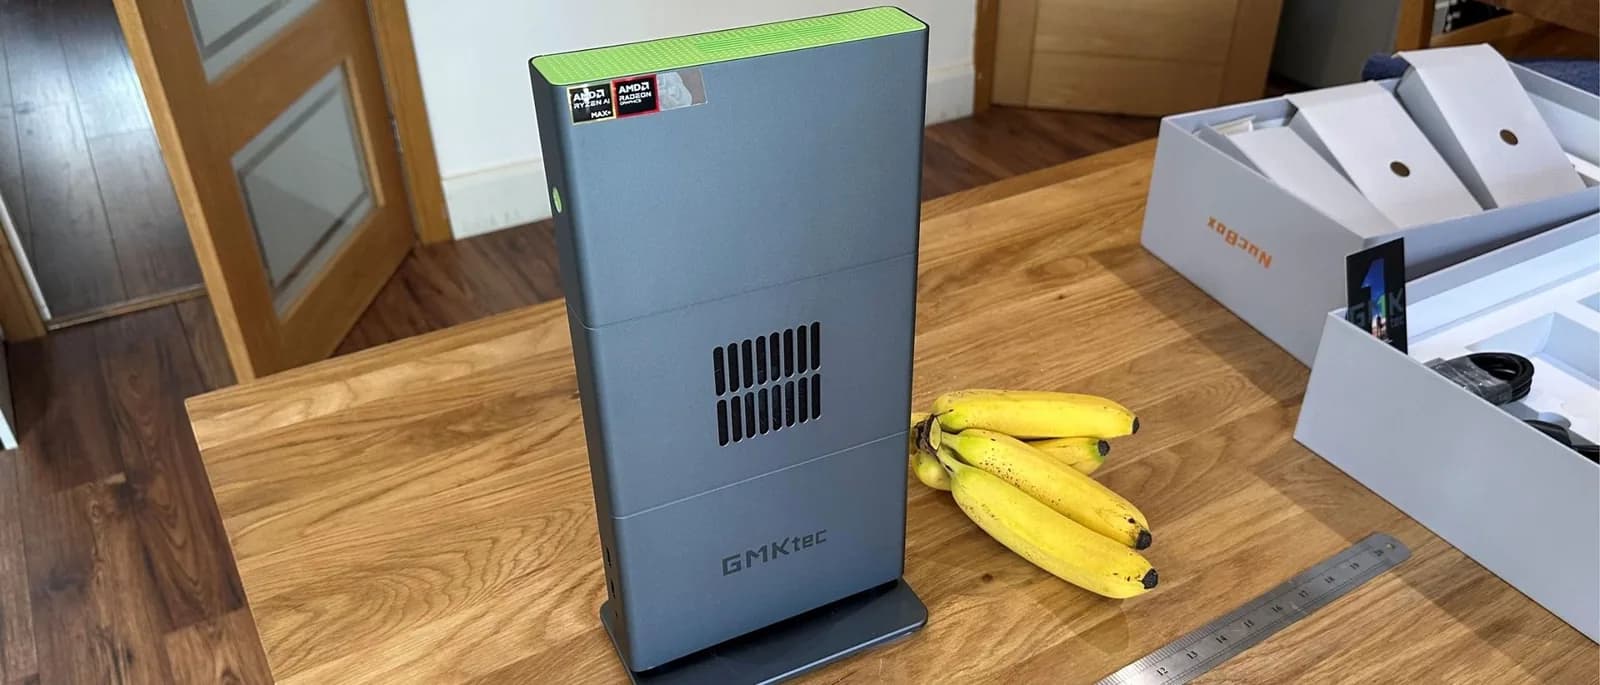
GMKtec Evo-X3 trae 128 GB de RAM y cuesta el doble que el Evo-X2
Electrónica

GMKtec Evo-X3 trae 128 GB de RAM y cuesta el doble que el Evo-X2

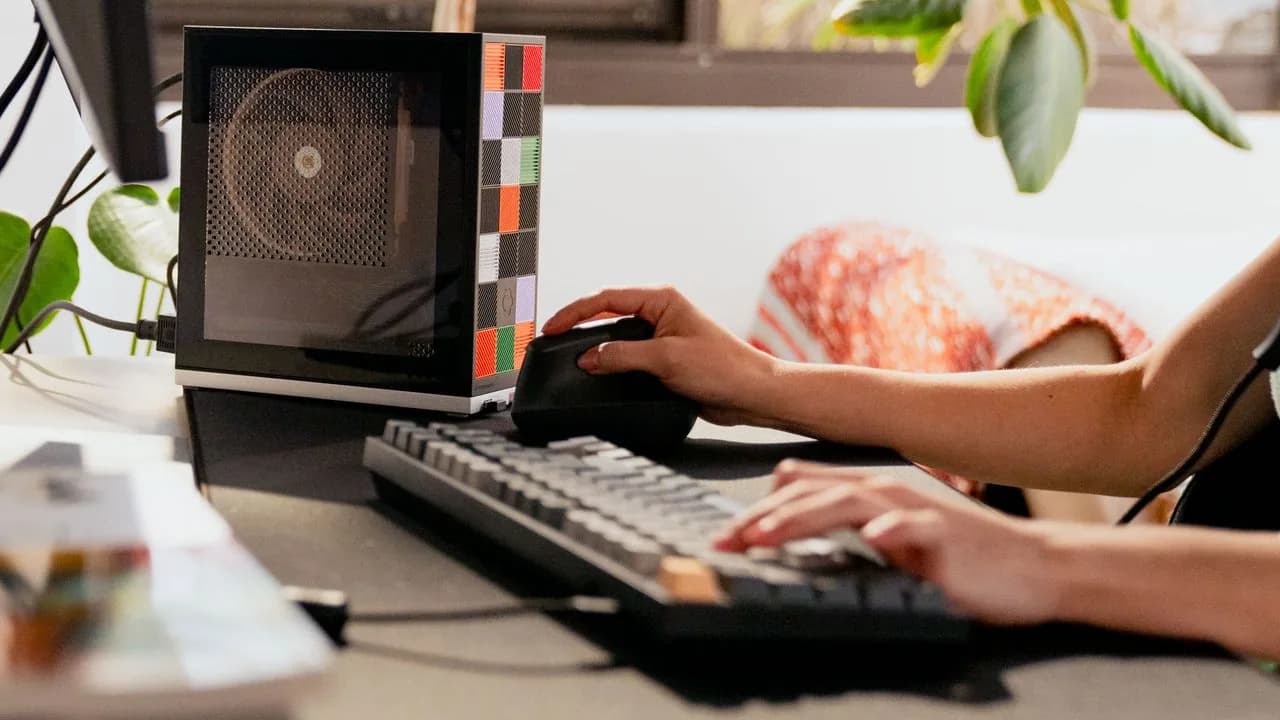
Tom's Hardware probó el nuevo mini PC con Ryzen AI Max+ 395, chasis metálico y hasta 96 GB para la GPU, que sale 3.799,99 dólares en su versión de 128 GB y 2 TB.

Tom's Hardware
Transformers ya corre los modelos GGUF de llama.cpp
IA

Transformers ya corre los modelos GGUF de llama.cpp

La integración reutiliza los kernels de ggml, parte por los Mac con Apple Silicon y arranca con la arquitectura Qwen3.5.

Hugging Face
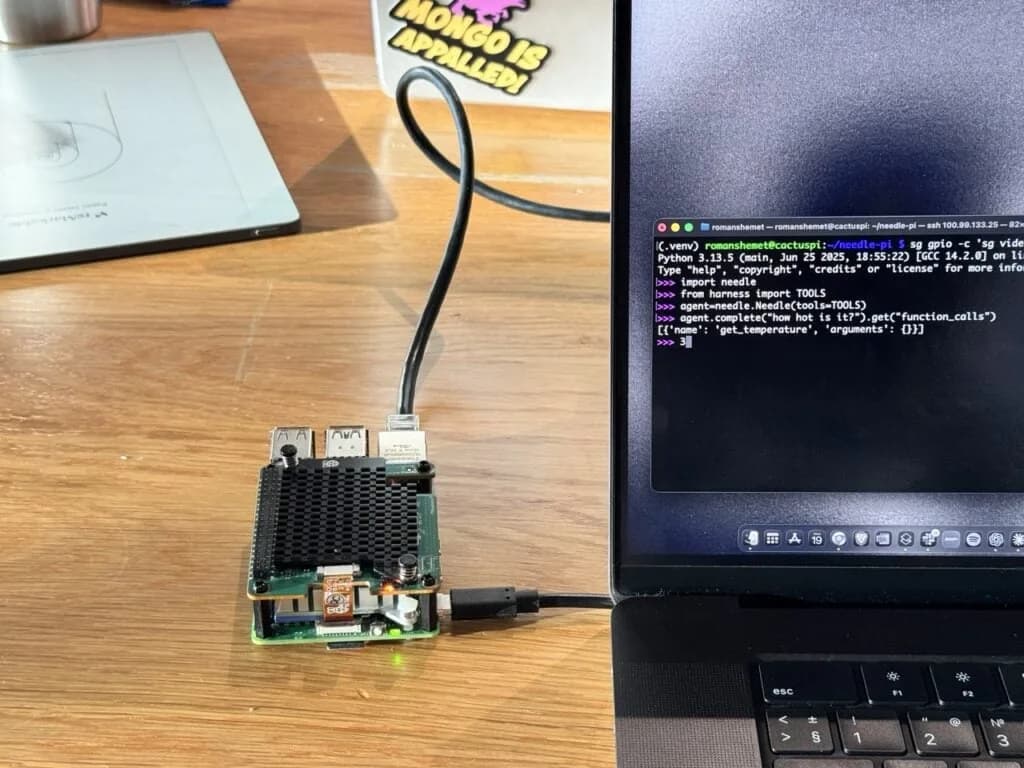
Needle 2 pesa 14 MB y llama funciones en el Pi 5 con CPU
Electrónica

Needle 2 pesa 14 MB y llama funciones en el Pi 5 con CPU

El modelo tardó 78 milisegundos en encender un LED y corre sin conexión a internet después de la primera descarga.

Raspberry Pi
OpenCode encabeza once entornos de agentes para modelos locales
IA

OpenCode encabeza once entornos de agentes para modelos locales

MarkTechPost ordenó 11 proyectos de código abierto según lo bien que documentan la inferencia local, con los datos de cada repositorio leídos en GitHub el 18 de septiembre de 2026.

MarkTechPost
Un servidor usado de 500 dólares corre modelos de IA sin GPU
Robótica

Un servidor usado de 500 dólares corre modelos de IA sin GPU

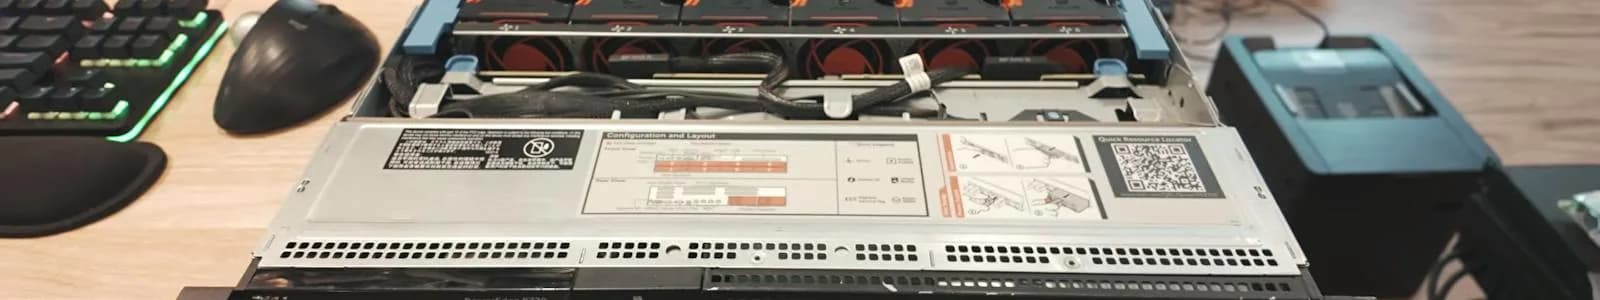
El youtuber MattMo llenó un Dell PowerEdge R720 de 2012 con 384 GB de memoria DDR3 ECC y ejecutó modelos completos en los dos Xeon, sin una sola tarjeta aceleradora.

Hackster.io
Qwen2.5 Coder 14B local reemplaza a Claude en un MacBook Air
Electrónica

Qwen2.5 Coder 14B local reemplaza a Claude en un MacBook Air

Un desarrollador dejó el plan de 20 dólares mensuales de Anthropic y movió su asistente de programación a un equipo de 16 GB, con resultados suficientes para su flujo de trabajo.

Hackaday
Dos mini PCs locales para 50 millones de tokens al día
Electrónica

Dos mini PCs locales para 50 millones de tokens al día

Un periodista de tecnología cuenta cómo armó un stack casero con un AMD Ryzen AI Max+ 395 de 96 GB para correr Qwen3.5 sin pagar APIs frontera.

Tom's Hardware
Osaurus: servidor LLM open source para Mac con MCP nativo
IA

Osaurus: servidor LLM open source para Mac con MCP nativo

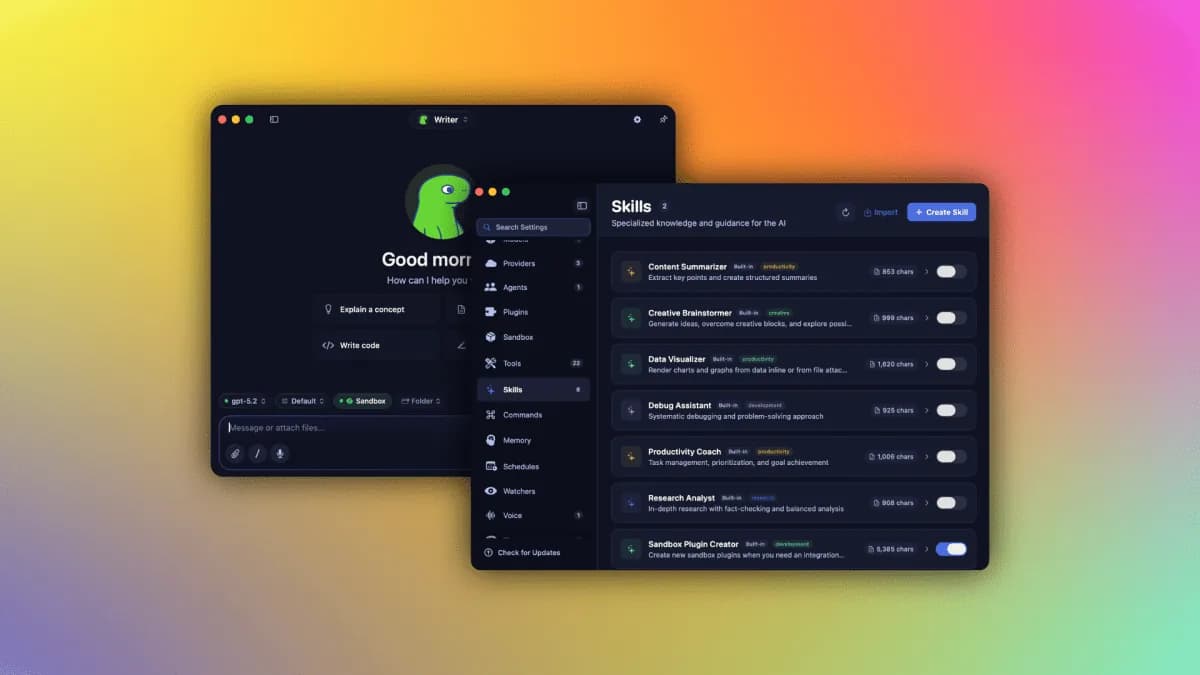
El proyecto corre MiniMax M2.5, Gemma 4, Qwen3.6, DeepSeek V4 y los modelos on-device de Apple, con sandbox por hardware y más de 20 plugins integrados.

TechCrunch AI

Etiquetas relacionadas

Otros temas que aparecen junto a #llm local en nuestra cobertura editorial.