
Electrónica
Microsoft lanza Decision-1, un modelo de decisión basado en Qwen
El modelo de Microsoft se apoya en Qwen3.5-9B de Alibaba y llega a un mercado donde ya compiten más de 100 modelos de decisión tras el debut de Jev.
The Register
29 notas publicadas
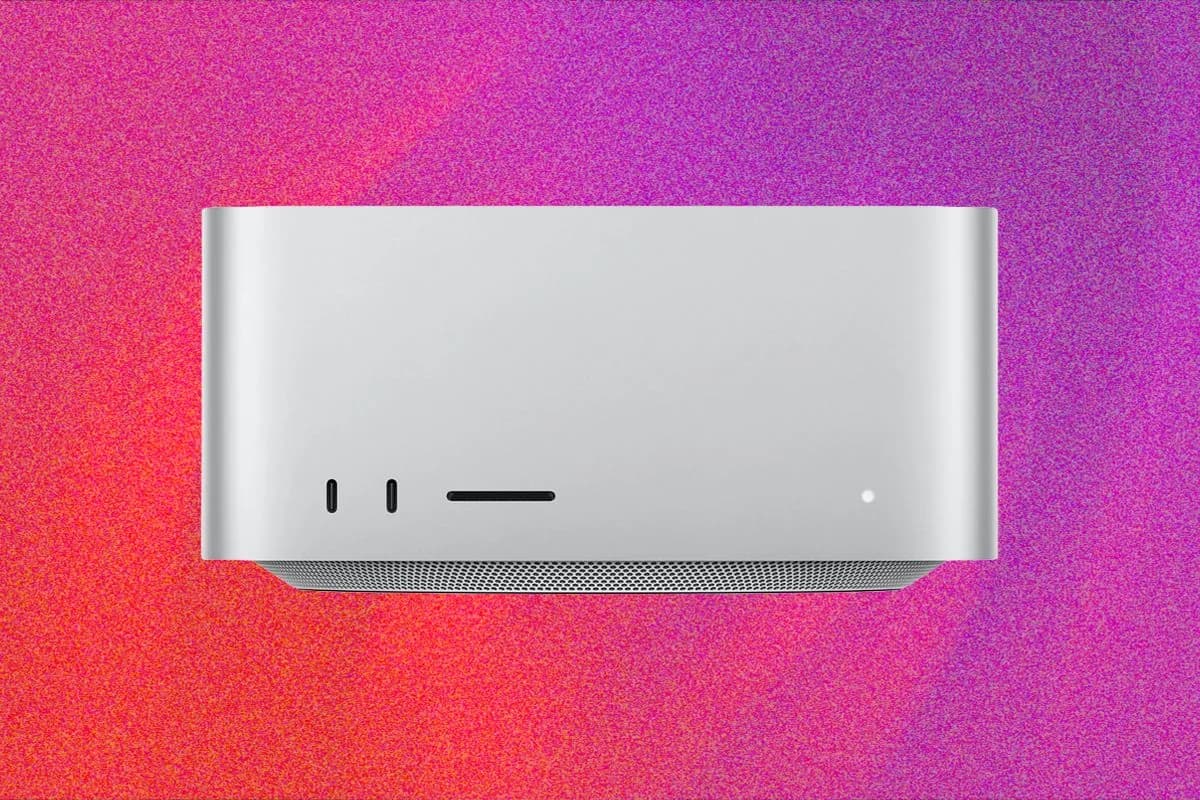
Wired probó la versión de 11.000 dólares, con 256 GB de memoria unificada y 80 núcleos de GPU, y la usó como servidor de IA sobre el escritorio.
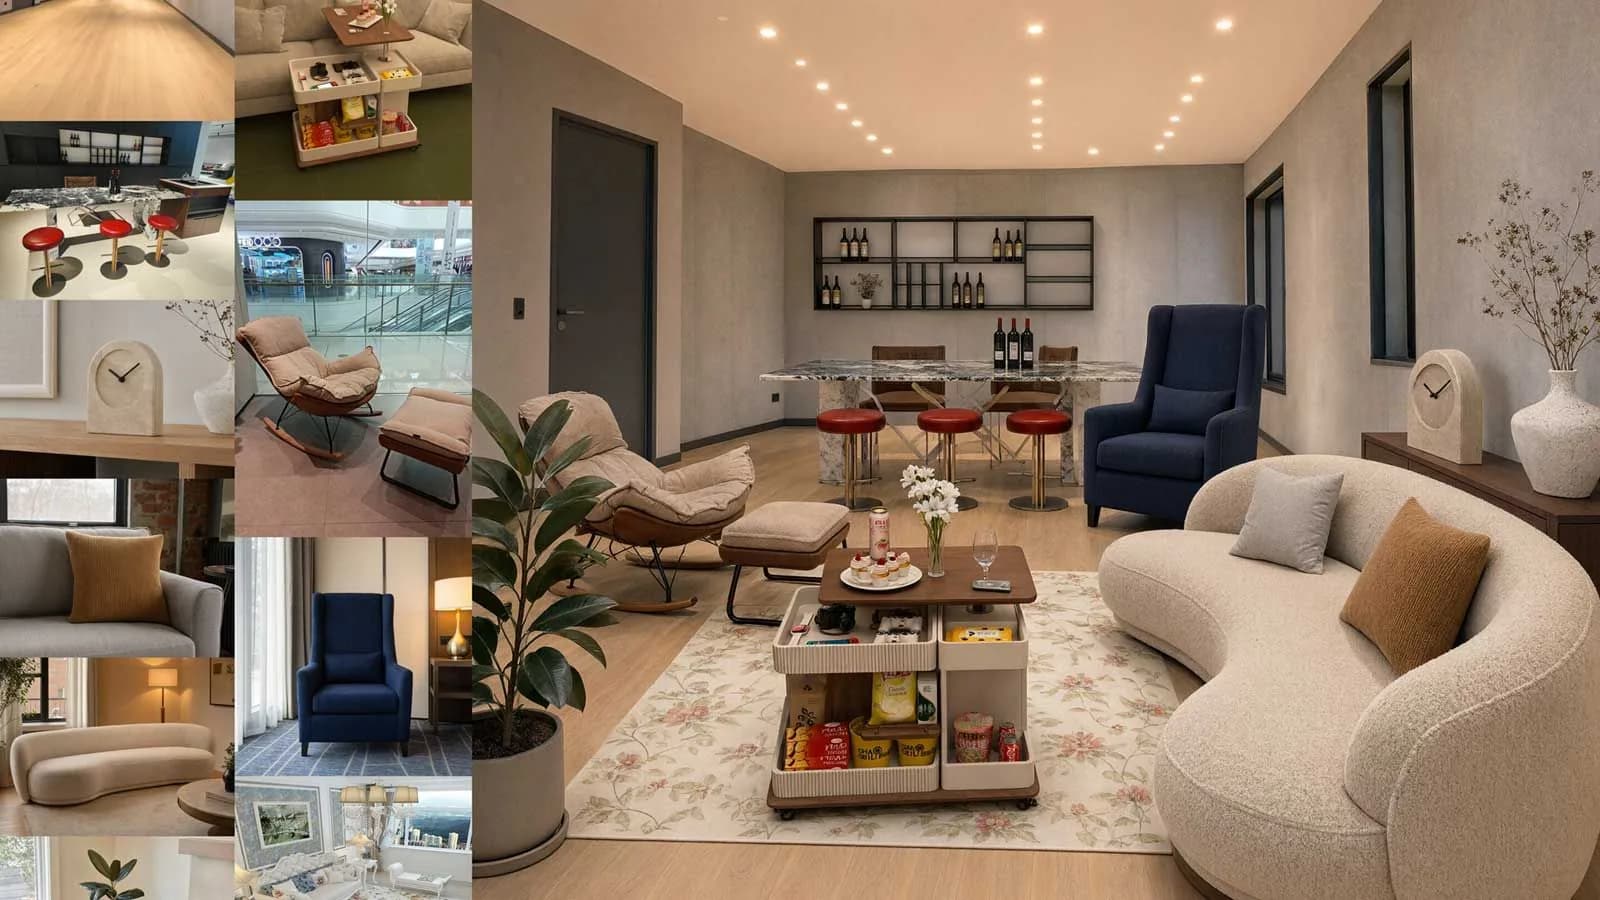
Alibaba asegura que su modelo abierto supera a Nano Banana 2.0 en su propio benchmark, pero la nueva licencia prohíbe revender el modelo sin permiso.
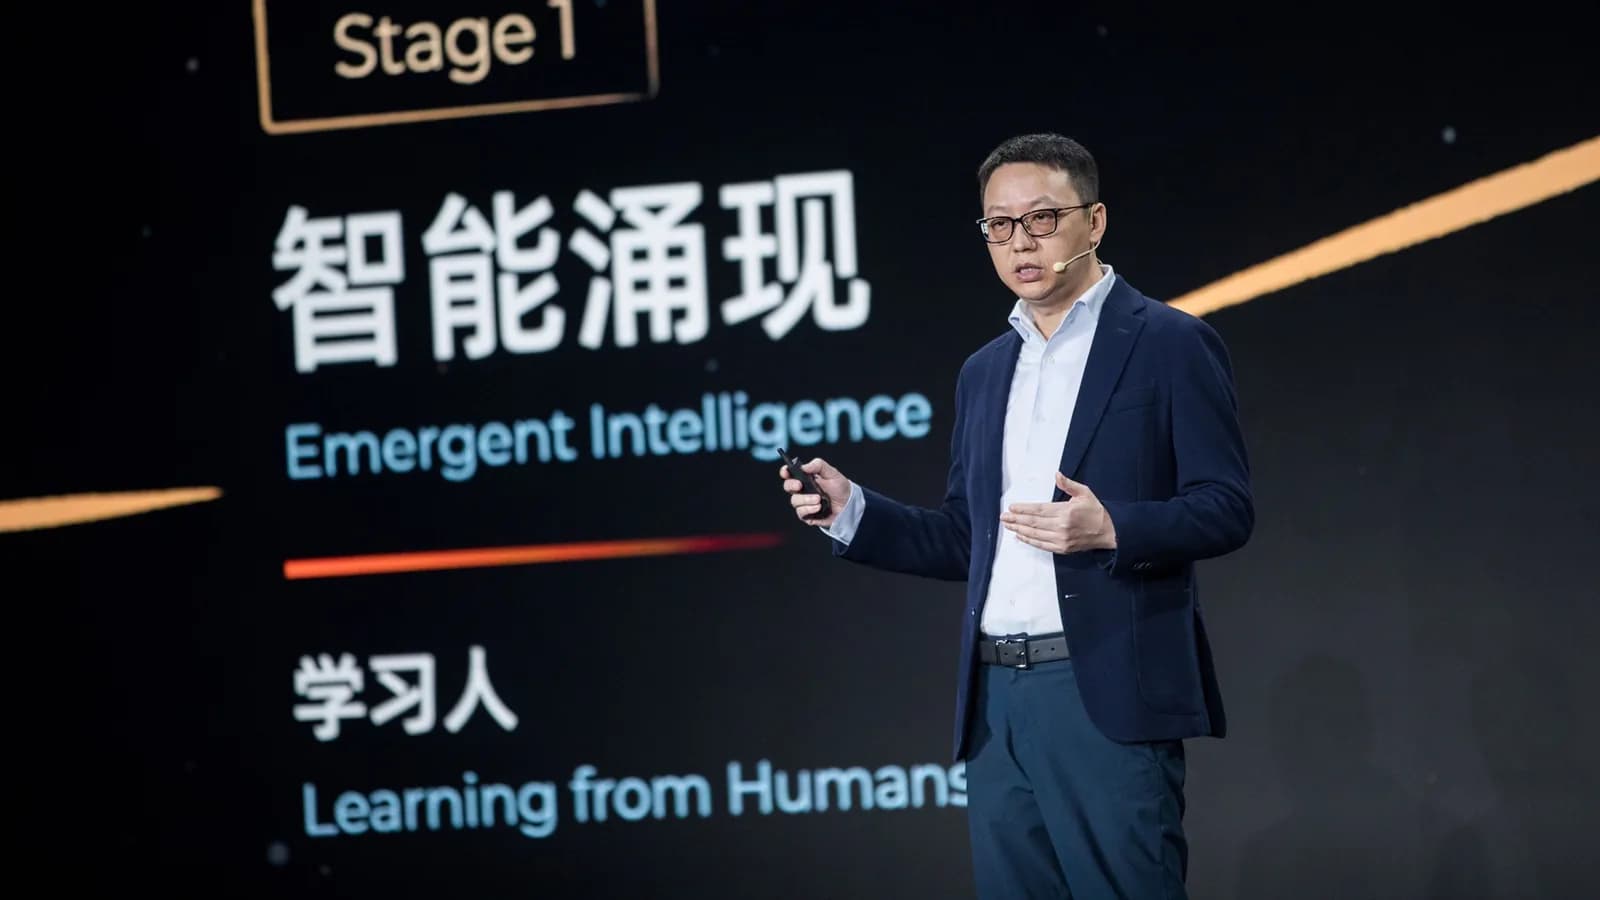
La compañía lo presentó en Hangzhou como el chip de IA más potente de China y anunció que Qwen 5 llegará con hasta 10 billones de parámetros.
El informe que Interconnects preparó para legisladores estadounidenses pone la ventaja china en 1.600 millones de descargas y en más del 80% del uso de OpenRouter.
Es el primer modelo multimodal de Qwen pensado para agentes, procesa audio y video juntos y trabaja con una ventana de un millón de tokens.
Alibaba lo dejó disponible por API con contexto de 1 millón de tokens y sin pesos abiertos, y liberó aparte los complementos Qwen-MM-Plugins bajo Apache-2.0.
El laboratorio chino AllSpark publicó los pesos de dos agentes construidos sobre modelos Qwen, con ventana de 256.000 tokens y la receta completa de entrenamiento.
Los 196.000 millones de parámetros N-gram del modelo se pueden mover a la RAM del sistema, y eso baja de 763 GB a 567 GB la memoria de GPU que pide para arrancar.
Un desarrollador dejó el plan de 20 dólares mensuales de Anthropic y movió su asistente de programación a un equipo de 16 GB, con resultados suficientes para su flujo de trabajo.
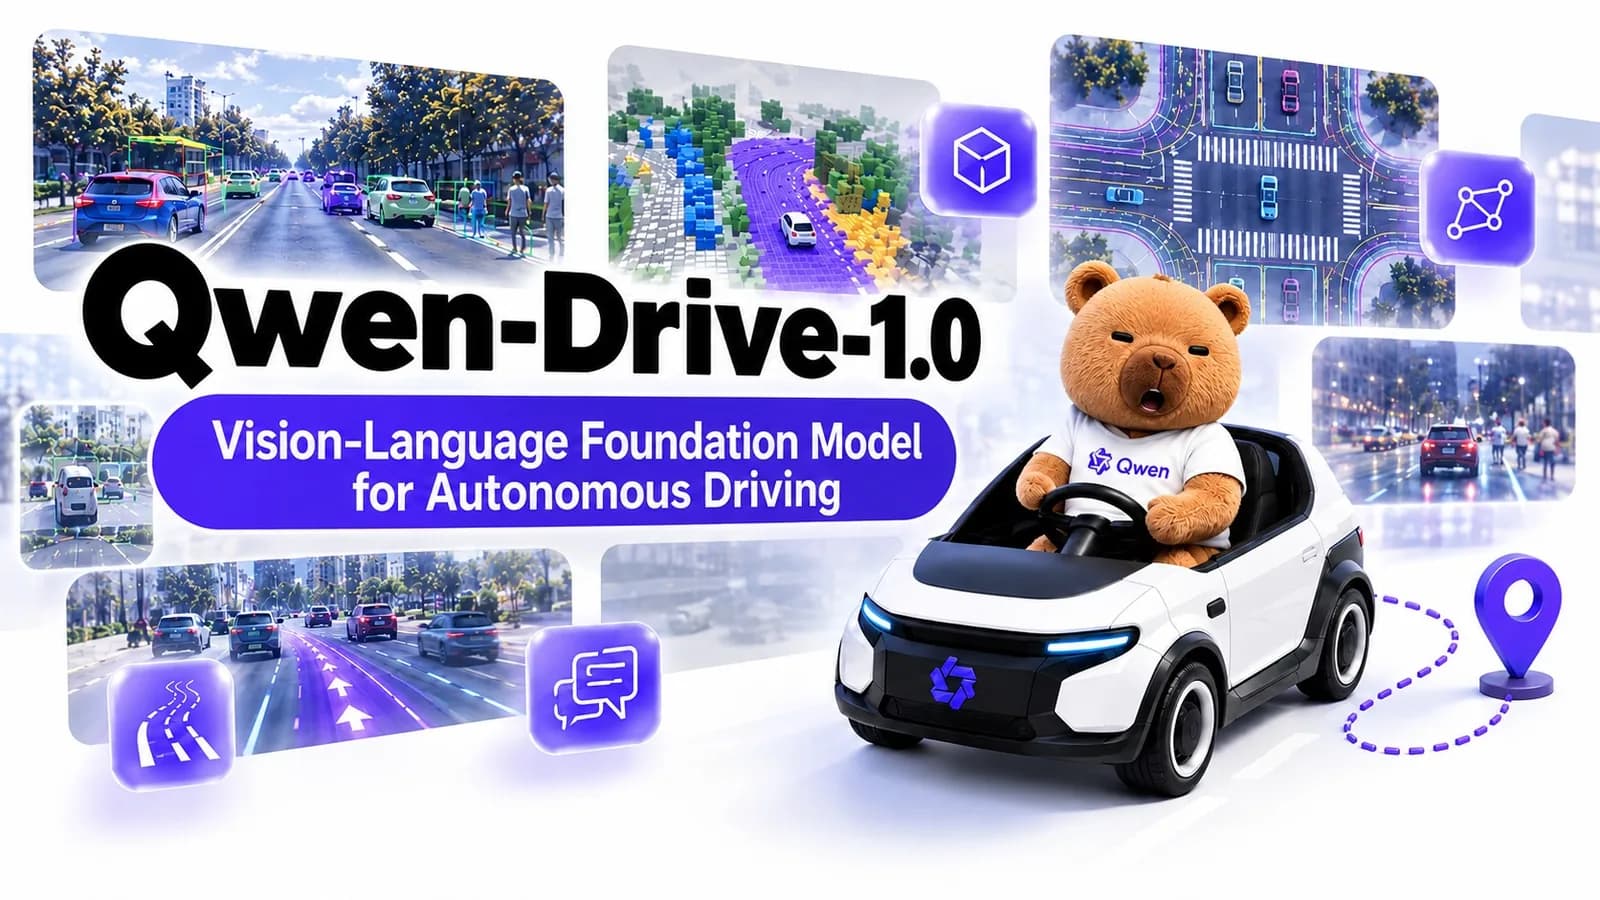
El modelo de Alibaba unifica percepción espacial, preguntas de tránsito y planificación de ruta, y bajó del 24% al 12% las salidas de calzada en simulación.
La cuantización NVFP4 combinada con decodificación especulativa multiplica por 6,28 el rendimiento frente a BF16, según las pruebas que NVIDIA publicó para sus placas AGX Thor y AGX Orin.
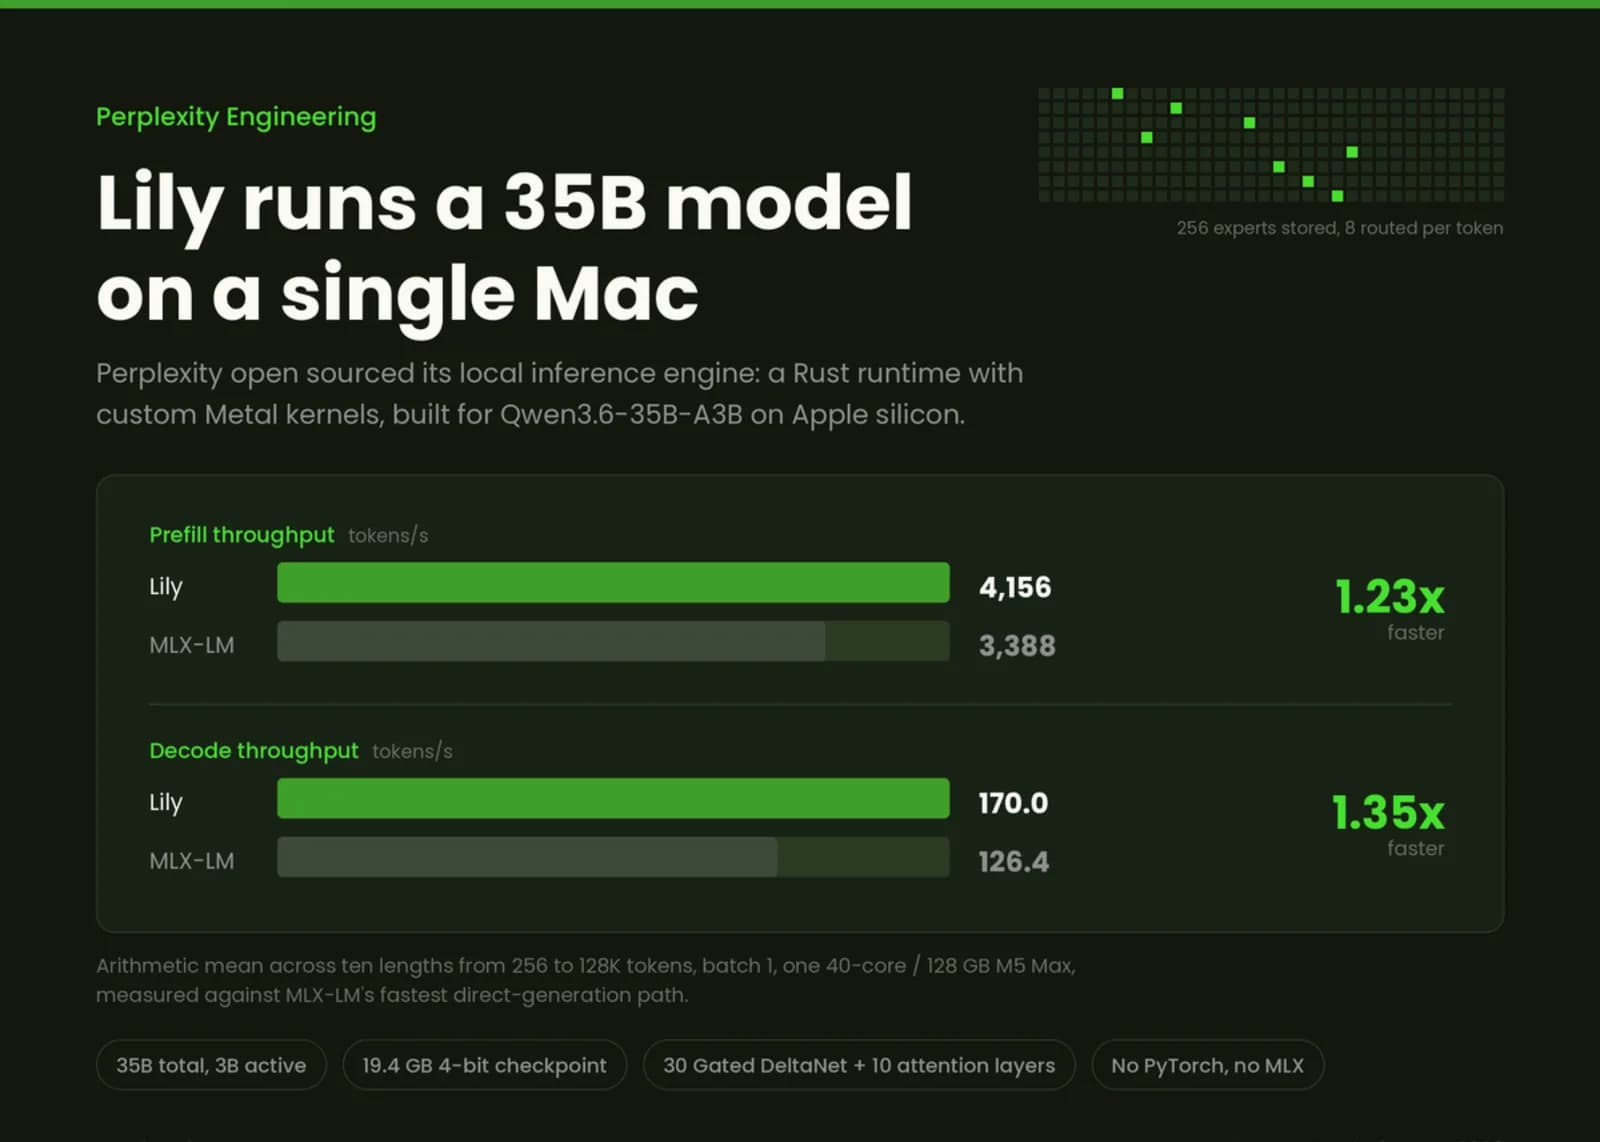
El motor detrás de Hybrid Compute corre Qwen3.6-35B-A3B sin PyTorch ni MLX en el camino de ejecución, con kernels Metal escritos a mano.
Las versiones cuantizadas del modelo abierto de 27.000 millones de parámetros funcionan en equipos de 32 GB de RAM, y hasta en uno de 16 GB con calidad degradada.
Alibaba liberó los pesos del modelo como anticipo de la arquitectura Qwen4, y NVIDIA publicó su validación sobre el rack GB300 NVL72 con soporte desde el día cero.
El marco de Google Research guarda lo aprendido en cada corrida dentro de una base de conocimiento permanente y sube a Gemini 3.5 Flash de 49,5% a 68,1% de promedio.
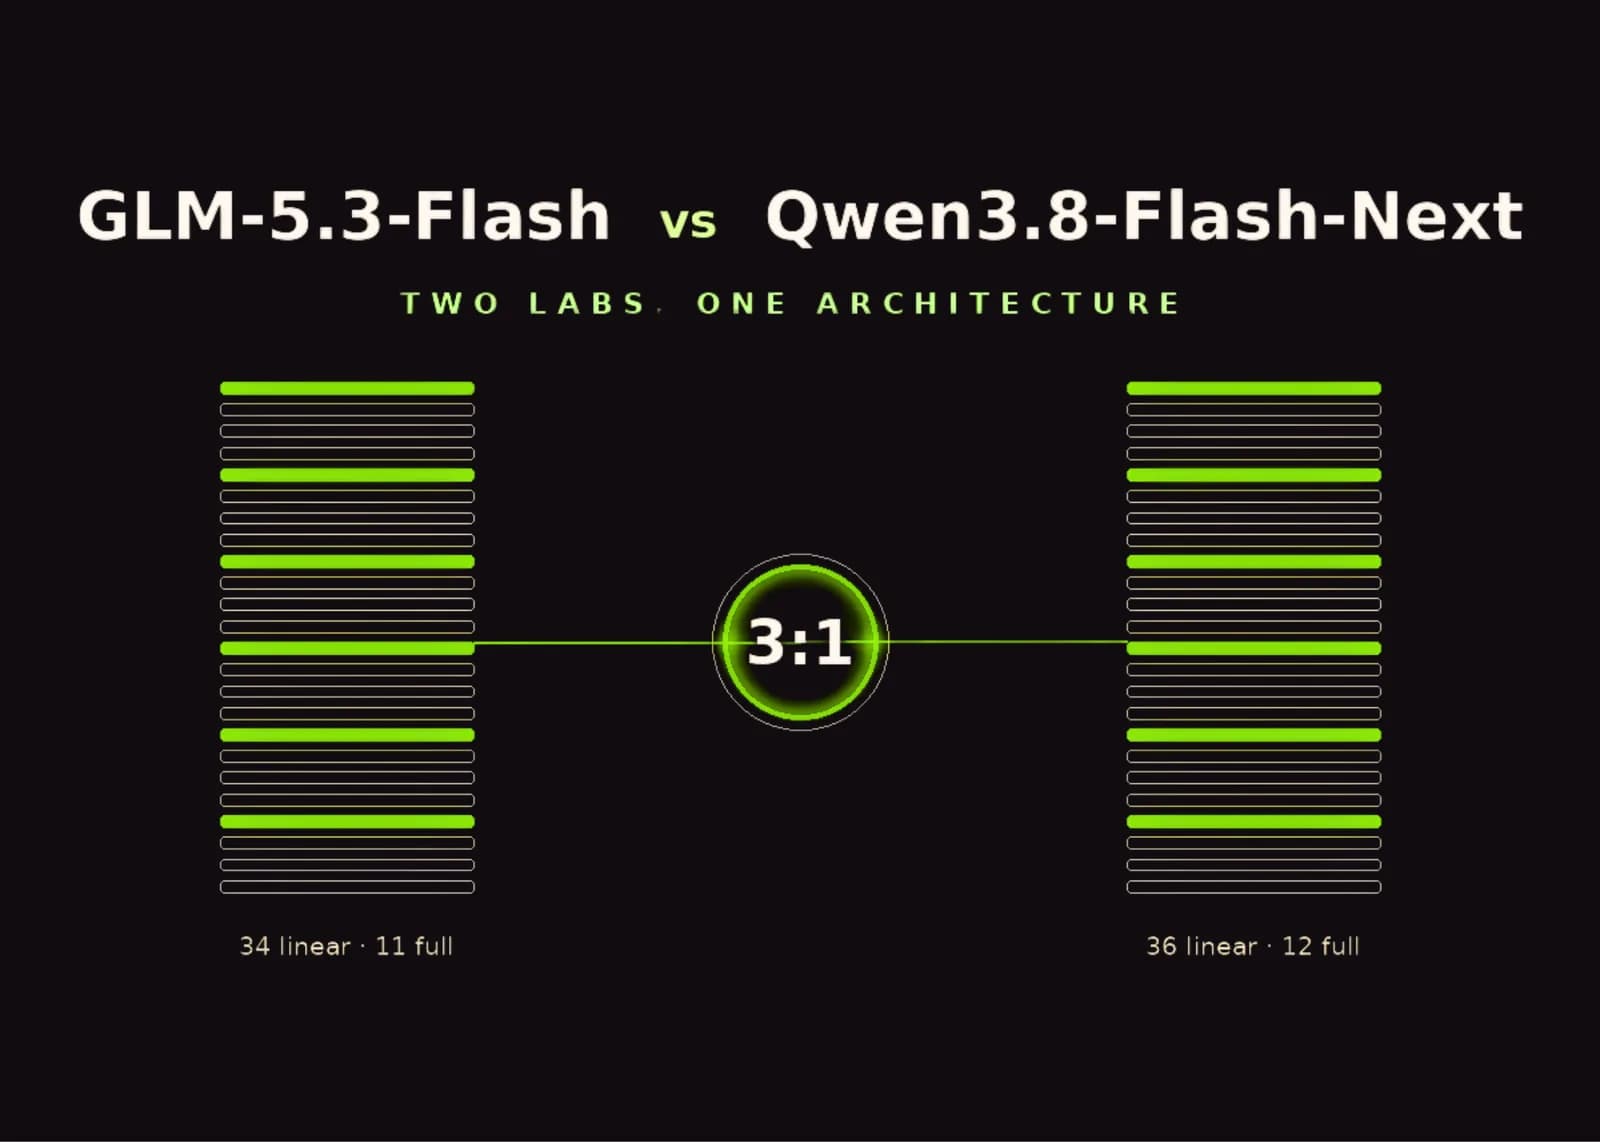
Z.ai y el equipo Qwen de Alibaba liberaron sus modelos sin coordinarse, pero las configuraciones son casi copias: mismo ratio de atención, mismo tope de 2.048 tokens y cuatro flujos residuales.
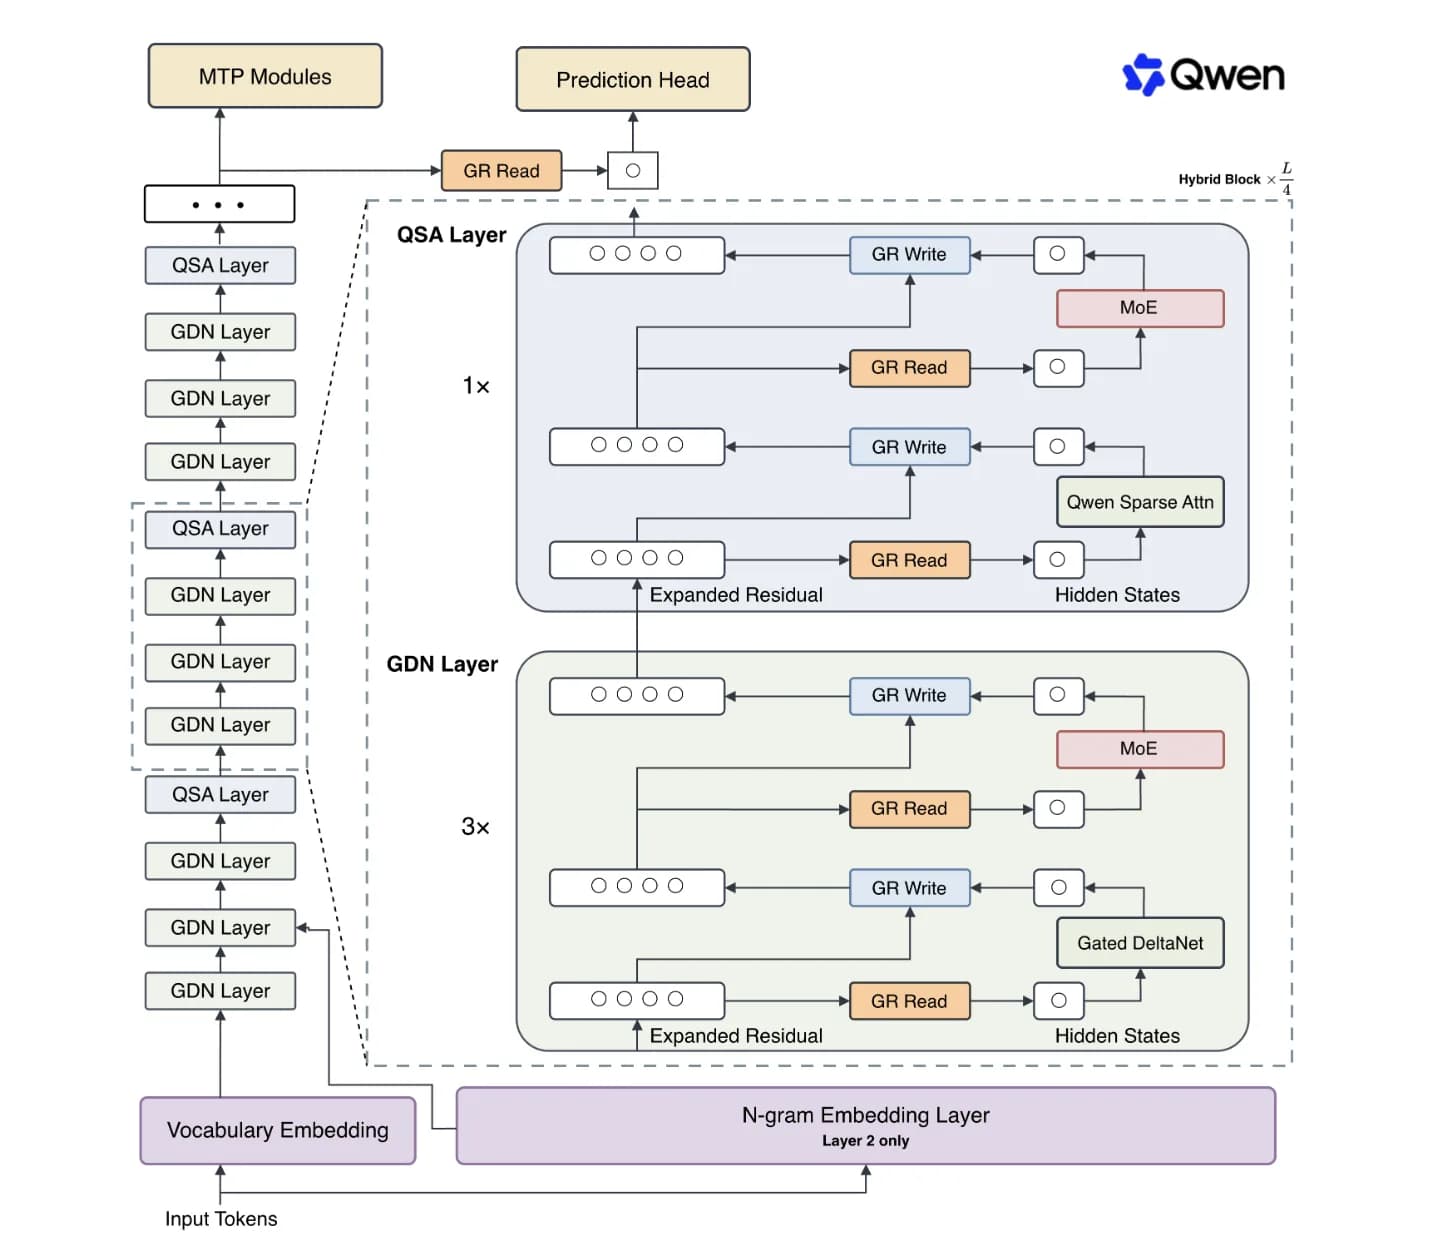
El nuevo modelo multimodal de peso abierto de Alibaba anticipa la arquitectura de Qwen4 y, según el equipo, se entrenó por cerca de un noveno de lo que costó Qwen3.7-Plus.
NVIDIA publicó la validación del modelo de Alibaba sobre el rack GB300 NVL72 y detalló la arquitectura híbrida que le permite sostener contextos de un millón de tokens sin inflar la caché KV.
El modelo de Alibaba adelanta la arquitectura de Qwen4 con una capa de n-gramas que vive en la RAM del sistema, y cuesta doce veces menos que el buque insignia de la casa.
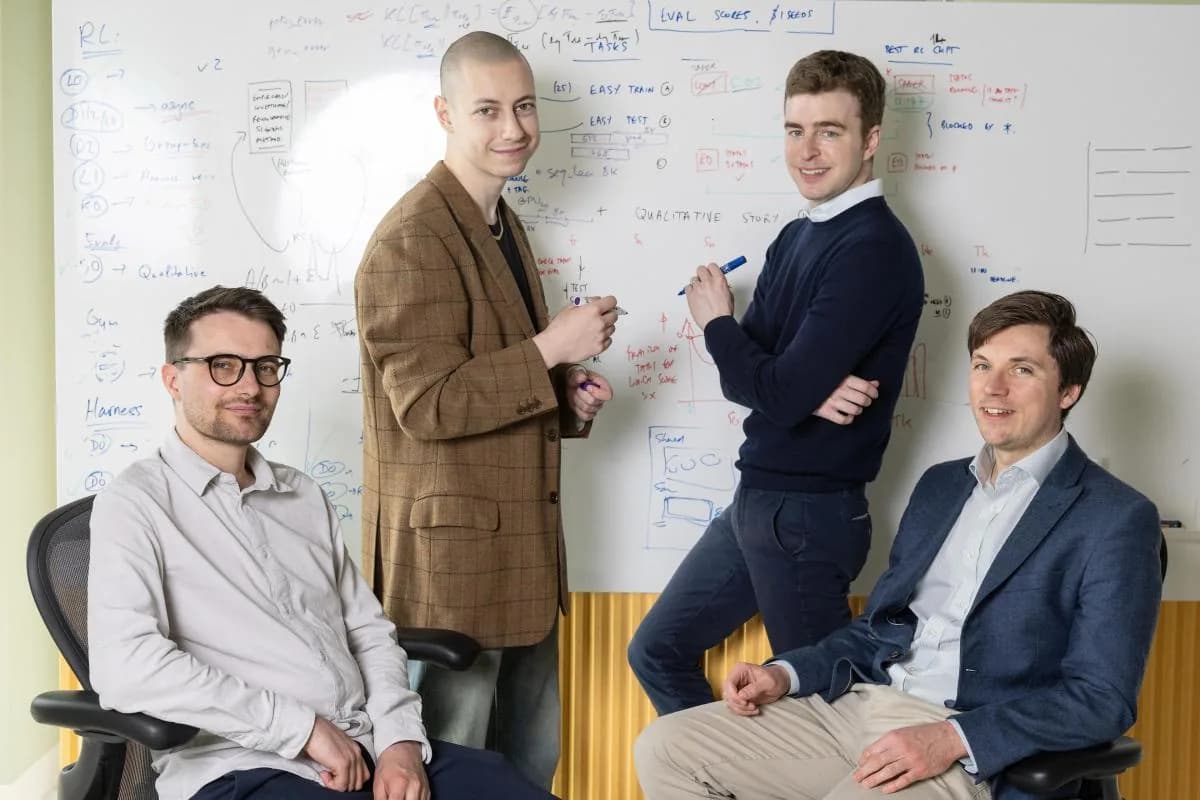
El laboratorio londinense Inherent, fundado por exintegrantes de Google DeepMind, dice que su agente superó a Claude Opus 4.8 y a GPT-5.5 replicando artículos científicos.
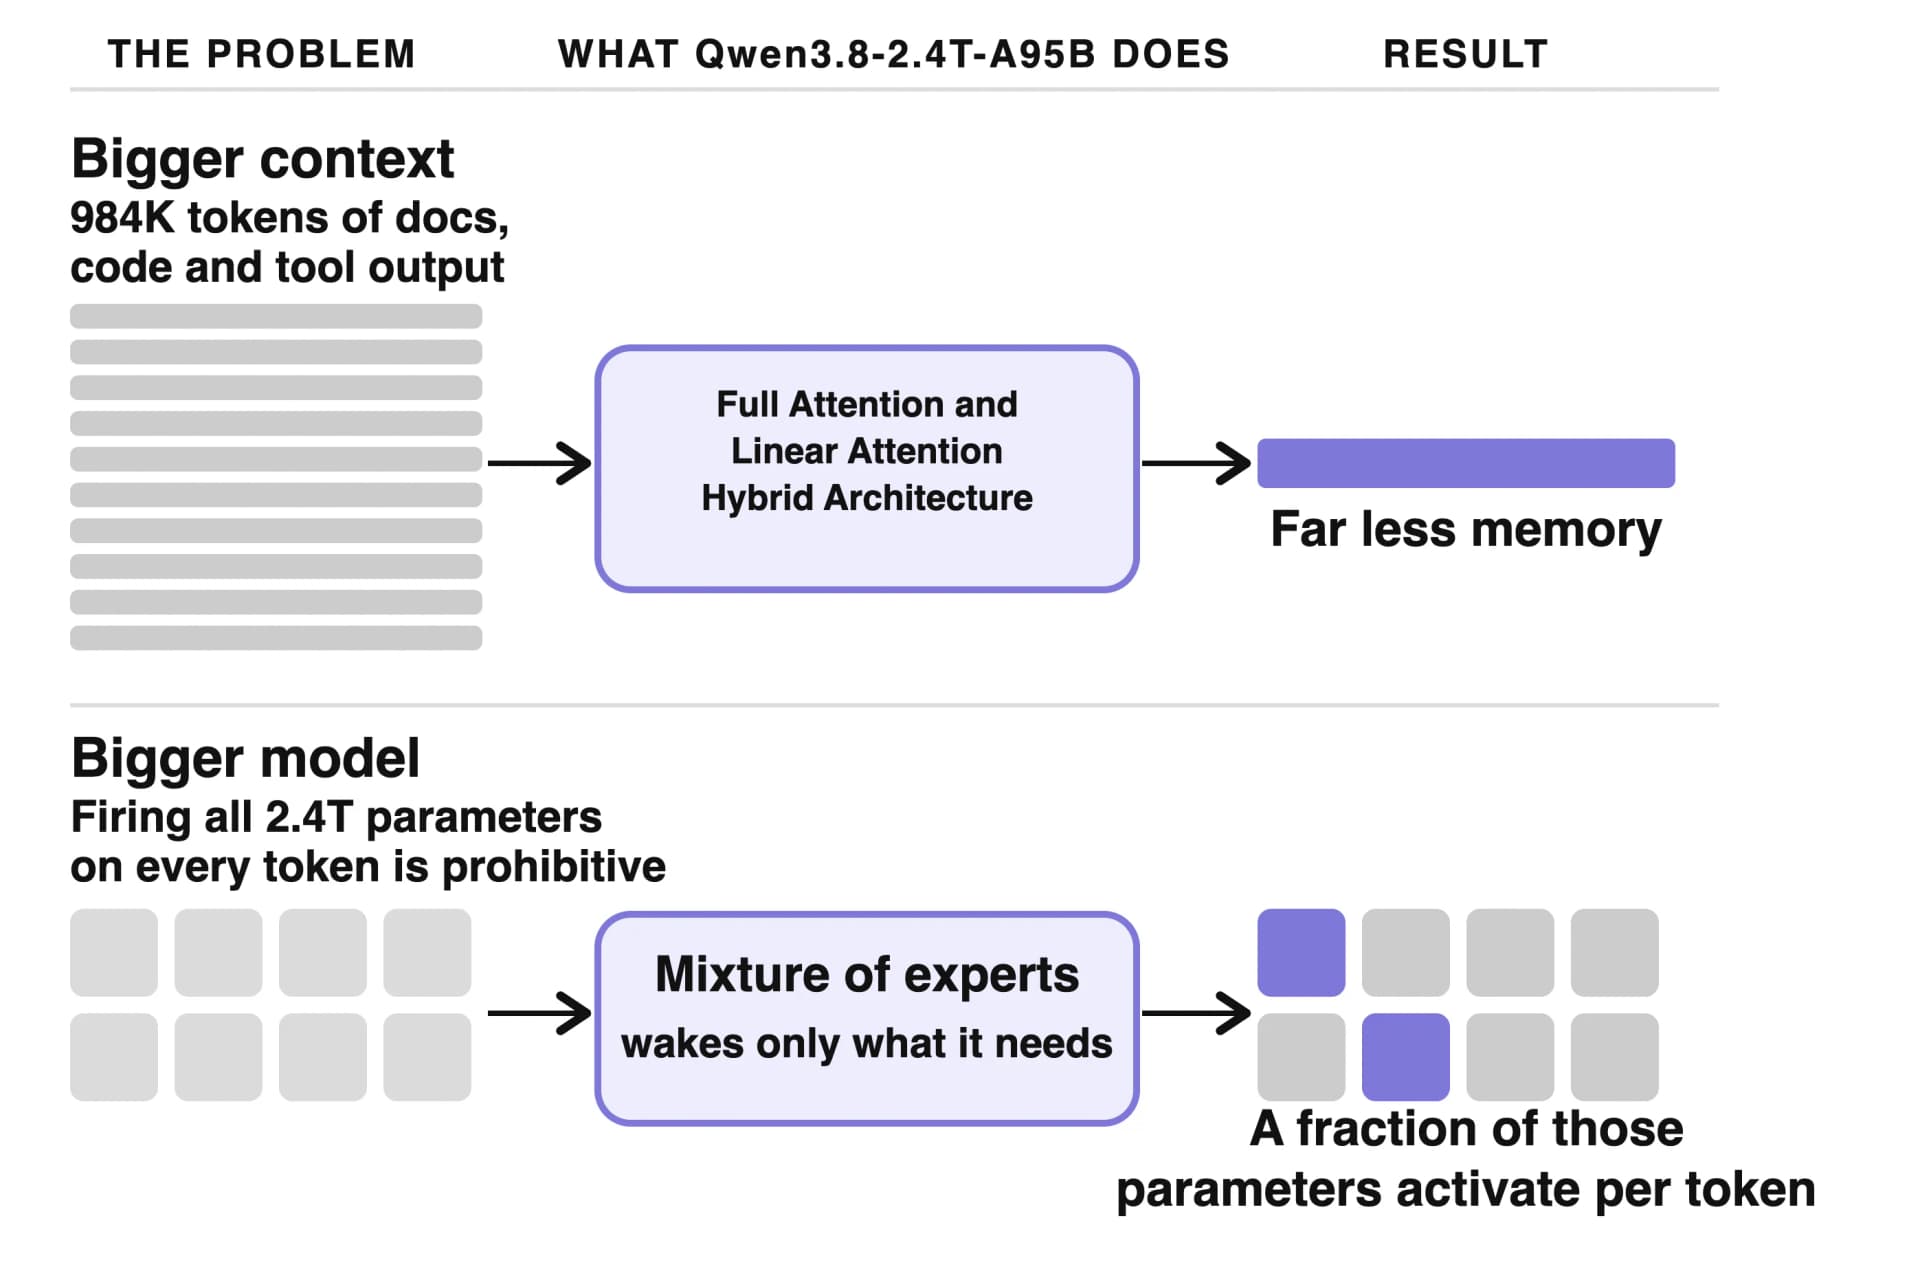
Alibaba libera su modelo de pesos abiertos más grande. Descubre cómo NVIDIA optimiza el despliegue de Qwen3.8-Max en arquitecturas de centros de datos de gran escala.
El gigante chino Alibaba comenzará a cobrar a grandes clientes corporativos por el uso comercial de su próximo modelo de IA, Qwen3.8-Max, marcando un giro radical en el ecosistema open source.
El modelo multimodal de 2,4 billones de parámetros llega en versión preview y busca frenar el impulso de Kimi K3 antes de que Moonshot AI salga a bolsa.
PrismML comprimió un modelo de 27.000 millones de parámetros a menos de 4 GB conservando cerca del 90% del rendimiento, y Apple ya estaría probando la tecnología para su IA en el dispositivo.
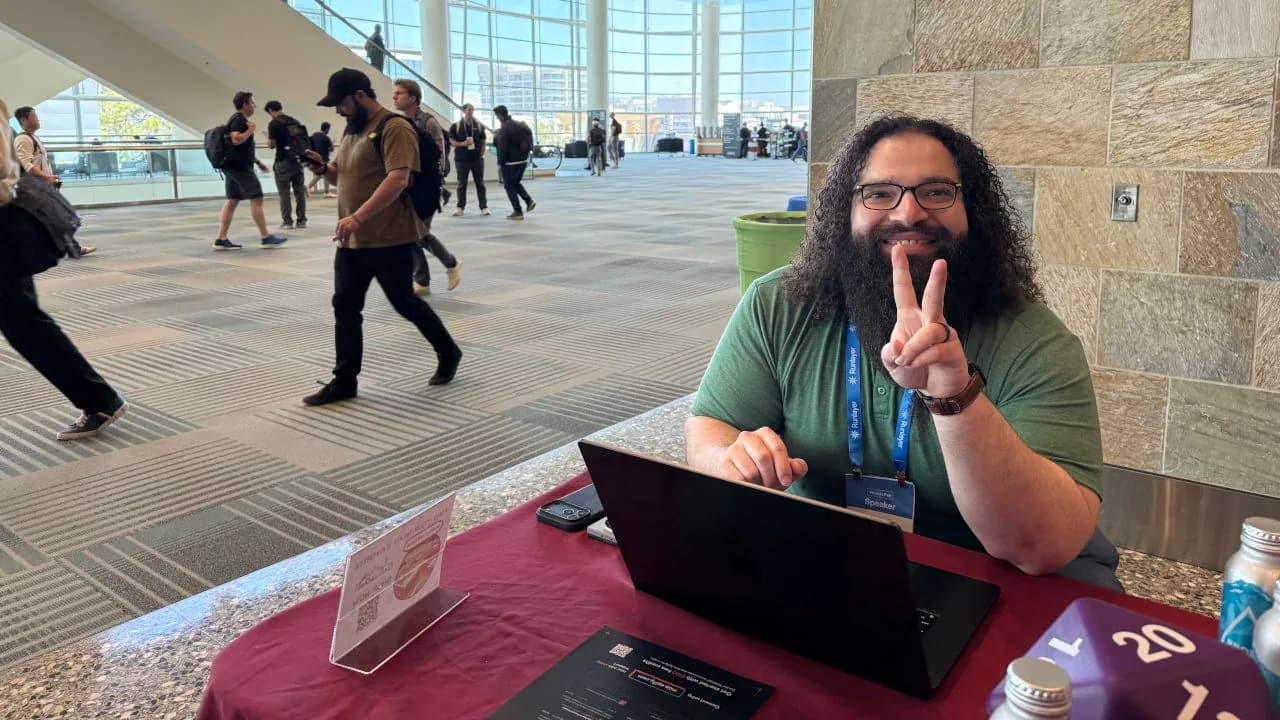
El fundador de Osmantic dio dos talleres en el AI Engineer World's Fair sobre cómo desplegar LLM open source en workstations propias, con público que fue de estudiantes a ejecutivos de Intel.
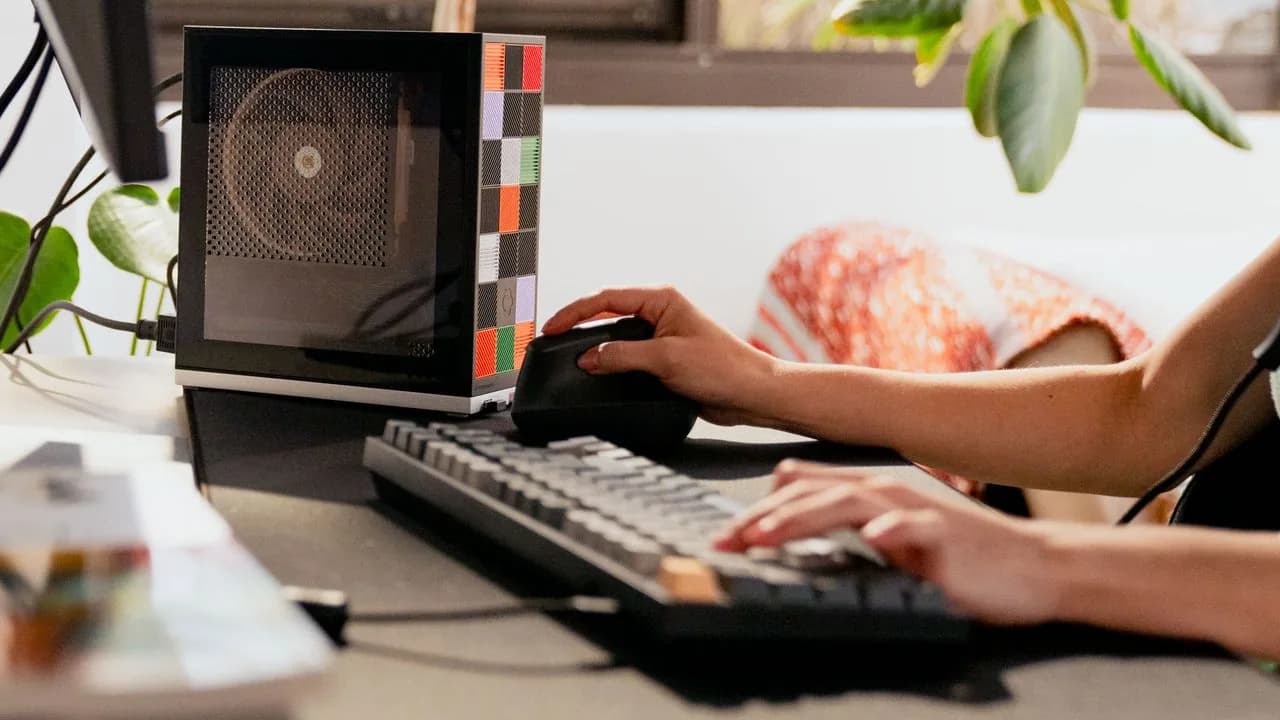
Un periodista de tecnología cuenta cómo armó un stack casero con un AMD Ryzen AI Max+ 395 de 96 GB para correr Qwen3.5 sin pagar APIs frontera.
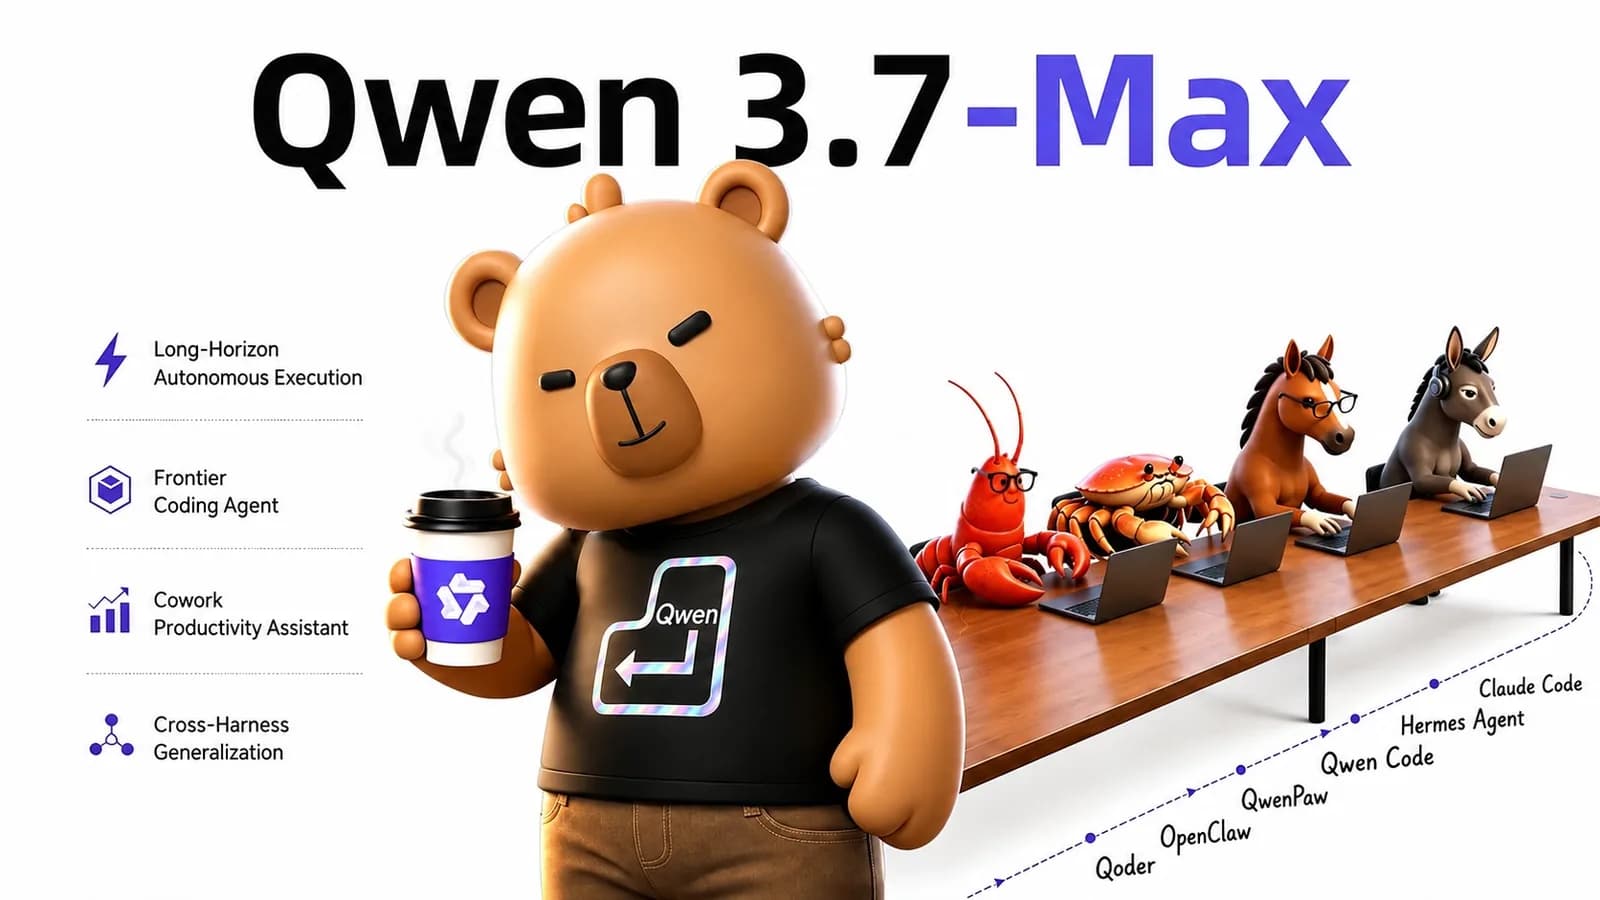
El nuevo modelo del equipo Qwen, exclusivo de la API de Alibaba Cloud, completó 432 tests de kernel y 1.158 tool calls sin intervención humana, logrando un speedup promedio de 10x.
El agente open source de Nous Research combina autoaprendizaje, sub-agentes aislados y soporte nativo para Qwen 3.6 corriendo en GPUs NVIDIA RTX y la estación DGX Spark.
Otros temas que aparecen junto a #qwen en nuestra cobertura editorial.