Cada generación de Intel Xeon o AMD Epyc trae decenas de modelos nuevos. Hay piezas con muchos núcleos afinadas para rendimiento total, otras de alta frecuencia optimizadas para latencia, chips de bajo consumo pensados para el borde y todo lo que cabe entre medio.
Ian Finder, que dirige el desarrollo de las CPU de centro de datos de Nvidia, cree que para la gran mayoría de los usos toda esa variedad sobra.
"Durante muchos años hubo una especie de sobredimensionamiento del lado de los otros fabricantes", le dijo a The Register al margen de Supercomputing 2026, esta semana.
Nvidia es relativamente nueva en las CPU de centro de datos. Su primera pieza, Grace, salió en 2023 y casi no se usó fuera de los nodos de cabecera de IA, las tarjetas de red de gama alta y unos pocos despliegues de CPU independientes en hiperescaladores como Meta.
Vera, un solo modelo para todos los equipos
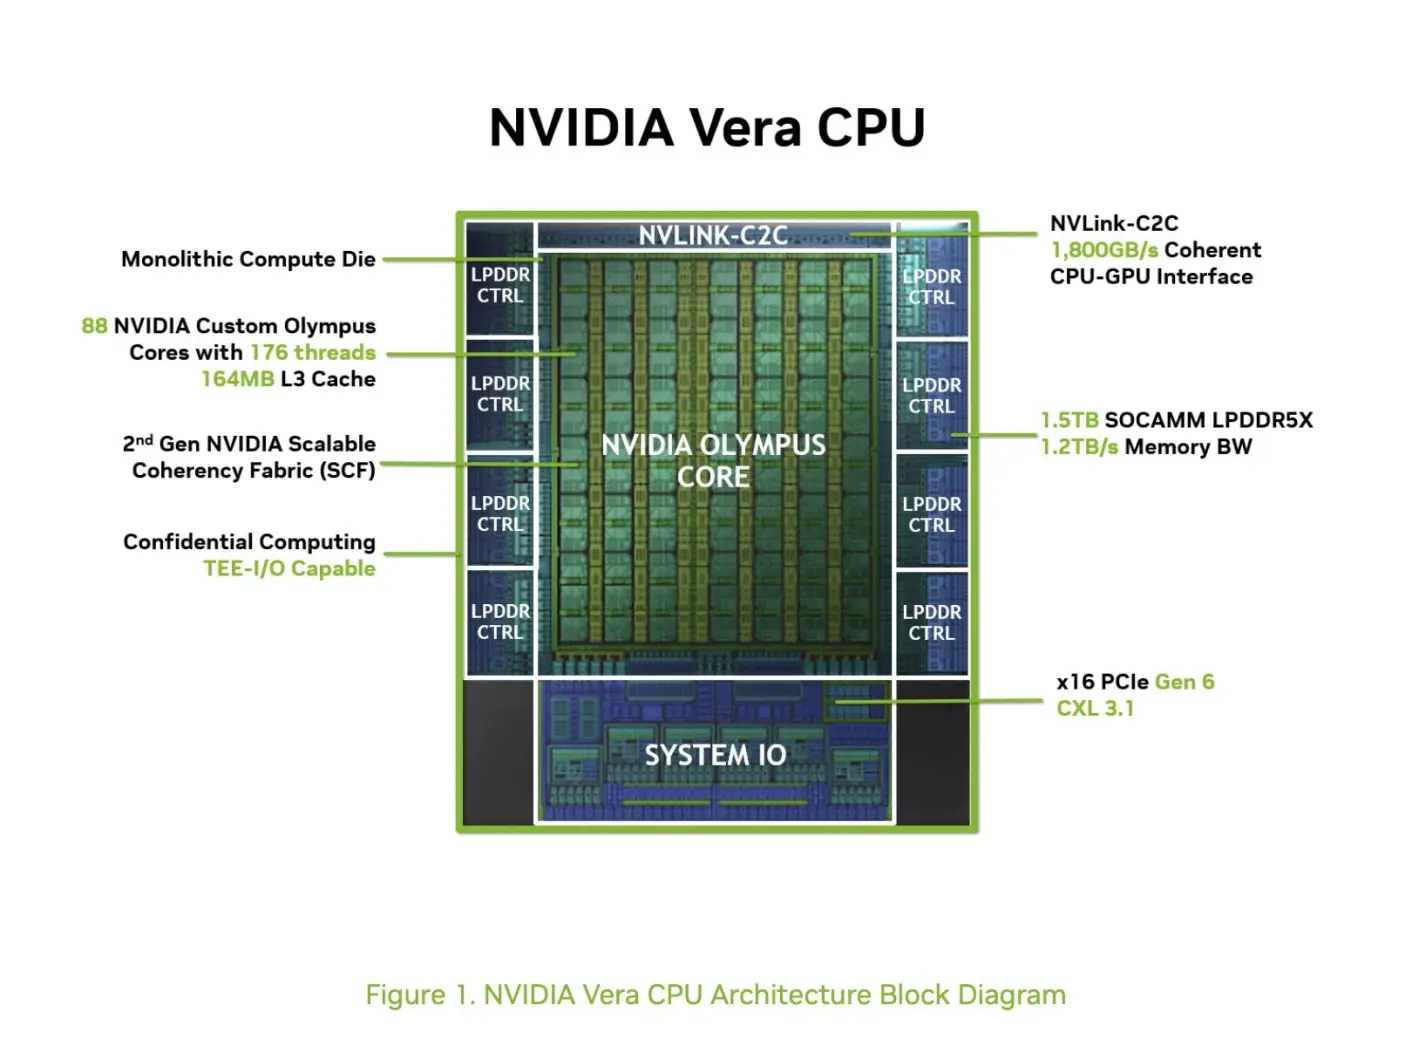
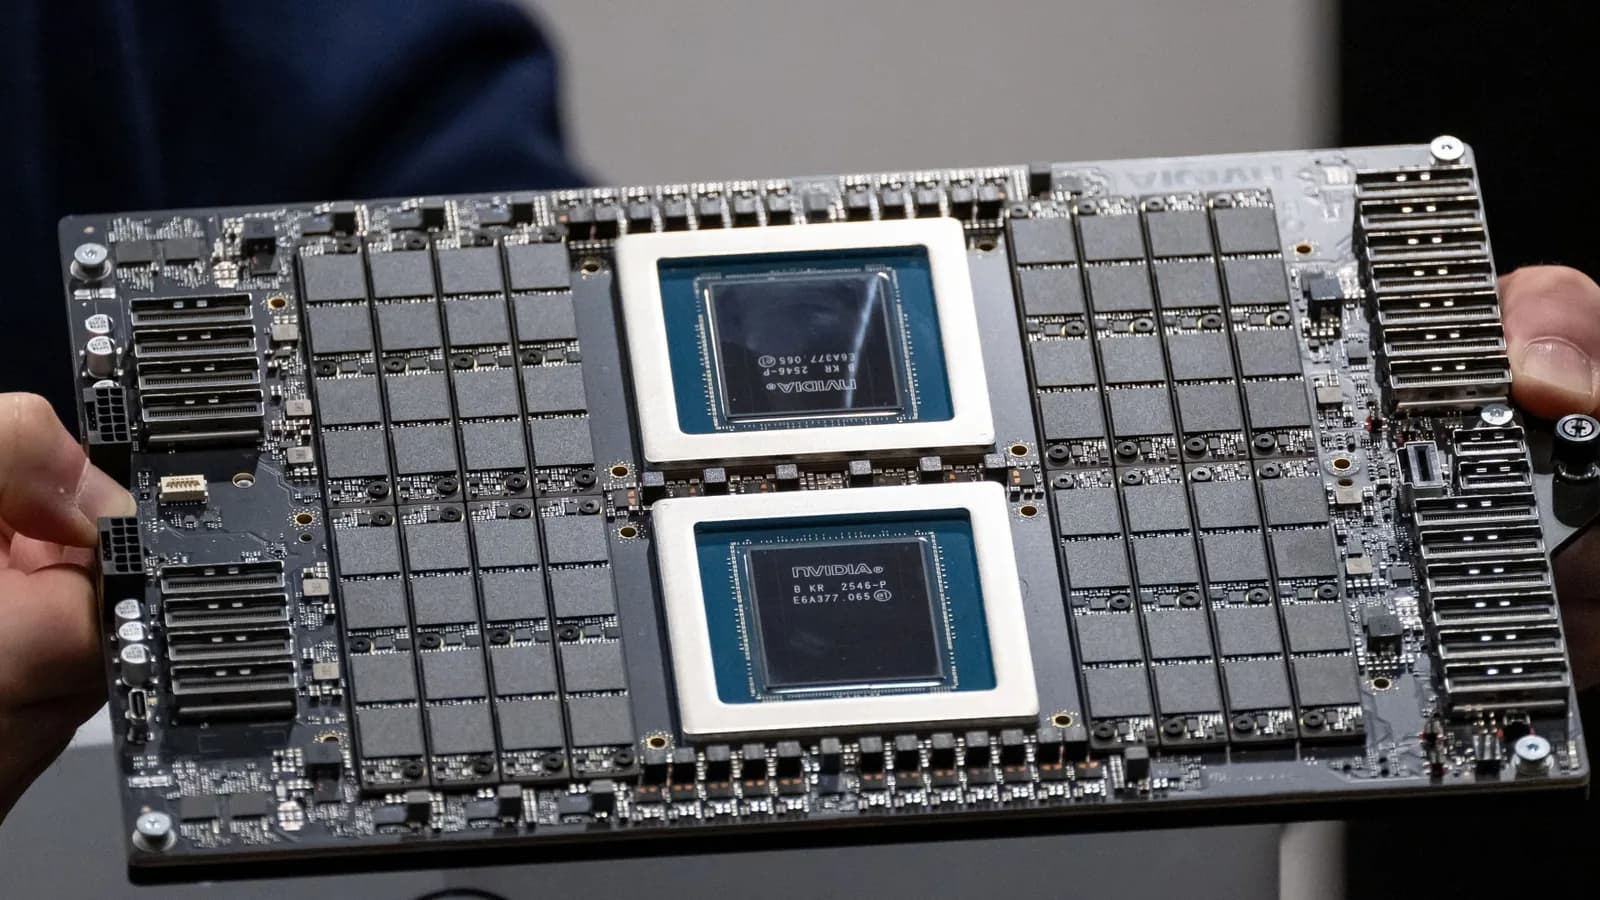
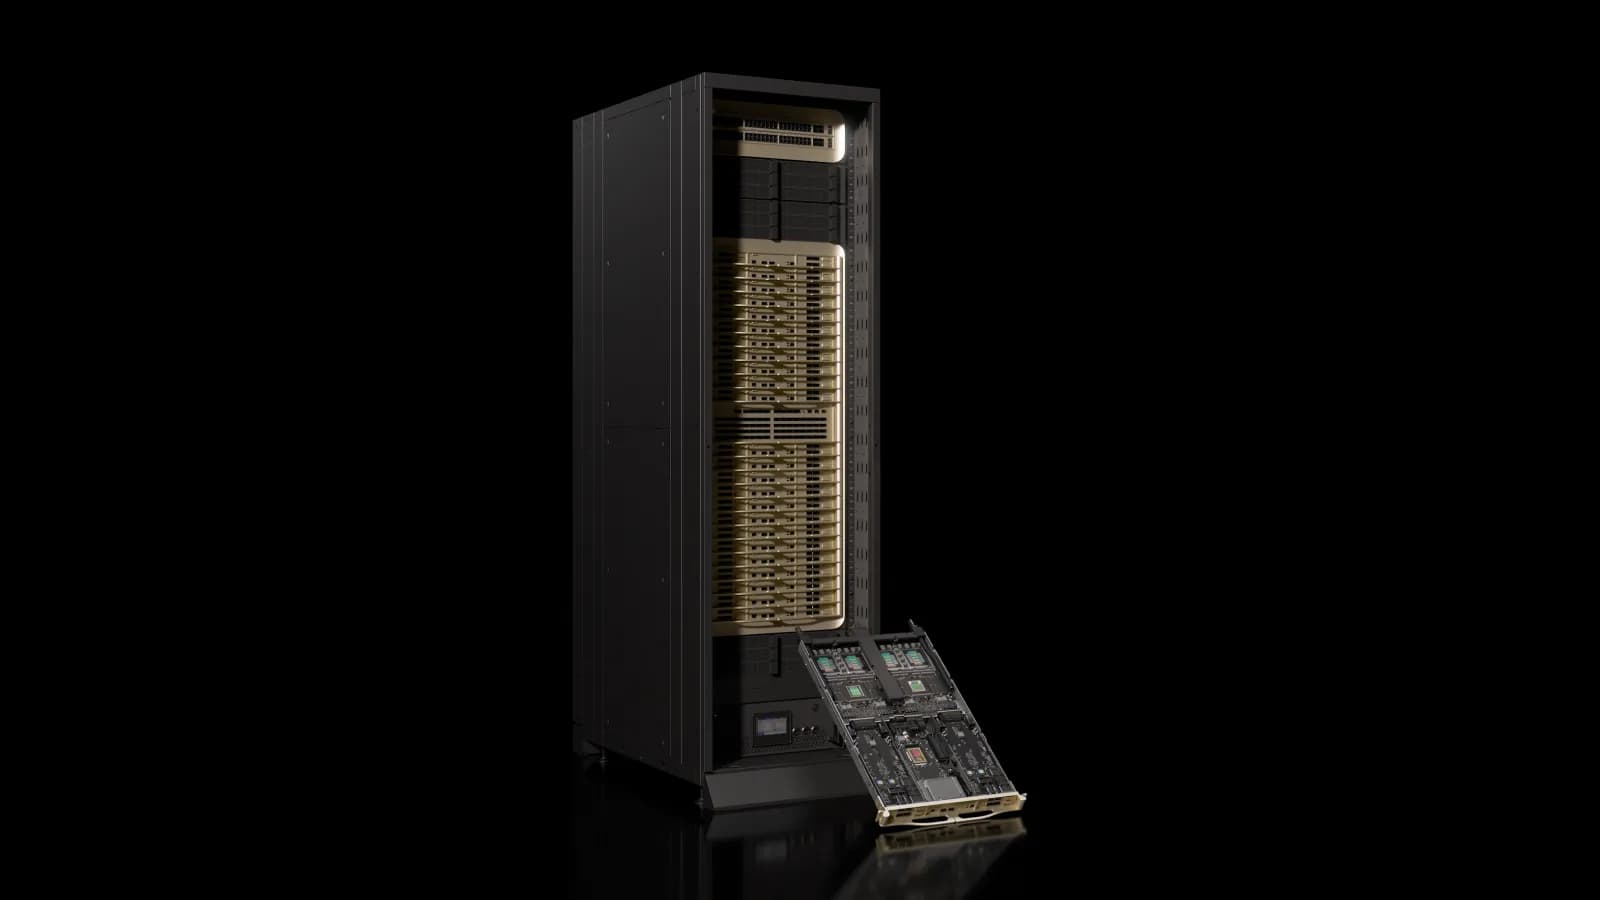
The Register ya revisó el chip en detalle a comienzos de año, pero la CPU más reciente de Nvidia, Vera, es otra cosa. Además de ir dentro de los superchips Vera-Rubin, se venderá en racks de CPU independientes, en sistemas de almacenamiento y en sistemas de memoria de contexto. Esta misma semana Nvidia anunció un rack nuevo con 192 CPU Vera para cargas de computación de alto rendimiento (HPC) que no se adaptan bien a las GPU. Y al menos en el papel, todos esos equipos usan el mismo modelo, con 88 núcleos a 3,3 GHz.
Históricamente, esos roles los cubrían CPU con distintas combinaciones de núcleos, frecuencias, entrada y salida y consumo.
Según Finder, la mayoría de las CPU de centro de datos nunca trabajó muy cargada, así que el punto de optimización fue la latencia sin carga. La consecuencia es que las CPU que suben su rendimiento total a punta de muchos núcleos suelen tener latencias altas cuando están cargadas.
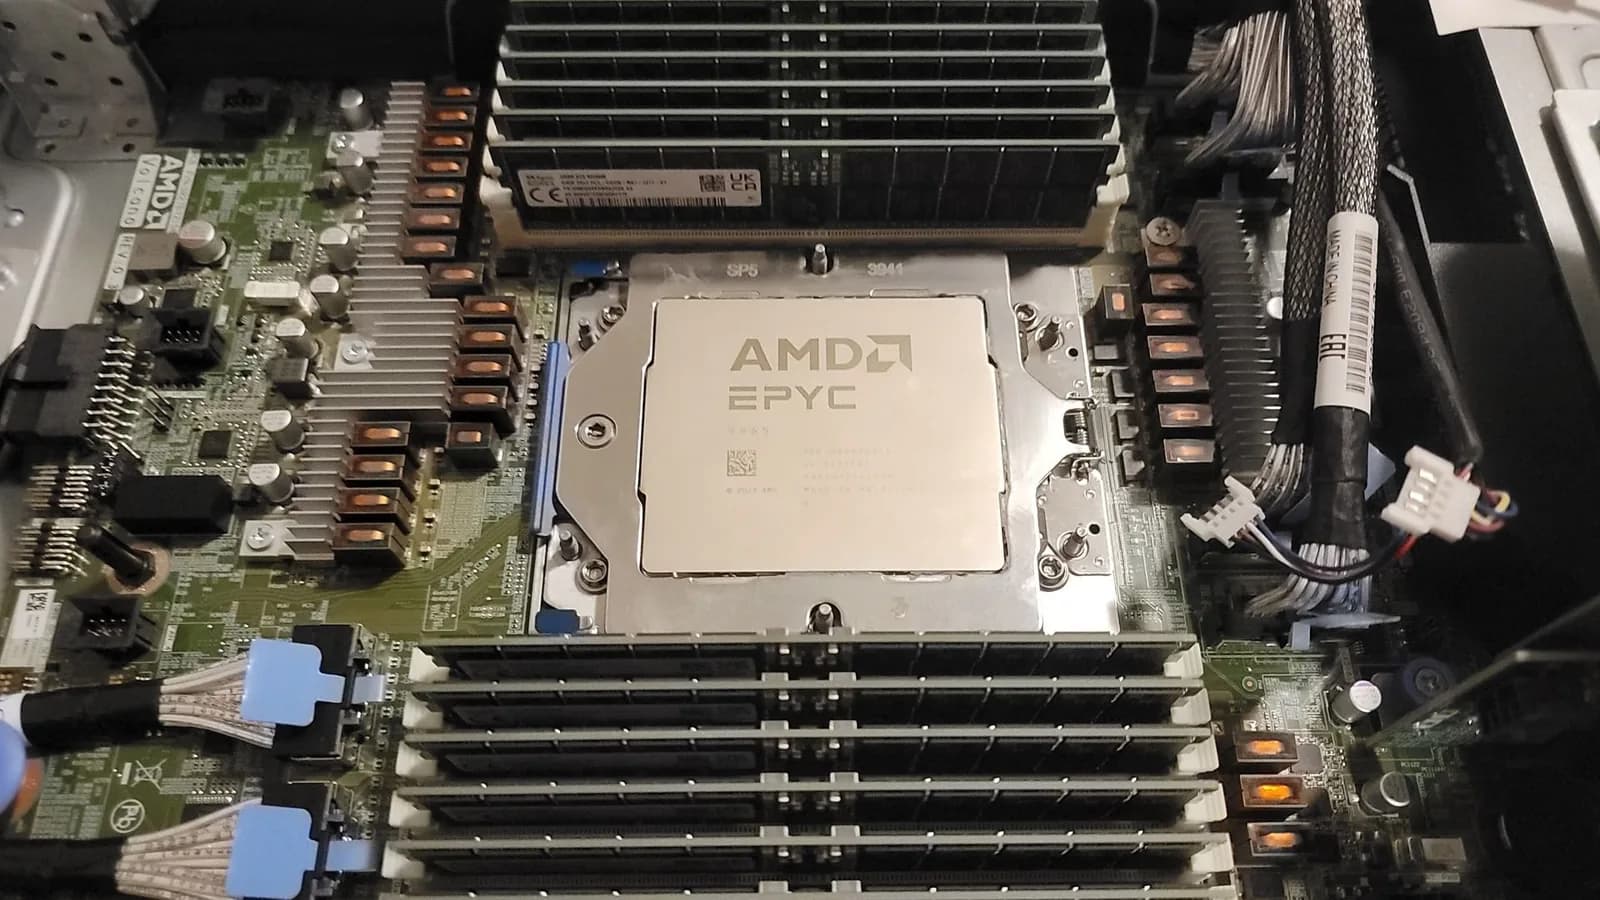
Los fabricantes también pueden optimizar para la latencia bajo carga, pero normalmente lo pagan en rendimiento total. Se ve claro en las últimas generaciones de Epyc de AMD, que diseñó núcleos Zen-C compactos para priorizar el rendimiento total y versiones más grandes, optimizadas para frecuencia, para priorizar la latencia.
"A medida que se encienden más núcleos, la latencia hacia la memoria sube, porque hay que lidiar con la congestión en los buses de interconexión", explicó a The Register el analista Ian Cutress, de More than Moore. "Lo que dice Nvidia es correcto. A veces hay que elegir entre cantidad de núcleos y latencia por núcleo."
¿Cómo equilibra Vera latencia y rendimiento?
Con Vera, Nvidia buscó una arquitectura equilibrada que mantenga latencias bajas y rendimiento alto incluso con los 88 núcleos cargados. Eso obliga a ceder en algunas cosas, en particular en la unidad vectorial de la CPU, que no es la más grande. Si se tienen GPU capaces de correr código vectorizado, la concesión tiene más sentido, y quien compra Vera casi seguro las tiene.
"Si haces algunas cosas así, puedes lograr una pieza que, para las cargas que le importan a la gente (agentes de conocimiento para CI/CD, para ingeniería de software, o bases de datos y analítica), te dé el mismo rendimiento por núcleo que las piezas x86 optimizadas para frecuencia, con el mismo rendimiento por watt que las piezas optimizadas para densidad", argumentó Finder.
Nvidia no es la única que piensa así. Los proveedores de nube llevan tiempo saltándose los modelos con más núcleos de Intel o AMD, y prefieren los que les dan la mezcla que buscan de rendimiento total, latencia, ancho de banda de memoria y capacidad.
En parte es porque un proveedor de nube no sabe qué van a hacer sus clientes con esos núcleos, y le conviene ofrecer algo parejo antes que la pieza de frecuencia más alta o de latencia más baja. La misma lógica funciona bastante bien para las sandboxes de agentes.
"Nvidia confía en que entiende el mercado lo suficiente como para que un solo chip cubra la mayoría de los casos", dijo Cutress. "Se podría argumentar que Nvidia simplemente quiere quedarse con ese mercado de volumen."
¿Para qué sirve tener varios modelos?
Hay razones de sobra para tener varios modelos o líneas de producto. Durante buena parte de su último ciclo de lanzamientos, AMD ha argumentado que sus chips son mejores CPU para agentes porque un agente reúne muchas cargas distintas. Algunas ganan con más núcleos y otras con más frecuencia, y el catálogo más variado de AMD deja elegir.
En ese punto Vera tiene una carta guardada, una doble personalidad. Es uno de los pocos chips Arm que soportan multihilo simultáneo (SMT), y lo implementa de una forma muy distinta a lo que Intel llama Hyperthreading.
Con SMT activado, cada núcleo Olympus de Vera se divide en dos. Los 88 núcleos pasan a funcionar más bien como 176 núcleos más angostos. Si hace falta más rendimiento total del que dan 88 núcleos, o si la carga no saca provecho de un núcleo más ancho, Vera ofrece esa flexibilidad.
Un catálogo amplio también ayuda con el binning. La fabricación de chips no es perfecta y siempre aparecen núcleos defectuosos. El binning permite vender esos chips con descuento.
Cutress sospecha que Nvidia probablemente hace eso con sus clientes, solo que no lo anuncia como modelos distintos, a la manera de Intel y AMD en las últimas décadas.
Un hiperescalador, por ejemplo, podría aceptar feliz una variante de Vera con 72 núcleos que suba un poco más de frecuencia o entregue más ancho de banda de memoria por núcleo con el mismo consumo. Por ahora, el catálogo oficial tiene un solo modelo.