
Electrónica
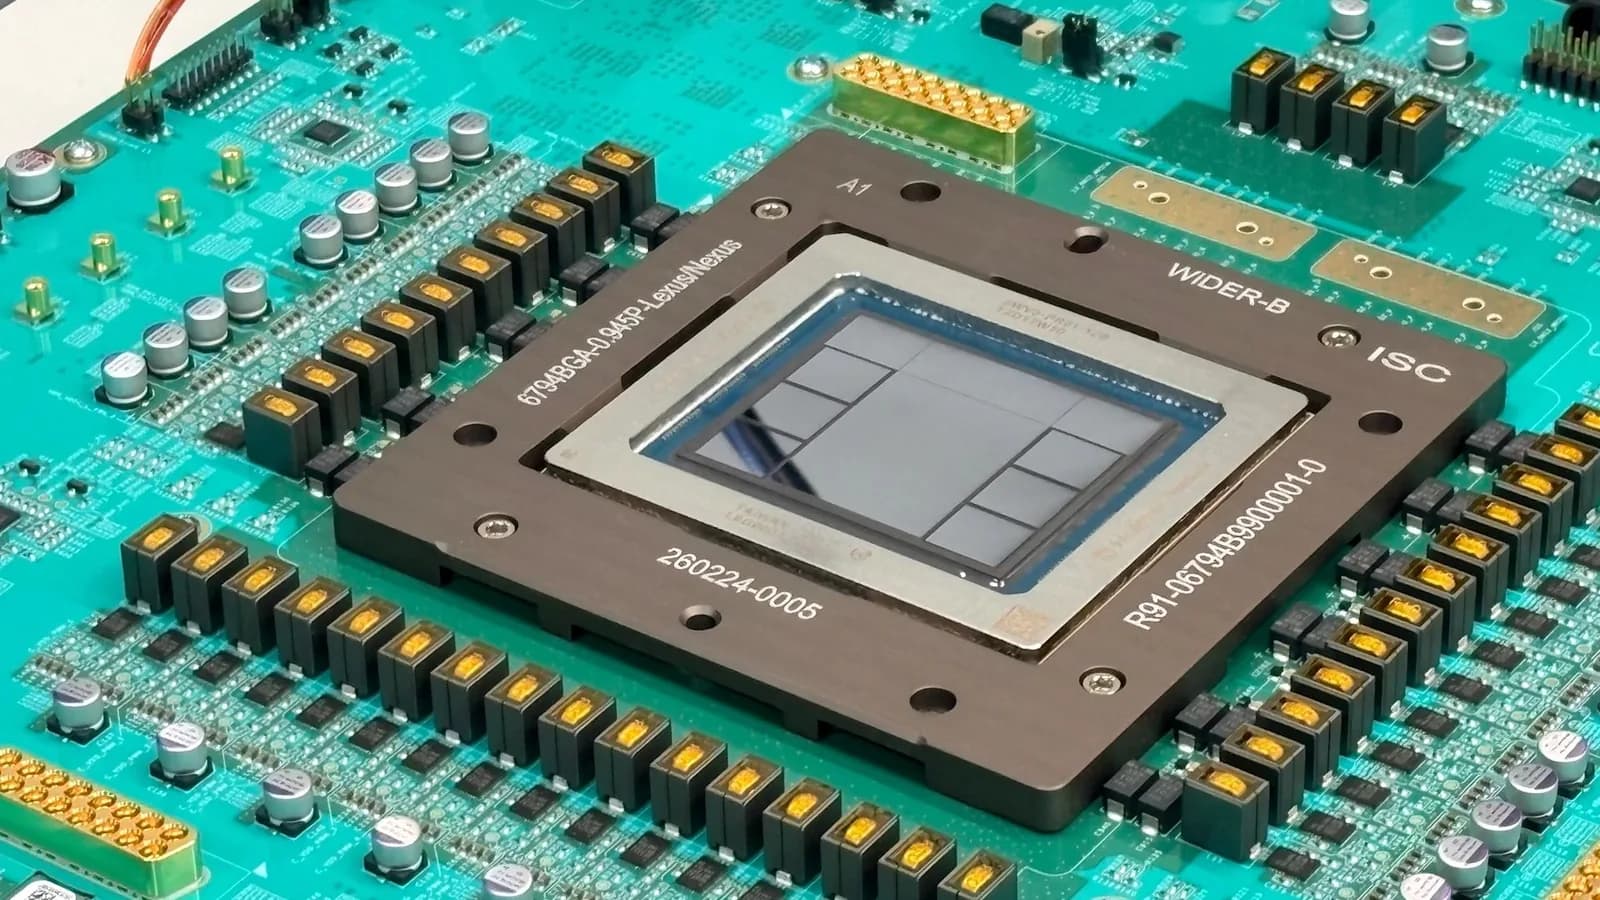
AMD Verano es la CPU que alimentará sus GPU contra Vera Rubin
El nuevo Epyc usa memoria LPDDR5X soldada en BGA y enlaces xGMI de 112 Gbps por carril, cerca del nivel de PCIe 7.0.
The Register
60 notas publicadas
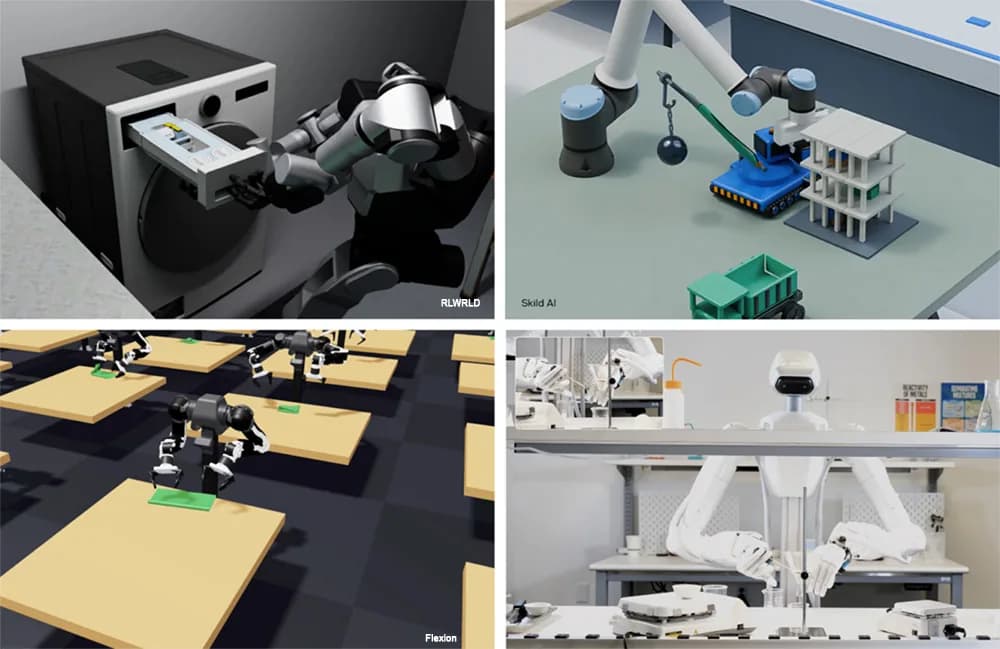
El modelo de acción del mundo resolvió 40 de 50 tareas sin demostraciones, y el nuevo Isaac Lab entrena hasta 2,5 veces más rápido con el motor Newton.
La robótica agéntica, presentada en la Conference on Robot Learning 2026, cambia las demostraciones humanas por código legible que escriben y prueban agentes de IA.
Ricursive Intelligence entrenó su modelo denso de 65.000 millones de parámetros con 12 billones de tokens y afirma haber gastado 32 millones de dólares.
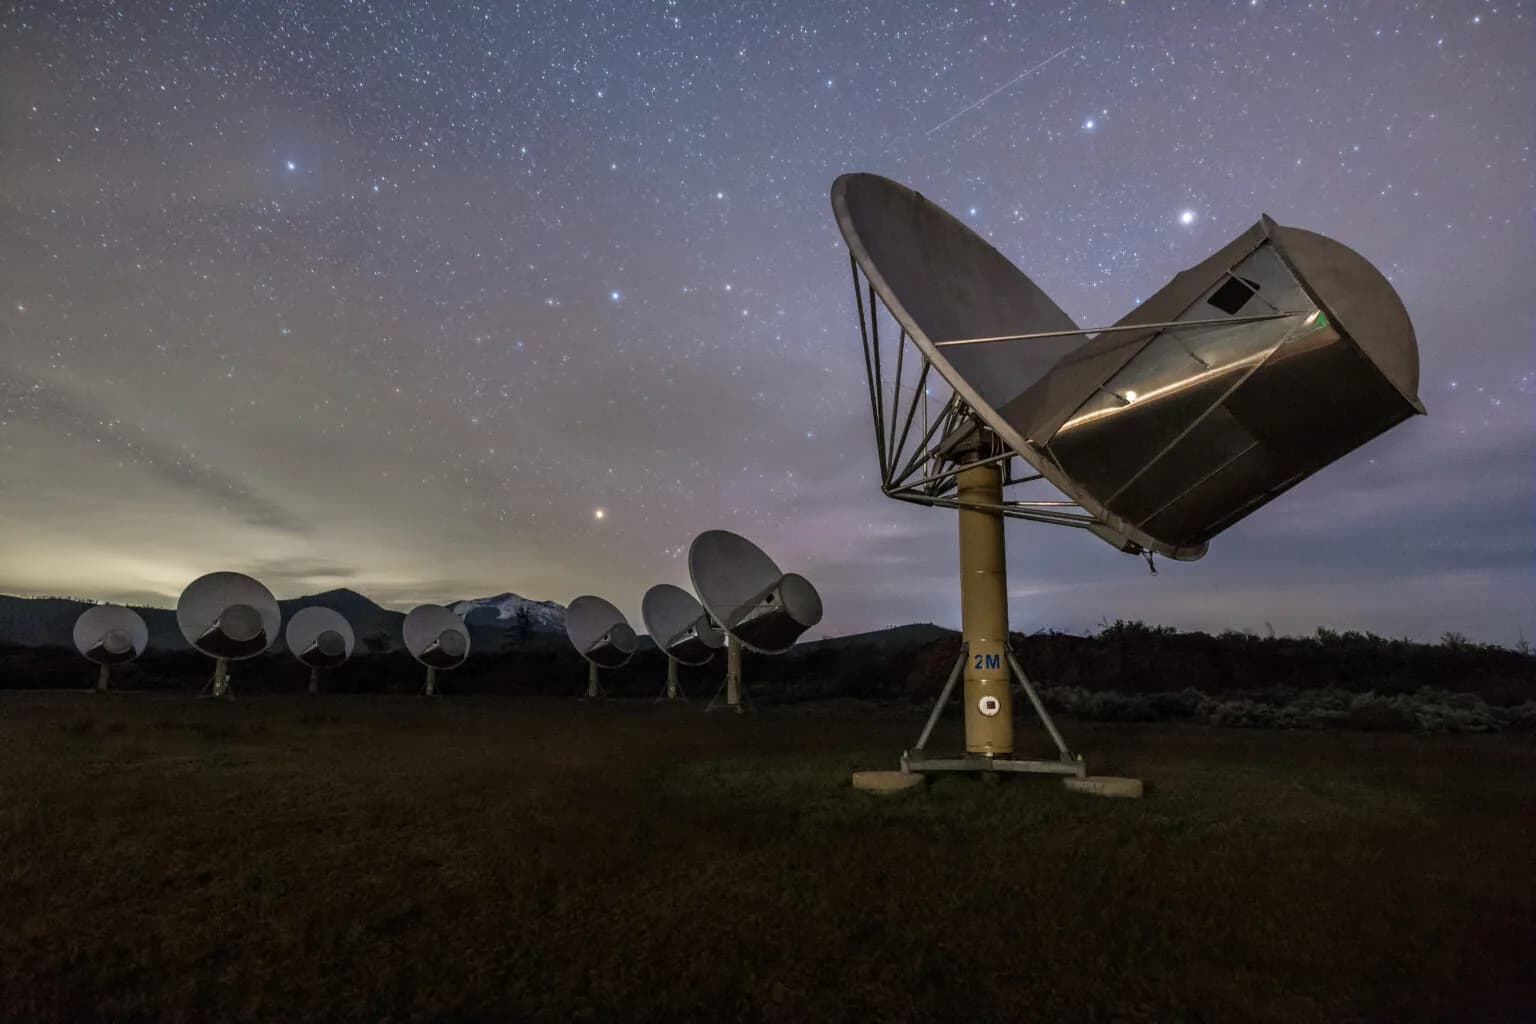
El Allen Telescope Array procesa sus señales en tiempo real con la plataforma Holoscan de Nvidia, y el equipo detectó así un púlsar en la nebulosa del Cangrejo.
La versión también lleva Windows on Arm a la DGX Station, amplía el control del reparto de GPU con MPS v3 y suma comunicación entre varias GPU dentro de CUDA Tile.
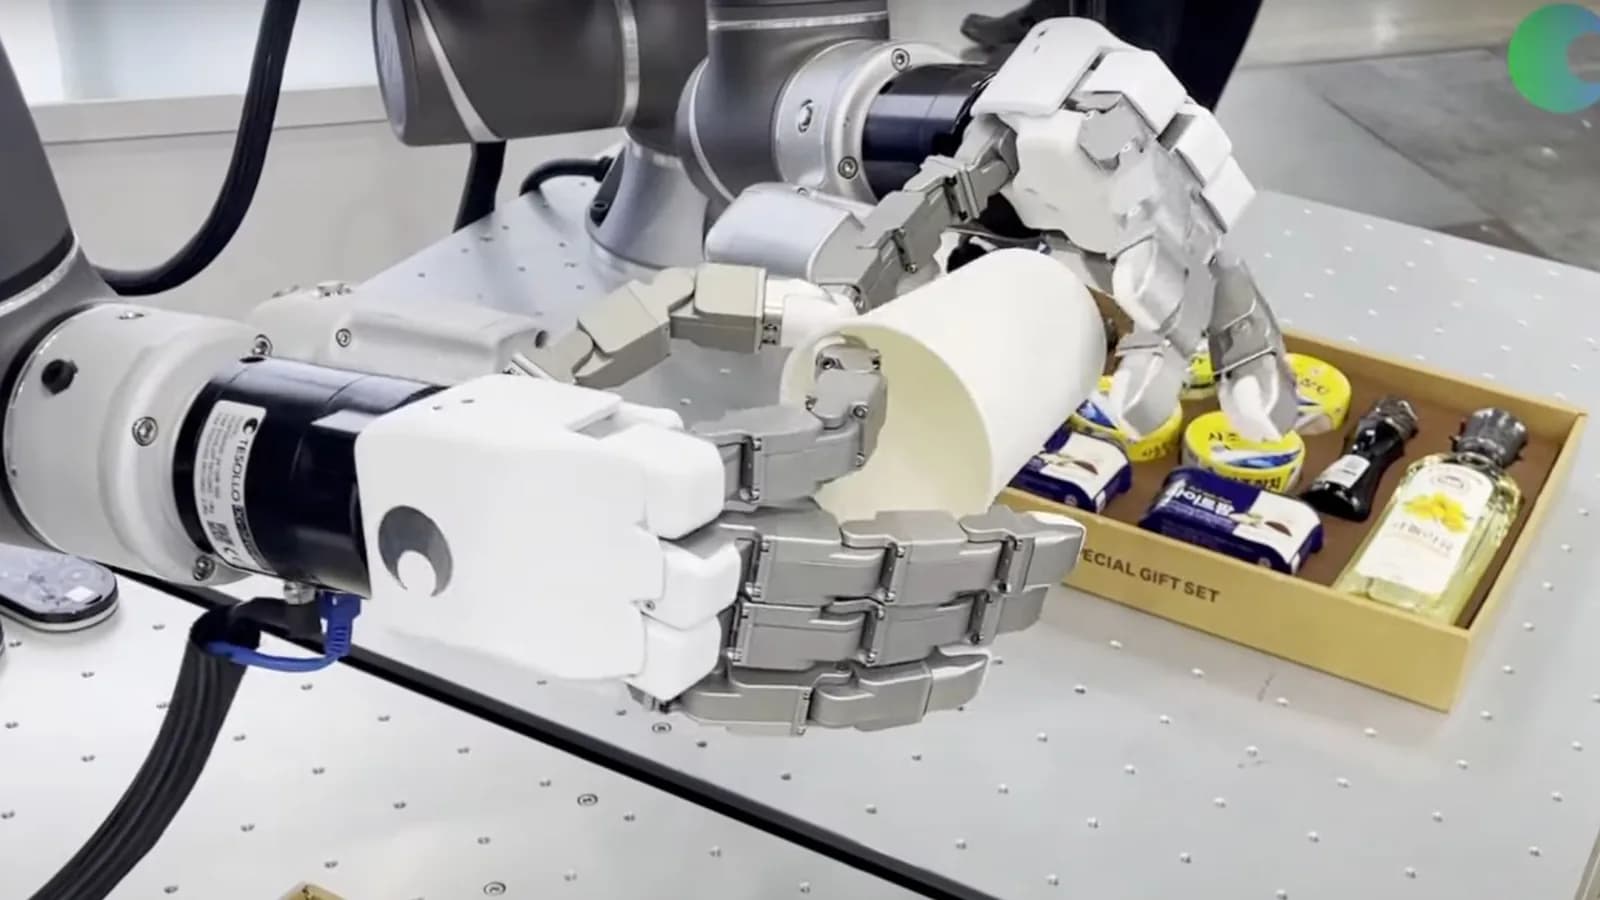
El método arma trayectorias completas en una sola pasada del modelo y bajó la latencia de 3.552 a 703 milisegundos en un Jetson Thor.
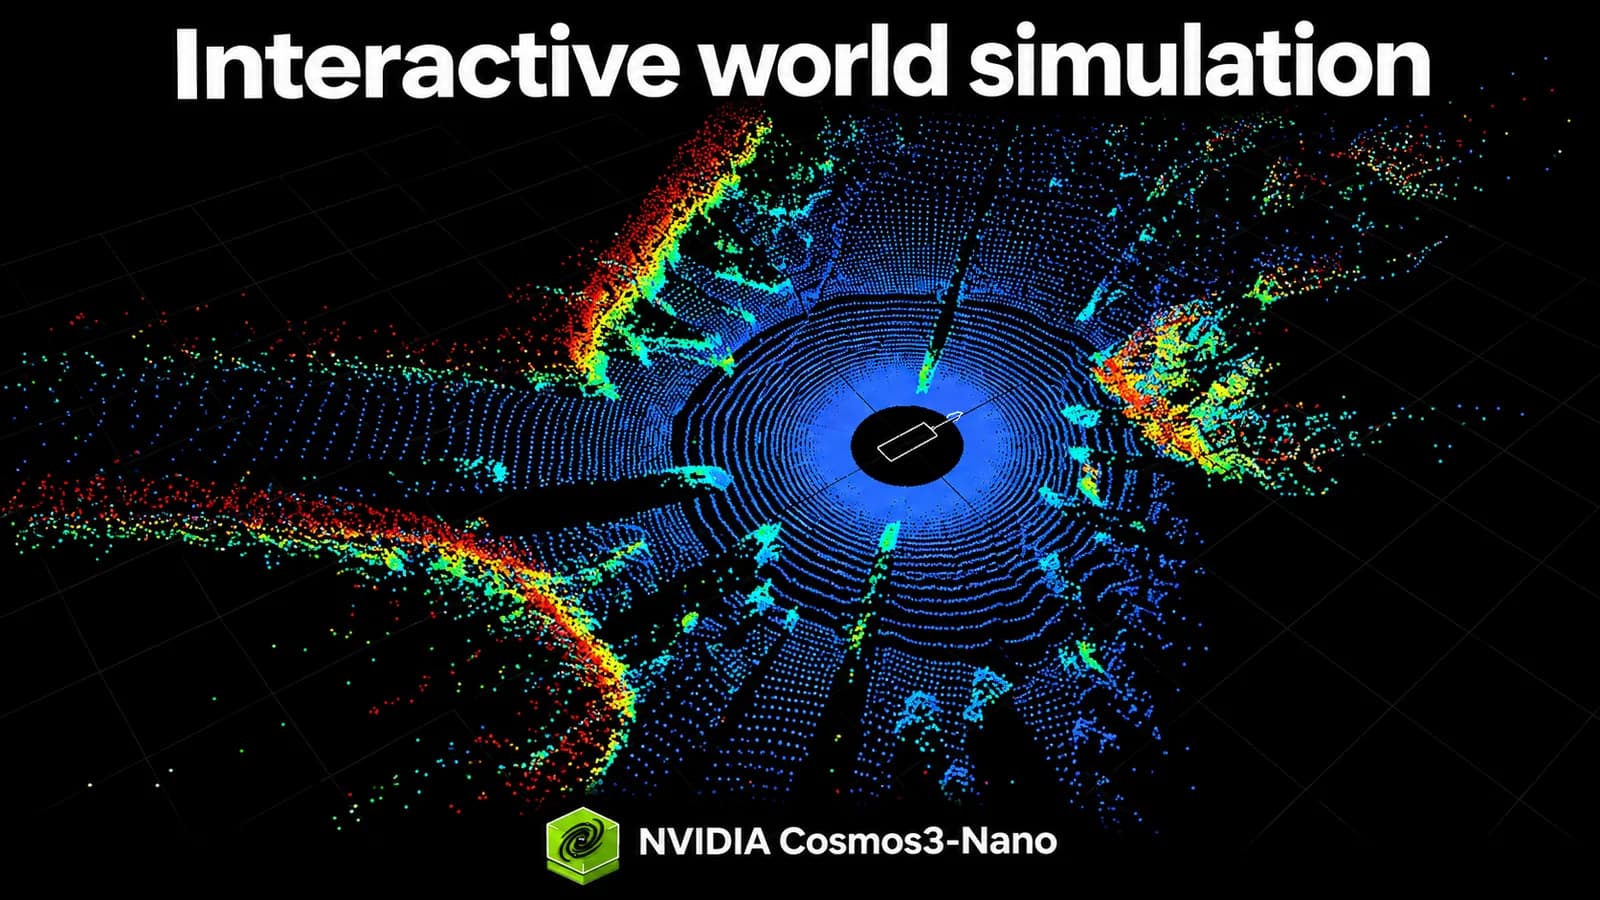
Son versiones de 16.000 millones de parámetros de Cosmos 3 Nano que generan video, cámaras y LiDAR a partir de acciones o controles de un simulador.
Los pedidos chinos de la tarjeta de estación de trabajo sumarían 70.000 millones de dólares, y Nvidia despacharía apenas unas decenas de miles en los próximos meses.
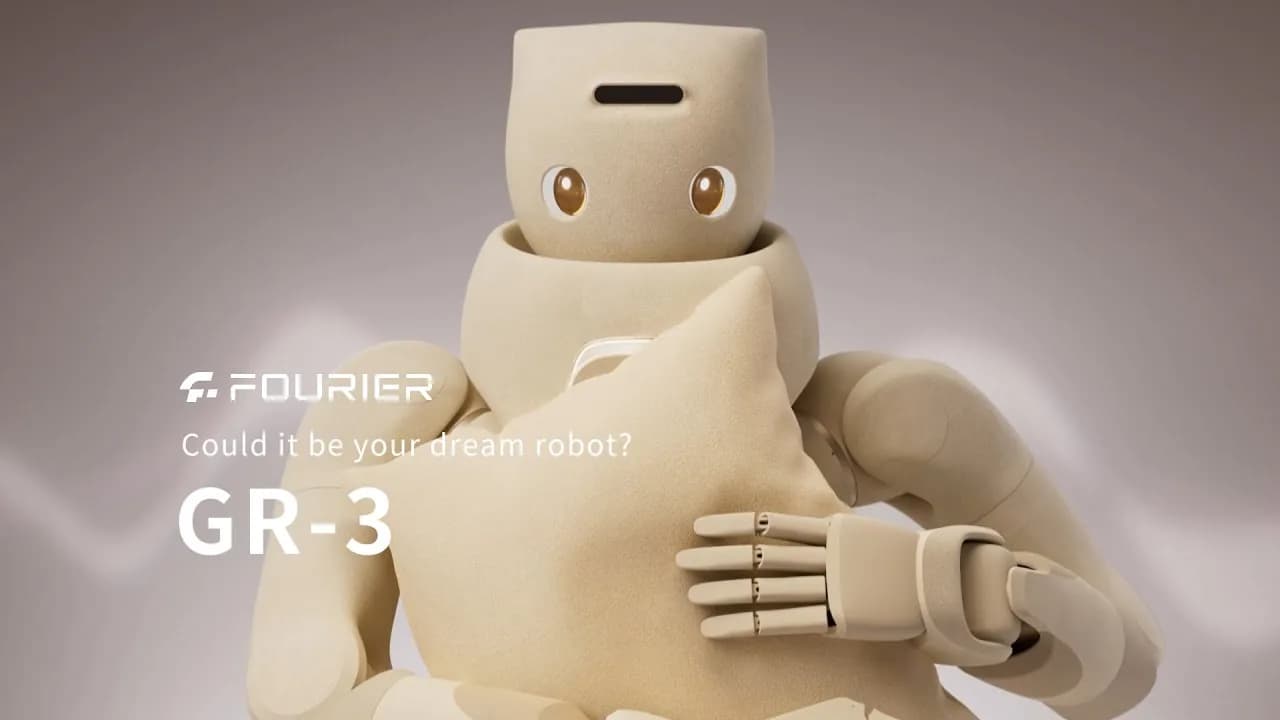
El prototipo mide 1,5 metros, usa Jetson Thor de NVIDIA y se construyó en tres meses. Meta ya trabaja en una segunda versión, Max 2.
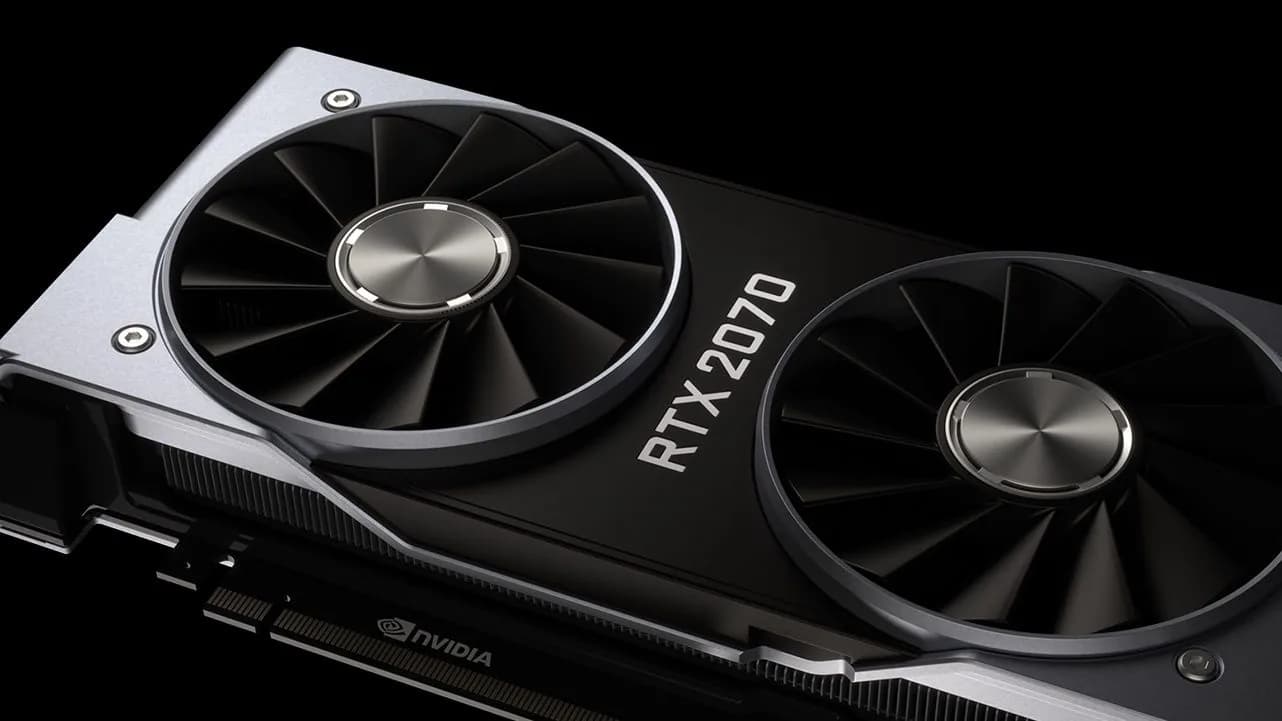
La herramienta abierta nv-uefi-unlocker corre antes del driver de Nvidia y llevó una RTX 4060 de portátil a 65% más de rendimiento en FP16.
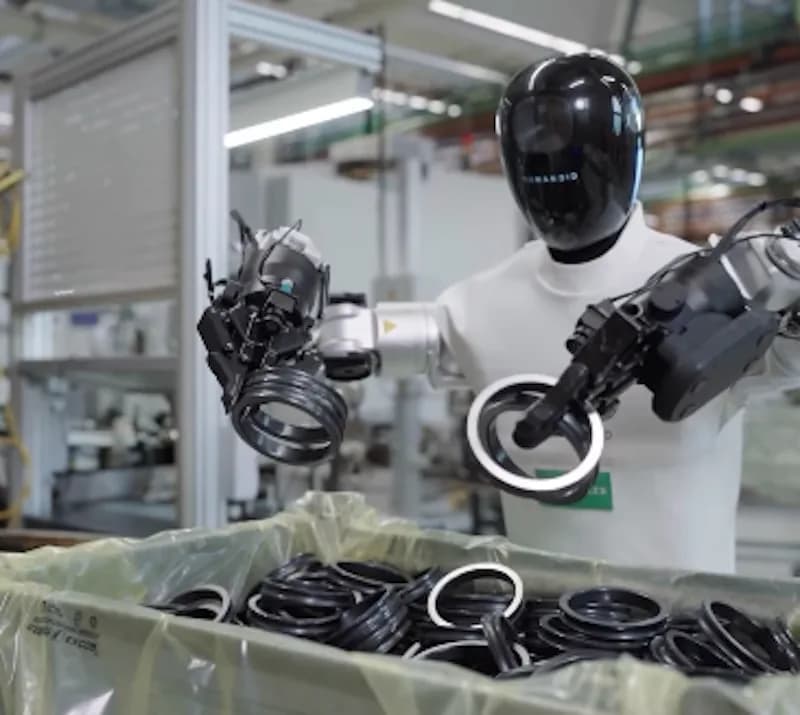
La empresa británica amplía su trabajo con Nvidia para correr la IA a bordo, con Isaac OS, Holoscan Sensor Bridge y Ethernet de hasta 100 Gb.
El modelo de 30.000 millones de parámetros transcribe grabaciones de hasta una hora y distingue hasta ocho voces. Llega junto a Granary v2, su base de datos de voz.
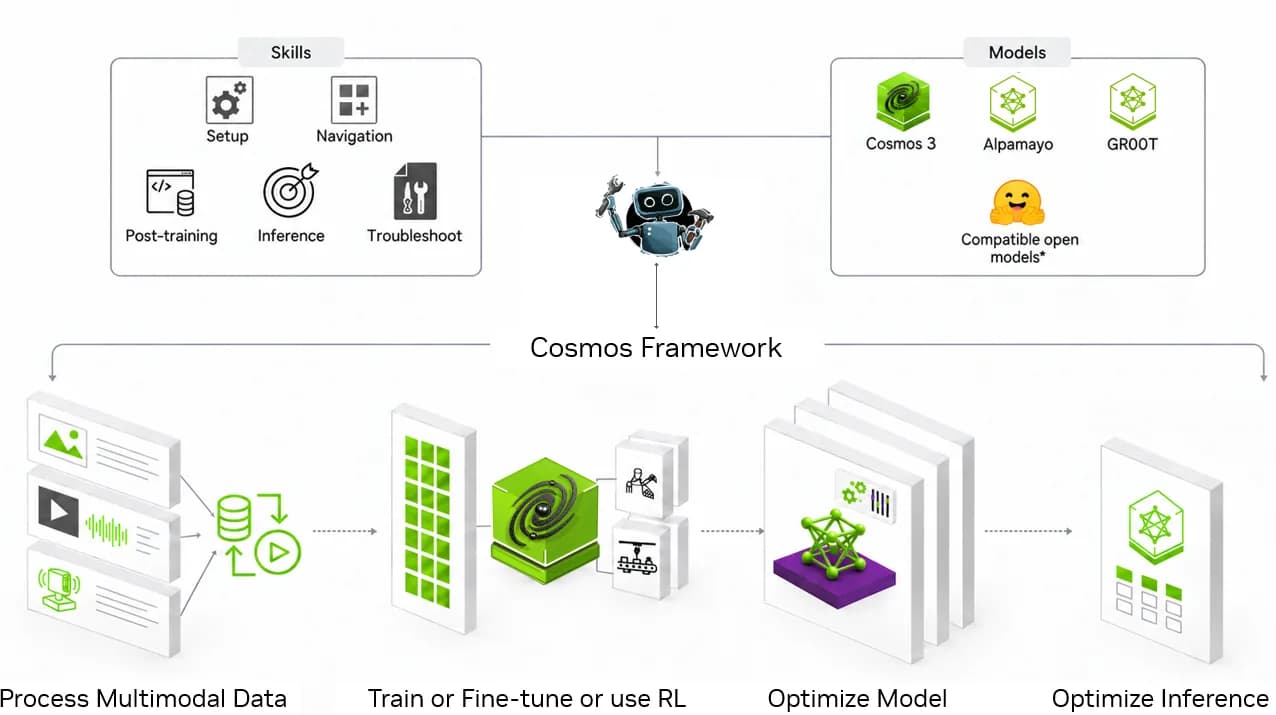
Cosmos Data Factory suma cinco blueprints de datos sintéticos y Cosmos 3 Nano llega en variantes para probar políticas de robots y autos en simulación.
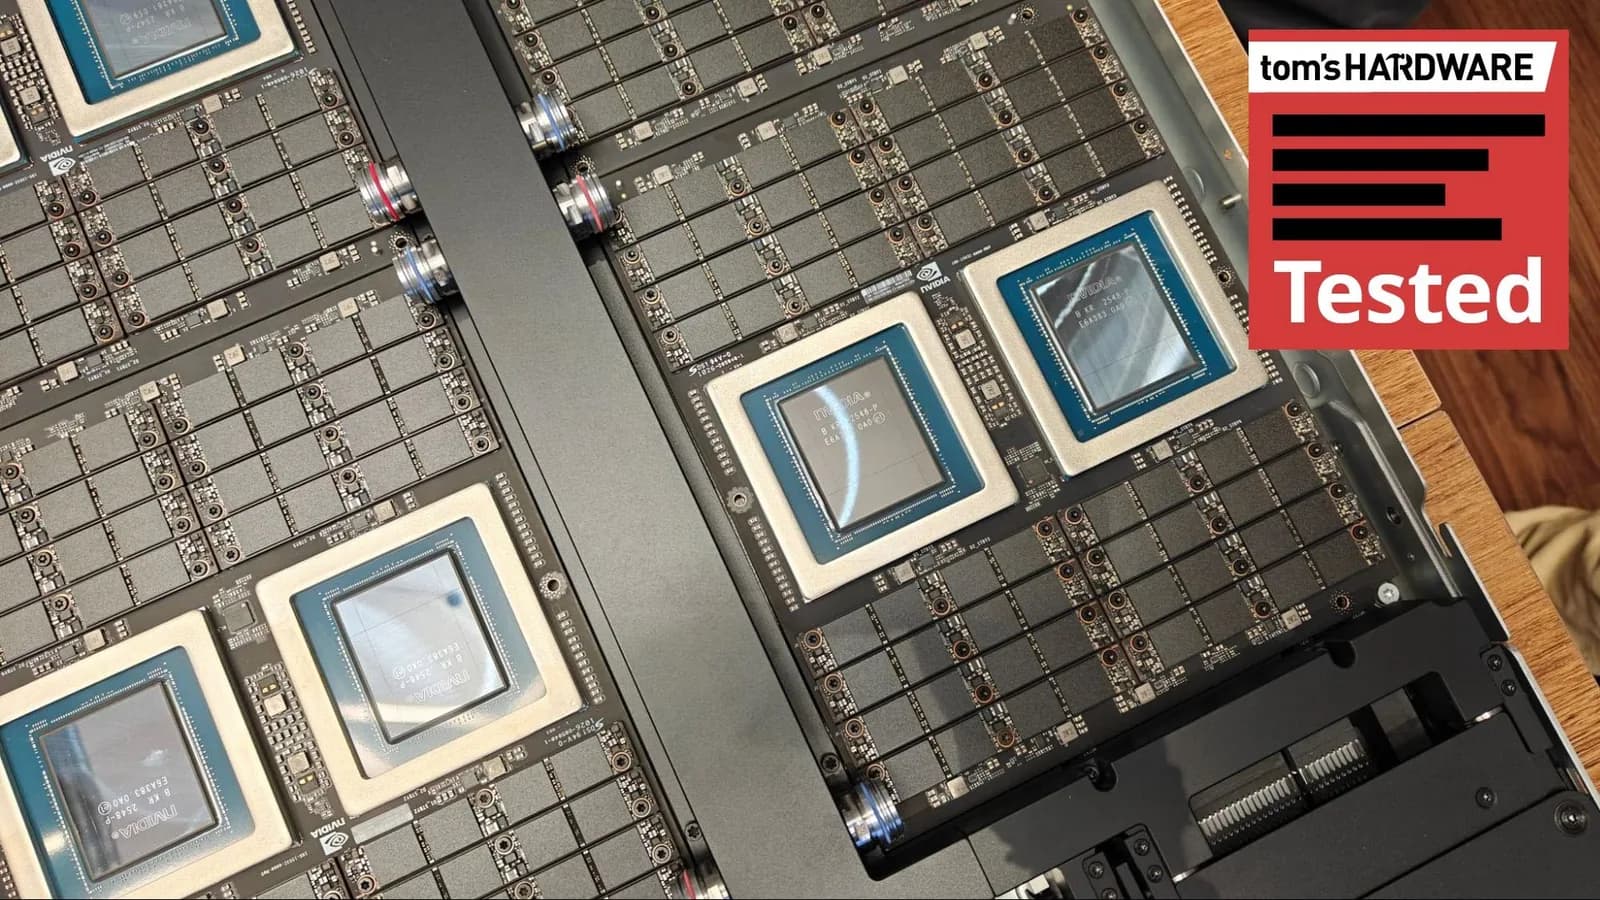
Tom's Hardware probó la CPU de 88 núcleos contra el Xeon 6980P y los EPYC 9965 y 9755, con ventaja en Python y en ancho de banda de memoria.
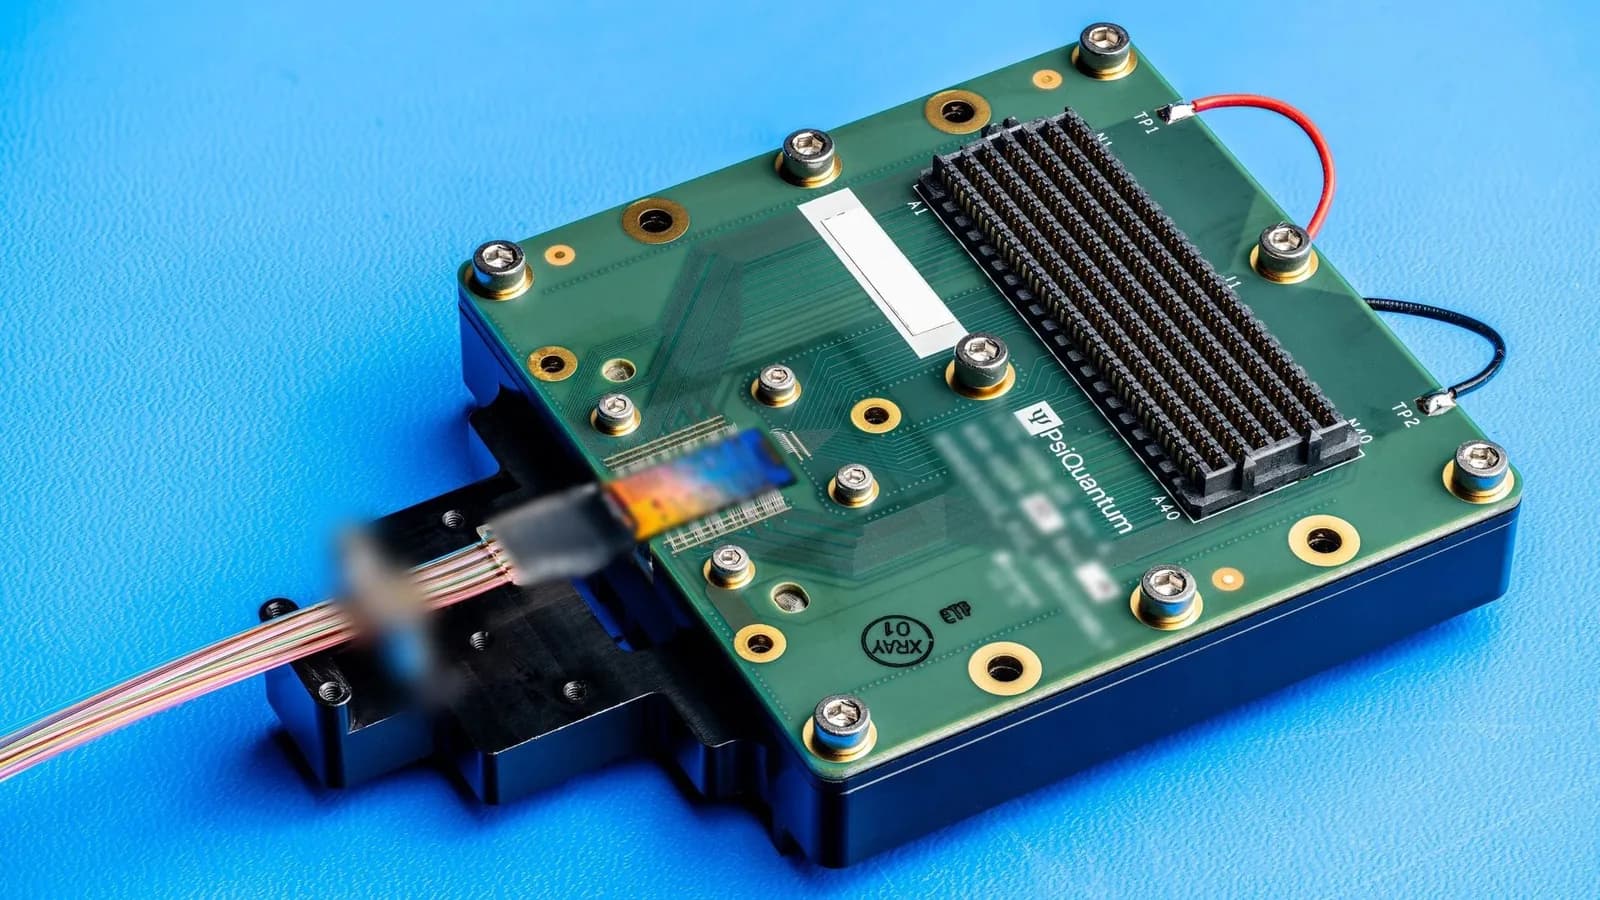
El prototipo de 8 por 8 puertos pierde 1,2 dB de señal sin amplificador, y la empresa ya tiene diseñada una versión de 64 puertos.
Atender clientes le costó 2.380 millones de dólares en el semestre, contra 16.290 millones de ingresos, y firmó contratos de cómputo por cerca de 800.000 millones.
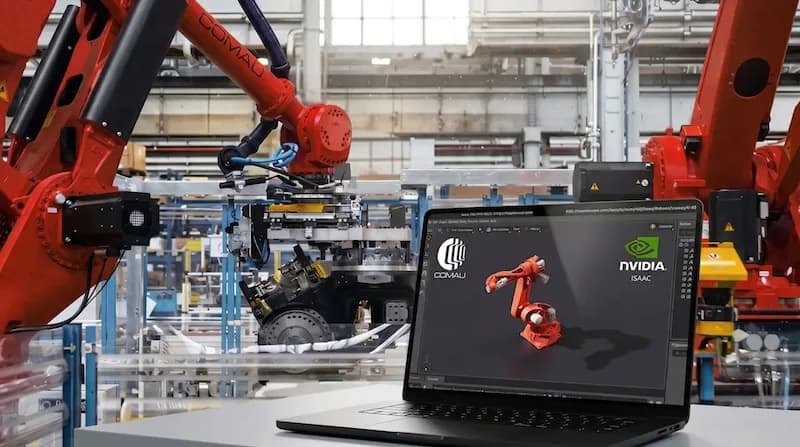
El fabricante italiano también suma sus robots a Isaac Sim y entrena con aprendizaje por refuerzo su sistema de visión MI.RA para paletizado.
Una placa dorada virtual creada con Nvidia Cosmos genera imágenes sintéticas de defectos para calibrar la inspección óptica automática.
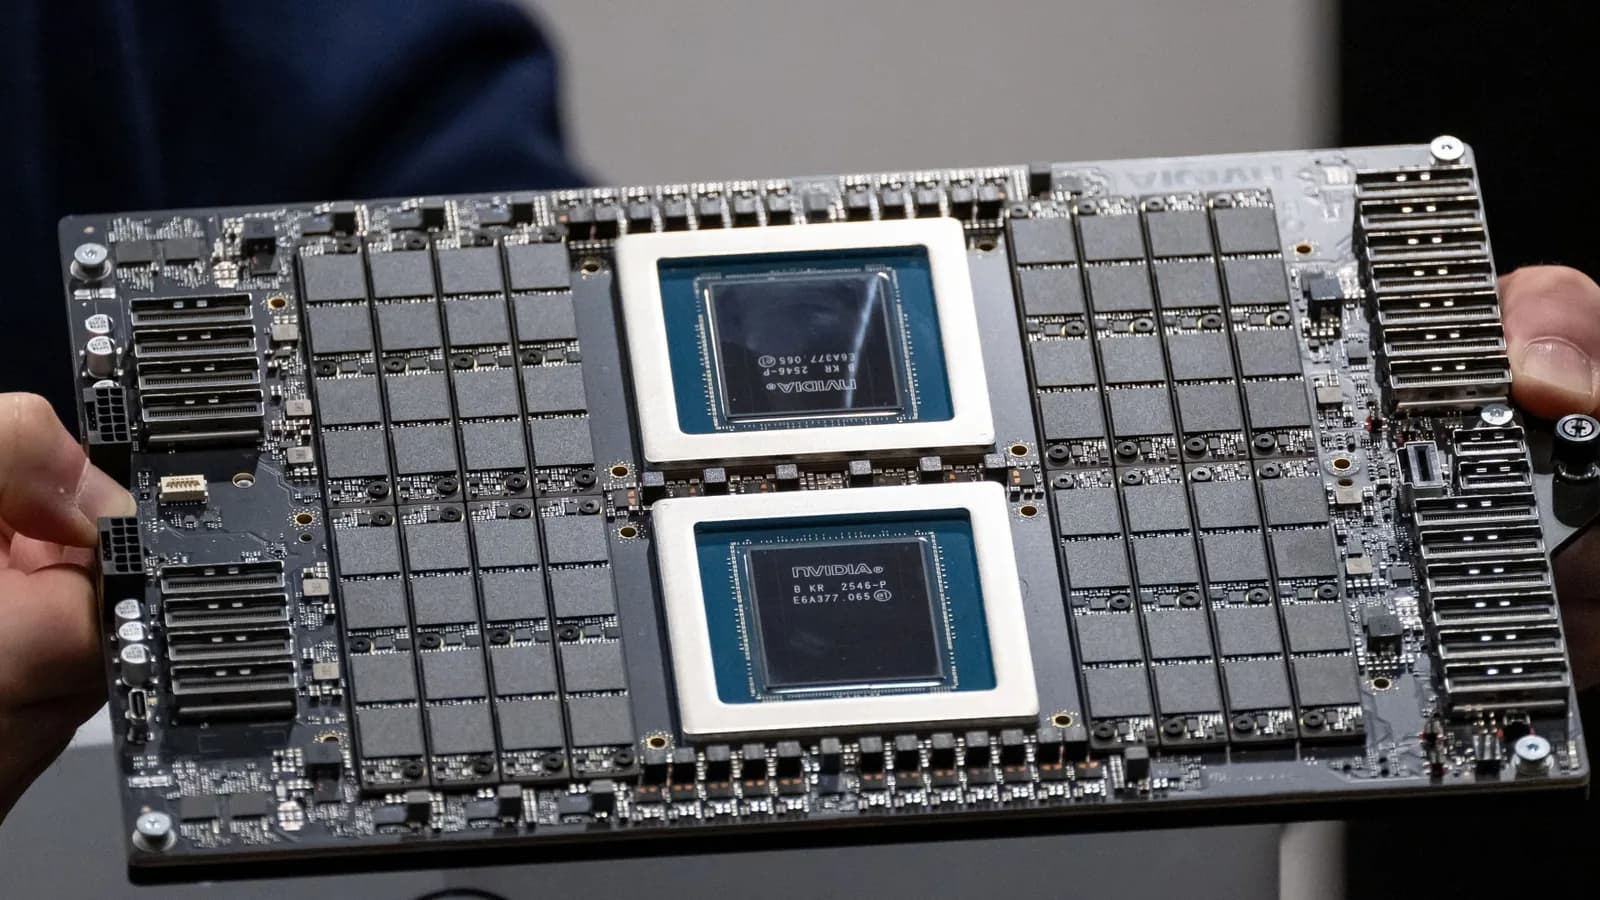
Es la primera vez que un gran proveedor de nube lista instancias de la CPU de 88 núcleos de Nvidia por separado, junto a las x86 de AMD e Intel.
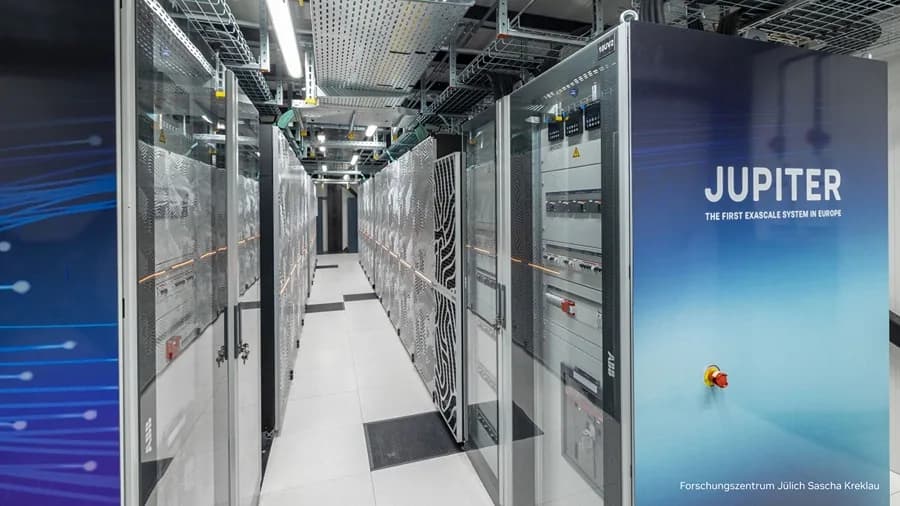
La simulación corrió en 8.192 GPU del superordenador de Jülich y validó el cultivo de estados mágicos con ruido de hardware realista.
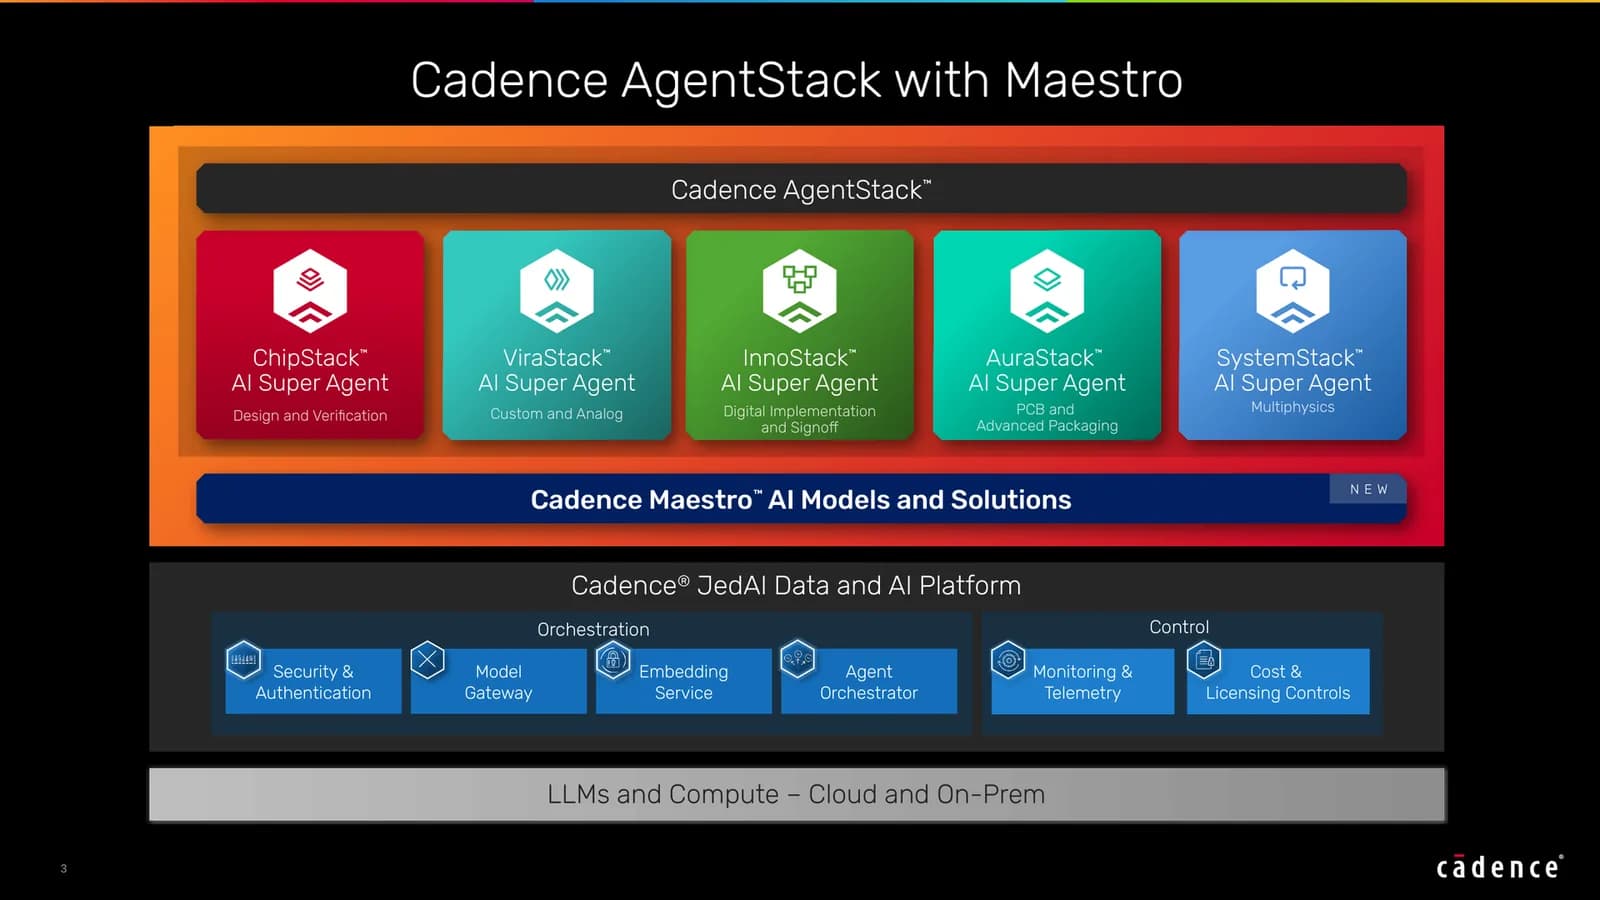
Los primeros modelos llegan a clientes de acceso anticipado en el cuarto trimestre de 2026 y, a diferencia de GPT-Synopsys, se pueden entrenar con datos del propio cliente.
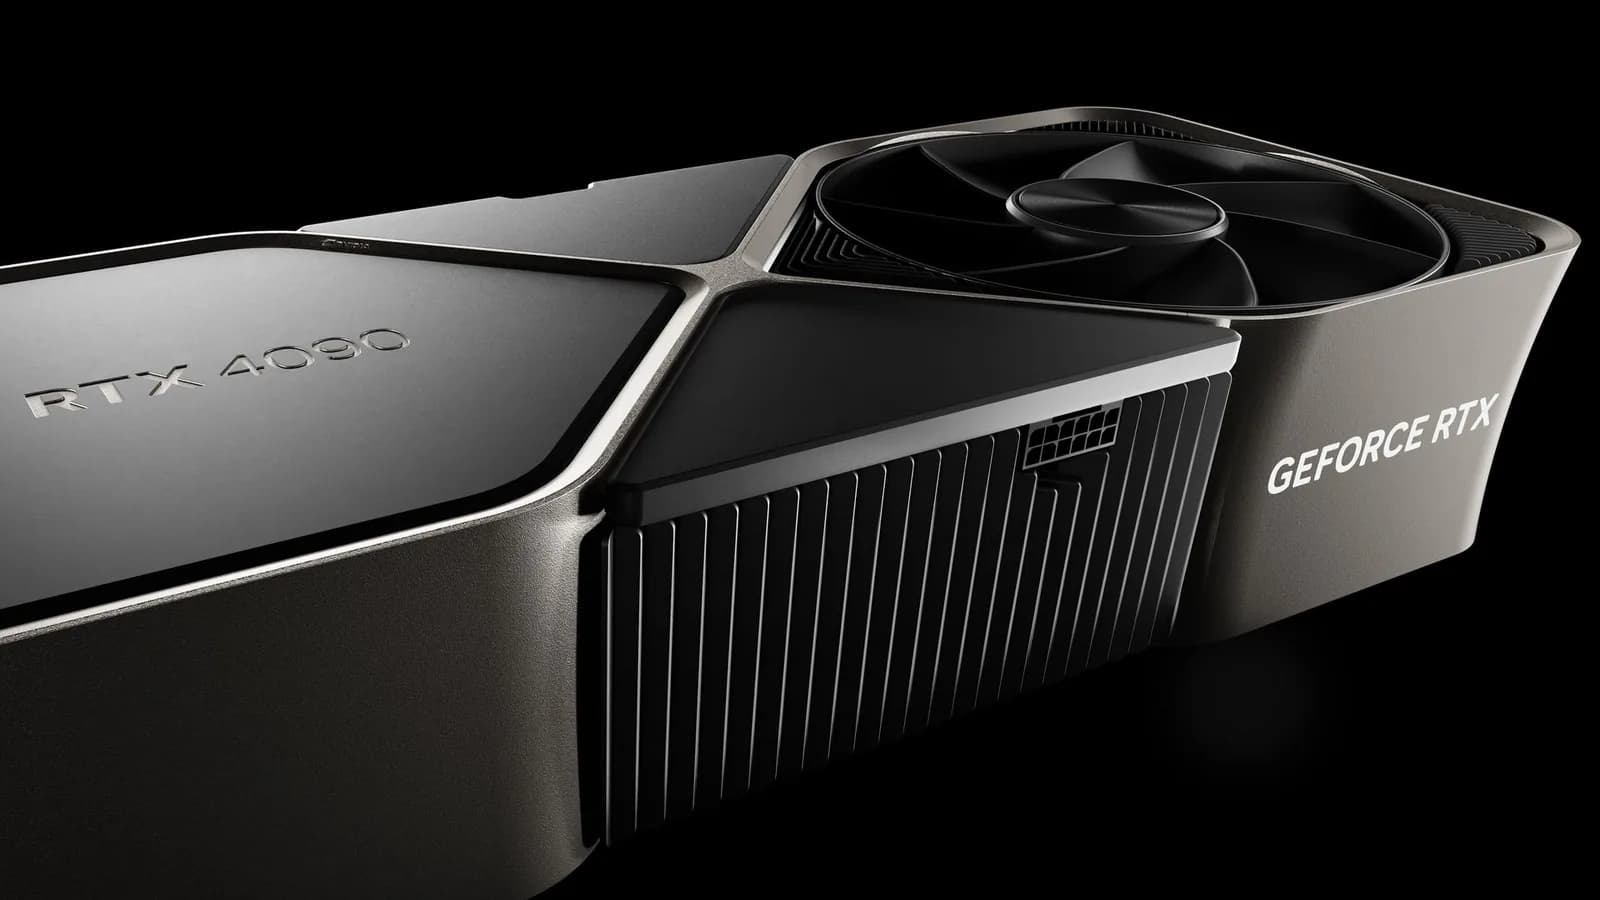
Tres proyectos levantan el límite que Nvidia impone a las GeForce RTX 20, 30 y 40 en matemática de matrices con acumulación FP32, con ganancias reales menores al doble.
Pollen Robotics presentó en el GTC Berlín un bípedo de 25 centímetros con 15 motores, cámara y pico articulado, y su tienda avisa que los pedidos actuales saldrán después de abril de 2027.
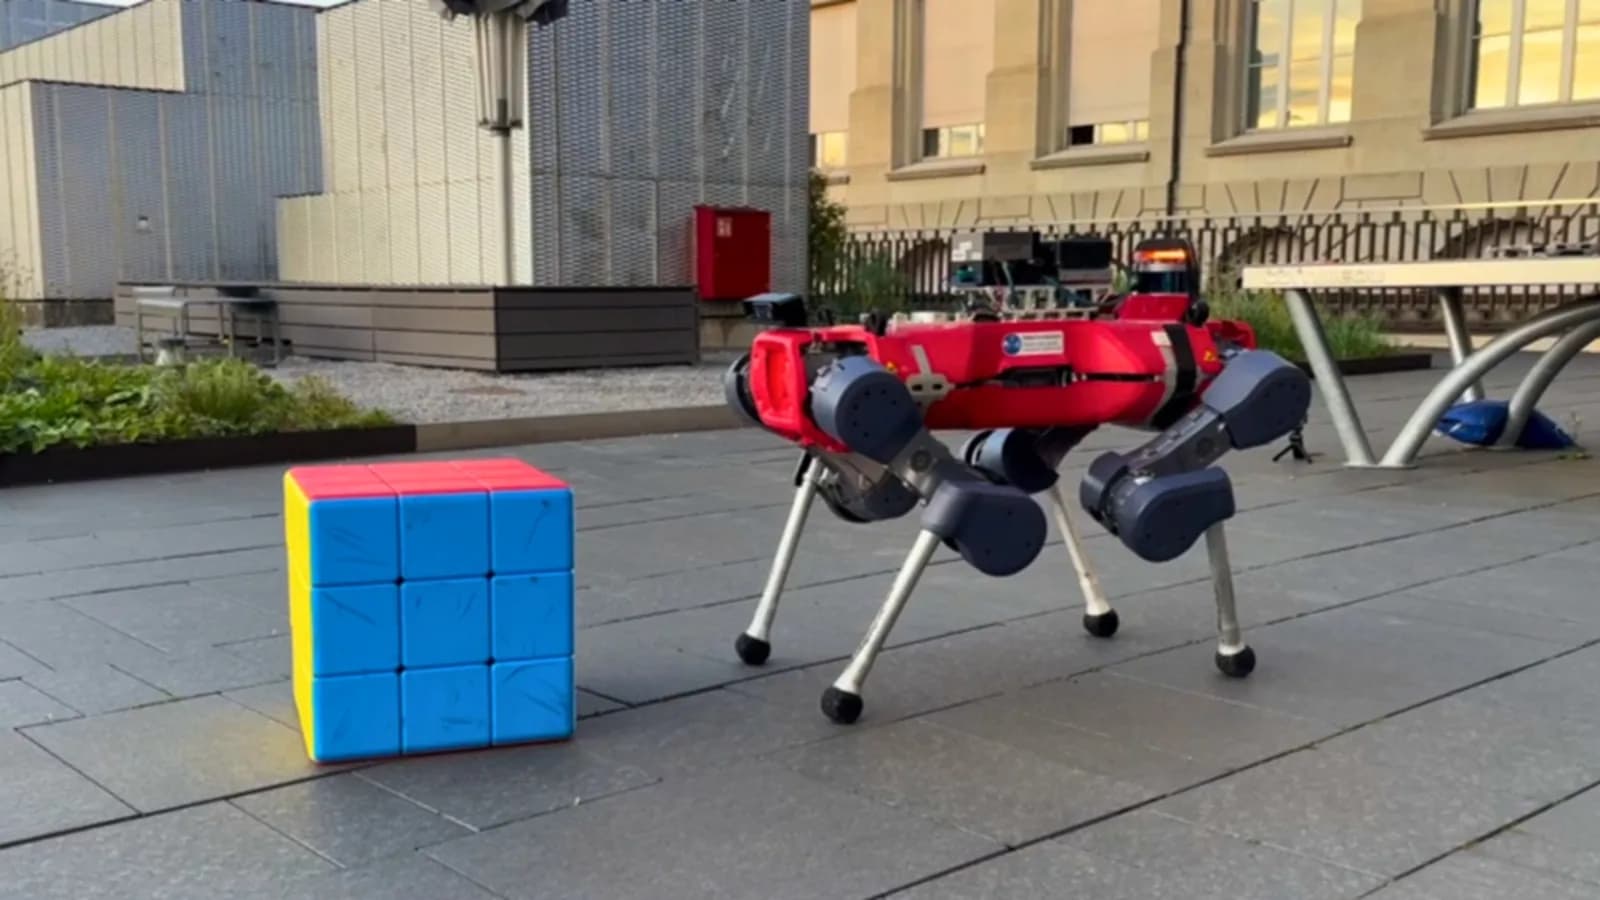
El cuadrúpedo de ETH Zúrich y NVIDIA completó tres soluciones en hardware real, cada una de unos 30 pasos y entre 8 y 9 minutos.
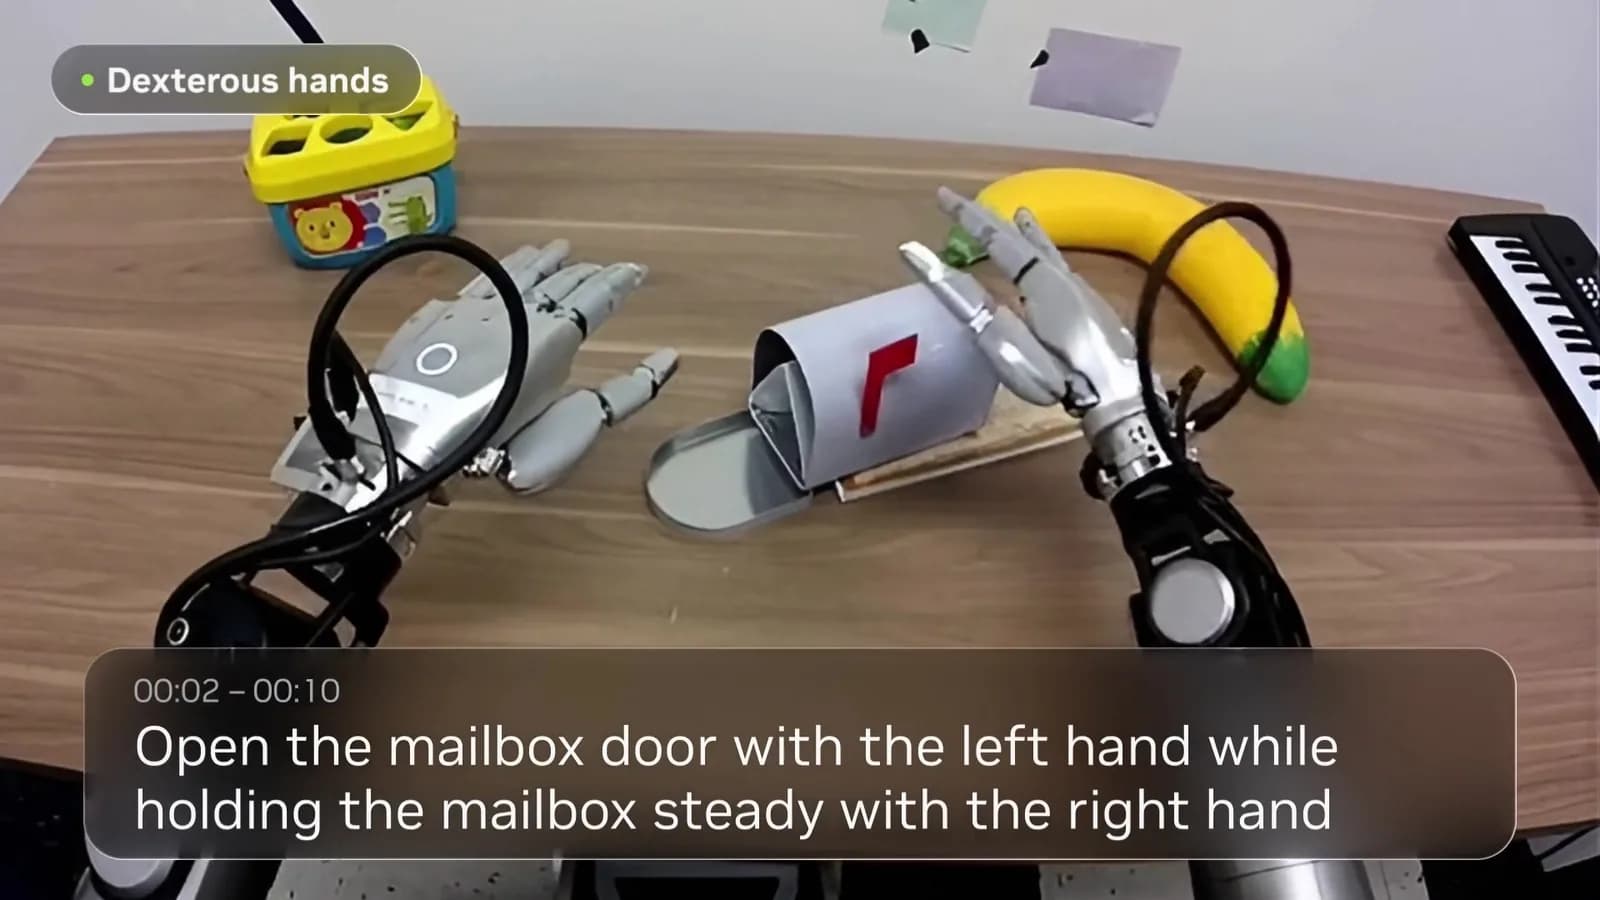
El motor de datos abierto se apoya en tres modelos Qwen3.5 afinados y, según NVIDIA, cuesta 125 veces menos que GPT-6 Astra.
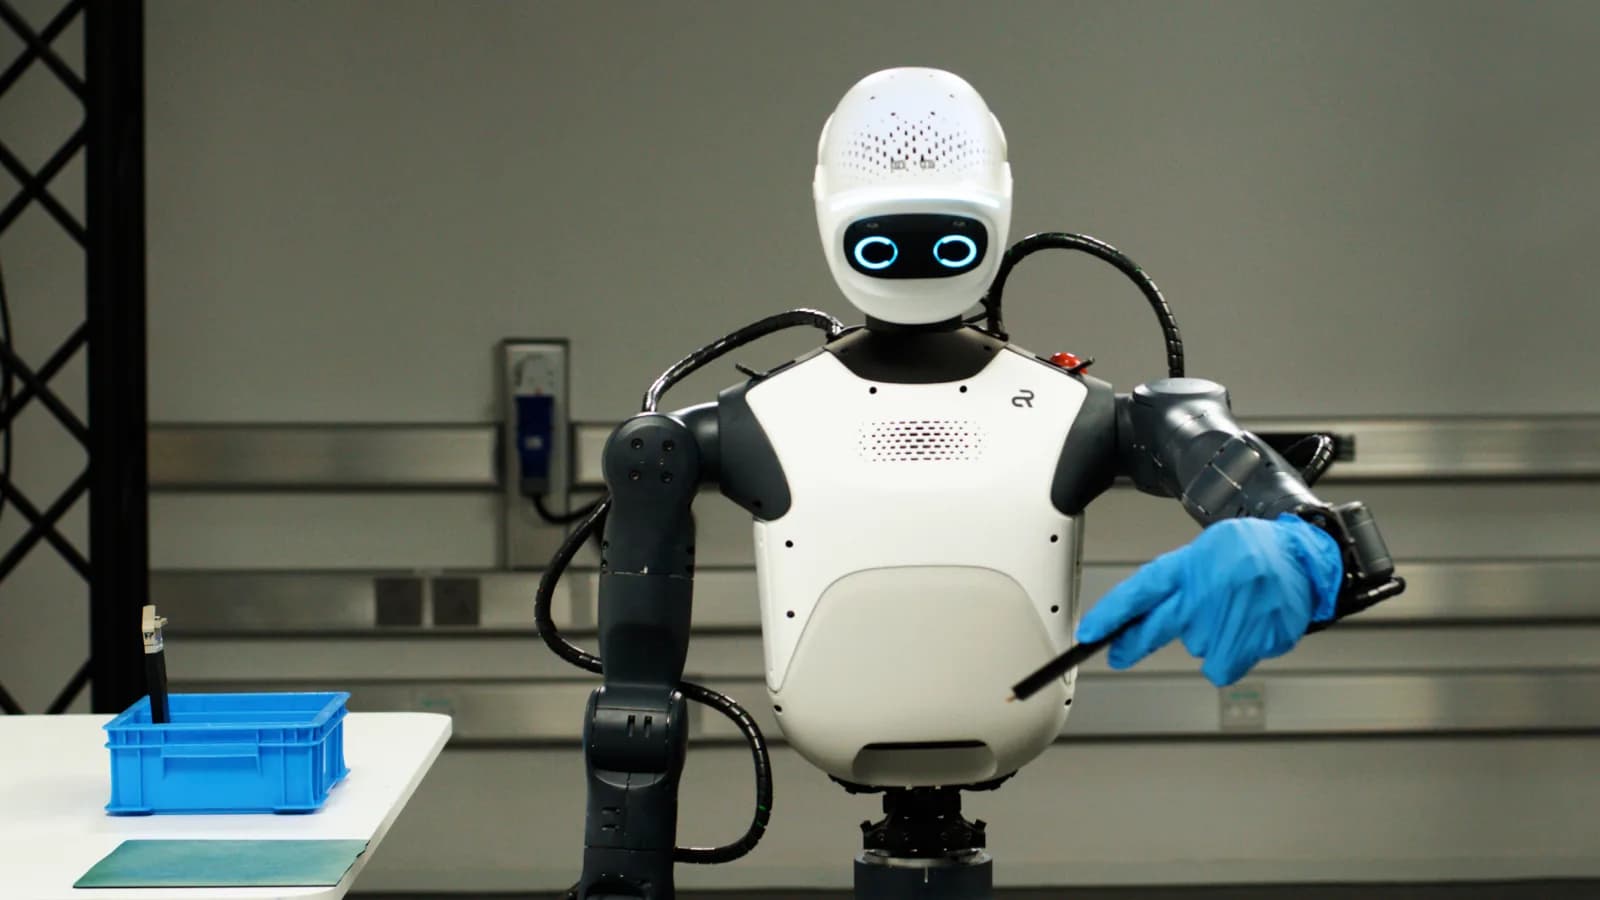
La plataforma Isaac agrega flujos de referencia, más de 2.000 recursos de simulación, el conjunto Human 1M y un runtime abierto sobre Holoscan para pasar de la simulación al robot real.
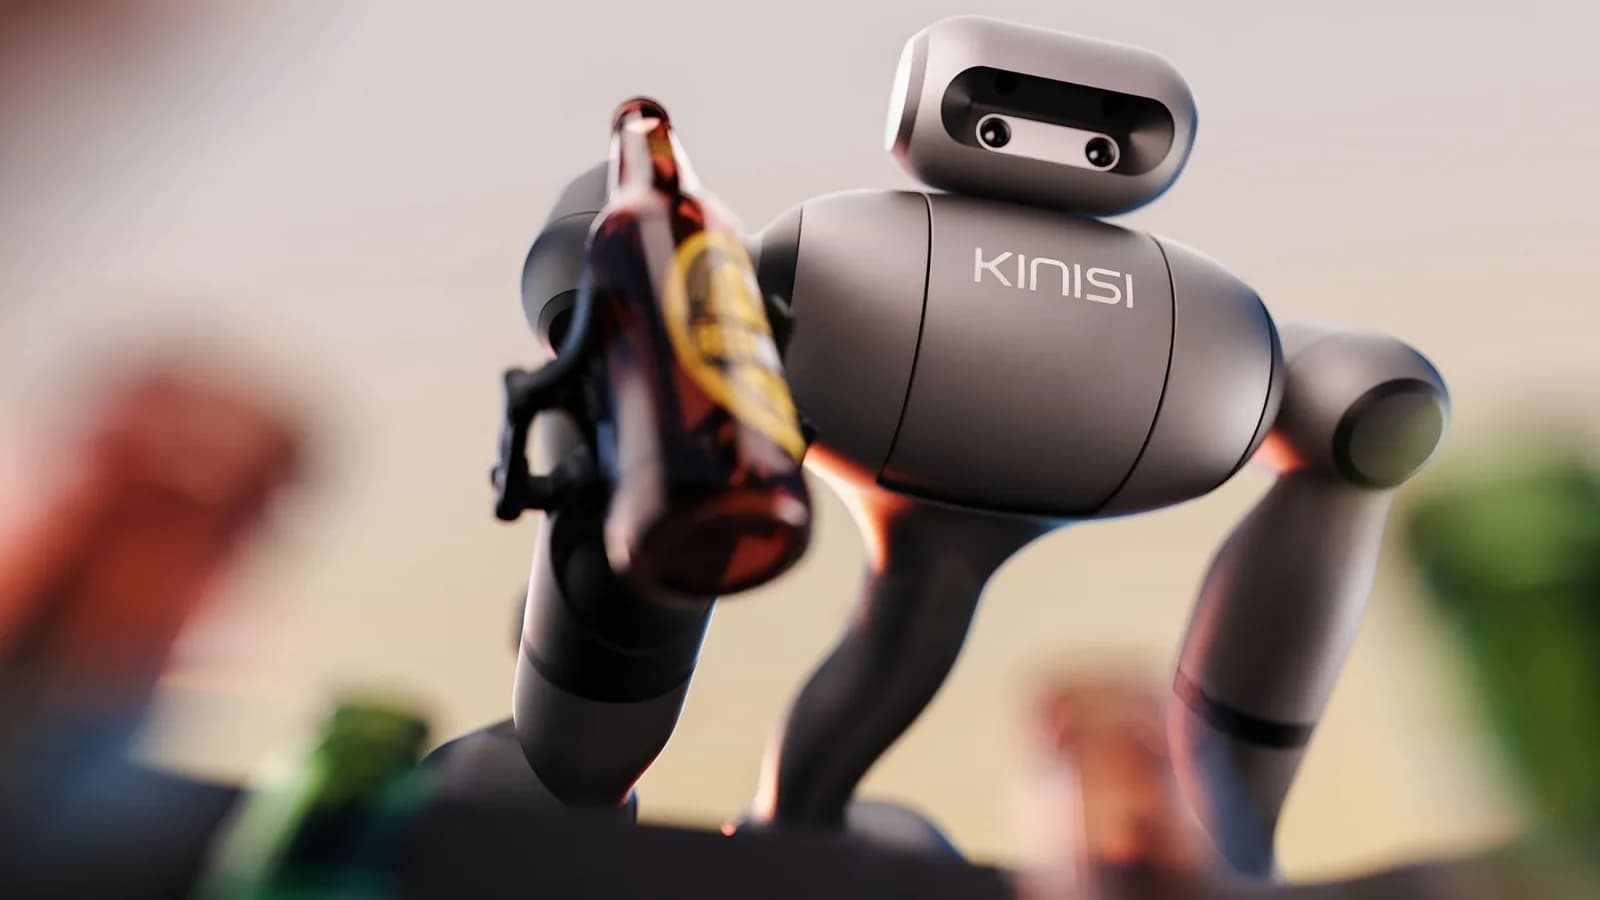
La empresa usó el software de NVIDIA sobre una Jetson AGX Thor y presentó KINO-2, su plataforma para enseñarle tareas al robot con demostraciones humanas.
NVIDIA publicó una guía paso a paso con KvikIO para cargar archivos en la memoria de la GPU sin pasar por la CPU y comprobar qué ruta tomó cada lectura.
Lo hace con una versión de SGLang escrita para PyTorch nativo, y un vLLM equivalente marcó 700 tokens por segundo contra 452 de 16 GB200.
Cosmos Data Factory trae cinco blueprints para generar datos sintéticos, Cosmos Framework abre el ajuste fino a modelos como GR00T y Pi0.5, y los NIM de Cosmos 3 duplican la velocidad de inferencia.
Los pedidos superan los 35.000 millones de dólares, pero NVIDIA solo podría entregar entre 5% y 10% de lo que piden, según fuentes de Reuters.
Super VL tiene 120.000 millones de parámetros y apunta al centro de datos, mientras los dos Bolt están hechos para correr local en equipos con RTX Spark y DGX Spark.
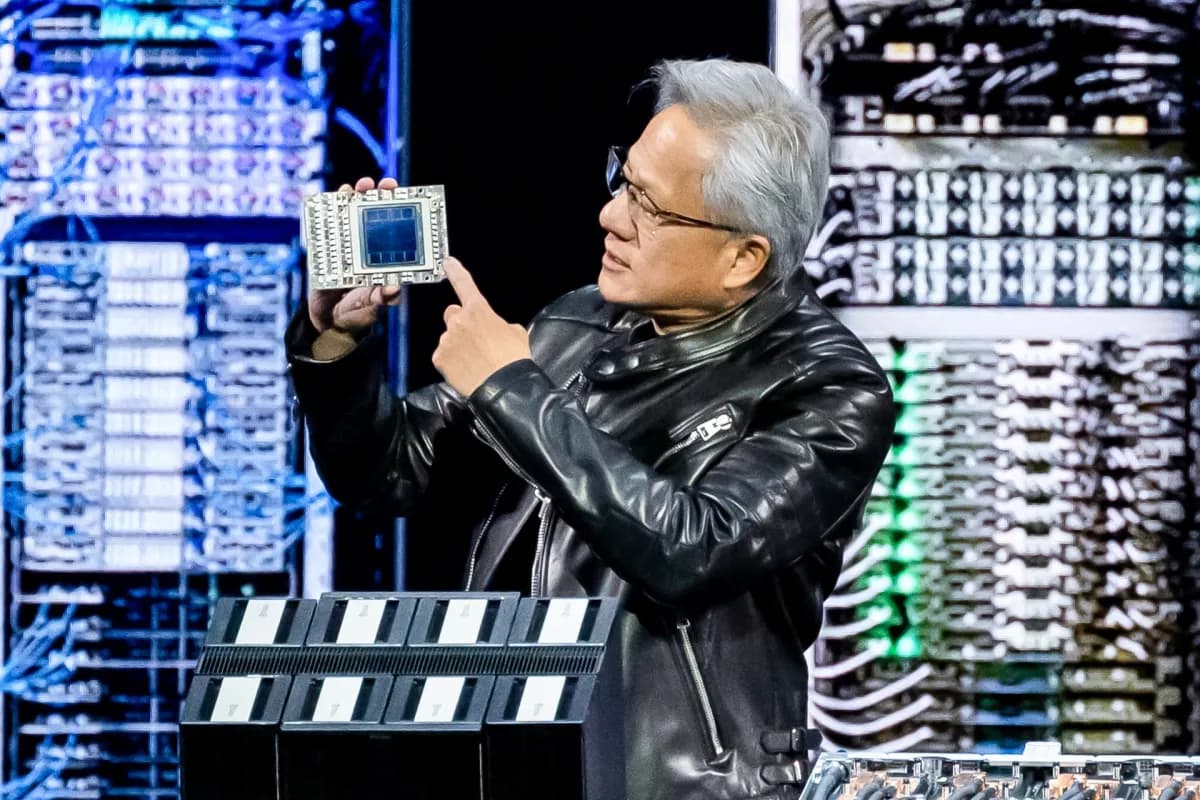
La herramienta de AWS promete llevar una app de PyTorch a Trainium cambiando una sola línea de configuración, sin reescribir código.
El sistema será de nivel 2++, parecido al FSD de Tesla, correrá sobre la plataforma Hyperion y llegará a toda la gama antes de 2030.
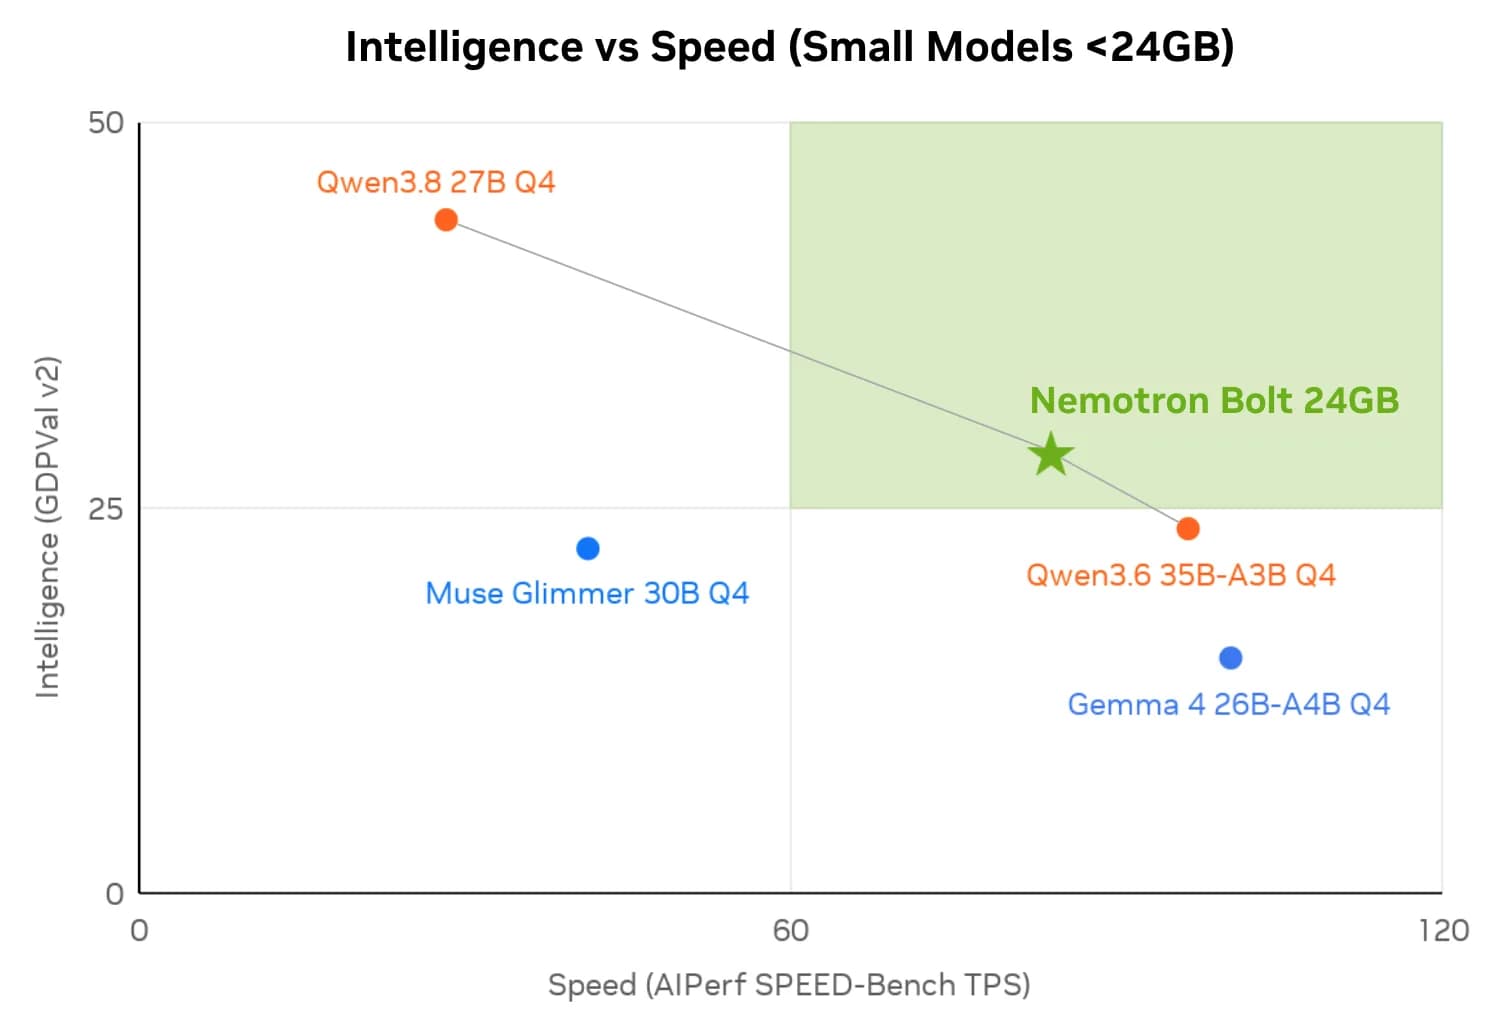
Super VL tiene 120.000 millones de parámetros y apunta a agentes empresariales. Los Bolt corren en 24 GB y 4 GB de memoria, en PC y Jetson.
USD BRep abre bajo licencia Apache 2.0 un motor de modelado sólido NURBS que antes se vendía con licencia comercial, con interfaces en C++ y Python.
La plataforma de orquestación de GPU sobre Kubernetes queda abierta completa, junto a cuatro componentes que se pueden adoptar por separado.
Según el Financial Times, usan RTX 5090 y RTX Pro permitidas por los controles de exportación para cubrir un déficit de 1,5 millones de chips.
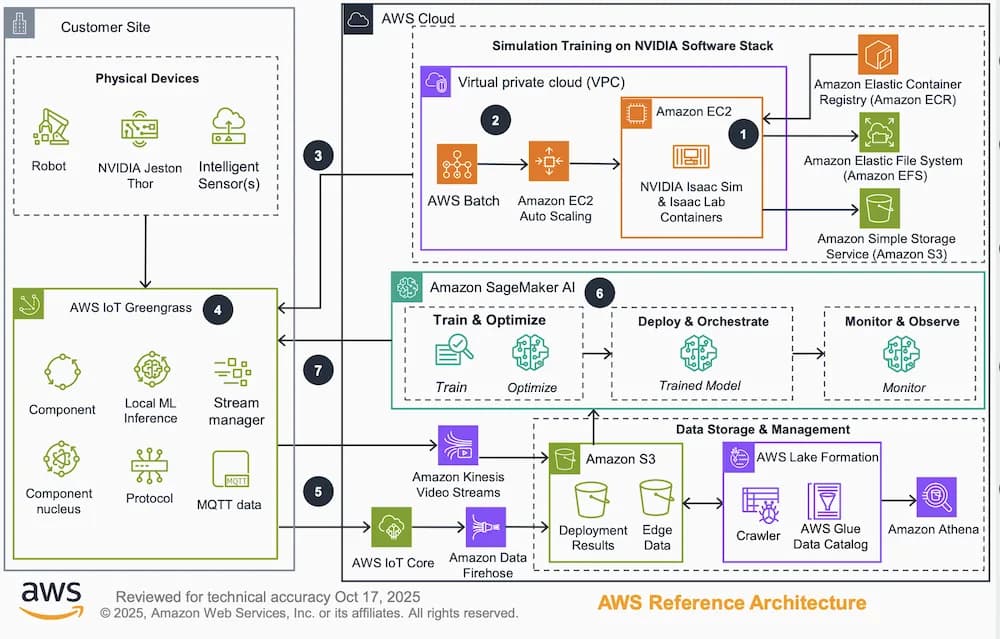
Junta SageMaker, IoT Greengrass y el stack Isaac y Cosmos de NVIDIA en un flujo que va de los datos sintéticos al despliegue en el robot.
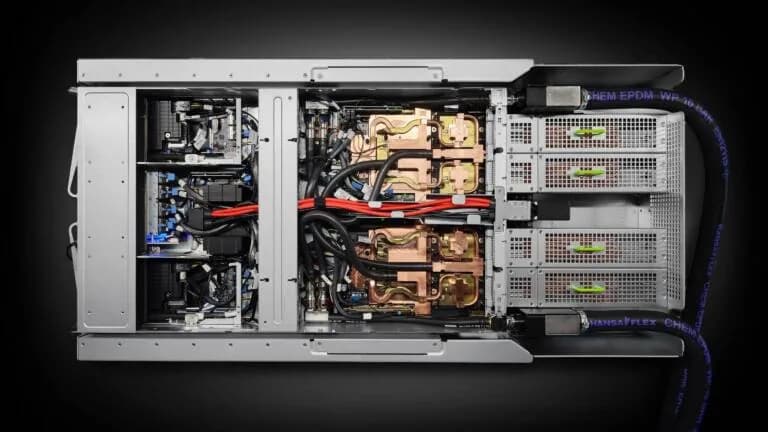
El laboratorio de robótica de NVIDIA en Seattle y Foxconn pusieron a prueba robots en el montaje de las bandejas de prueba del GB300, y lo clásico ganó a lo aprendido.
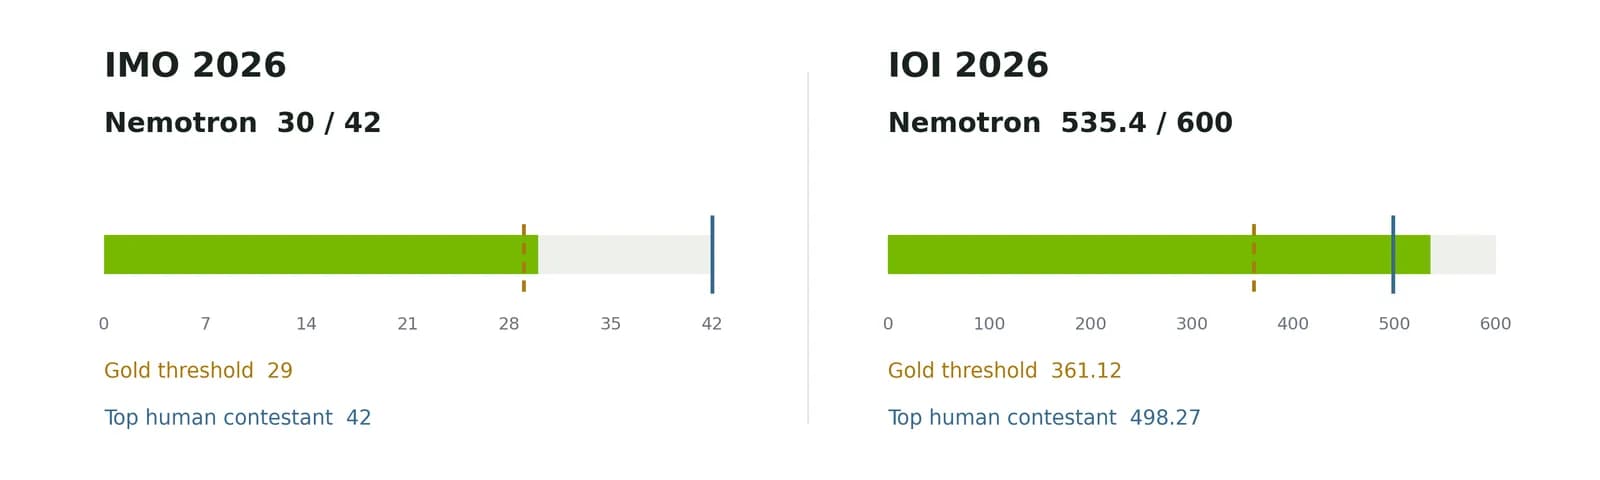
NVIDIA especializó su familia Nemotron 3 con ajuste fino y aprendizaje por refuerzo, y liberó en Hugging Face los modelos, los datos y las recetas.
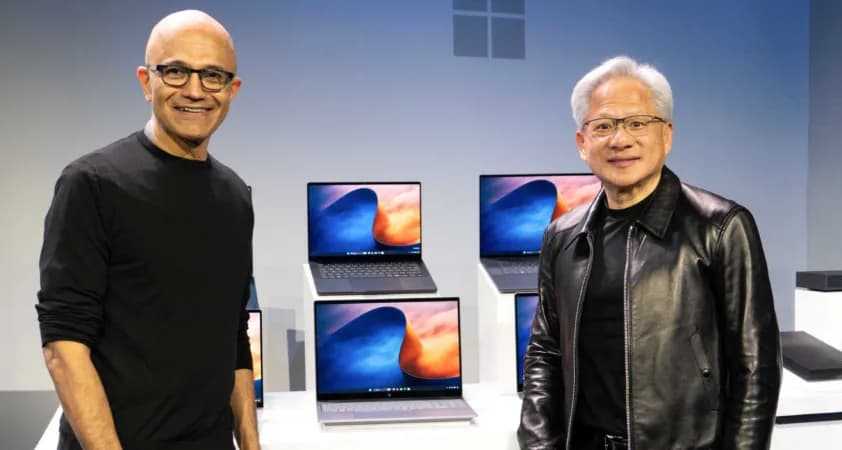
NVIDIA y Microsoft presentaron en San Francisco el chip para agentes locales, la Surface Laptop Ultra y una DGX Station que por primera vez corre Windows.
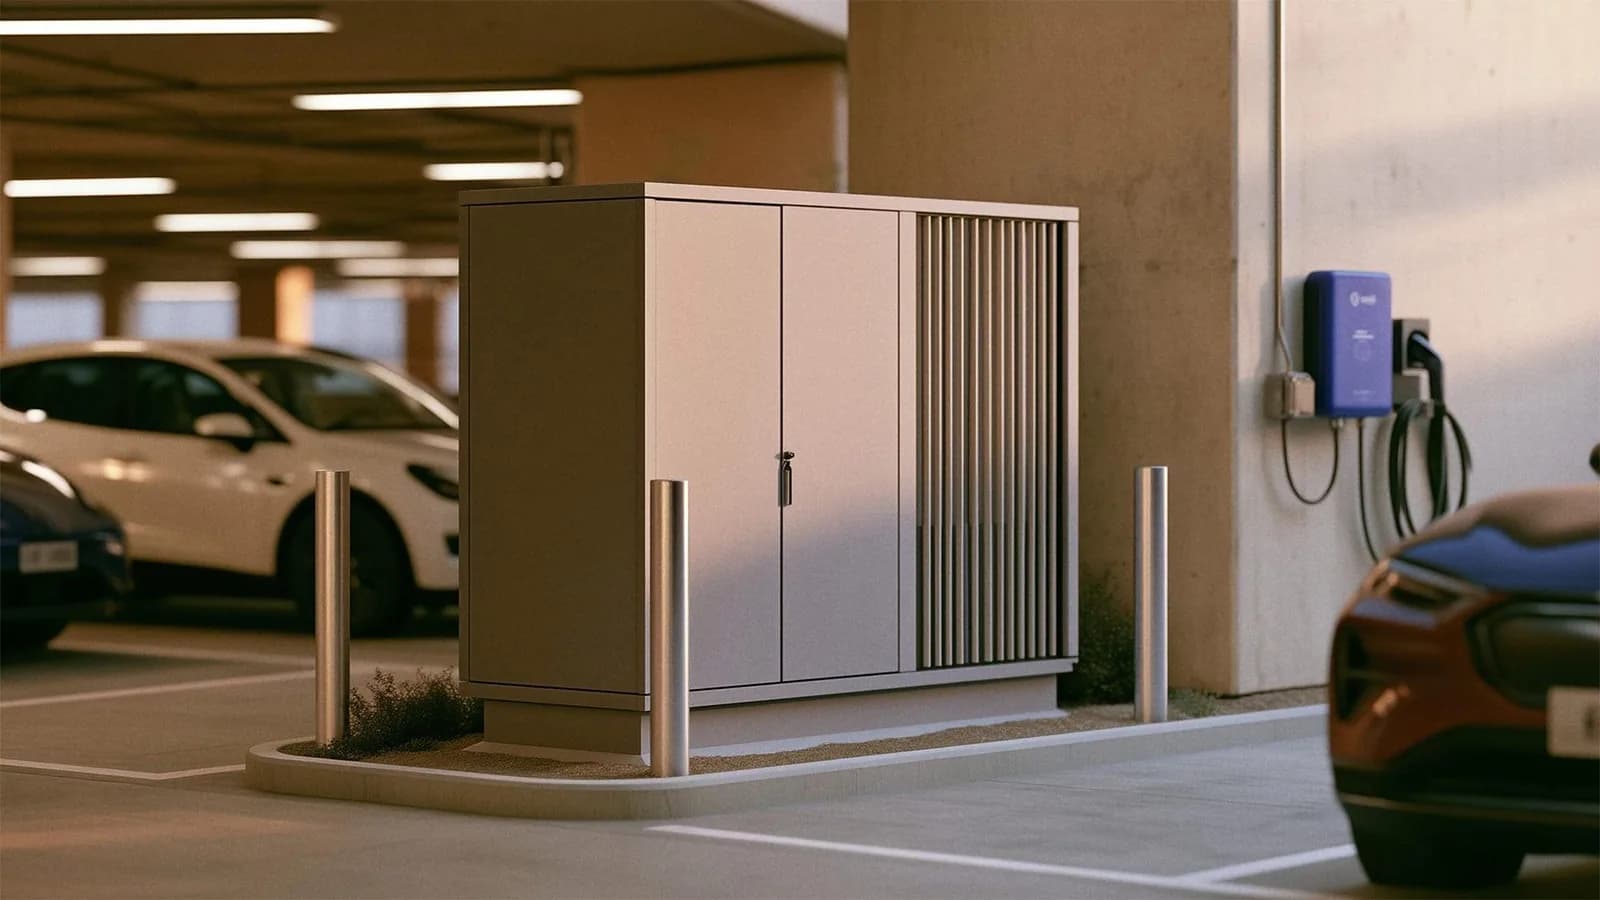
La empresa de carga de vehículos eléctricos diseñó gabinetes con hasta 48 GPU para aprovechar la potencia eléctrica que sus 1.600 estaciones no usan.
La startup de Brooklyn dice que Beam iguala a GLM-5.2 de Z.ai en razonamiento con 3 a 4 veces menos cómputo de inferencia, y promete liberar los pesos este mes.
La compañía compara su Ryzen AI Max+ Pro 495 con un Core Ultra de Intel y dice haber despachado más de medio millón de PC agénticos.
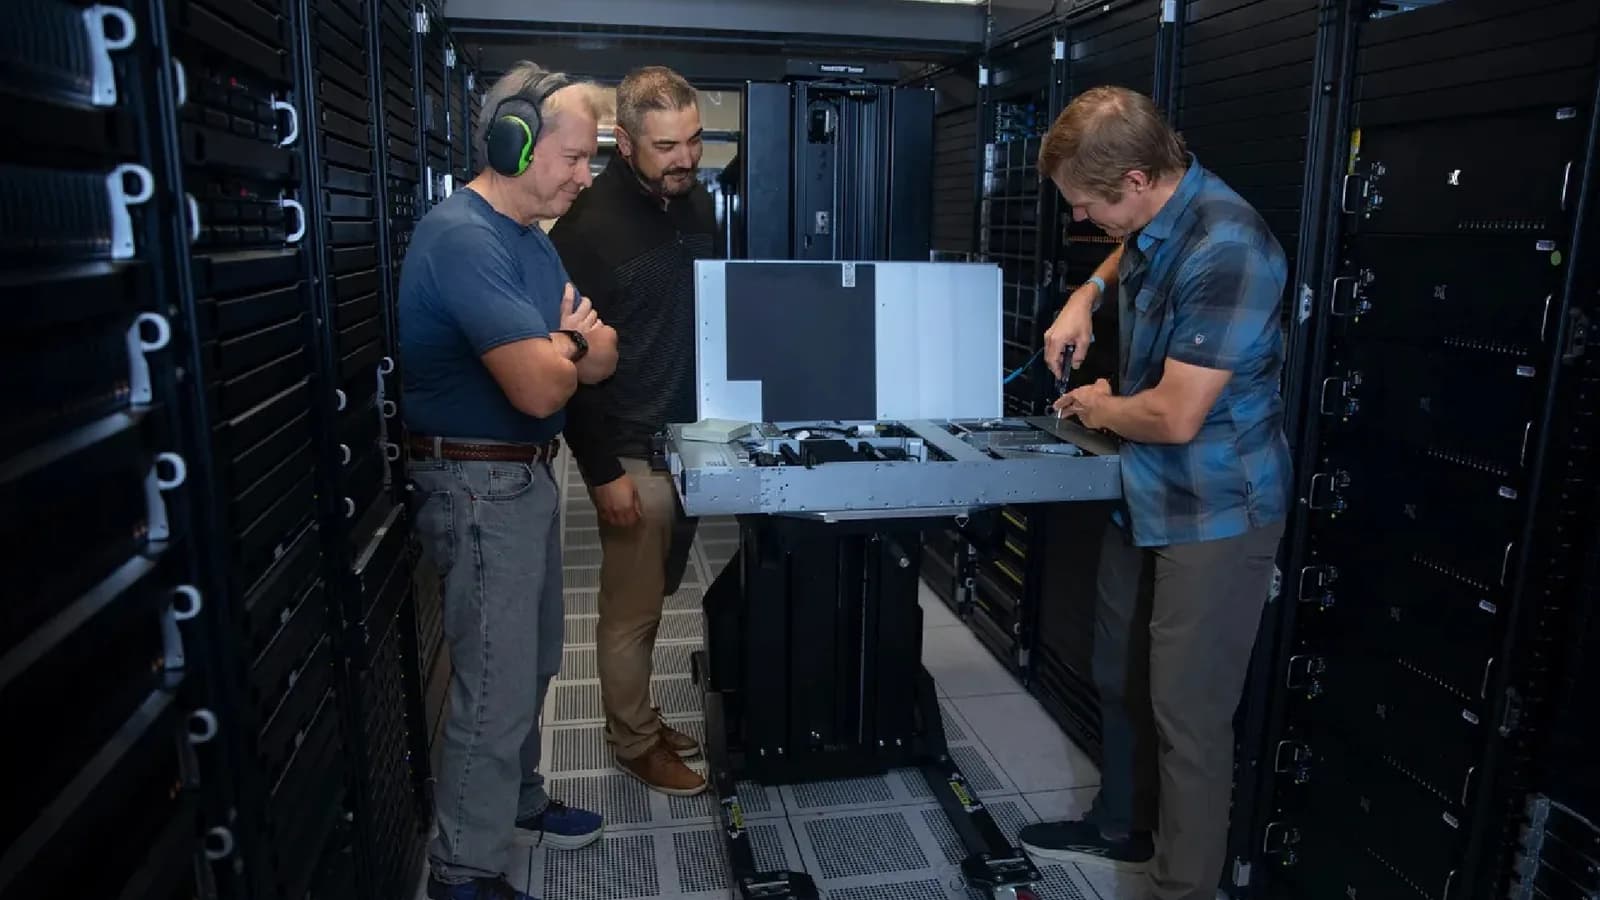
El laboratorio instaló un servidor con dos Vera de 88 núcleos en su banco de pruebas Darwin, antesala de los supercomputadores Mission, Vision y Veritas.
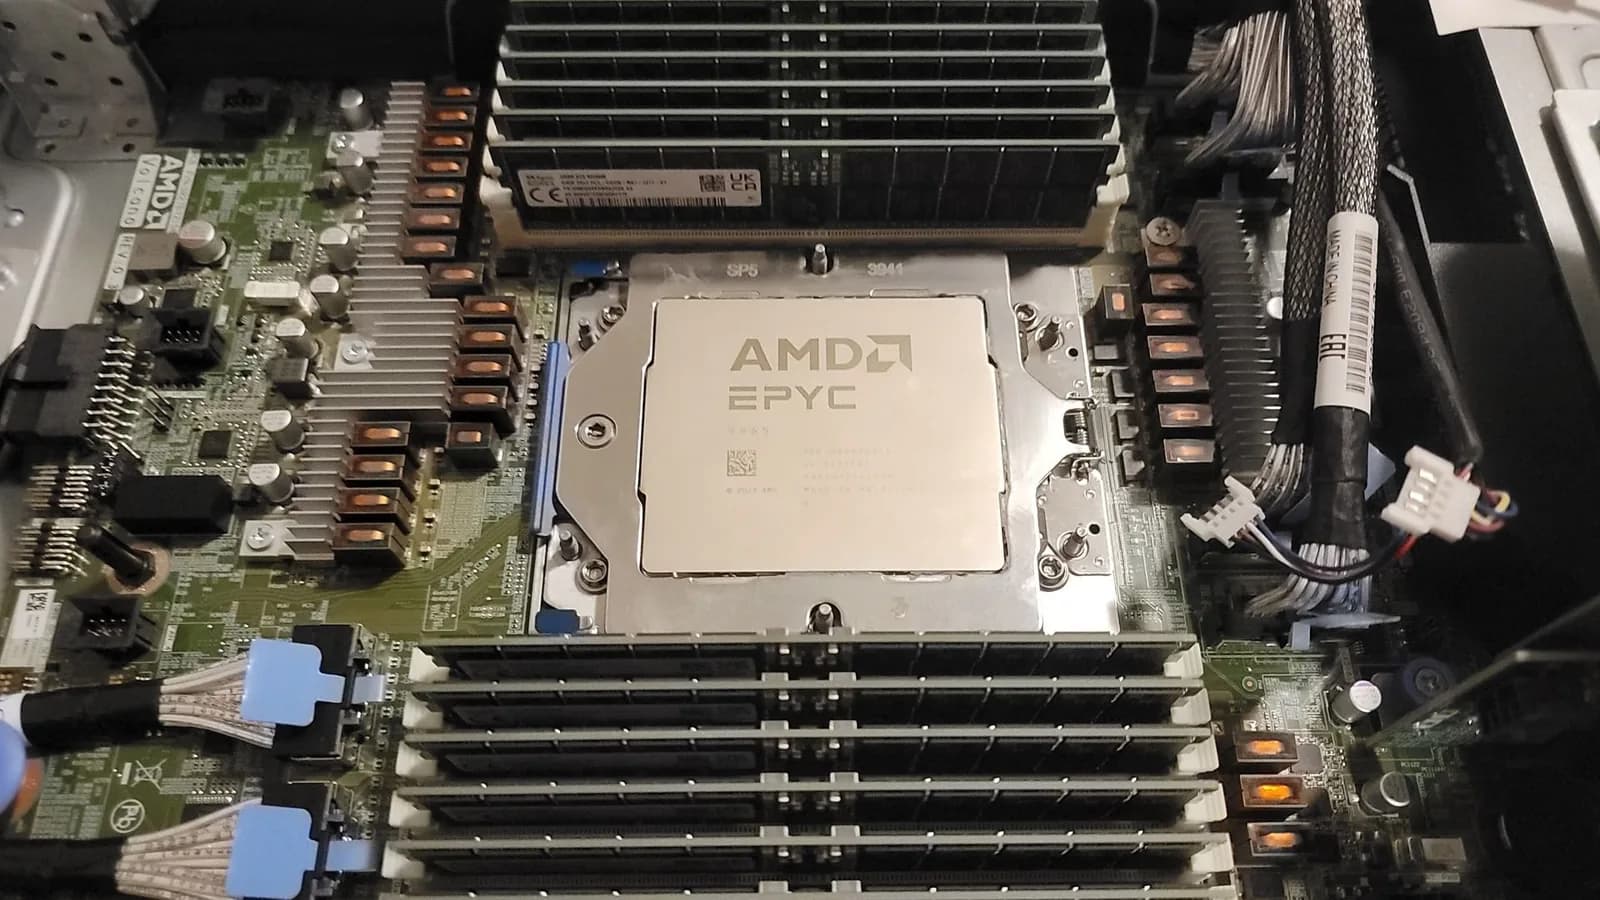
Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que eligió Turin por madurez y que Vera, como CPU independiente, todavía está un poco atrás.
El nuevo sistema del Allen Institute for AI triplica el rendimiento de su versión anterior en GPU B300 y será la base del próximo Olmo.
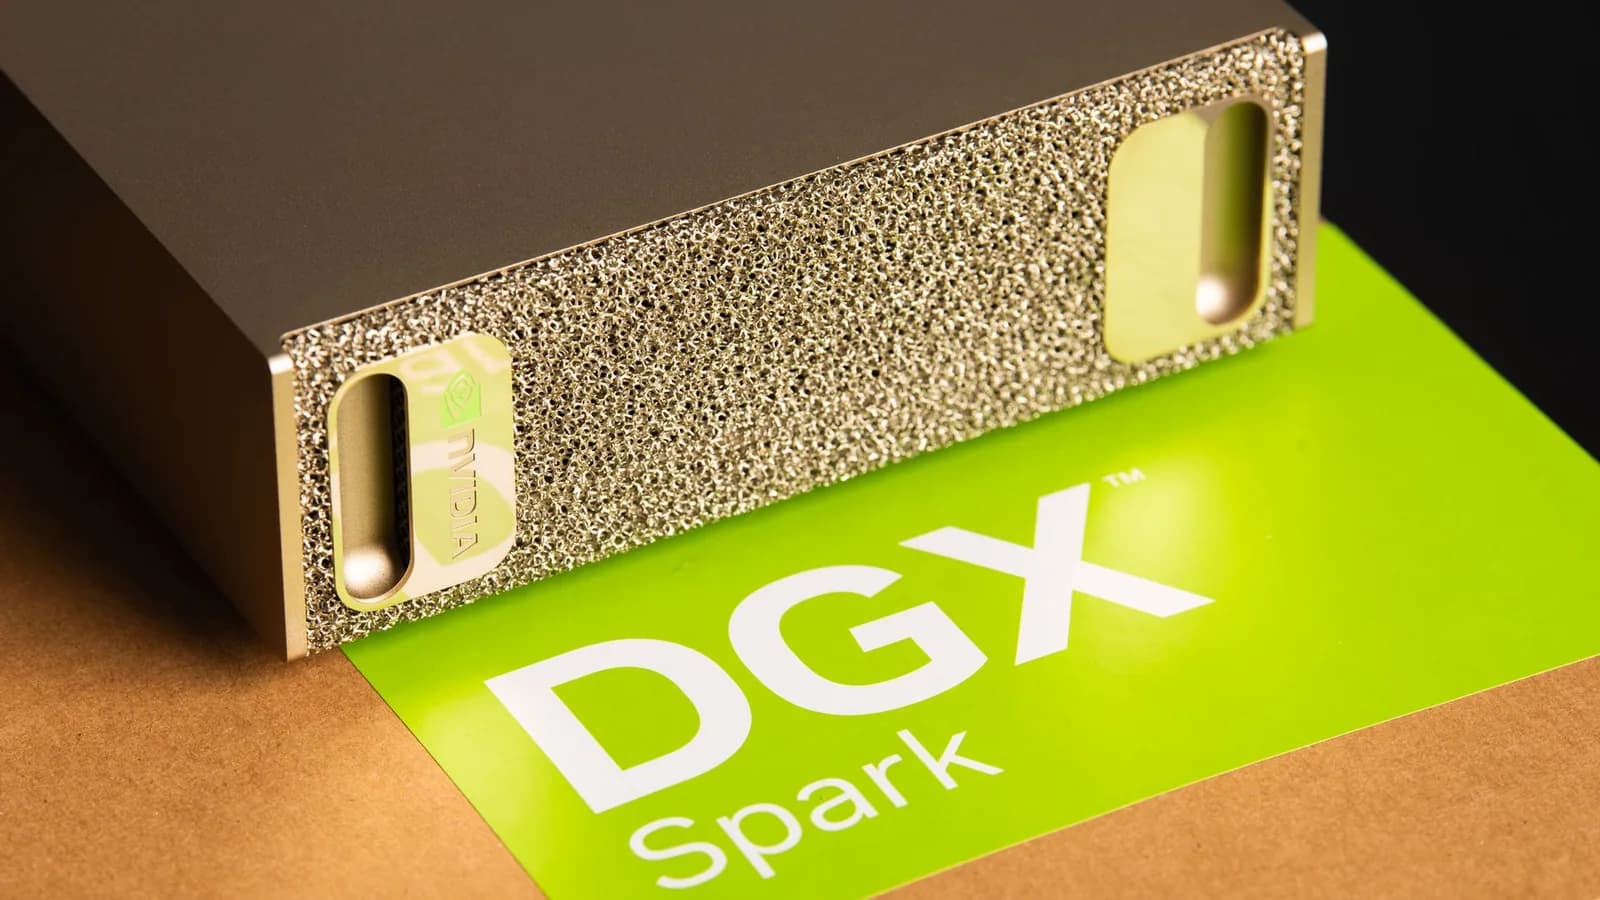
La versión recortada mantiene el GB10, los 273 GB/s de ancho de banda y la tarjeta ConnectX 7 para unir dos equipos.
Google, Nvidia, OpenAI y Architect Labs usan IA para diseñar silicio, pero con grados de autonomía muy distintos, y la arquitectura sigue en manos humanas.
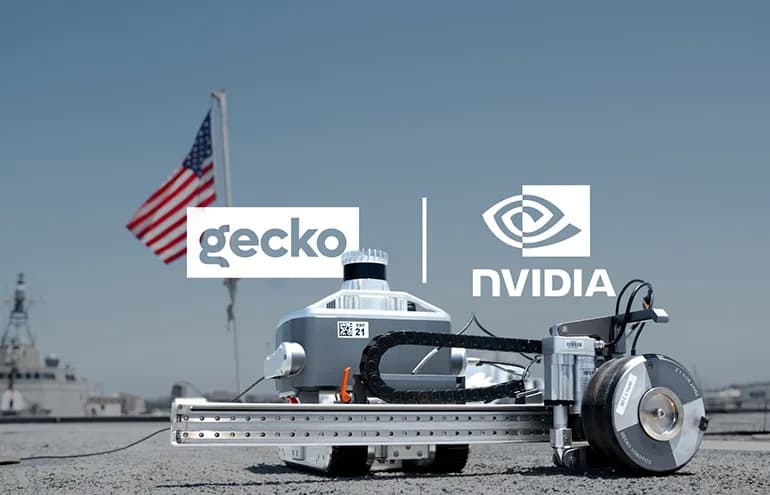
La empresa de robots de inspección usa OpenShell para que sus agentes de IA solo den las órdenes que ya pueden dar sus operadores de terreno.
Richard Ho, jefe de hardware de OpenAI, dijo a Tom's Hardware que el chip es de propósito general y que la demanda interna de cómputo lo ocupará por mucho tiempo.
La empresa agrupa ambas herramientas en su Open Agent Safety Platform y dice tener colaboraciones con Anthropic, Microsoft y Mistral, pero OpenAI no aparece en el anuncio.
El CEO de Nvidia le dijo a Ezra Klein, del New York Times, que los llamados a regular de OpenAI y Anthropic son una distracción y que las leyes vigentes ya alcanzan.
Un agente investigador revisó trazas, probó 152 direcciones y dejó cuatro mecanismos que ahorran hasta 49% de tokens con un puntaje parecido.
Las dos variantes, de 28 y 32 Gbps, figuran como fin de vida. La empresa mueve su producción a los chips de 3 GB que usan las GPU para IA.
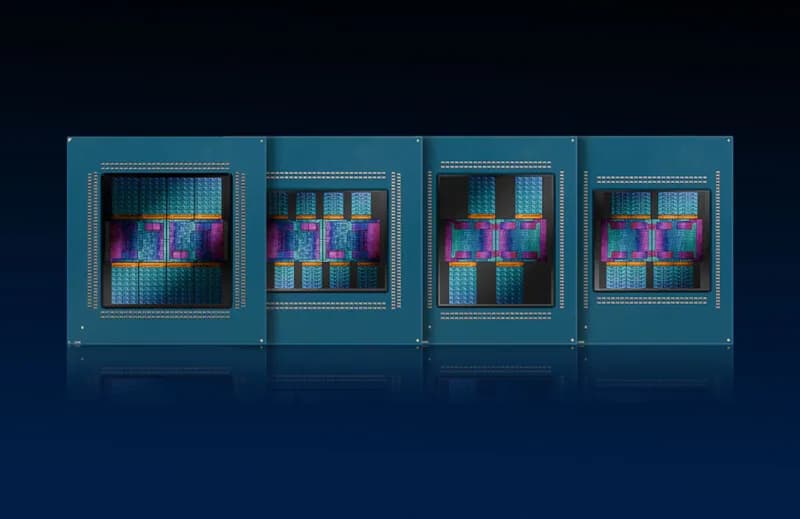
The Register reunió lo que se sabe de Zen 6 en servidores, desde el Venice de 256 núcleos hasta el Verano con LPDDR5x que AMD prepara contra Vera de Nvidia.
La medición corrió sobre DeepSeek-R1 en ocho GPU B200, con el cifrado encendido y apagado, y dejó el sobrecosto de latencia por token bajo el 5%.
NVIDIA aportó a ROS un backend de memoria que deja los datos en la GPU entre nodos, y publicó el paso a paso para migrar un nodo de inferencia ya existente.
Otros temas que aparecen junto a #nvidia en nuestra cobertura editorial.