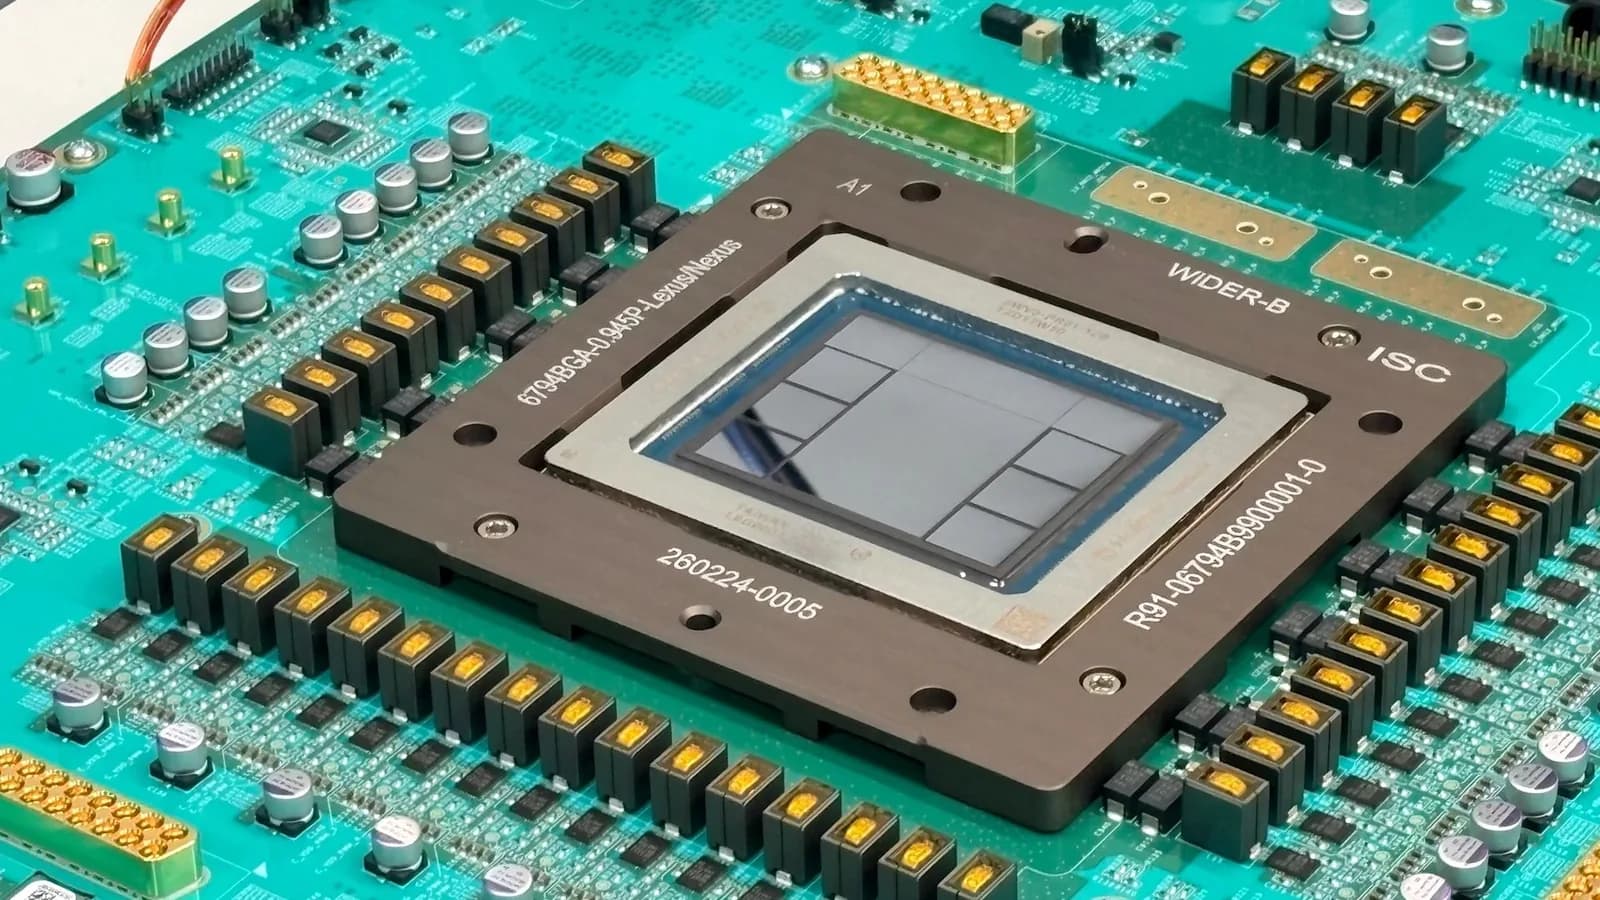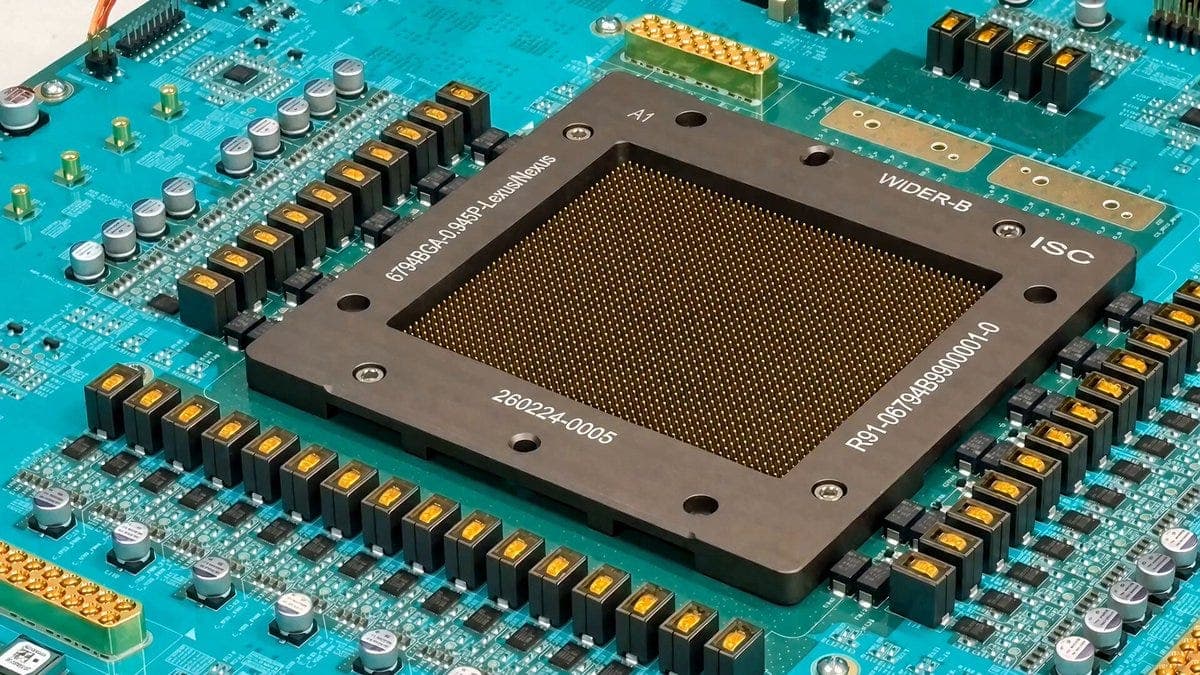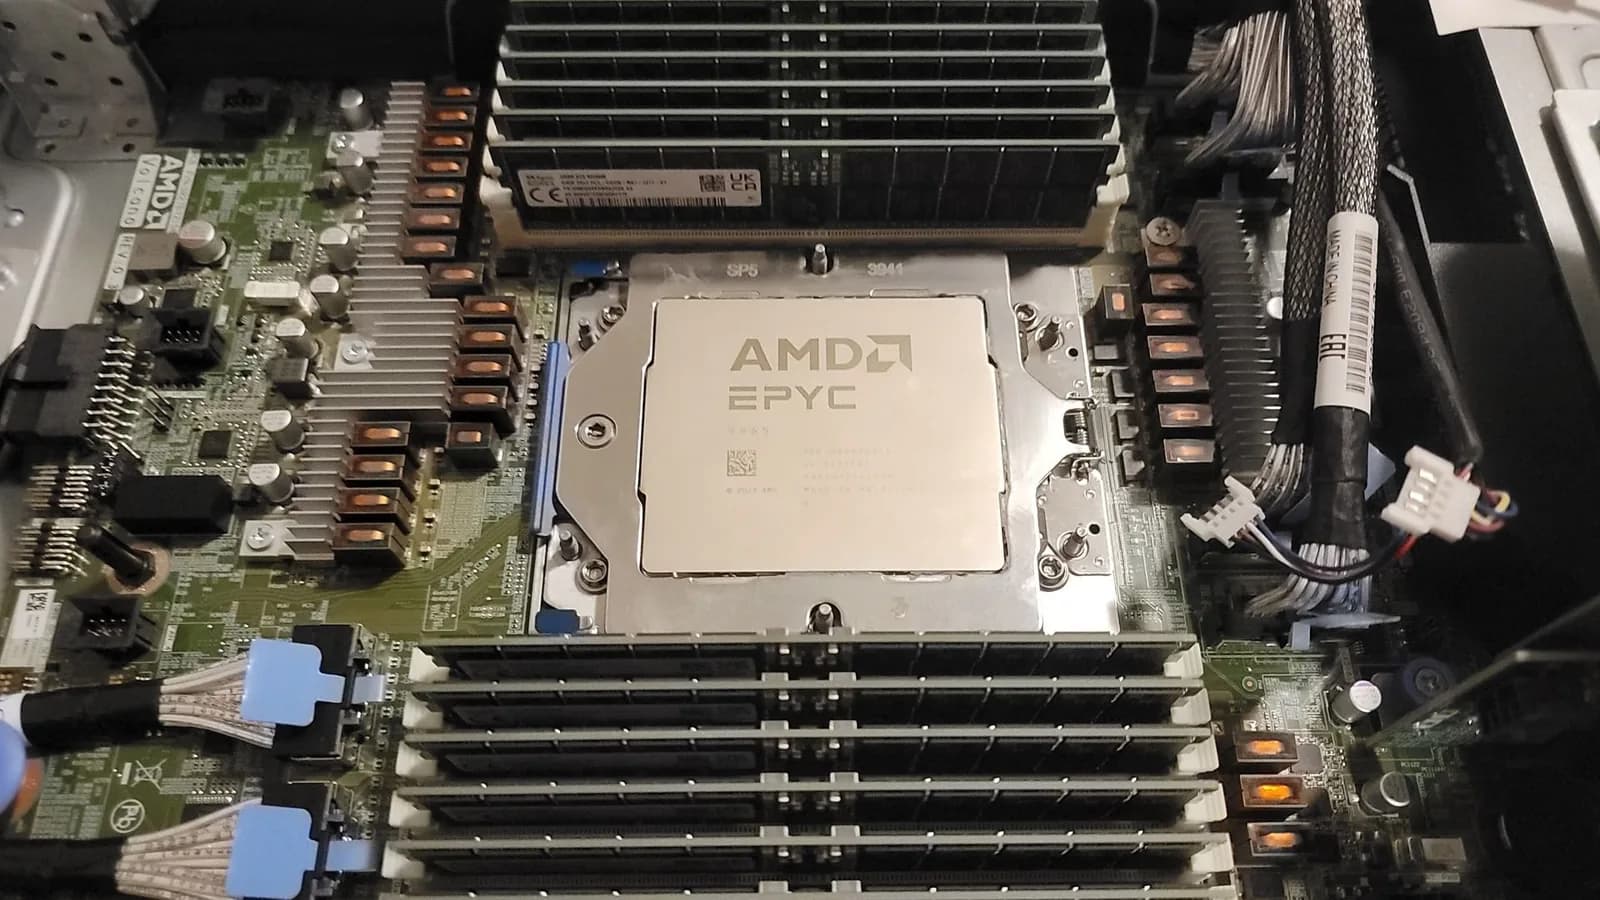
OpenAI despliega su nuevo ASIC Jalapeño dentro de sus propios centros de datos, montado junto a servidores anfitriones con procesadores AMD EPYC Turin, cada uno con 1,5 TB de memoria. El despliegue a escala de rack lo describió SemiAnalysis después de que se presentara el chip, y Tom's Hardware le preguntó por esa elección a Richard Ho, vicepresidente y jefe de hardware de OpenAI.
Ho calificó la decisión de usar Turin como "pragmática". De la nueva CPU Vera de Nvidia dijo que está "un poco atrás... en ese nivel de madurez".
"La forma en que abordamos ese diseño fue pensando en reducir riesgos y en poder hacerlo rápido. Vera, como pieza independiente, está un poco atrás en ese nivel de madurez. El dispositivo Turin es sólido. Hizo lo que necesitábamos, y en parte nuestros socios ya tenían experiencia con él", dijo Ho a Tom's Hardware Premium.
"Para el programa Jalapeño intentamos tomar decisiones muy pragmáticas. Queríamos ser agresivos en las metas de rendimiento y de costo, pero no queríamos asumir riesgos innecesarios. Nos pareció una buena decisión de diseño, que cabía dentro de los parámetros con los que tomamos estas decisiones."
¿Por qué la pregunta apuntaba a Arm?
En el mercado hay muchas CPU basadas en Arm, varias de ellas desplegadas dentro de los grandes proveedores de nube, como Axiom de Google Cloud y Graviton de AWS. Vera y la CPU AGI de Arm se presentan además como "CPU agénticas", que en teoría aceleran el razonamiento de los bucles de agentes mejor que sus equivalentes x86 de AMD e Intel. Tom's Hardware le planteó a Ho esa dinámica y le preguntó por qué Turin era la opción correcta, considerando la relación cercana entre OpenAI y Nvidia. La respuesta fue la cita de arriba.
Arm lleva años defendiendo la arquitectura AArch64 frente a x86, al punto de afirmar que su CPU AGI rinde más del doble que las plataformas x86 actuales. Esa cifra sale de estimaciones internas, no de pruebas reales. La empresa se muestra optimista con la adopción de AGI, aunque incluso con 2.000 millones de dólares en compromisos, los analistas calculan que su penetración de mercado seguirá en un dígito bajo después de dos años.
Lo que muestran los números de Vera
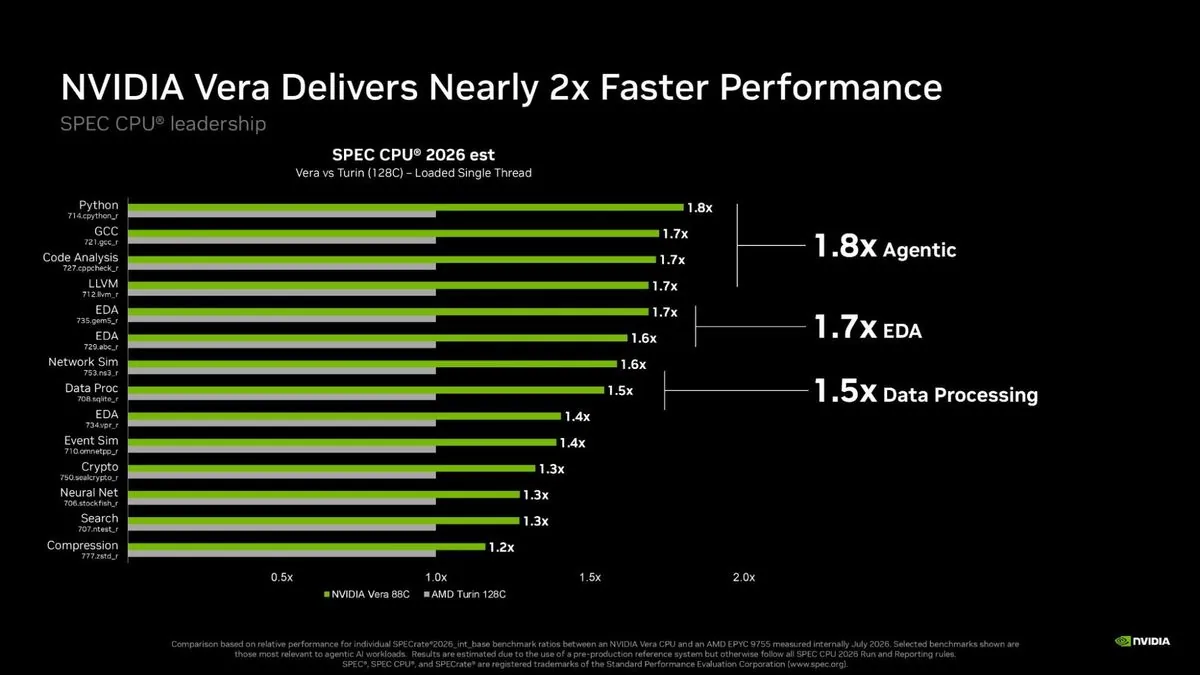
Con la explosión de la demanda de CPU para servidores este año y la evolución de las cargas agénticas, Nvidia ha llevado la delantera en el mensaje y compara su Vera, basada en Arm, con la competencia x86. Asegura una mejora de 1,8 veces sobre un chip AMD Turin, pero esa cifra sale de dividir el puntaje total de SPEC CPU 2026 por núcleo. En el puntaje global, Vera queda apenas 3% por delante del AMD EPYC 9755.
Muchos diseños Arm semipersonalizados, desde Graviton hasta Cobalt de Azure, se han enfocado en la densidad de núcleos y la eficiencia para cargas de nube. Vera y AGI cambian el discurso hacia el rendimiento máximo. En las primeras pruebas, la CPU de Nvidia se ve bien, aunque todavía no se la ha visto en una variedad amplia de cargas, y menos comparada con los próximos AMD Venice o con Diamond Rapids de Intel.
Lo llamativo de la elección de Turin es que OpenAI es uno de los socios de despliegue de Arm para AGI, y también figura entre los clientes que están "explorando la CPU Vera", según Nvidia. OpenAI, los otros laboratorios de frontera y los proveedores de nube mantienen una flota de hardware muy variada. Emparejar Jalapeño específicamente con Turin respondió a reducir el riesgo, y Ho apuntó a la madurez de la plataforma.
x86 contra AArch64, y lo que no dijo Ho
En términos generales, x86_64 es más maduro que AArch64. Arm existe desde mediados de los años 80, pero su extensión de 64 bits llegó 12 años después que la de x86. Y aunque Arm se ha ganado un lugar en los centros de datos durante las últimas dos décadas, la base de x86 se remonta a varias décadas más.
Los comentarios de Ho no apuntaban a la diferencia entre AArch64 y x86. Se referían a Turin frente a Vera, que es el primer núcleo de CPU propio de Nvidia para centros de datos. Las primeras pruebas de Vera son buenas, pero igual representaba un riesgo innecesario para el despliegue de Jalapeño a escala de rack.
Que los socios de OpenAI ya tuvieran experiencia con Turin también muestra cómo pensaba el equipo de hardware. Hay diferencias prácticas de mantenimiento entre ambos. Vera va soldada a la placa, mientras que los chips Turin van en zócalo. En un servidor rara vez se cambia el procesador. Con Turin, hacerlo es más fácil.
Como OpenAI tiene una flota de hardware disponible, es posible que en el futuro Jalapeño se despliegue con otro sistema anfitrión, por ejemplo con AGI de Arm o con Vera de Nvidia. Por ahora, el anfitrión es Turin.