Investigadores de Carnegie Mellon University, New York University, Stanford University y el MIT presentaron Ataraxos, una IA para Stratego, en un paper publicado en Nature. Según los autores, es la primera IA que alcanza un rendimiento sobrehumano en ese juego de tablero. En una serie oficial de 20 partidas venció al neerlandés Pim Niemeijer con 15 triunfos, una derrota y cuatro empates. El entrenamiento costó menos de 8.000 dólares, informó The Decoder.
Niemeijer es el jugador con más títulos en la historia del juego. Ganó cuatro campeonatos mundiales, 15 títulos nacionales de Países Bajos y dos mundiales en línea, y pasó más de 600 semanas en el primer lugar del ranking mundial. George Franka, el único jugador que compitió en todos los mundiales desde 1997, lo llama "el mejor jugador de Stratego de todos los tiempos".
¿Por qué Stratego era tan difícil para una IA?
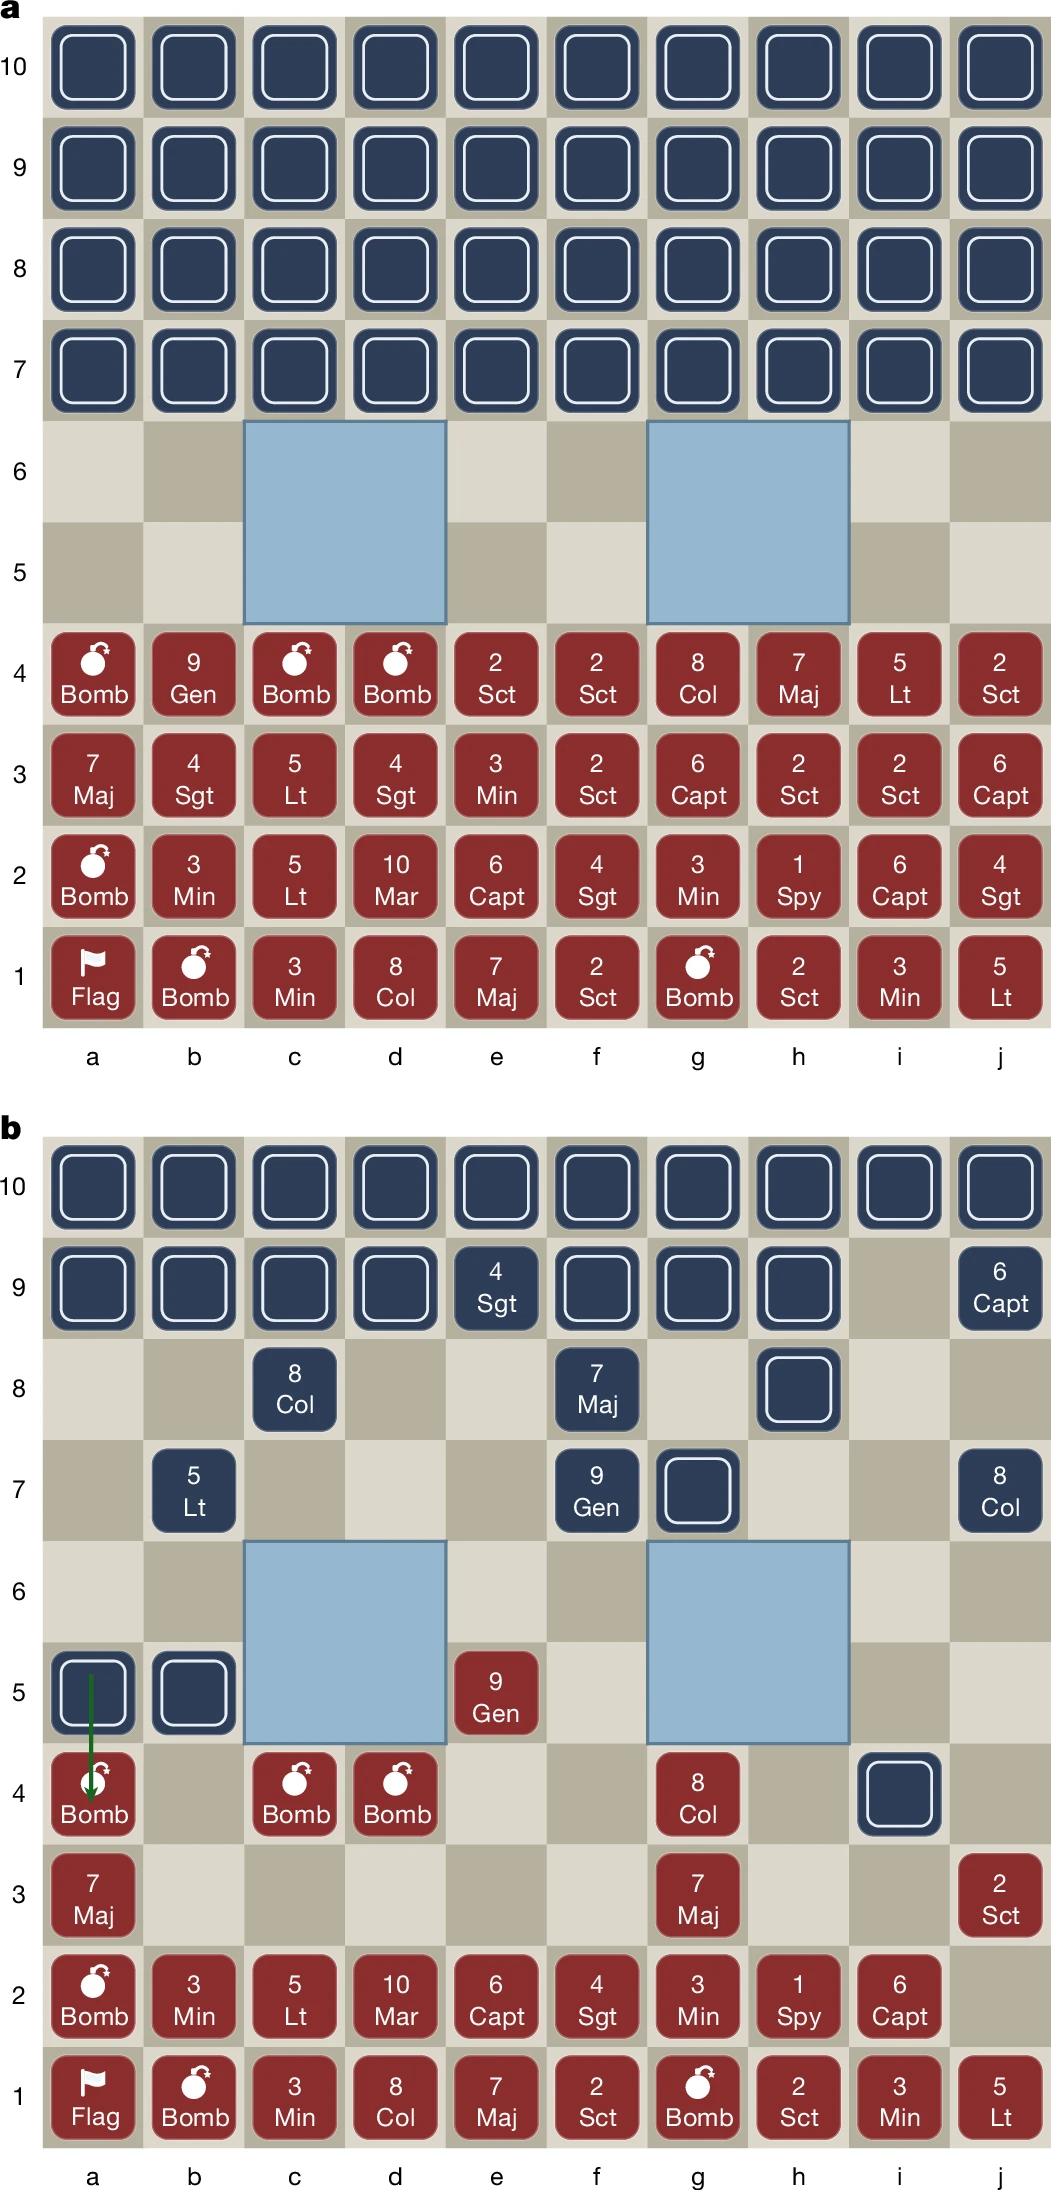
En Stratego cada jugador ordena sus 40 piezas boca abajo. El paper calcula más de 10^33 disposiciones iniciales posibles. El rango de una pieza se revela solo cuando choca con una pieza rival, y gana quien captura la bandera del oponente.
En un juego con información imperfecta como este, el valor de una jugada no depende solo de cómo sigue la partida. También pesa lo que pasó antes y durante la decisión, escribió en X Samuel Sokota, primer autor del trabajo.
Según Sokota, los métodos derivados de las IA de póker sí resolvían ese problema, pero únicamente cuando había poca información oculta. En Texas Hold'em hay apenas 1.326 manos iniciales posibles, y de acuerdo con el paper el esfuerzo de cómputo de esos métodos crece con la cantidad de información escondida. Por eso Stratego seguía siendo uno de los últimos grandes juegos de tablero competitivos donde los humanos le ganaban a la IA.
Un presupuesto universitario contra los millones de DeepMind
DeepMind ya había intentado superar a los mejores jugadores humanos en este juego y no lo logró. Según el paper, su sistema DeepNash entrenó en 1.024 nodos TPU durante dos a tres meses, de acuerdo con lo que recuerda el autor responsable de DeepNash. Los autores de Ataraxos estiman que eso costaría entre 3 y 4,5 millones de dólares a precios de 2025.
Ataraxos necesitó una semana en 16 GPU Nvidia H100, más otros cuatro días en cuatro GPU para su llamada red de creencias. A precios de 2025, eso suma menos de 8.000 dólares.
| Sistema | Hardware de entrenamiento | Duración | Costo estimado (precios 2025) |
|---|---|---|---|
| DeepNash (DeepMind) | 1.024 nodos TPU | Dos a tres meses | 3 a 4,5 millones de dólares |
| Ataraxos | 16 GPU H100, más 4 GPU para la red de creencias | Una semana, más cuatro días | Menos de 8.000 dólares |
Los investigadores lo cifran en cerca de 1/500 del costo de cómputo, 1/30 de las partidas de autojuego y 1/100 de los ejemplos de entrenamiento. Atribuyen la diferencia al simulador para GPU que escribieron ellos mismos y a una eficiencia de muestreo mucho mayor. Sokota cuenta que el equipo estaba limitado a recursos de cómputo académicos y fue juntando trucos durante años.
No hay un enfrentamiento directo entre los dos sistemas. Los investigadores dicen que ofrecieron montar la infraestructura necesaria, pero DeepMind les respondió que no era posible porque el código de DeepNash ya no funciona. En el Mundial de 2023, DeepNash ganó 19 de 28 partidas, aunque perdió con la mayoría de los mejores jugadores, Niemeijer incluido.
Obligar a la IA a variar su juego
Ataraxos aprende sin datos humanos, solo jugando contra sí misma. Según el paper, lo determinante es cuánto se presiona al sistema para que varíe su juego. Una condición adicional durante el entrenamiento obliga a la IA a repartir sus disposiciones y sus movimientos en vez de fijarse temprano en una estrategia. Esa técnica se llama regularización. En Stratego importa porque jugar bien exige mucha aleatoriedad, explican los autores, y el jugador predecible termina explotado.
Los investigadores aflojan esa presión a medida que avanza el entrenamiento y ajustan el tamaño de los pasos de aprendizaje en la misma medida. Al principio Ataraxos varía mucho su juego y aprende a saltos grandes. Más adelante juega de forma más deliberada y solo hace correcciones pequeñas. Así el aprendizaje no entra en círculos ni se vuelve caótico, algo que suele pasar en juegos con información imperfecta.
Los autores comparan la regularización con una reserva de energía. Si la IA la quema demasiado rápido, avanza mucho al principio, después pierde la capacidad de seguir aprendiendo y muchas veces queda fácil de explotar.
Ataraxos usa además una red de creencias que predice cuáles son las piezas ocultas del rival. Antes de cada jugada, la IA genera con ella estados posibles del tablero, simula las jugadas candidatas y corre un paso de aprendizaje extra solo para esa decisión. Según los autores, los trabajos anteriores se saltaban este tipo de búsqueda porque se consideraba demasiado difícil con tanta información escondida.
Ganó con una desventaja de fábrica
Los investigadores repartieron la serie contra Niemeijer en tres semanas para evitar el cansancio y darle tiempo de prepararse. Niemeijer sabía que Ataraxos no iba a adaptarse a su estilo. Recibió 1.000 dólares por participar, más 100 dólares por triunfo y 50 por empate, así que tenía un motivo económico para jugar al máximo.
Contando los empates como medio triunfo, la tasa efectiva de victorias fue de 85%, un resultado sin precedentes en el nivel más alto, escriben los autores. Max Roelofs, tres veces subcampeón mundial, explica que los márgenes en la cima son mínimos porque el juego obliga a correr riesgos.
La IA además jugó con una desventaja estructural. Niemeijer podía ajustarse a ella a lo largo de muchas partidas y ella no podía ajustarse a él. Según el paper, Vincent de Boer, tres veces campeón mundial, lo considera una desventaja importante.
En una exhibición durante el Mundial de Stratego de 2025, Ataraxos ganó además 38 de 40 partidas contra jugadores de torneo. Los jugadores describen su estilo como difícil de leer. La IA lanza faroles que un humano consideraría demasiado arriesgados y, cuando va perdiendo, alarga la partida con tanta terquedad que a algunos jugadores les parece de mala educación. También parece tener una suerte casi inquietante, porque sus piezas siempre están justo en el lugar correcto. Las partidas contra Niemeijer están publicadas en línea.
El método sirve fuera de Stratego
Los investigadores usaron el mismo método para construir otros sistemas.
- En la variante Barrage Stratego, su IA ganó cuatro series de 50 partidas contra tres de los cuatro mejores jugadores del ranking, todos bicampeones mundiales de Barrage.
- En el juego de cartas cooperativo Hanabi fijó récords nuevos en todas las variantes, y en la versión de dos jugadores necesitó dos órdenes de magnitud menos de cómputo que el líder anterior.
- En el juego de cartas chino Dou dizhu venció a PerfectDou y DouZero, los sistemas de referencia hasta ahora.
Los autores sacan una conclusión amplia de estos resultados. Sostienen que una gran cantidad de información oculta ya no es un obstáculo para el aprendizaje por refuerzo y la búsqueda. Eso pondría la IA práctica al alcance de muchos problemas de decisión estratégica, siempre que se puedan construir simuladores rápidos y precisos para ellos. El paper menciona los mercados financieros, los conflictos militares y las negociaciones como ejemplos de situaciones con información imperfecta.
Los investigadores reconocen una limitación. Como la búsqueda imita un solo paso de aprendizaje, su rendimiento no mejora indefinidamente con más tiempo de cómputo. Un método de búsqueda más sofisticado podría cambiar eso. El equipo liberó el código de Ataraxos.