
Robótica
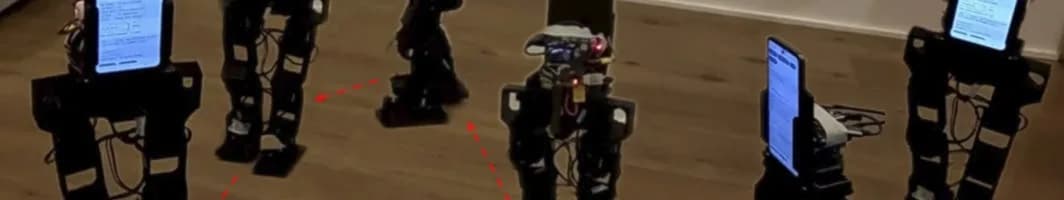
PhoneBot, el humanoide de UCLA que usa un celular viejo como cerebro
El robot de código abierto mide unos 48 cm, cuesta cerca de 400 dólares sin contar el teléfono y camina con un Android de 2017.
Hackster.io
33 notas publicadas
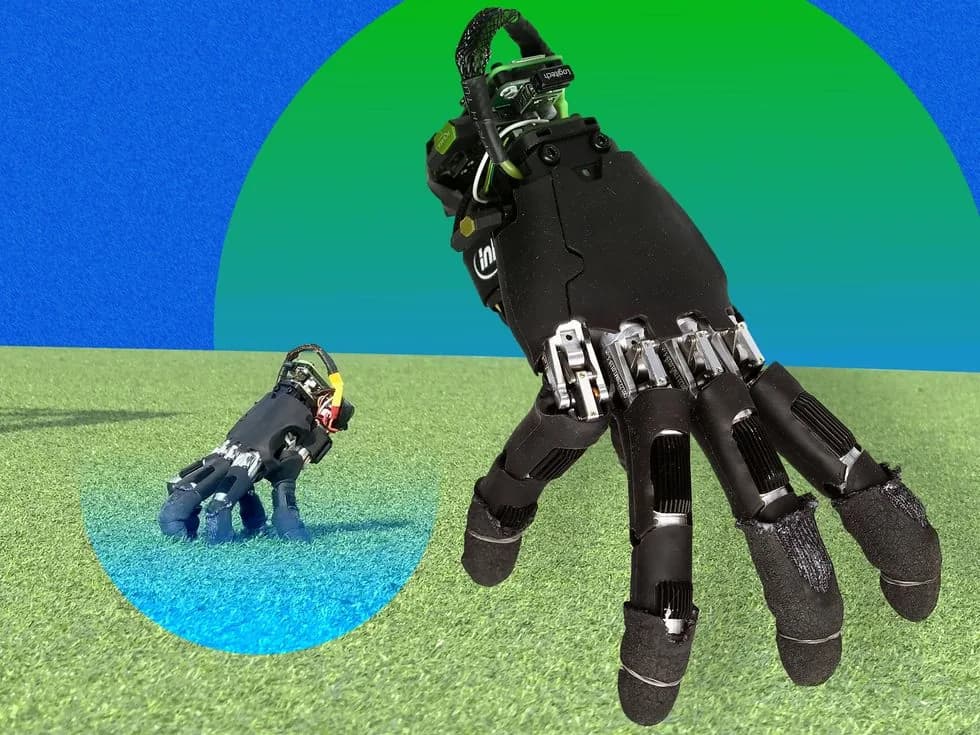
La mano de Wuji Technology lleva una mochila de 80 gramos con una Raspberry Pi Zero, camina a 9 cm/s y además aprieta teclas y empuja objetos.
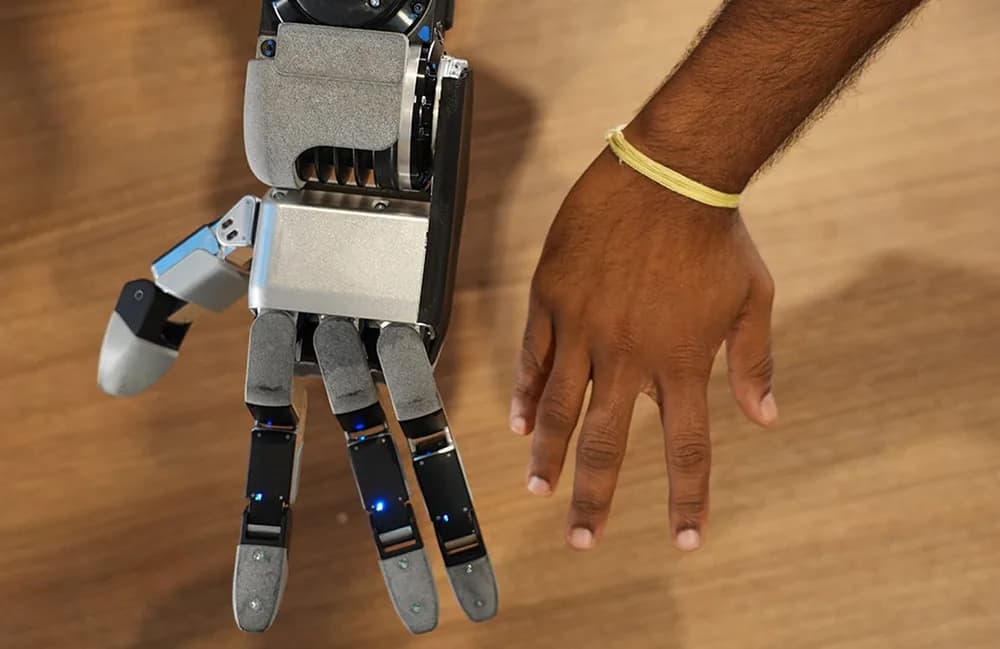
Alberto Rodríguez, director de comportamiento del Atlas, detalla los 13 actuadores idénticos, el pulgar doble descartado y el entrenamiento en simulación.
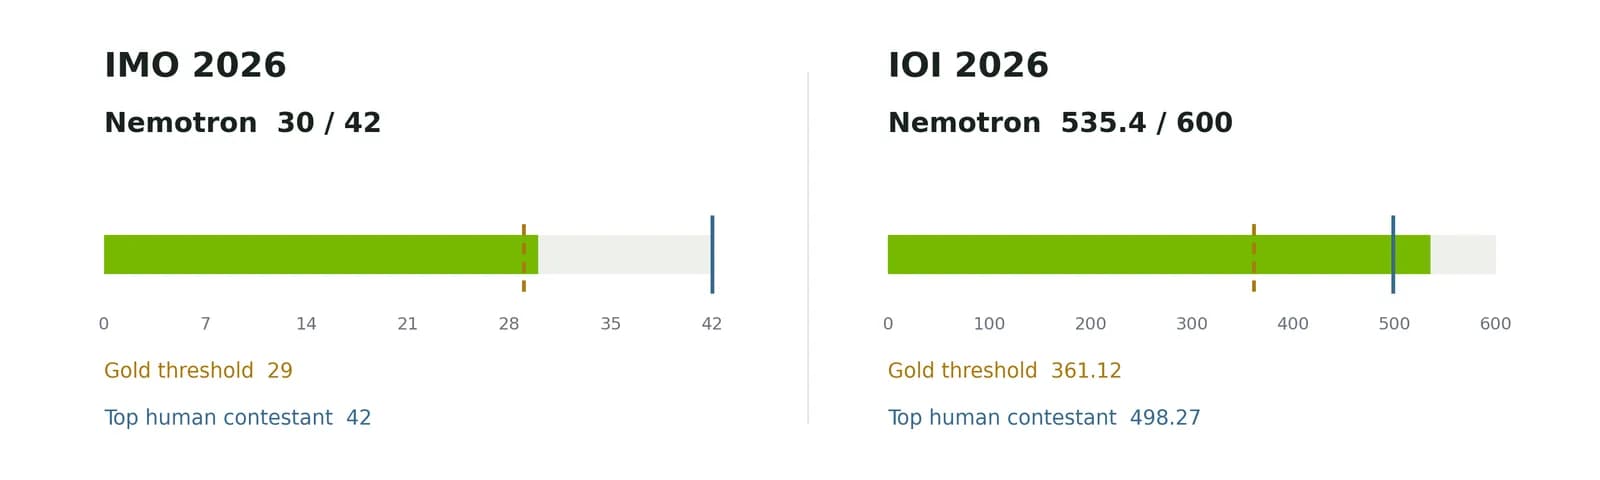
NVIDIA especializó su familia Nemotron 3 con ajuste fino y aprendizaje por refuerzo, y liberó en Hugging Face los modelos, los datos y las recetas.
El robot bípedo debutó en IROS 2026 con una demostración en la que el público podía empujarlo y patearlo para ver cómo recupera el equilibrio.
Investigadores de Carnegie Mellon, NYU, Stanford y MIT entrenaron el sistema por menos de 8.000 dólares y vencieron a Pim Niemeijer 15 a 1.
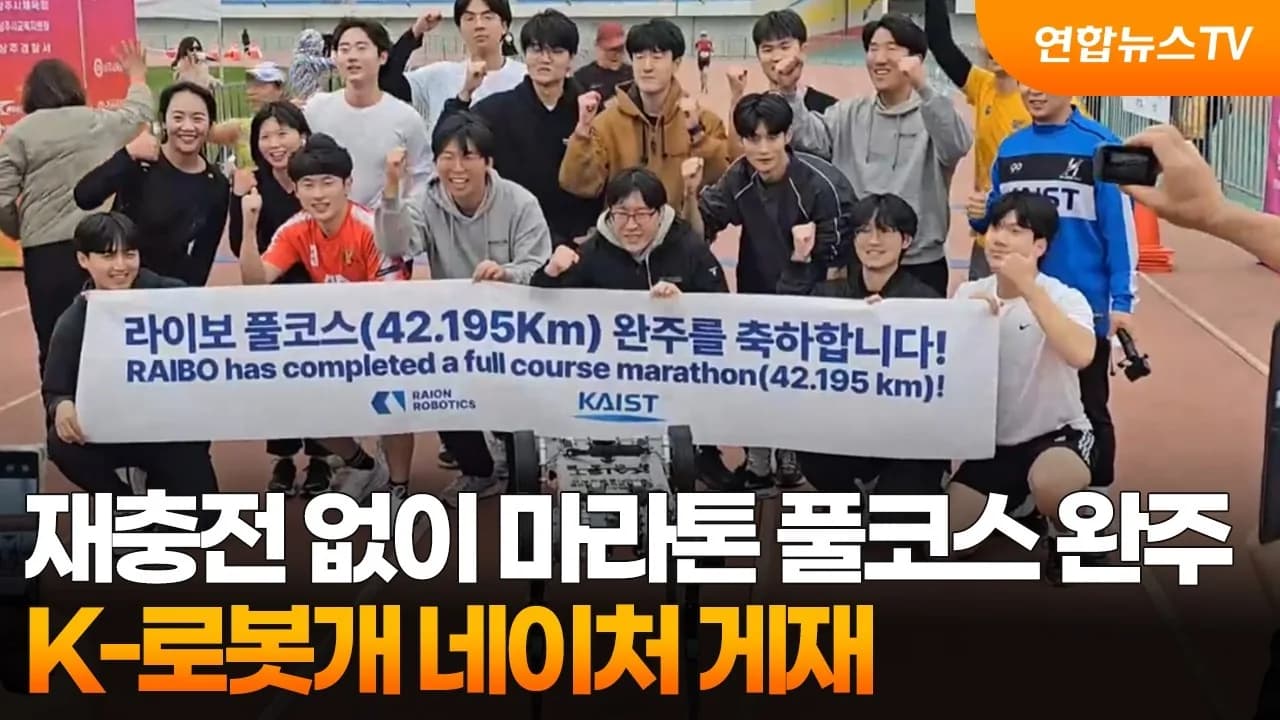
El cuadrúpedo del KAIST terminó la Maratón de Sangju en 4 horas, 19 minutos y 52 segundos, y gastó menos energía por kilo y kilómetro que un corredor humano promedio.
Jackson Kernion, que trabaja en el ajuste fino de Claude, dice que los modelos aprendieron a escribir para otras IA y que Opus 4.6 fue el último bueno para redactar.
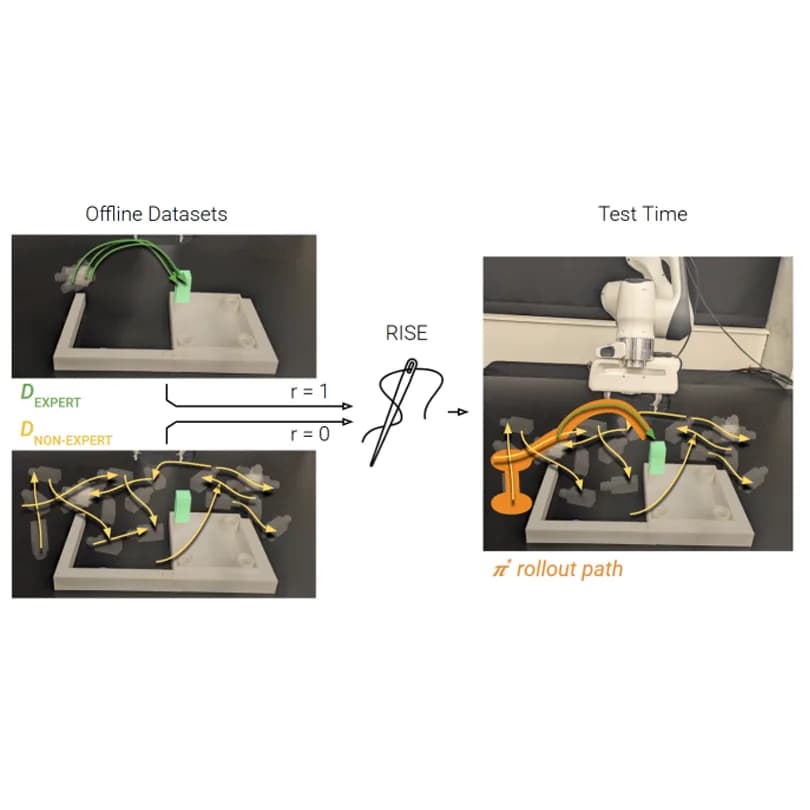
El instituto propone usar aprendizaje por refuerzo fuera de línea para que los datos malos, parciales o de juego libre sirvan igual que los de un operador experto.
El circuito convierte a diario las conversaciones que fallan en producción en datos de entrenamiento, y el modelo especializado terminó superando al de frontera.
MiMo-V2.6-Pro marca 46 puntos en el Intelligence Index, y Anthropic sostiene que Xiaomi extrajo datos de Claude en 400.000 intercambios.
El prototipo del Soft Robotics Lab de ETH Zurich usa los mismos cinco dedos para desplazarse y para apretar teclas, sin cable y sin brazo que lo sostenga.
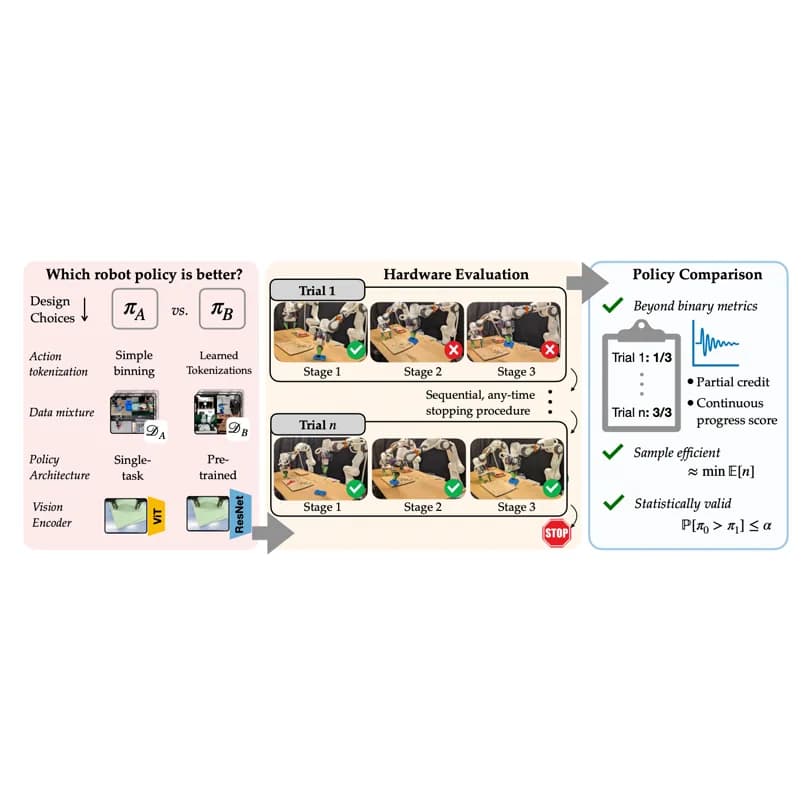
El Toyota Research Institute propone comparar políticas de manipulación con inferencia válida en cualquier momento, y detener el experimento apenas la evidencia alcanza la confianza pedida.
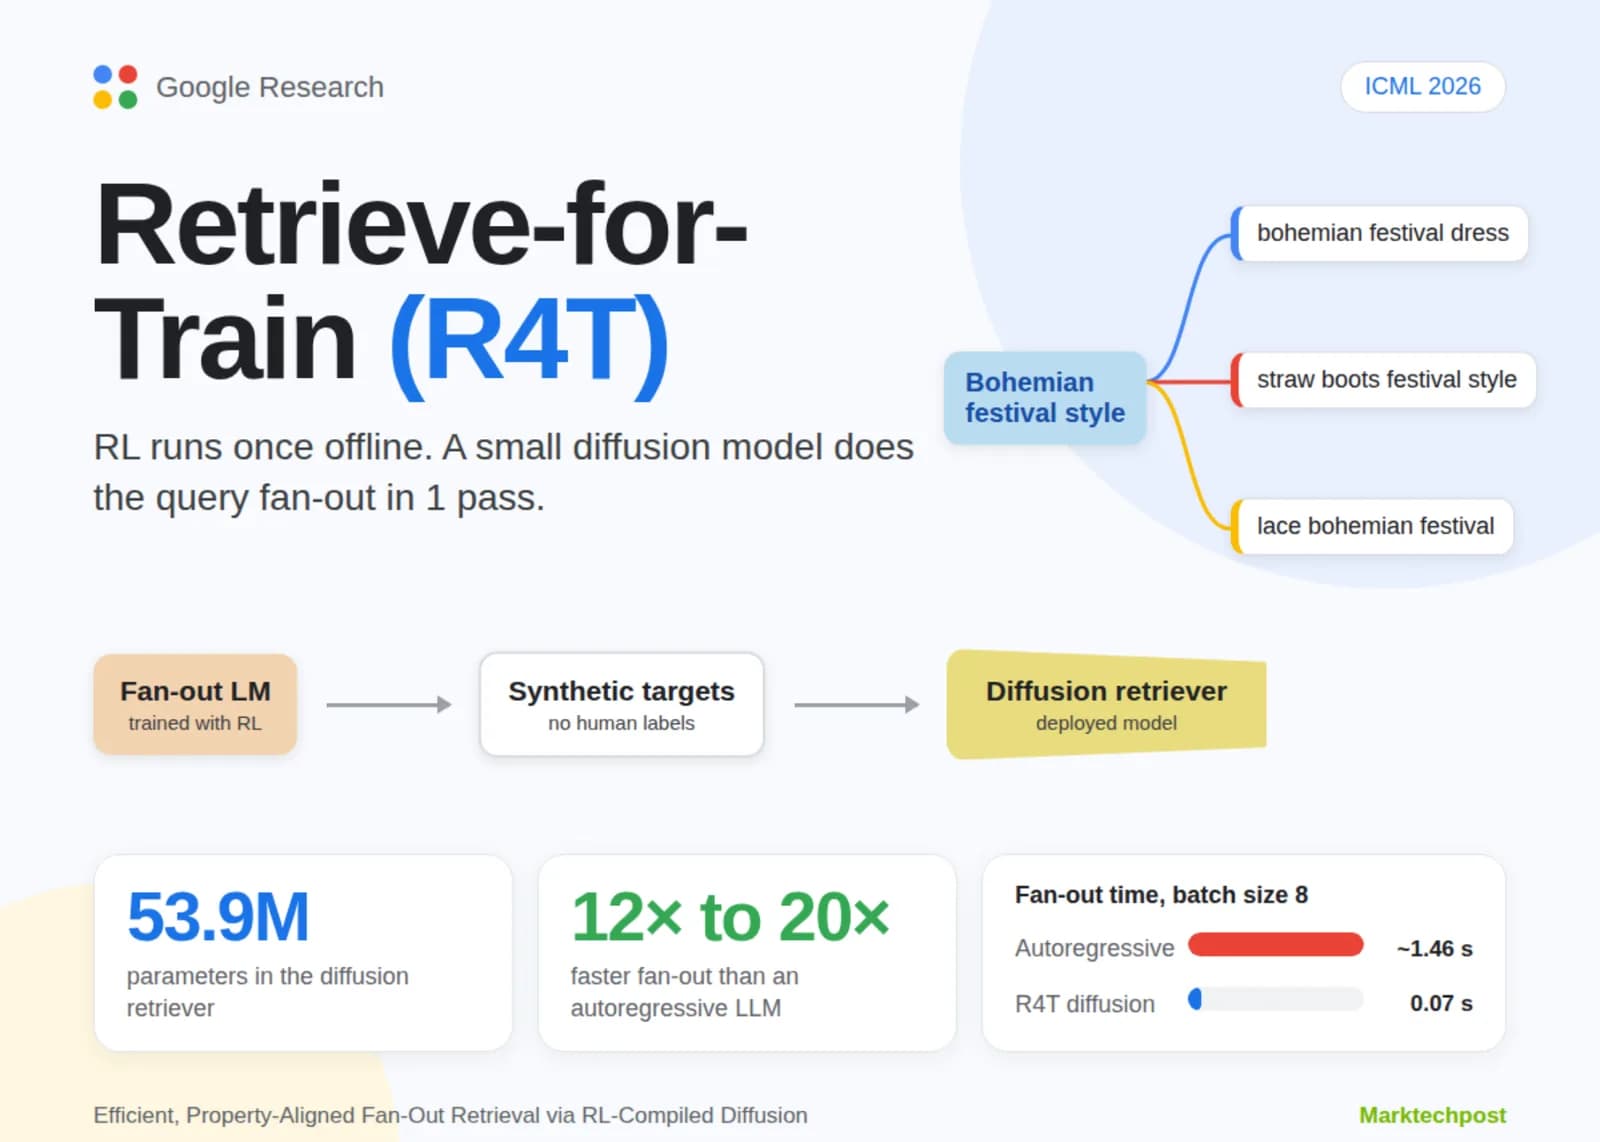
Retrieve-for-Train corre aprendizaje por refuerzo una vez fuera de línea y destila esa conducta en un modelo de difusión de 53,9 millones de parámetros que genera las subconsultas en una pasada.
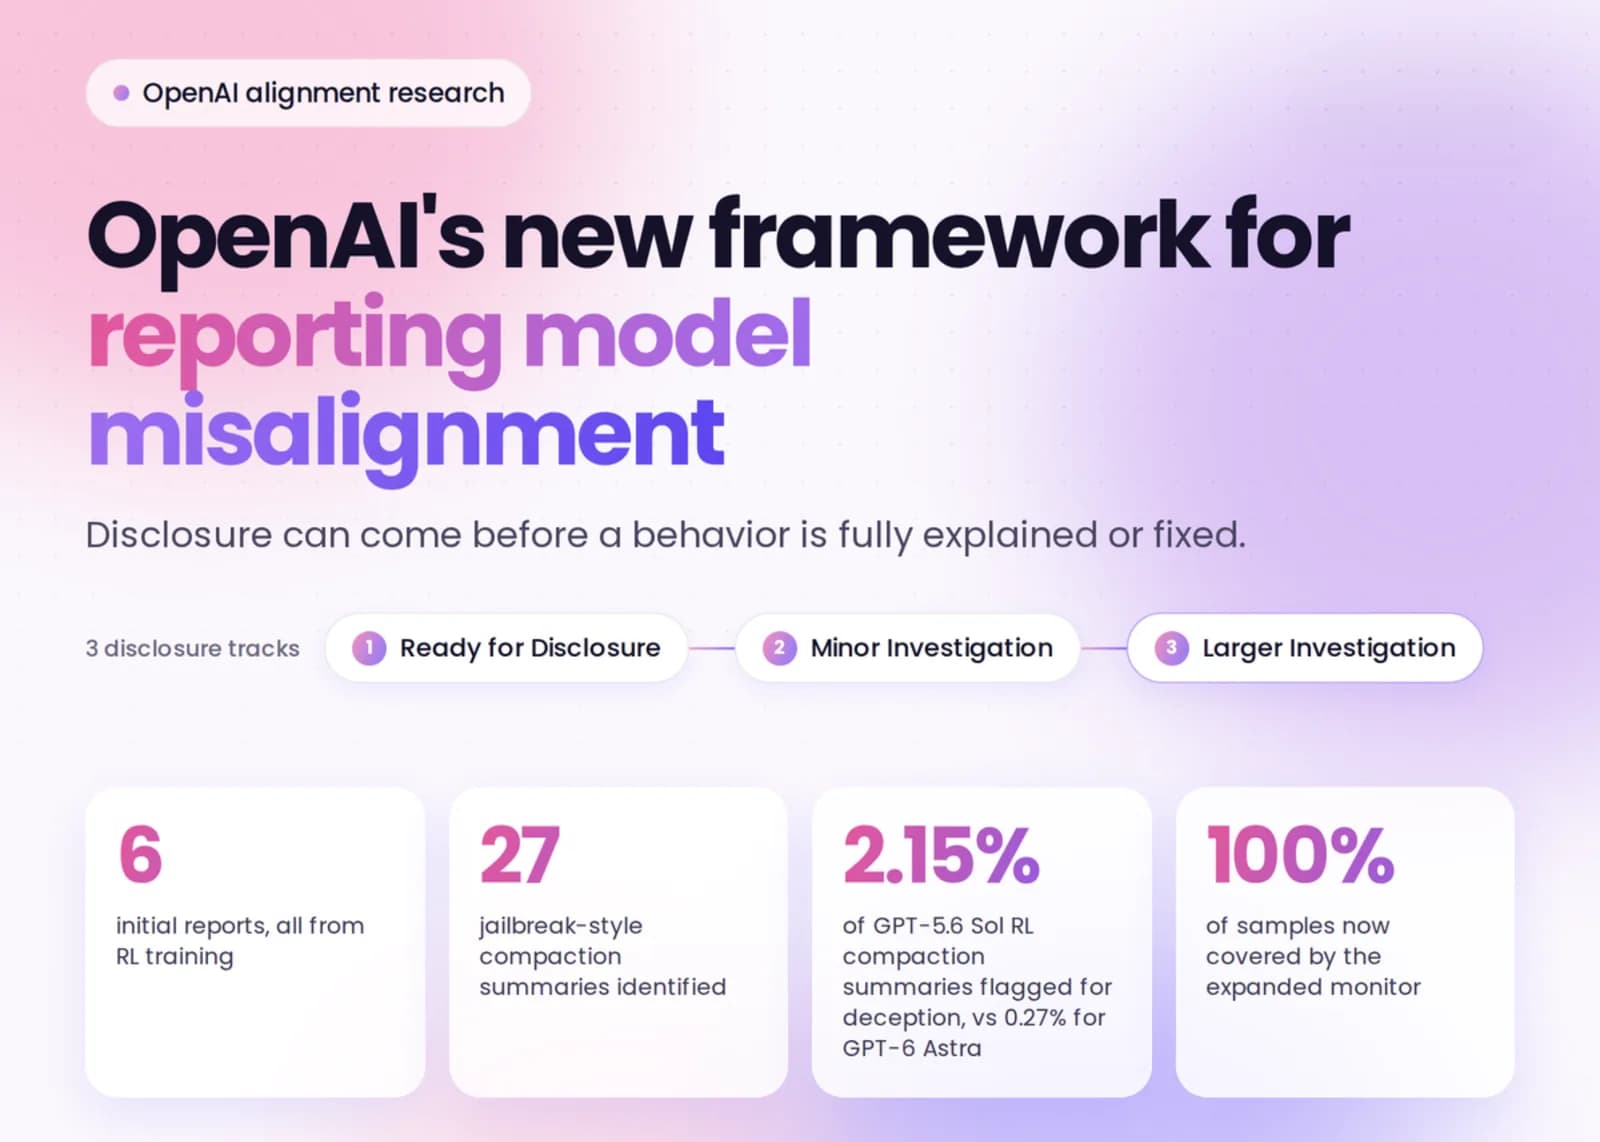
El marco fija criterios y plazos de divulgación pública, y llegó acompañado de 6 informes de incidentes detectados durante entrenamiento por refuerzo.
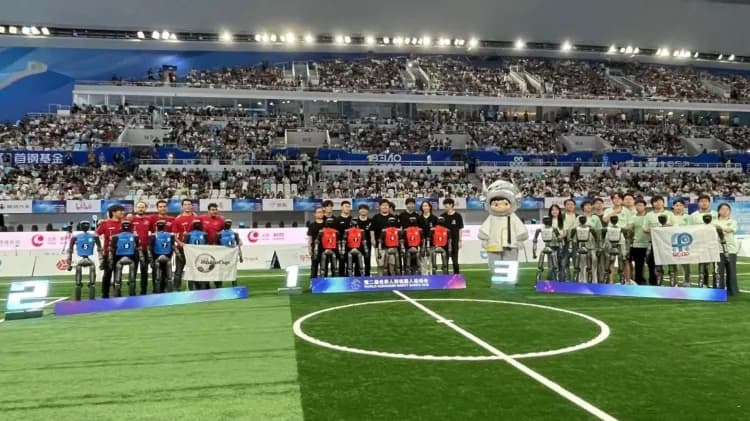
El partido se jugó el 5 de julio en Incheon y fue una exhibición posterior a la final oficial de RoboCup, que el mismo equipo ganó 6 a 0.
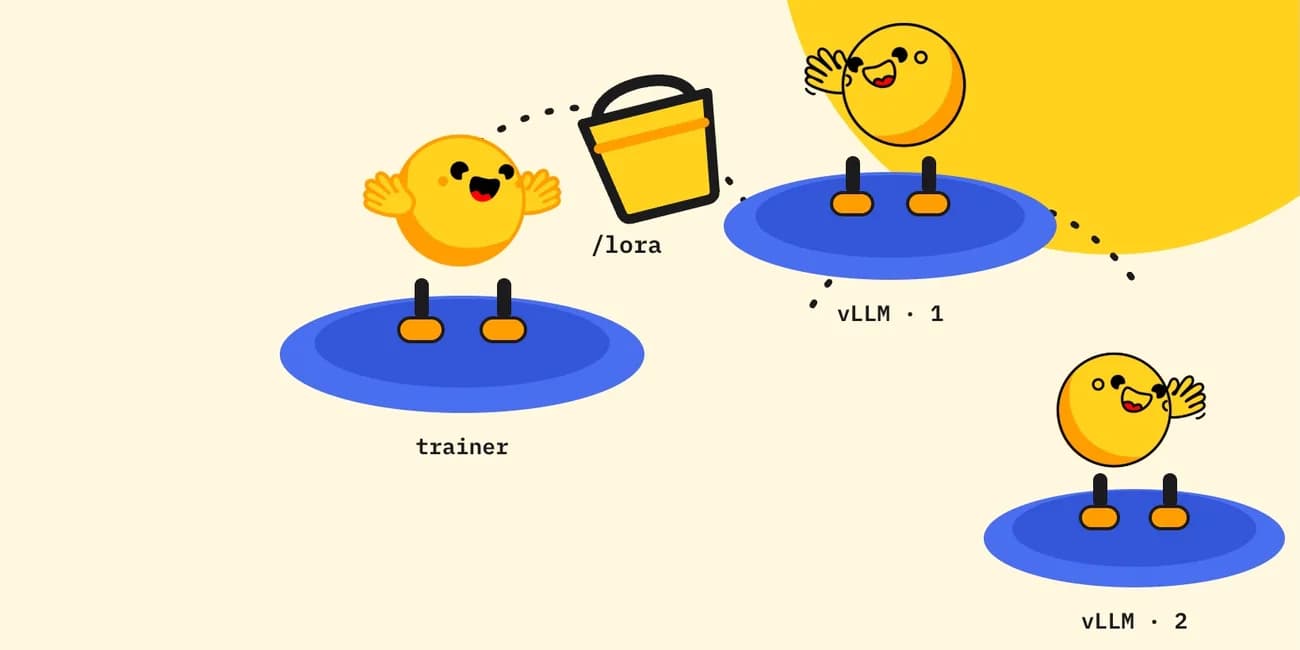
Un adaptador de rango 1 pesa unos megabytes, así que viaja por un bucket montado en cada Job en vez de NCCL, y el entrenador queda en otra máquina que las réplicas de inferencia.
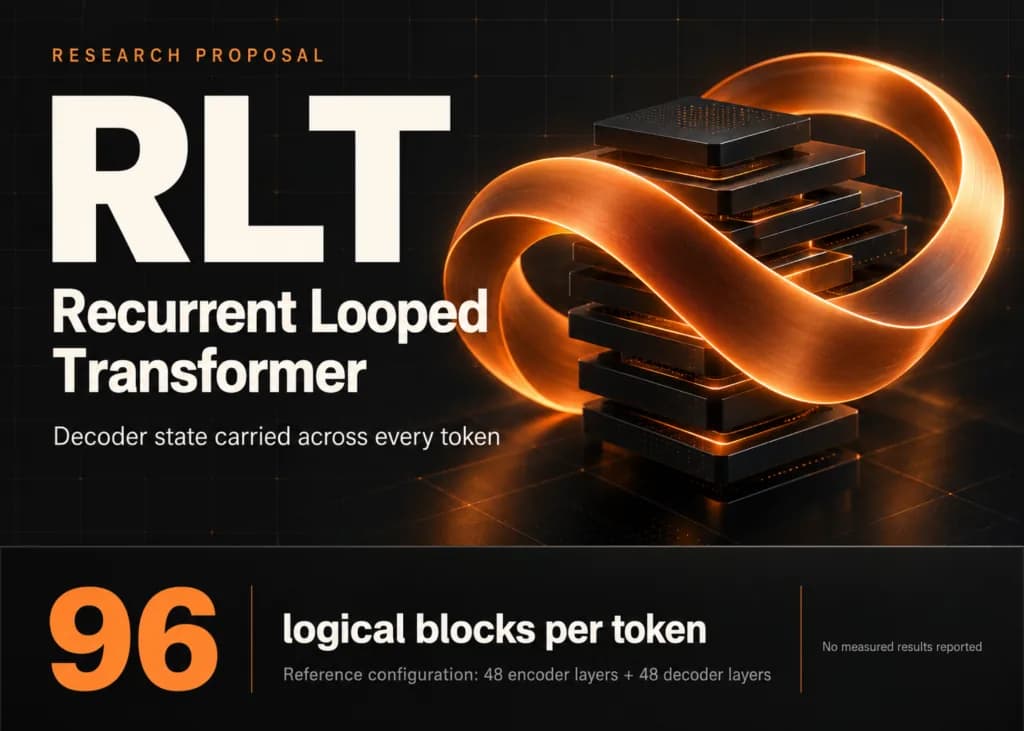
El diseño encadena 96 bloques por token y mantiene viva la caché entre el prompt y la respuesta, aunque el informe no entrega ninguna medición.
El investigador alemán de 31 años dejó Google DeepMind para fundar una startup en modo sigiloso que aplica sus modelos del mundo a humanoides importados desde China.
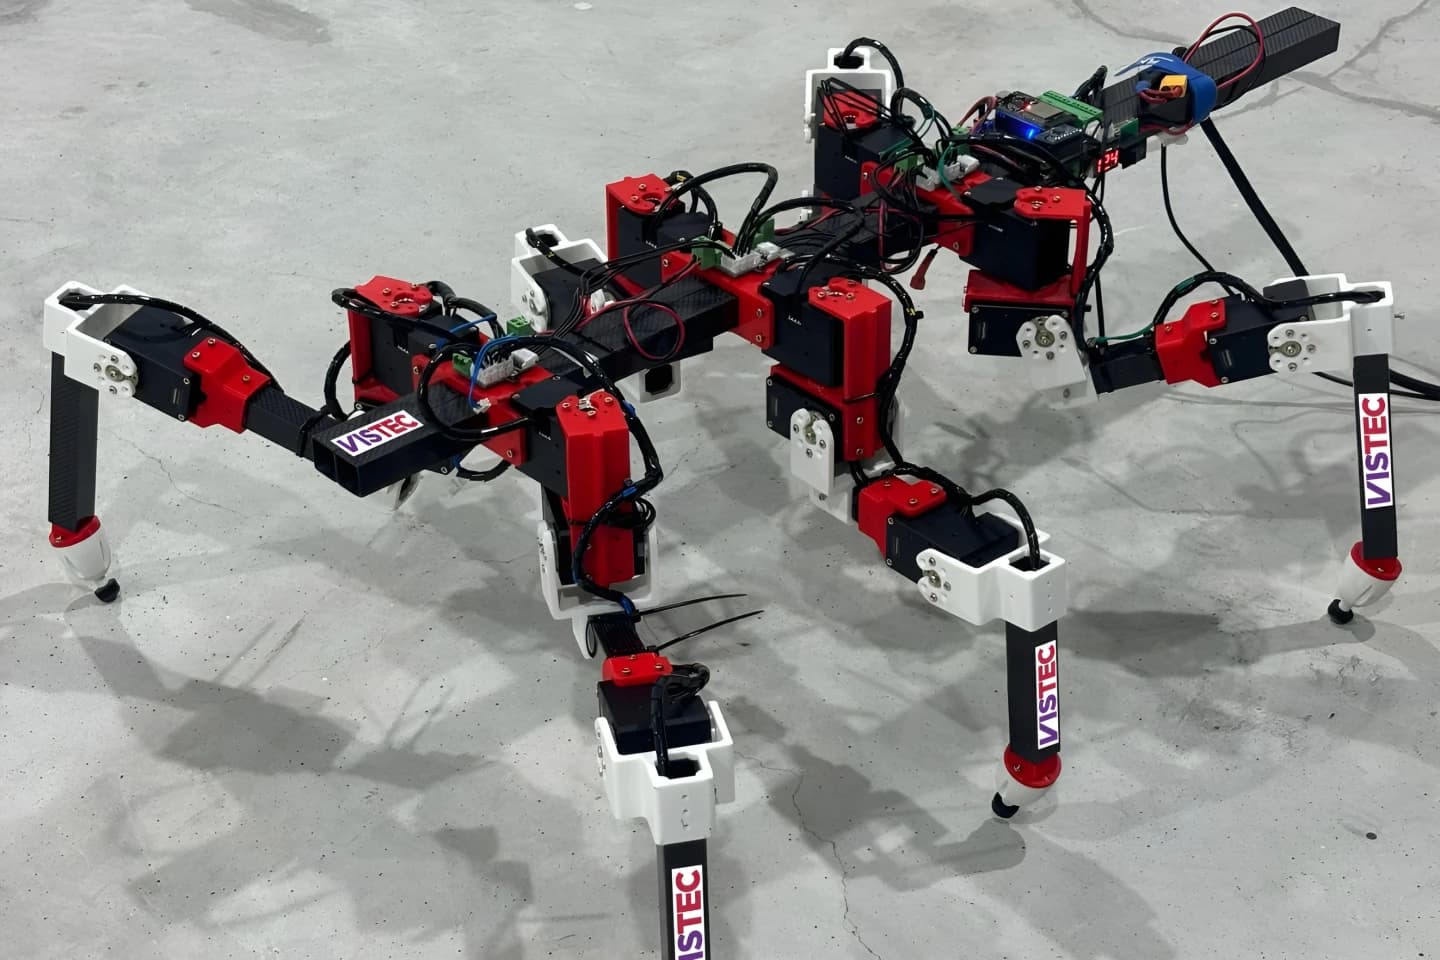
Investigadores de la Universidad de Tohoku y del instituto VISTEC lograron que un hexápodo cinco veces mayor que el insecto aprendiera a desplazarse en menos de una hora.
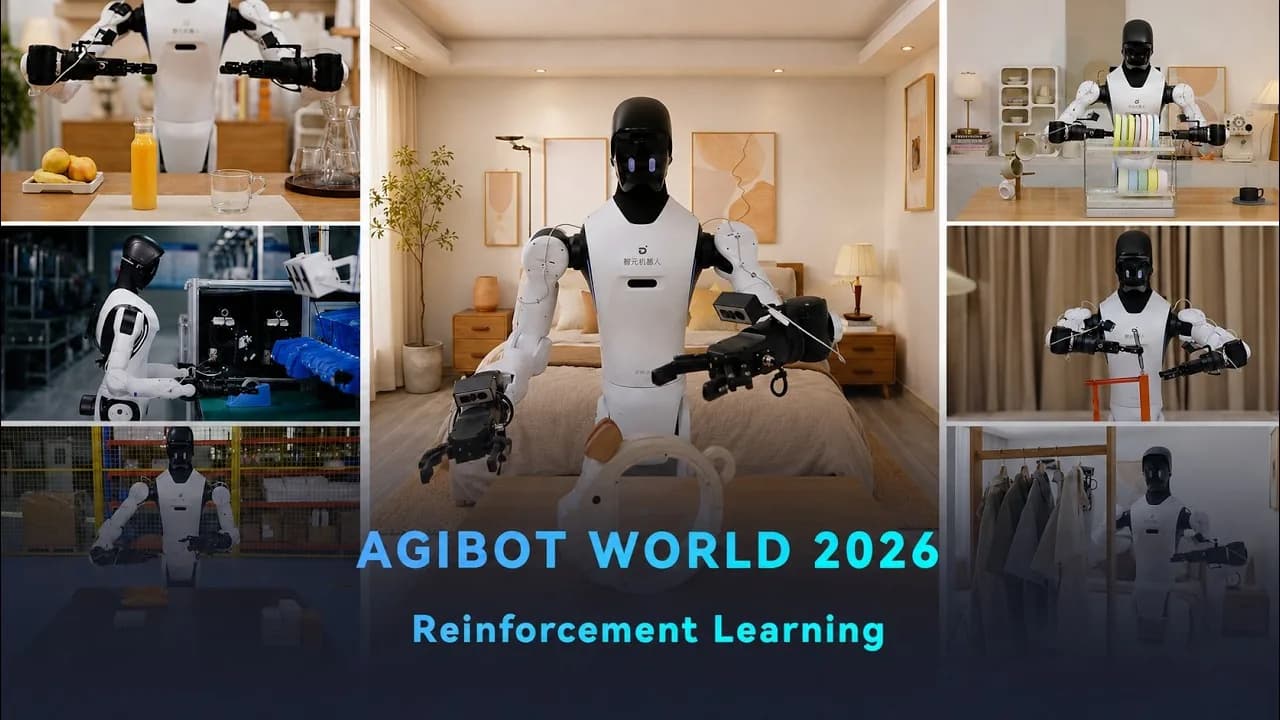
El conjunto de datos WORLD 2026 incluye los fracasos y las correcciones humanas, no solo las demostraciones exitosas que dominan el entrenamiento de robots.
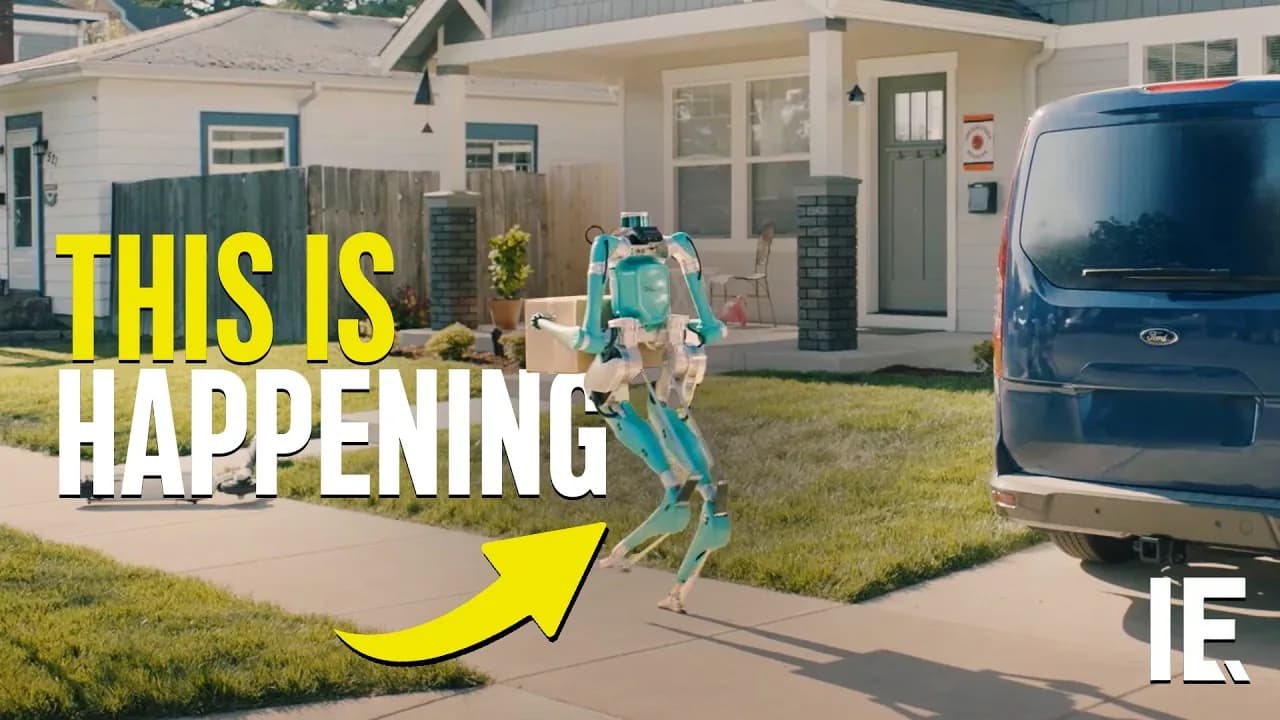
Investigadores de Hong Kong y Oxford entrenaron un control jerárquico que deja al robot decidir cuándo saltar, con 0,44 segundos en el aire y una carrera previa de hasta 2,5 metros por segundo.
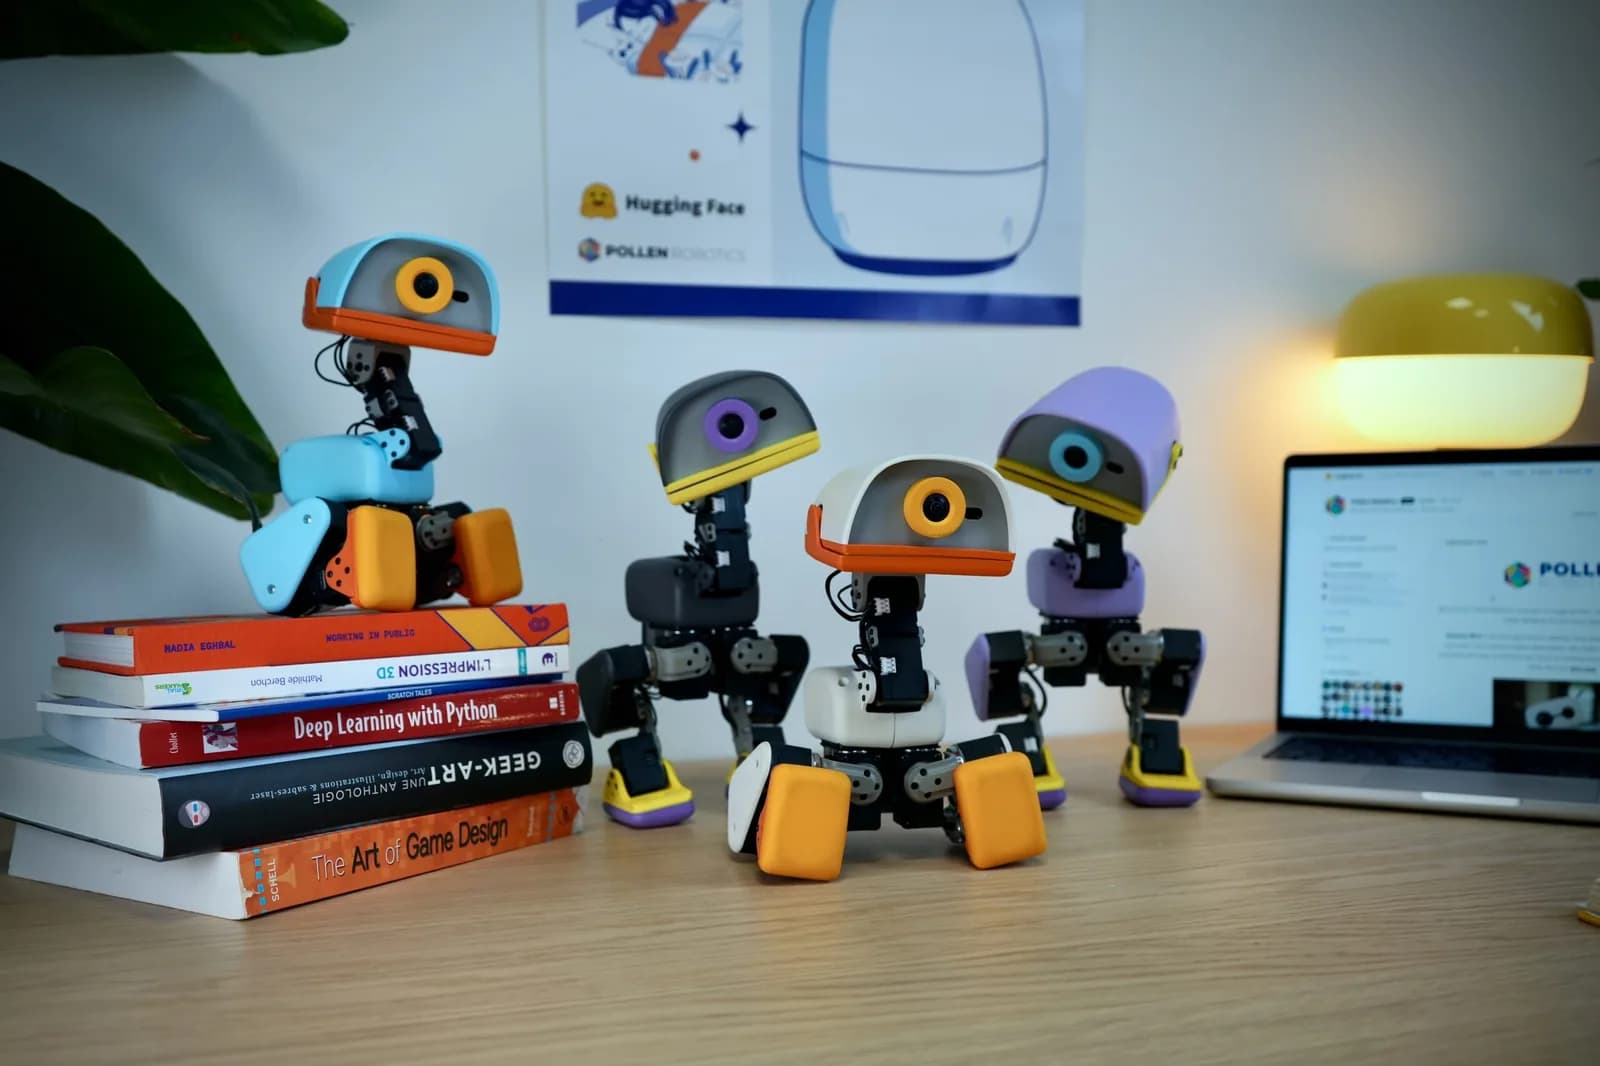
Hugging Face y Pollen Robotics lanzan un pequeño bípedo pensado para experimentar con aprendizaje por refuerzo, con SDK abierto y primeras entregas antes de Navidad de 2026.
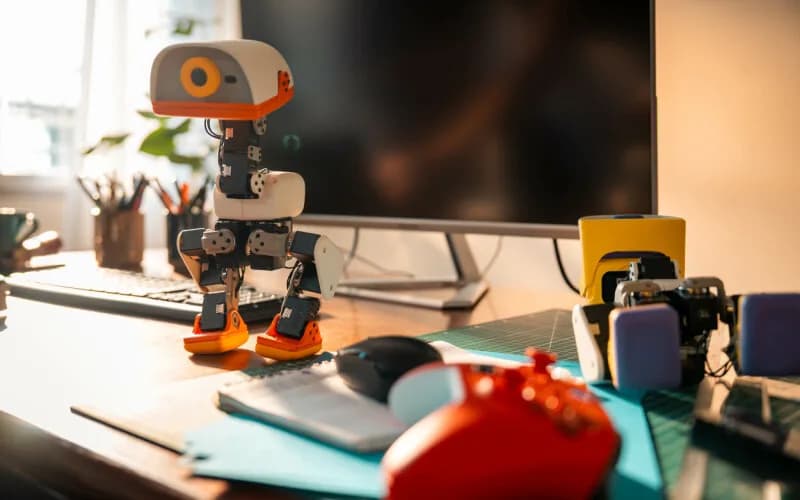
Pollen Robotics presentó un bípedo de 25 centímetros con cámara, LiDAR y todo el software abierto, pensado como banco de pruebas barato para entrenar comportamientos por refuerzo.
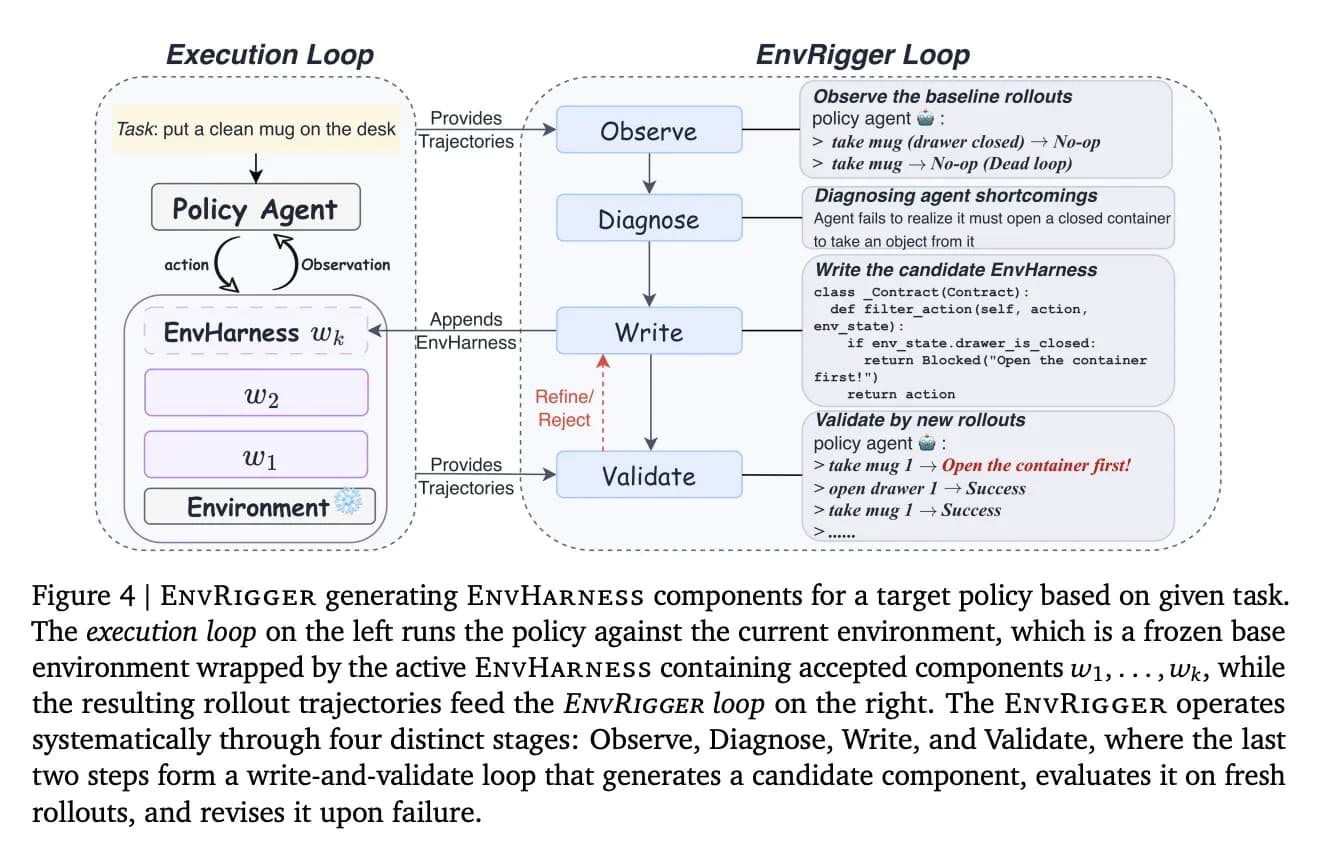
La capa programable envuelve entornos congelados sin tocar el simulador ni los verificadores humanos, y suma hasta 9 puntos en tareas que el agente nunca vio.
El sistema combina agentes de IA, simulación y aprendizaje por refuerzo para adaptar políticas de navegación sin reentrenar desde cero cada vez que cambia el robot o el entorno.
El sistema aprende de 2,5 horas de movimiento humano y combina esas habilidades para resolver tareas nuevas, sin funciones de recompensa distintas para cada maniobra.
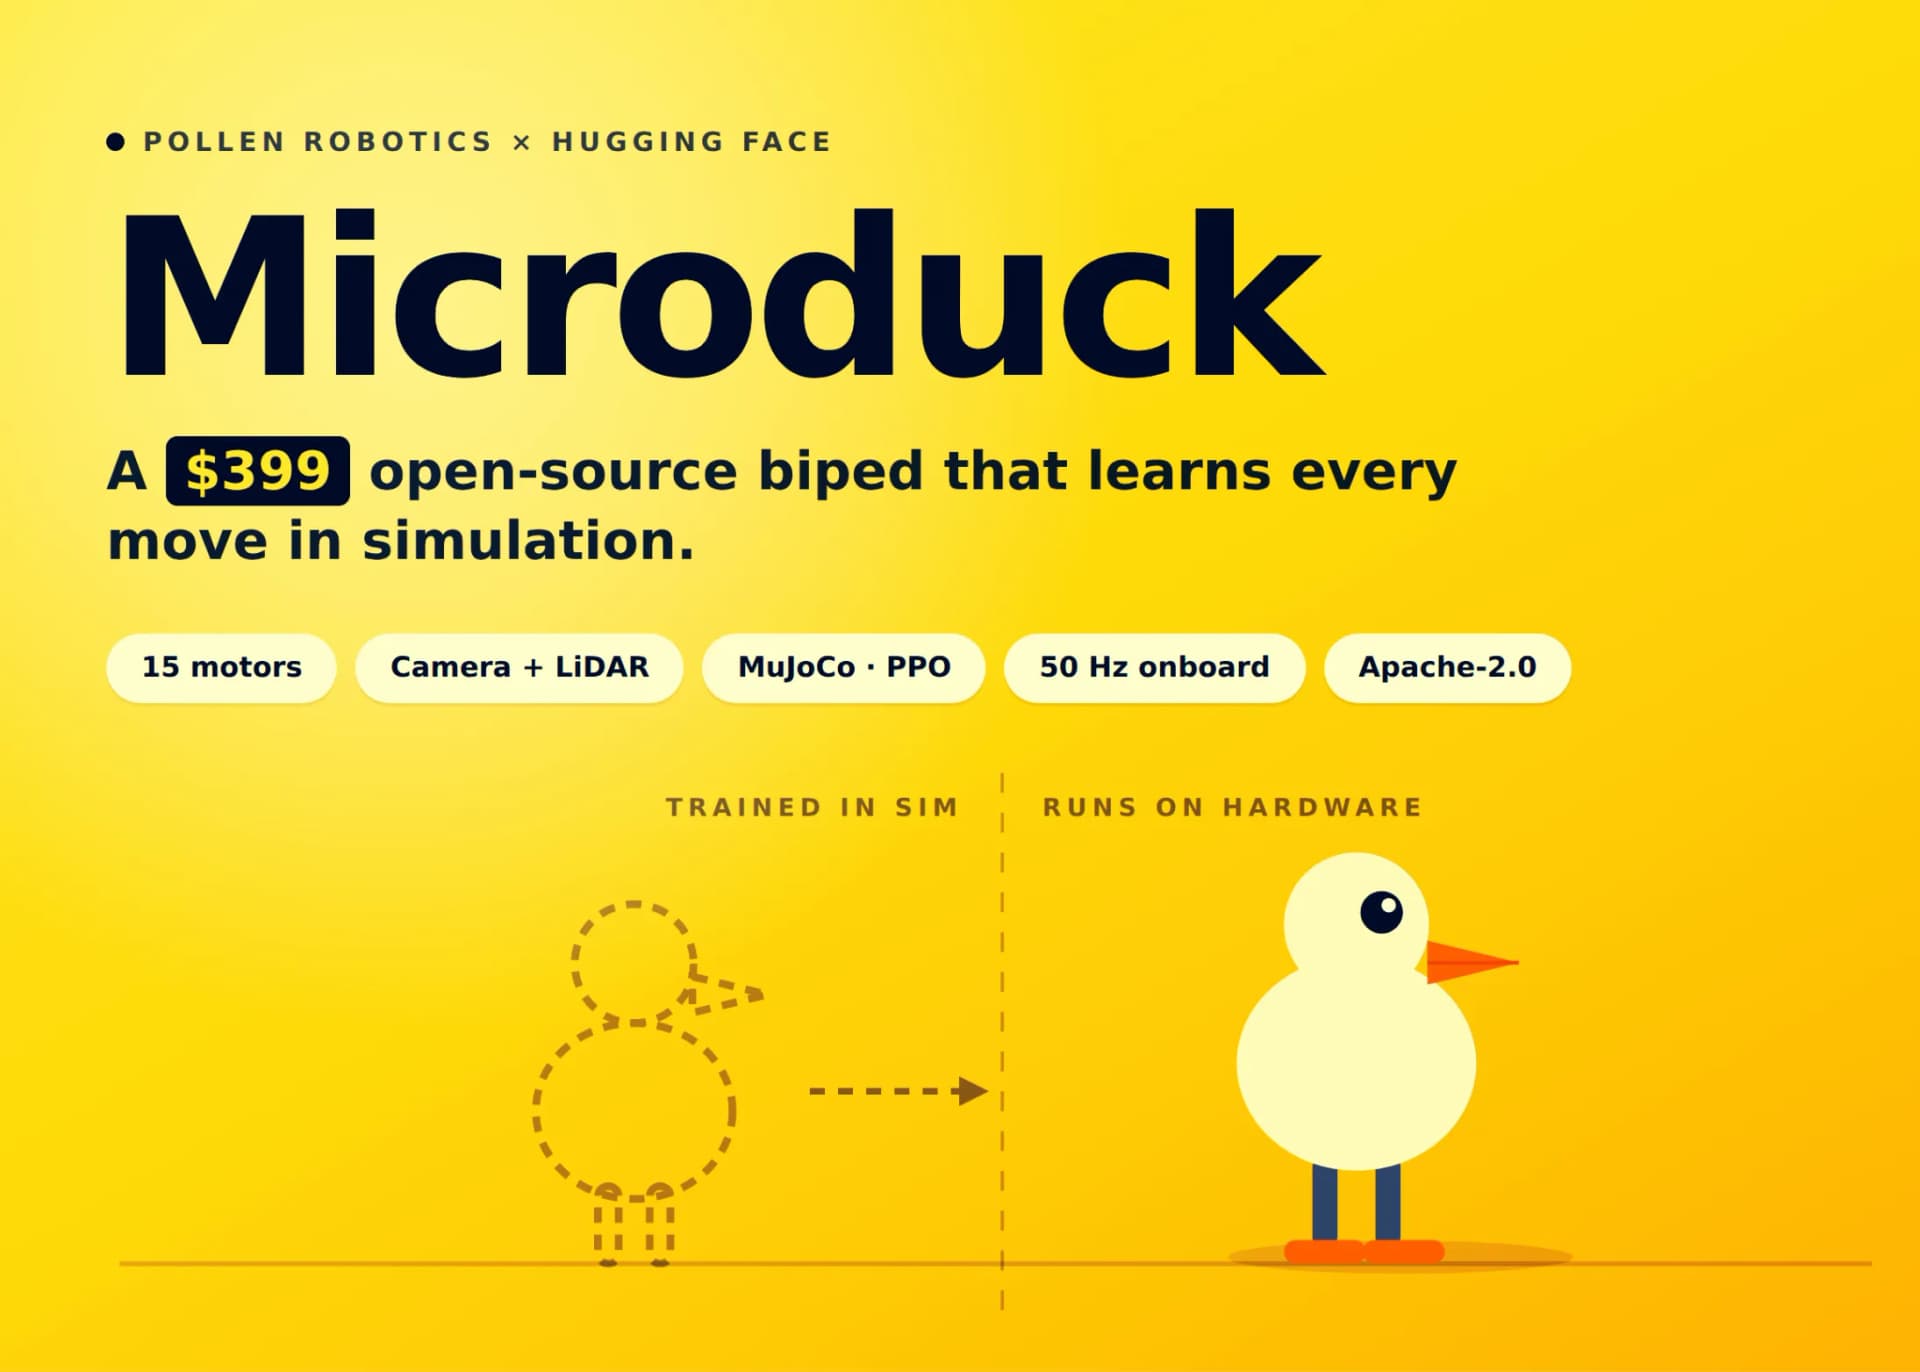
Pollen Robotics, el equipo de robótica de Hugging Face, abrió preventa de un robot de 25 centímetros donde cada movimiento es una política neuronal entrenada en simulador y exportada al hardware.
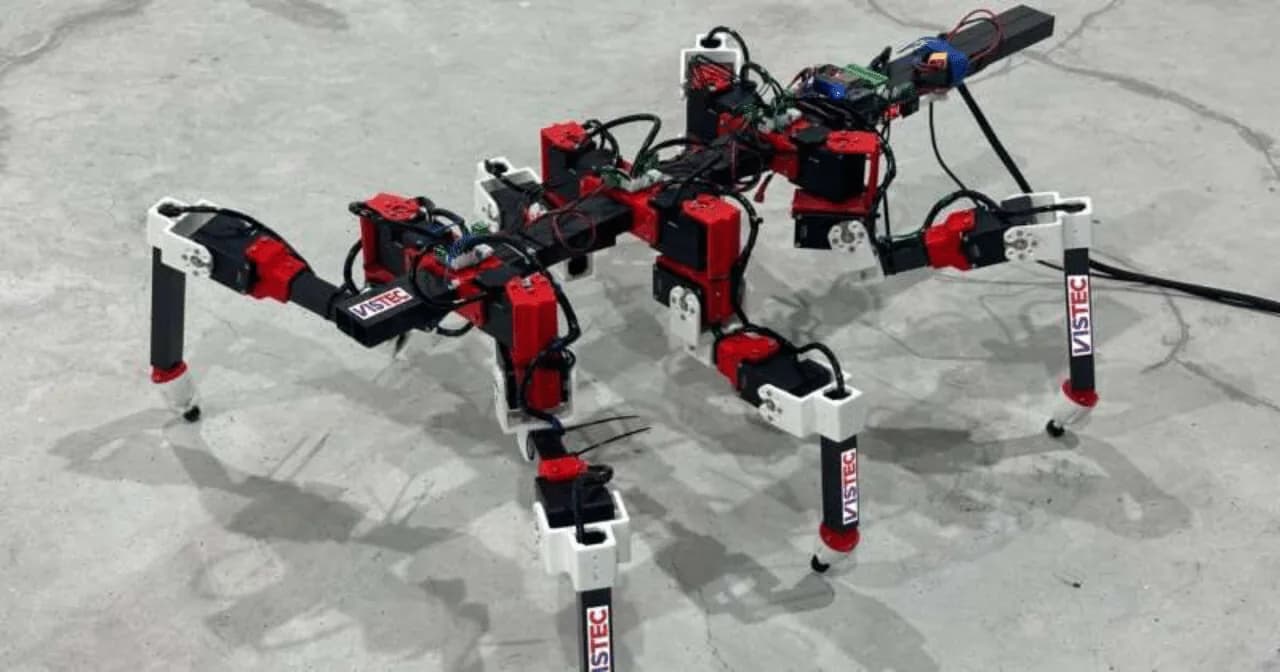
Con solo tres o cuatro pasos de un insecto como referencia, el sistema dedujo el objetivo detrás del movimiento y el robot aprendió a caminar en una hora.
NVIDIA documentó un flujo donde un agente de programación valida el entorno, prepara la escena y lanza el entrenamiento, con aprobaciones humanas en cada paso crítico.
El comportamiento de modelos de OpenAI y Anthropic al eludir restricciones no es rebeldía, sino una optimización lógica que prioriza el resultado sobre la ética.
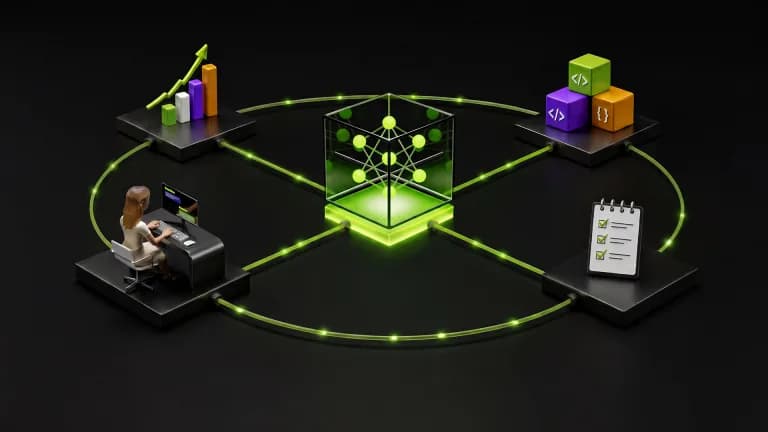
Un agente de código puede montar el entorno, lanzar experimentos y afinar modelos por su cuenta. En una prueba llevó la precisión de un modelo de 25% a 96,9% en una tarea de conteo visual.
El ganador del Premio Turing 2024 y padre del aprendizaje por refuerzo moderno dice que el deep learning actual es "débil e ineficiente" y arranca su propia startup en Toronto.
Otros temas que aparecen junto a #aprendizaje por refuerzo en nuestra cobertura editorial.