OpenAI anunció el 5 de octubre que agregará marcas de agua invisibles al texto que genera ChatGPT, informó Matthias Bastian en The Decoder. La medida responde a las reglas de la Unión Europea y, a diferencia de lo que hizo Anthropic, los clientes de la API en cualquier país podrán dejarla apagada.
Según The Decoder, la Ley de IA de la Unión Europea exige que los proveedores de IA etiqueten el texto generado en un formato que una máquina pueda leer. La respuesta de OpenAI se llama textGrain, una técnica que esconde una señal estadística en la elección de palabras del modelo. Funciona de forma parecida a la marca de agua de Claude, que usa SynthID, la tecnología de código abierto de Google.
Europa primero, la API a elección
OpenAI activará la marca para los usuarios de ChatGPT y Codex en la Unión Europea durante las próximas semanas. En la API será opcional en todo el mundo. Anthropic hizo lo contrario con Claude, cuya marca es obligatoria y se aplica en cualquier país, sin importar cómo se acceda al modelo.
La marca de agua de la API de OpenAI también llegará en las próximas semanas a socios de nube como Microsoft Azure.
¿Qué tan fácil es borrarla?
OpenAI asegura que textGrain igualó o superó en sus pruebas internas a otros métodos, entre ellos SynthID para texto de Google. La empresa también planea liberar la tecnología como código abierto para que otros puedan construir sobre ella.
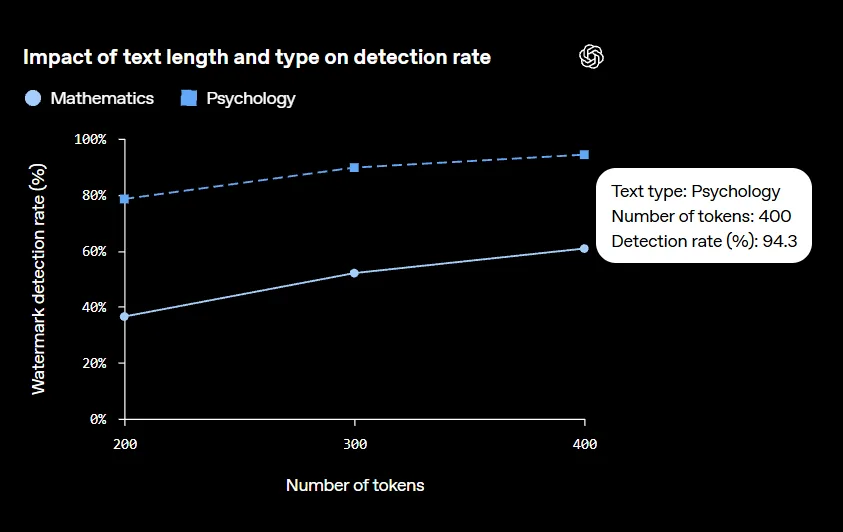
La tasa de detección depende mucho del largo del texto y del tema. Con el detector ajustado a una tasa objetivo de falsos positivos de 1%, encontró la marca en cerca del 95% de los pasajes de 400 tokens sobre psicología. Con 200 tokens, la cifra bajó a cerca de 80%.
En matemáticas la detección fue "considerablemente menor", según OpenAI, porque ahí el modelo tiene menos libertad para elegir palabras. Con 400 tokens, unas 300 palabras, el detector identifica cerca del 94% de las marcas en pasajes de psicología y apenas un 60% en los de matemáticas. Pasajes más largos podrían reforzar la señal estadística y mejorar la detección, aunque el resultado seguiría dependiendo del contenido. OpenAI no entrega datos para comprobar esa hipótesis.
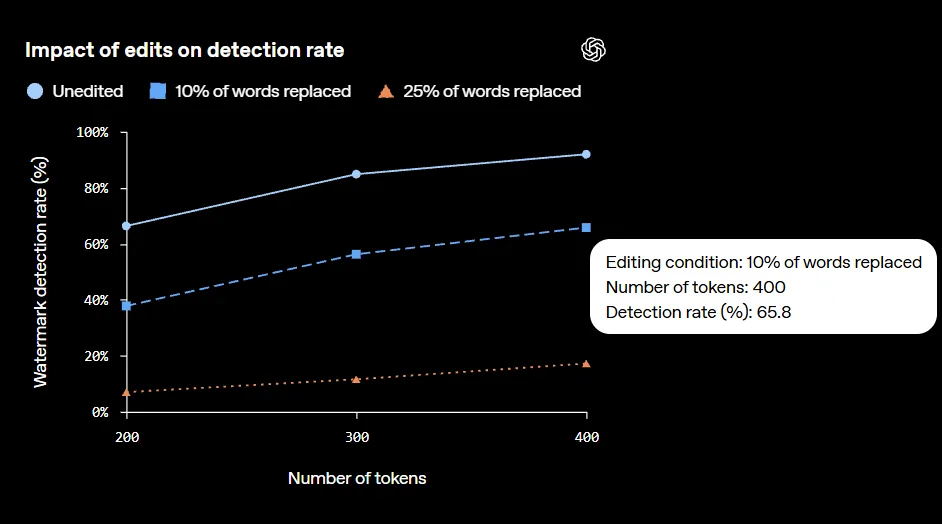
Editar el texto también complica la detección. Según OpenAI, reemplazar apenas el 10% de las palabras por sinónimos baja la detección en pasajes de 400 tokens de cerca de 92% a 66%. Con una de cada cuatro palabras cambiada, la detección cae a 17%, así que la marca se esquiva con poco esfuerzo.
| Escenario medido por OpenAI | Detección aproximada |
|---|---|
| Psicología, 400 tokens | 95% |
| Psicología, 200 tokens | 80% |
| Matemáticas, 400 tokens | 60% |
| 10% de palabras cambiadas, 400 tokens | 66% |
| 25% de palabras cambiadas, 400 tokens | 17% |
Esa debilidad podría jugar a favor de OpenAI, apunta The Decoder. Si las marcas fueran más difíciles de quitar, los usuarios que no quieren que se detecte su uso de ChatGPT podrían irse a modelos de pesos abiertos.
Un informe técnico de OpenAI explica en detalle cómo funciona textGrain. Anthropic no ha publicado tasas de detección para la marca de Claude, aunque asegura que su sistema resiste bien las ediciones.
Calidad y límites de la marca
OpenAI afirma que la marca de agua no empeora las respuestas y cita pruebas con Astra, su modelo de frontera. La empresa no reporta diferencias de rendimiento apreciables con la marca encendida o apagada en ocho benchmarks, entre ellos GPQA Diamond, BrowseComp y DeepSWE. Esos resultados no muestran si la marca afecta la calidad de la redacción, un punto que también se ha cuestionado sobre la marca de Claude.
La empresa también aclara qué no dice una marca detectada. No revela cuánta creatividad o edición humana hubo en el texto, no establece propiedad ni responsabilidad, no identifica al usuario y no indica si el contenido es correcto. Tampoco funciona al revés, porque no encontrar la marca no prueba que lo haya escrito una persona. El pasaje pudo ser muy corto, estar editado o traducido, o venir de un modelo que el detector no reconoce.
¿Quién podrá usar el detector?
Al principio, solo investigadores y organizaciones especializadas tendrán acceso al detector de textGrain, y deben postular con un formulario. OpenAI dará el acceso caso a caso bajo el Código de Buenas Prácticas de la Unión Europea. Anthropic sigue un enfoque parecido con su API de detección.
La herramienta solo informará si detectó una marca de OpenAI. No identificará a los usuarios ni mostrará sus prompts o conversaciones.
OpenAI explica que restringe el acceso porque el detector puede señalar texto que no lleva marca o pasar por alto marcas reales. La empresa ampliará el acceso "cuando creamos que los resultados se pueden interpretar de forma responsable", y no dijo cuándo ocurrirá.
Las herramientas de verificación para imágenes y audio siguen abiertas al público, entre ellas openai.com/verify y la Content Provenance API.