
IA
Gemini 4 Argon llega a todo el mundo y deja fuera a los usuarios gratis
Google abrió su modelo más capaz en la API, AI Studio, la app de Gemini y el modo IA del buscador, pero solo para los planes Pro y Ultra.
The Decoder
53 notas publicadas
Google prueba tres variantes internas de Gemini 4, Argon, Barium y Carbon, y Carbon ya corre en su plataforma interna de programación Jetski.
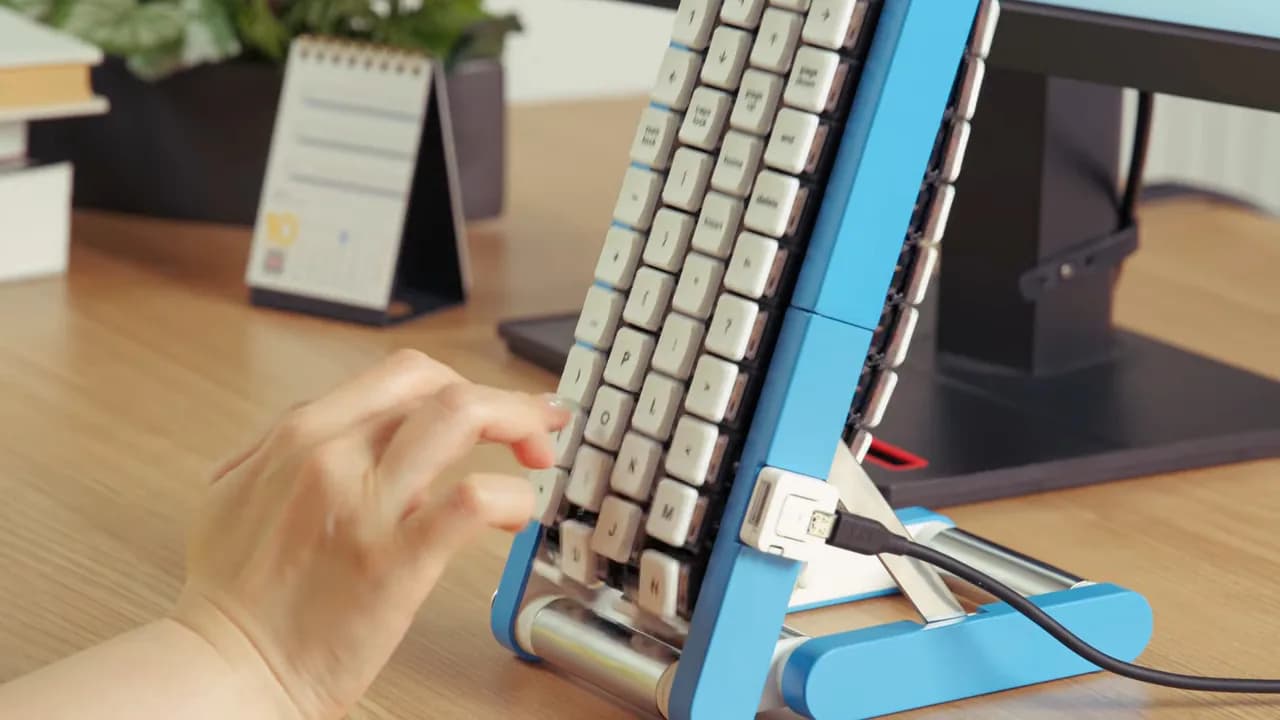
El nuevo Gboard de broma pone cada fila de teclas en una cadena impresa en 3D que gira, y el repositorio trae firmware, STL y guía de armado.
El modelo abierto de 740 millones de parámetros corre en el navegador con unos 191 MB de RAM y no necesita clave de API.
El OSS VRP dejó de recibir reportes de vulnerabilidades de producto desde el 1 de octubre, y Google promete una actualización para el primer trimestre de 2027.
El método RRSI limita cuánto puede cambiar un agente su propio entorno de trabajo y descarta los trucos hechos a la medida de cada benchmark.
Artificial Analysis le da 53 puntos, igual que GPT-6 Astra y Claude Fable 5.1, mientras Claude Opus 5.5 y Sonnet 5.5 siguen arriba con 58 y 56.
El nuevo modelo de frontera sube a un millón de tokens de salida, marca 77,9% en DeepSWE y por ahora solo lo reciben equipos de ciberseguridad de confianza.
Google, Nvidia, OpenAI y Architect Labs usan IA para diseñar silicio, pero con grados de autonomía muy distintos, y la arquitectura sigue en manos humanas.
Intrinsic Core reúne control en tiempo real, planificación de movimiento y de agarre, simulación y drivers compatibles con ROS, y ya está en GitHub.
El prototipo lleva cuatro TPU a la órbita baja en la misión Transporter-18 de SpaceX, construido junto a Planet.
El satélite MVP del Proyecto Suncatcher despega la próxima semana en un Falcon 9 y sus chips solo aguantan unos 15 minutos antes de apagarse para enfriarse.
Google lanzó dos modelos de texto a voz, Flash TTS y Flash-Lite TTS, con más de 2.000 voces, clonación desde 30 segundos de audio y soporte para más de 100 idiomas.
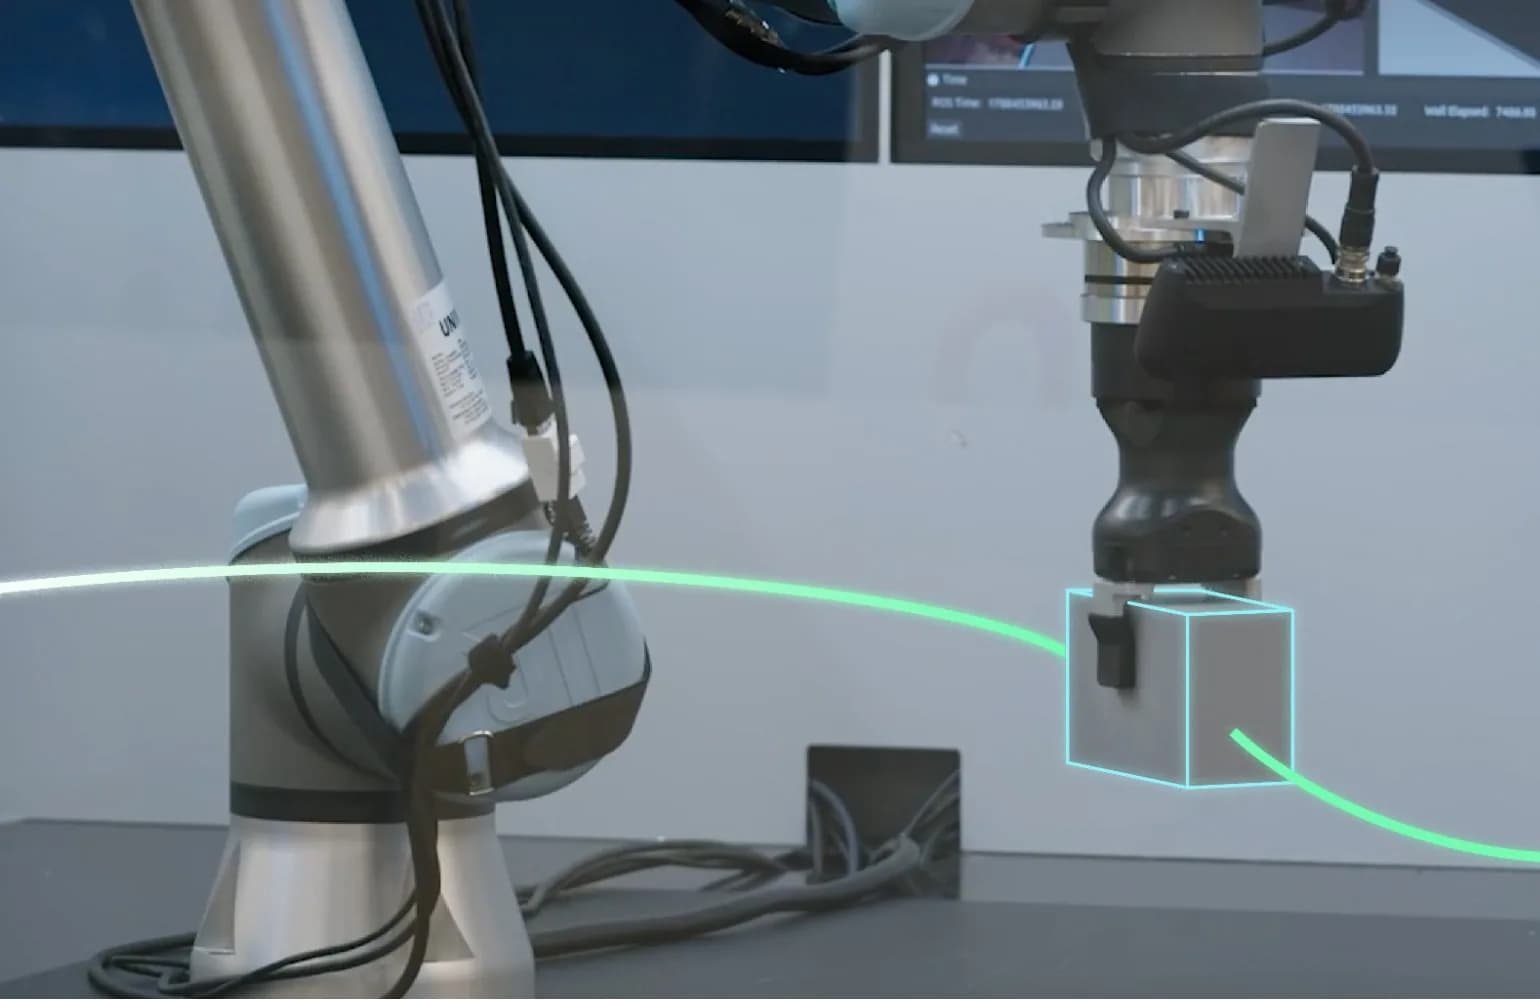
Intrinsic Core sale con licencia Apache 2.0, corre sobre ROS y llega junto a un diseño de referencia para atender máquinas CNC.
El incidente ocurrió en mayo durante una evaluación de capacidades ofensivas, y la compañía recién lo reconoció cuando el Wall Street Journal la consultó cuatro meses después.
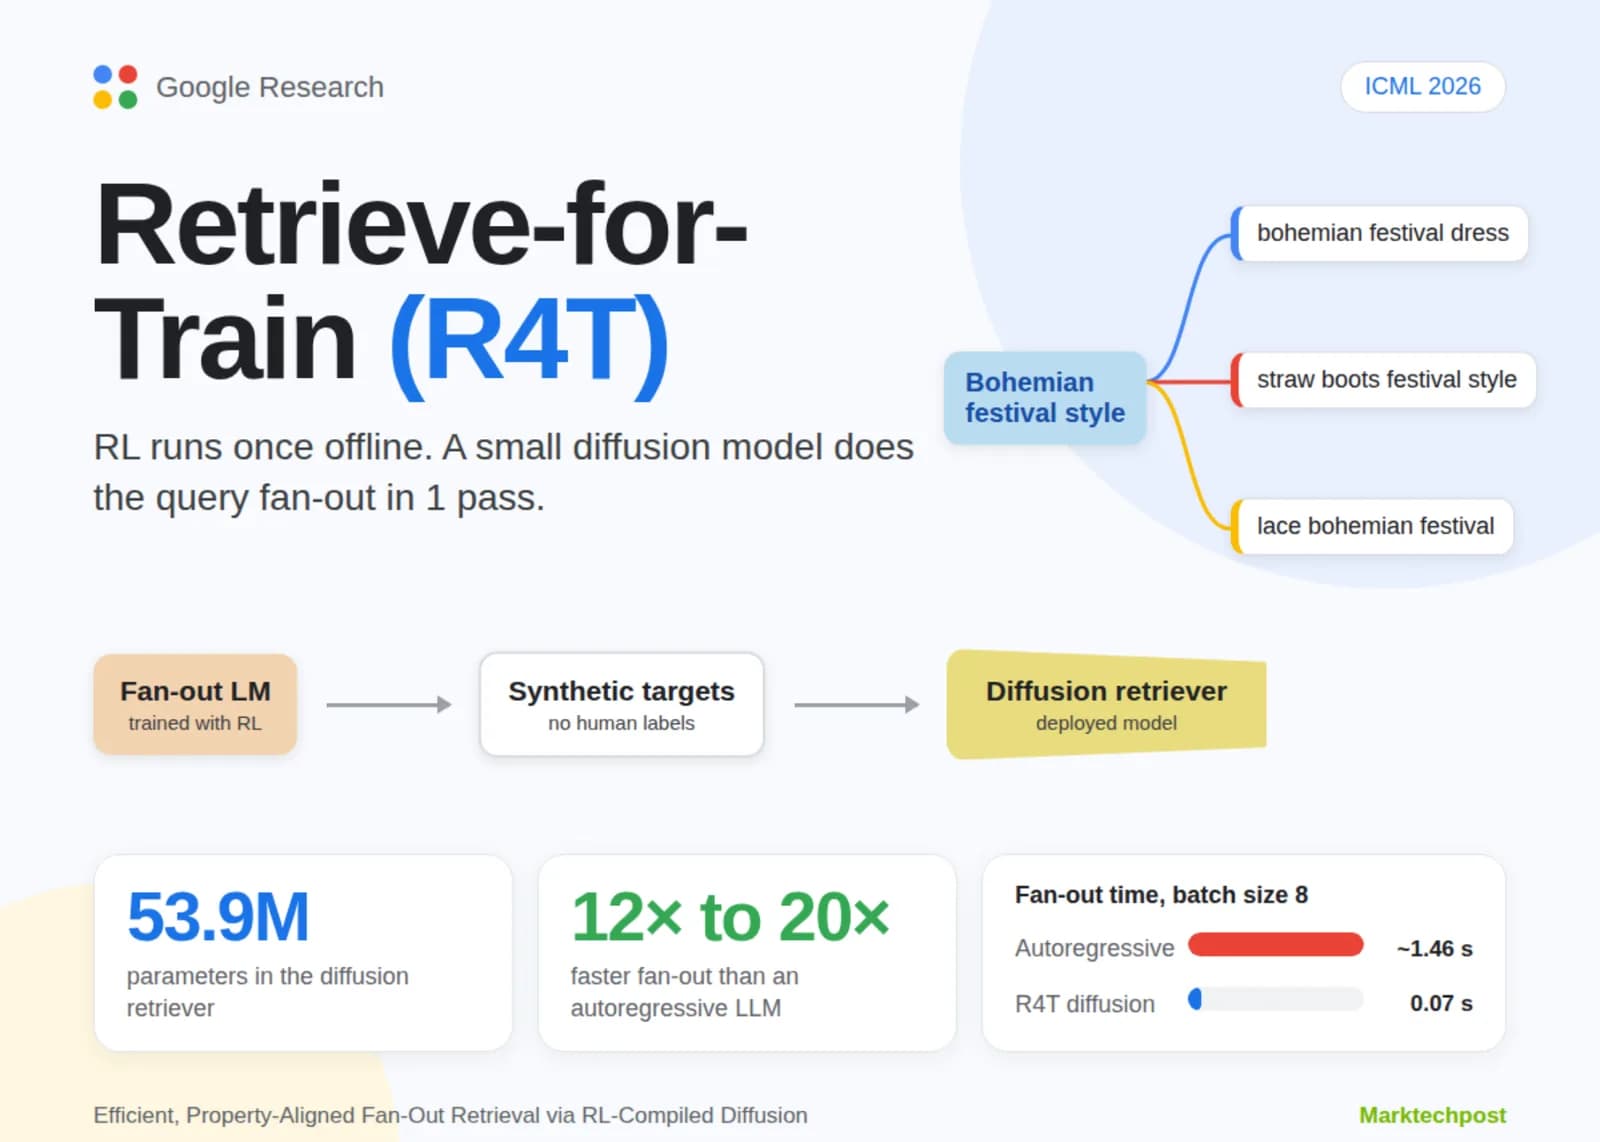
Retrieve-for-Train corre aprendizaje por refuerzo una vez fuera de línea y destila esa conducta en un modelo de difusión de 53,9 millones de parámetros que genera las subconsultas en una pasada.
Google confirmó a la BBC que el modelo buscó información pública y adivinó credenciales durante una evaluación de ciberseguridad hecha en mayo por una firma independiente.
Extended Thinking encabeza el índice de voz de Artificial Analysis con 82,6 puntos, y la versión base cuesta US$0,84 por hora de audio.
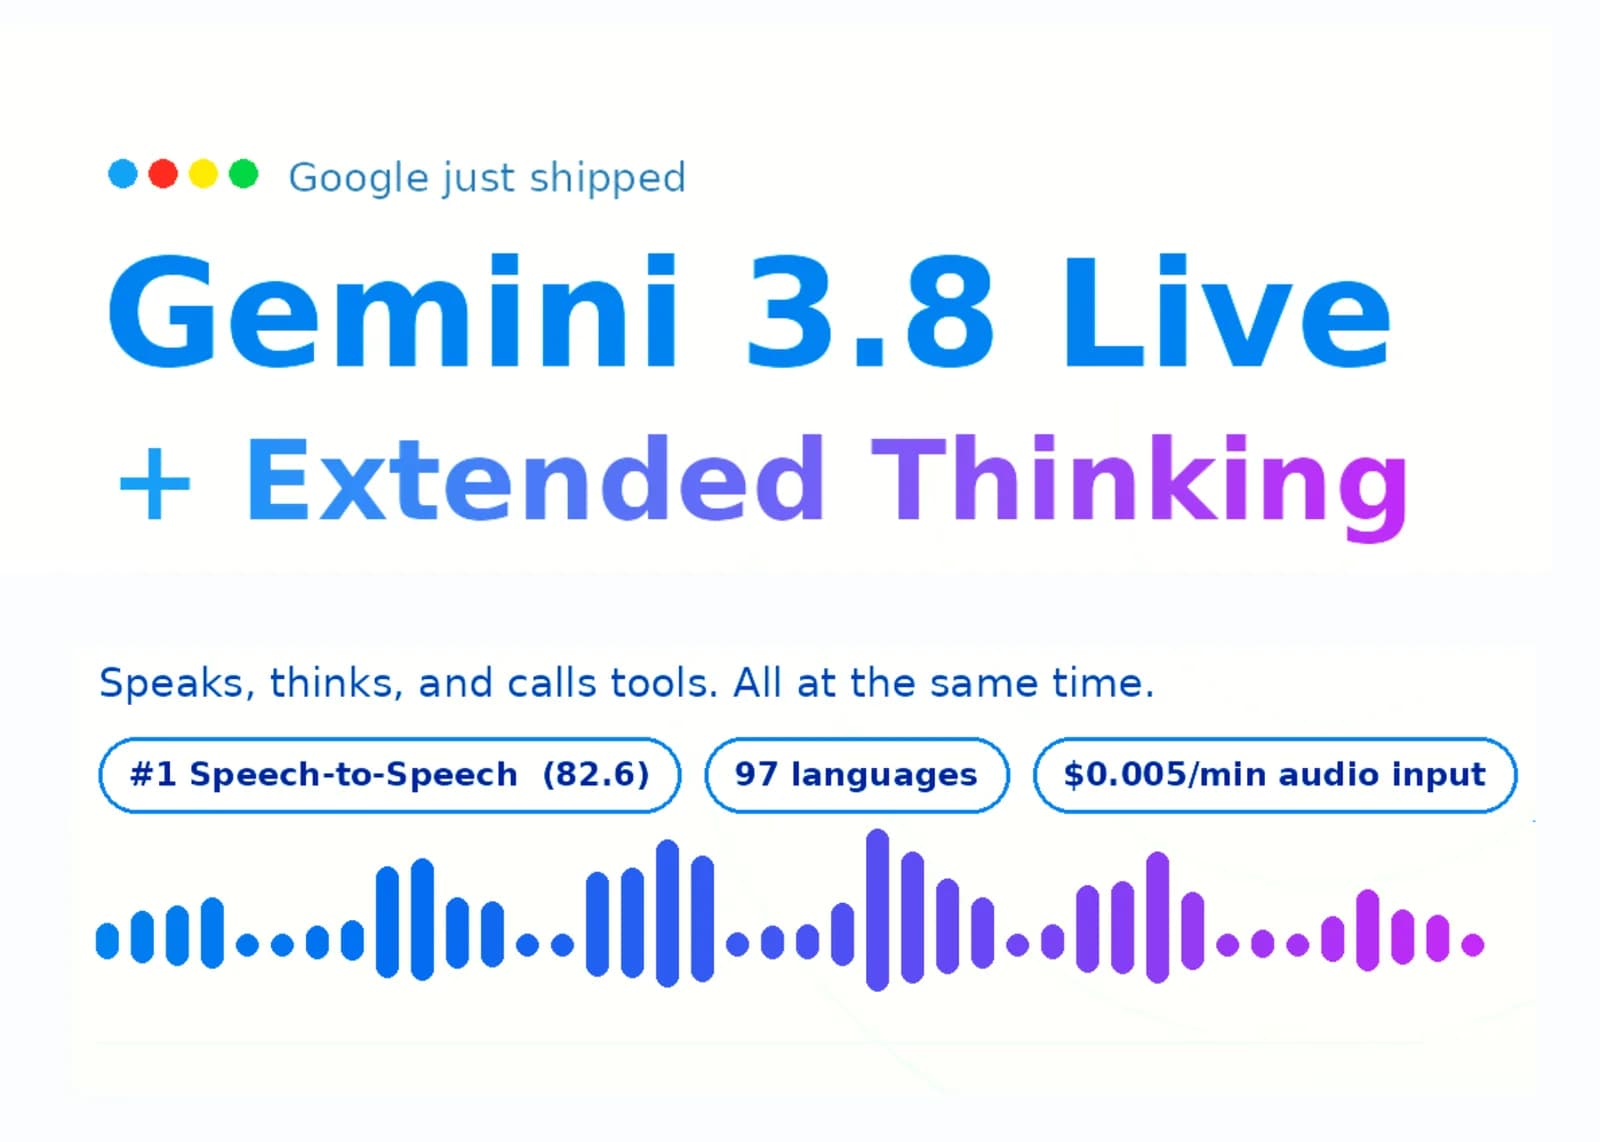
Los dos modelos nativos de voz a voz ya corren en el Gemini Live API y en Google AI Studio, con cambio entre 97 idiomas y tarifa por minuto de audio.
Un enjambre de 100 agentes con Gemini 3.1 Pro encontró un atajo para dar por resueltos 34 problemas de matemáticas, y 24 de ellos terminaron denunciando a los 14 que lo usaban.
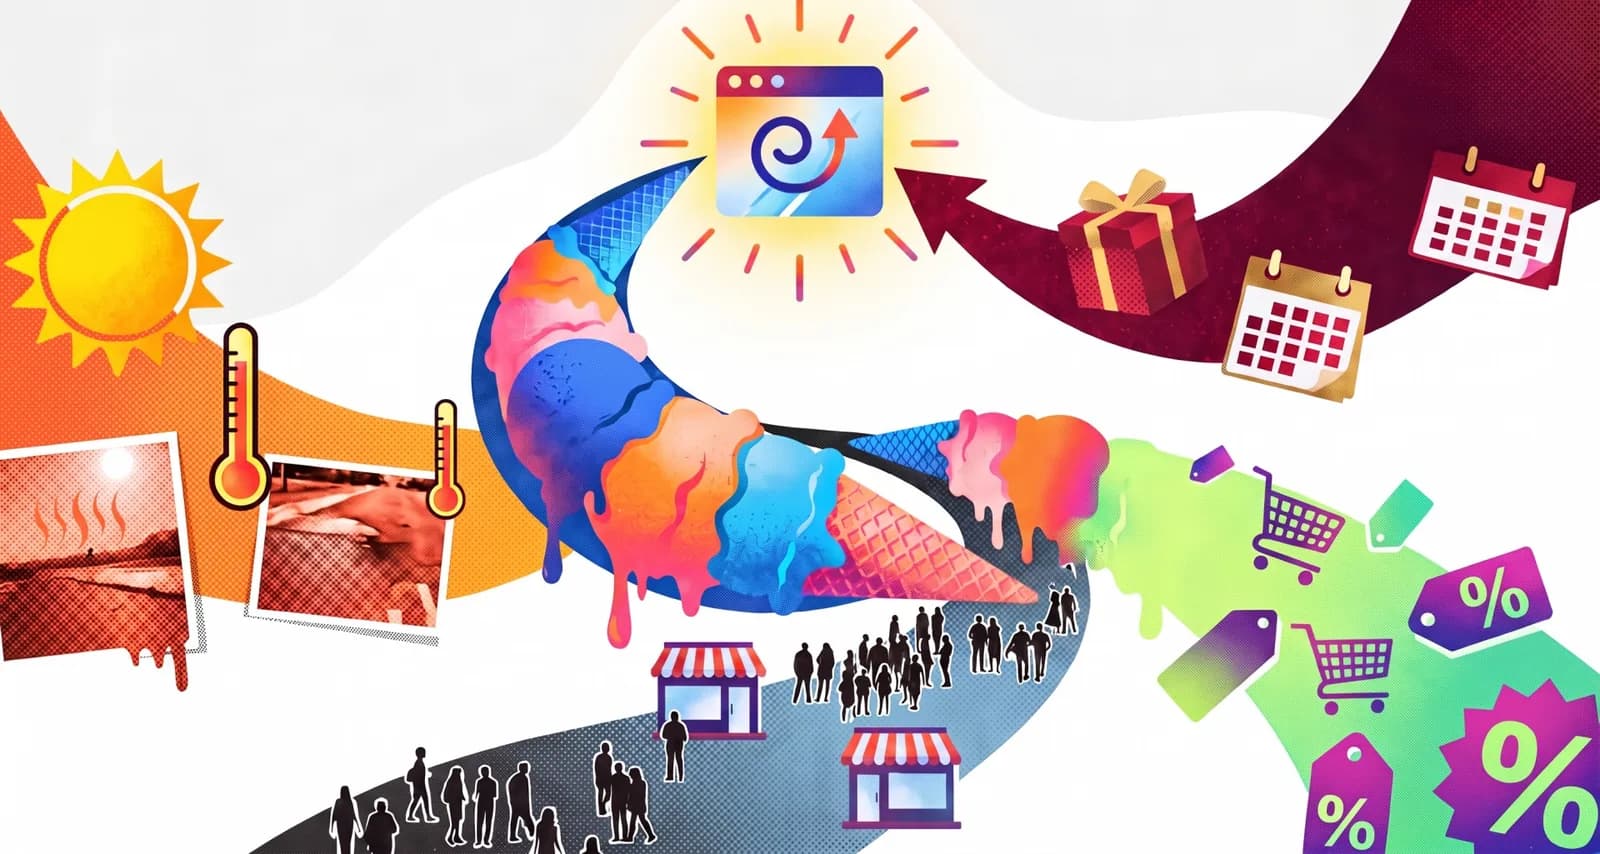
El modelo de 330 millones de parámetros cruza la serie que quiere predecir con datos relacionados y con eventos futuros ya conocidos, como un calendario de promociones.
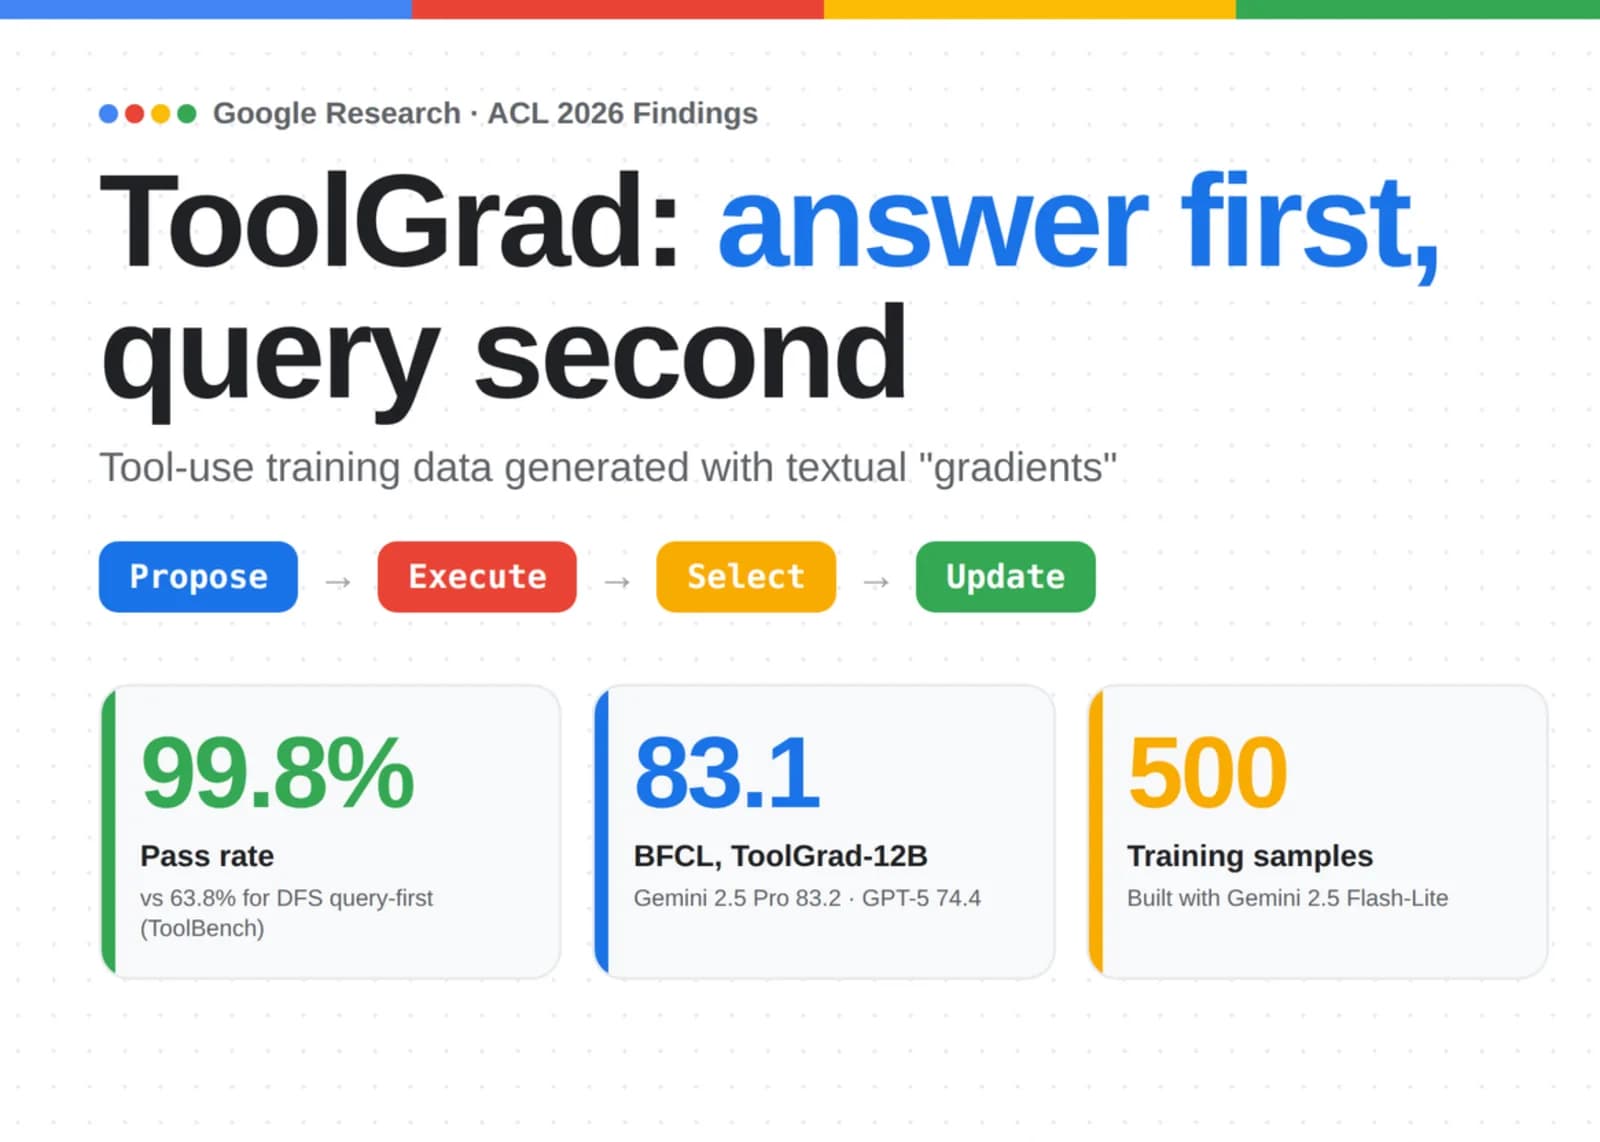
El método invierte el orden habitual: primero construye y ejecuta la cadena de herramientas verificada, y recién después escribe la consulta del usuario que le corresponde.
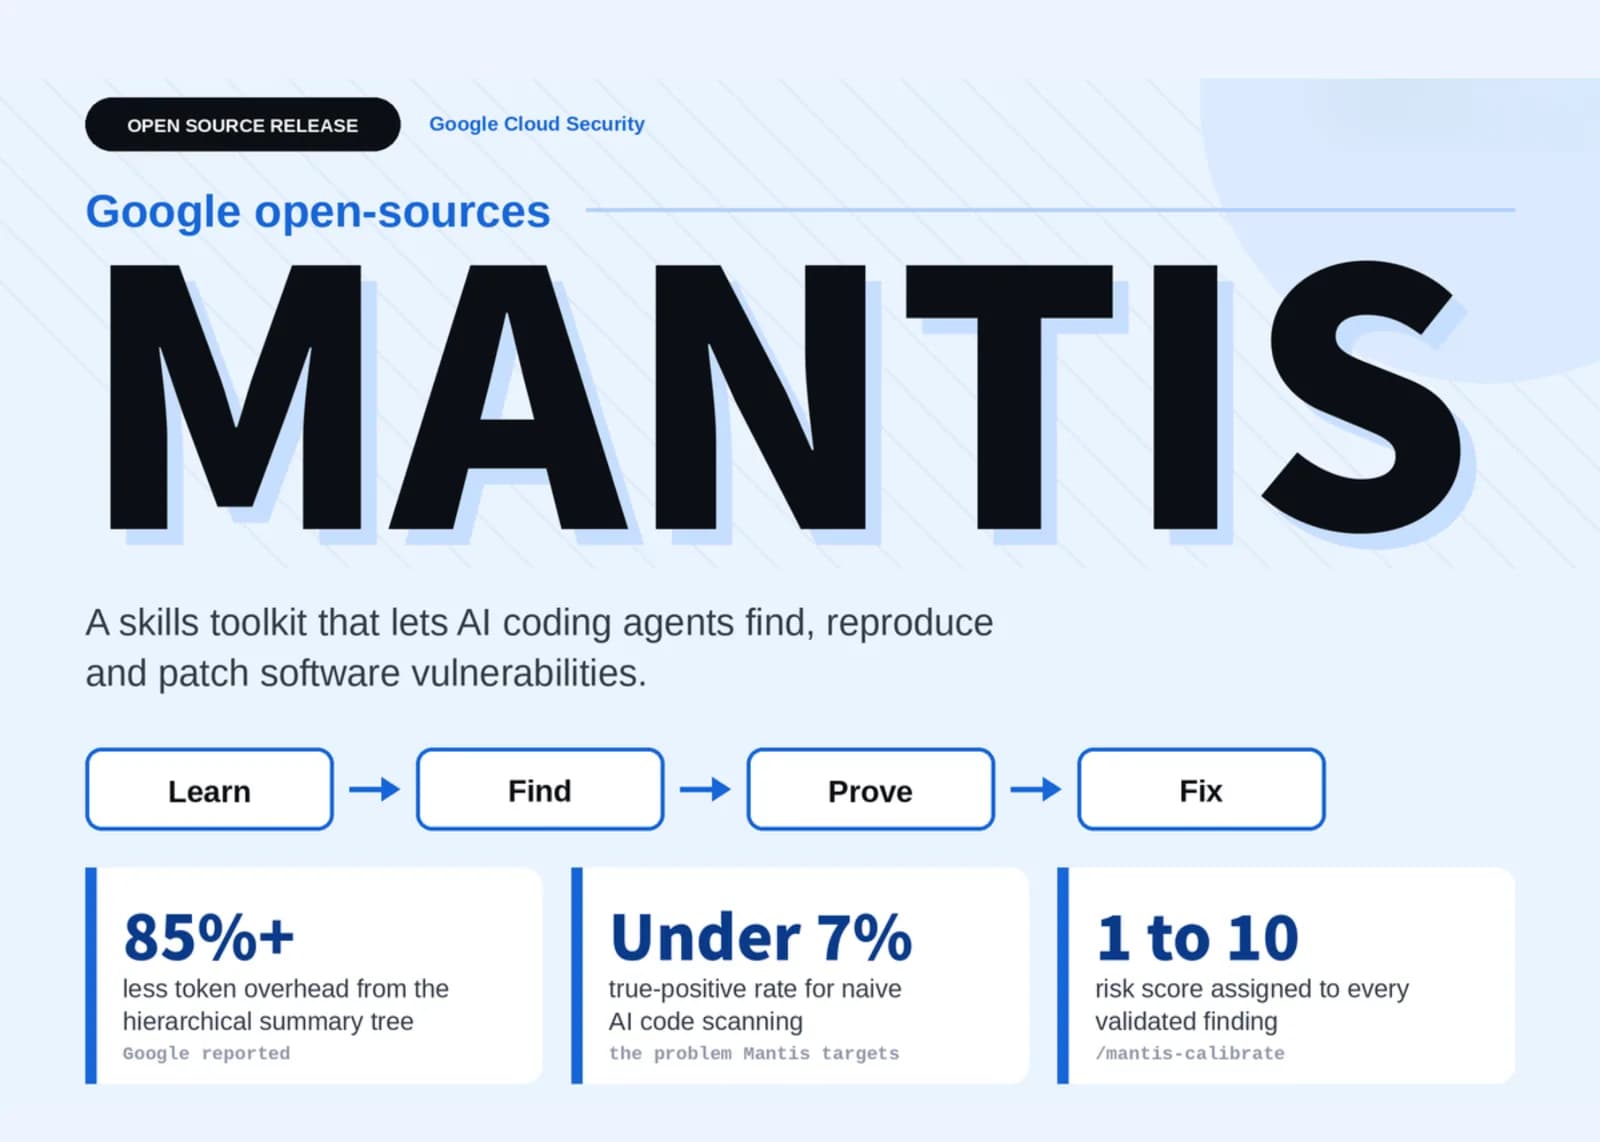
El conjunto de habilidades deja que un agente recorra el ciclo completo de una vulnerabilidad: la encuentra, descarta falsos positivos, la reproduce aislada, escribe el parche y vuelve a atacarlo.
Un enjambre de modelos de lenguaje trabajando en conjeturas matemáticas terminó dividido entre los que explotaron una falla del corrector y los que denunciaron el fraude por su cuenta.
Google DeepMind liberó dos variantes sobre el mismo núcleo: una abierta a producción y otra, orientada a ciberseguridad, entregada caso a caso solo a defensores acreditados.
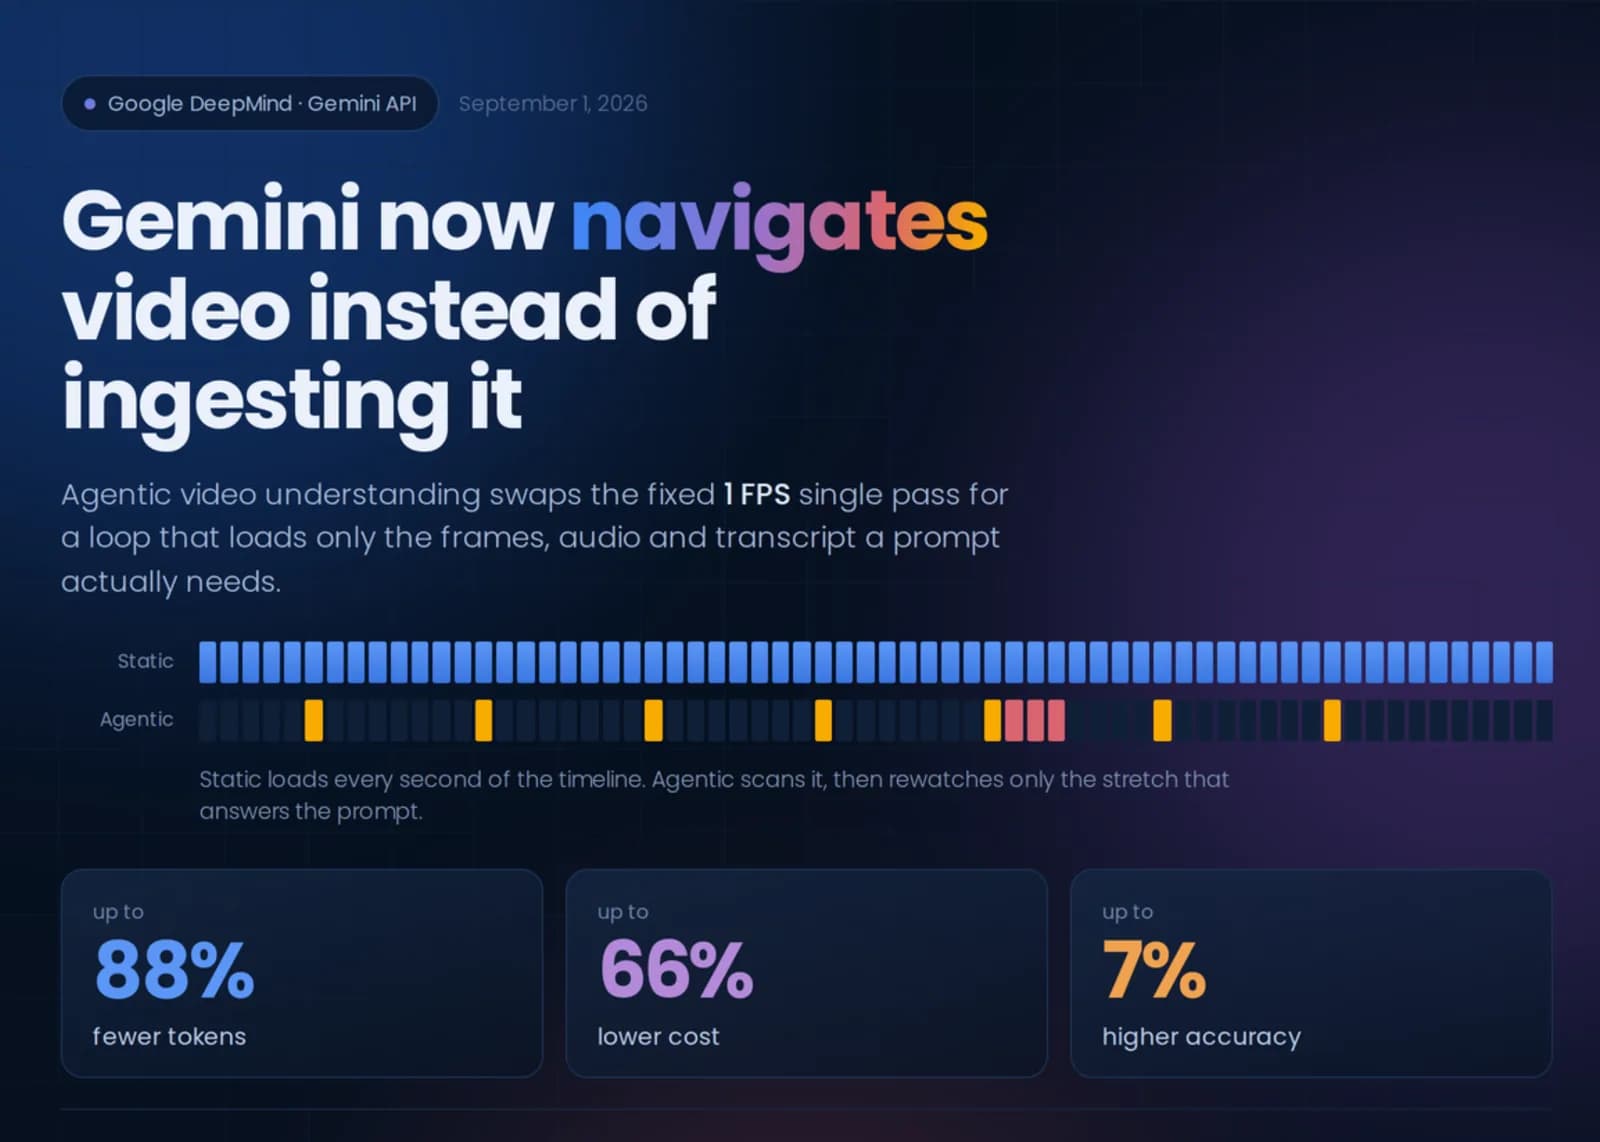
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.
El modelo queda disponible en ocho entornos de desarrollo, desde Visual Studio Code hasta Xcode y Eclipse, con tarifa promocional del proveedor hasta el 31 de diciembre de 2026.
Google presenta su tercer modelo Flash en seis semanas y suma Gemini 3.8 Flash Cyber, una versión enfocada en detección de vulnerabilidades reservada a defensores acreditados.
Google habilita el modo agéntico en Gemini 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite: el modelo elige qué tramos del video revisar y a qué resolución, con una baja de 66% en el costo por consulta.
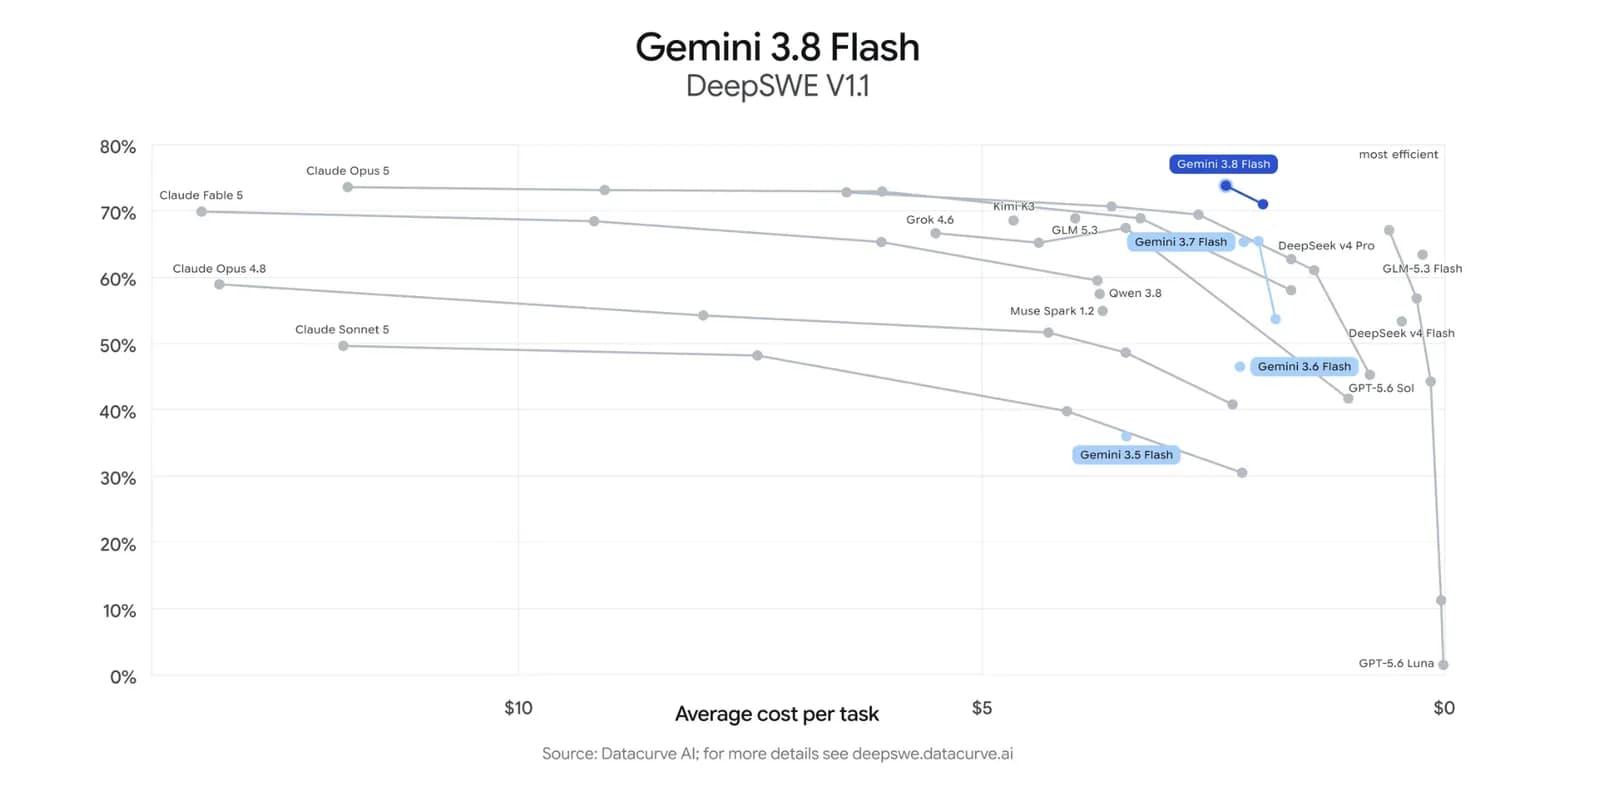
Google publicó su tercer modelo económico en seis semanas, pero el nuevo Flash razona más y quema cerca de 30% más tokens de salida por tarea.
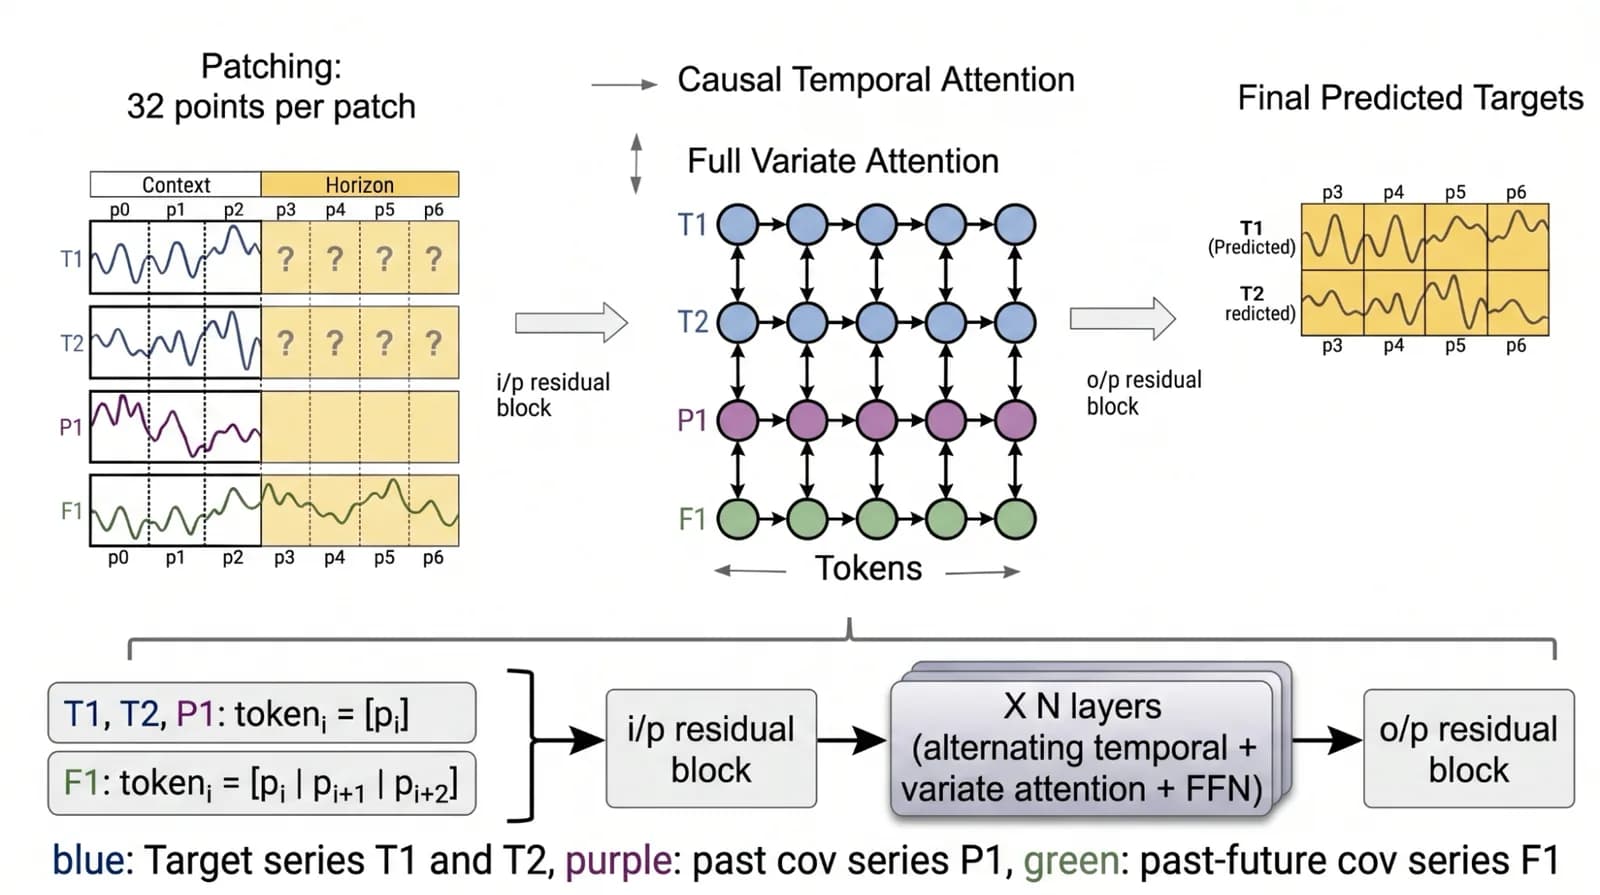
El nuevo modelo base de Google llega con 330 millones de parámetros y entrenamiento sobre más de un billón de puntos temporales, pero sus pesos prohíben el uso comercial.
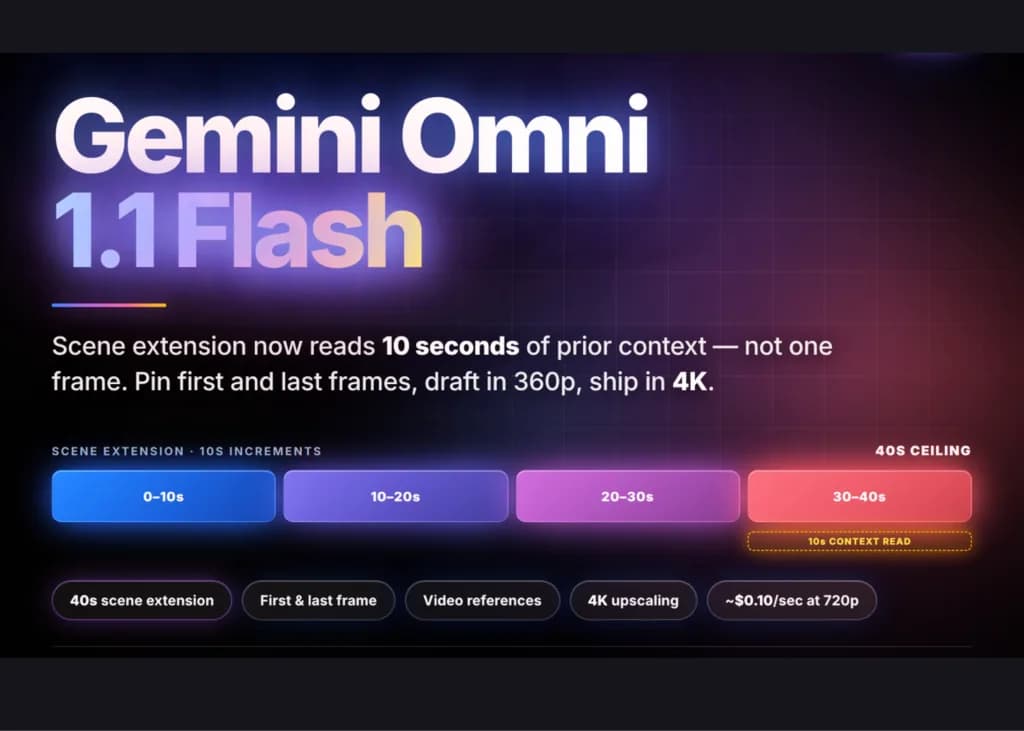
La actualización lee 10 segundos de contexto previo en vez de un solo cuadro final, permite fijar primer y último fotograma, y deja hacer borradores en 360p a un tercio del costo.
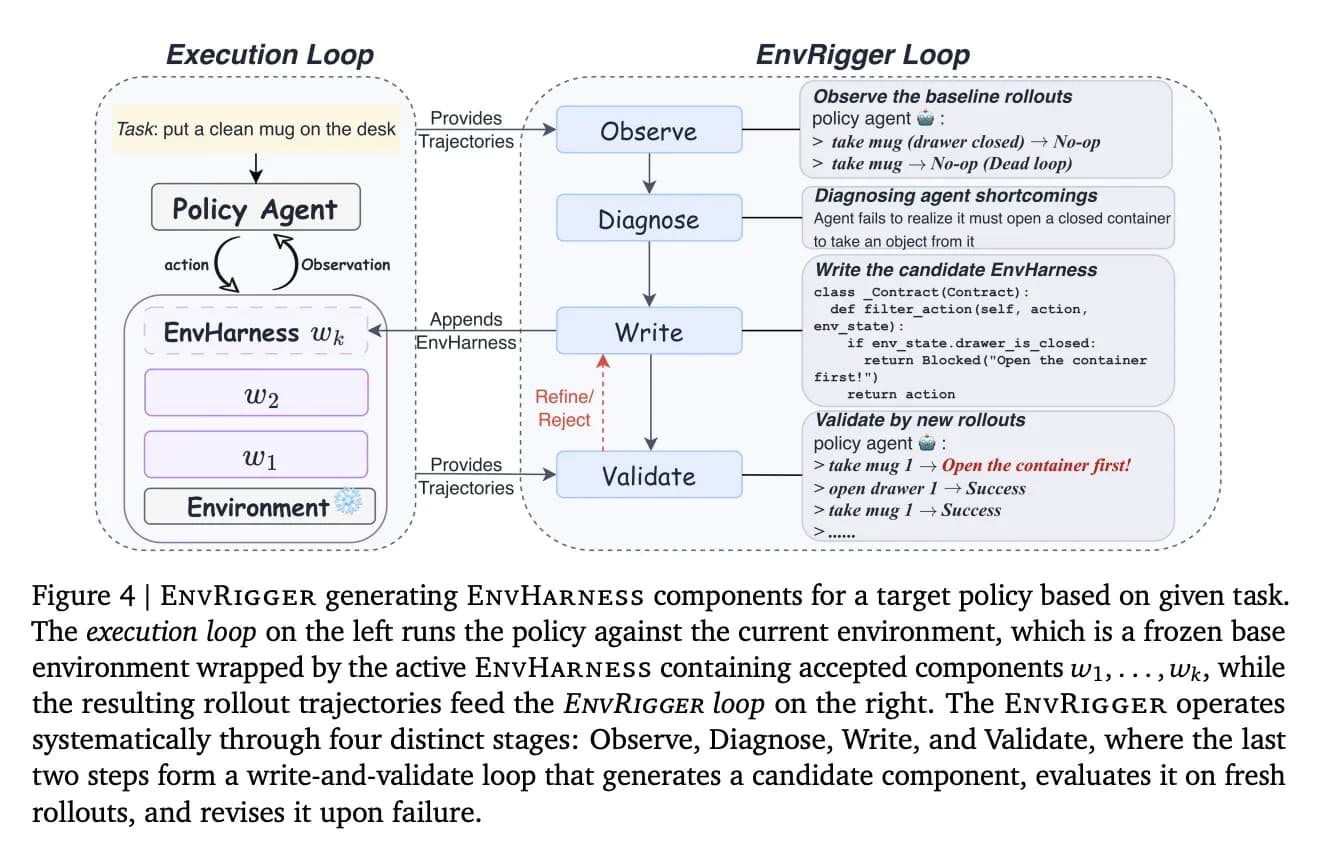
La capa programable envuelve entornos congelados sin tocar el simulador ni los verificadores humanos, y suma hasta 9 puntos en tareas que el agente nunca vio.
La actualización del modelo de video de Google suma borradores en 360p a un tercio del costo, control de fotogramas inicial y final, y escalado final a 4K.
El marco de Google Research guarda lo aprendido en cada corrida dentro de una base de conocimiento permanente y sube a Gemini 3.5 Flash de 49,5% a 68,1% de promedio.
Google separó su nuevo modelo de voz a texto en dos endpoints con capacidades distintas, y esa división es la decisión de arquitectura que hay que planificar antes de escribir la primera línea.
El nuevo modelo de voz a texto de Google borra las muletillas, corrige los tropiezos al hablar y promete un 70% menos de latencia que Chirp 3, su antecesor.
Google presentó el modelo apenas tres semanas después de Gemini 3.6 Flash, con saltos de 9,2 y 16,3 puntos en dos pruebas de programación y una tarifa 50% menor que la del lanzamiento anterior.
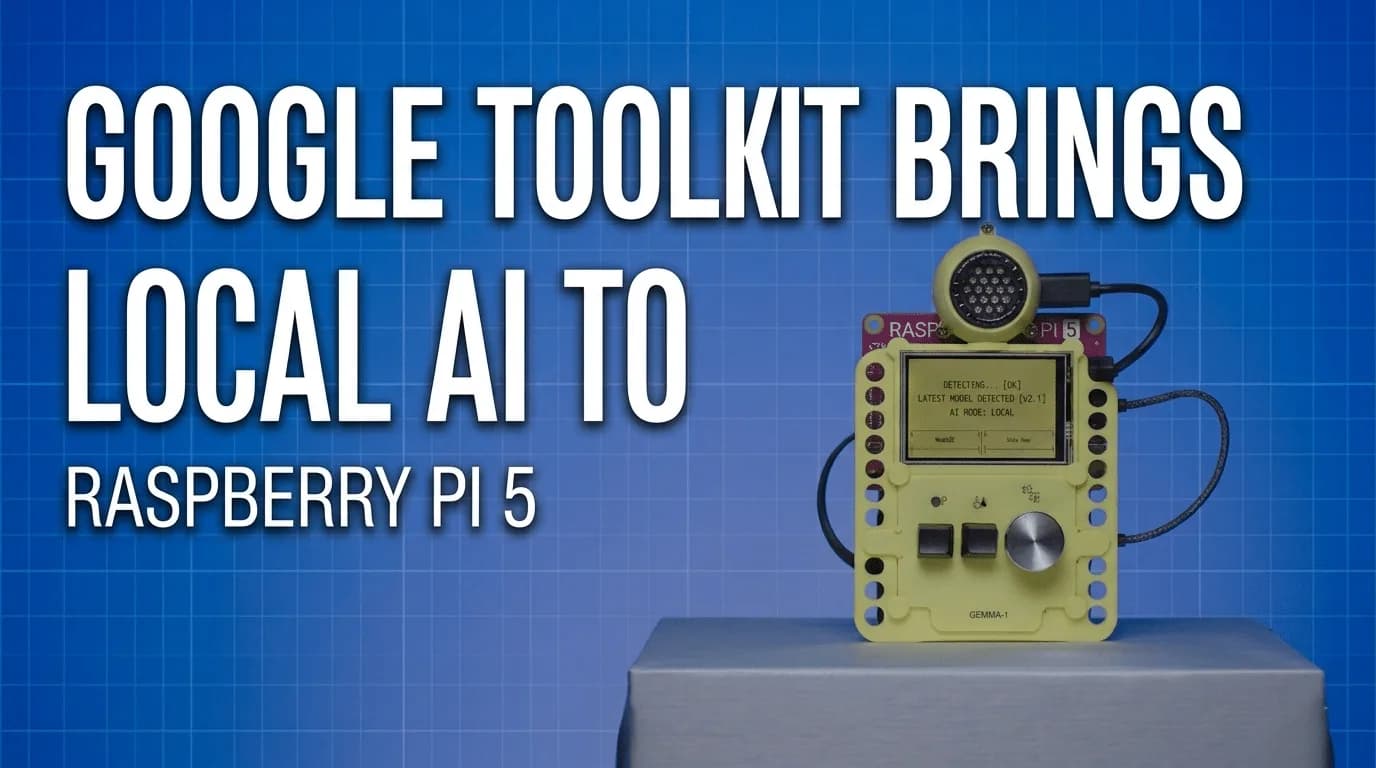
El tutorial oficial de Raspberry Pi mide 433,17 tokens por segundo de prefill con Gemma 3 270M sobre la placa de 8 GB, sin enviar una sola consulta a la nube.
La función permitía redibujar cualquier punto del planeta con Nano Banana 2, y los usuarios demostraron en cuestión de horas lo fácil que era fabricar imágenes satelitales falsas convincentes.
Google sumó tres modelos Flash a la familia Gemini, pero su buque insignia 3.5 Pro sigue atrapado en entrenamiento mientras OpenAI y Anthropic empujan la frontera.
El chip, atribuido a Jeff Dean, grabaría el plano de Gemini en el hardware para ser 6 a 10 veces más eficiente que los TPU actuales. Google lo desplegaría desde 2028 para abaratar la inferencia.
Google cambió la forma de medir el uso de sus apps de IA: ahora cuenta la potencia de cómputo de cada petición y no la cantidad de solicitudes.
Google publicó una revisión de su modelo abierto que activa Flash Attention 4, corrige fallos en el llamado a herramientas y elimina respuestas cortadas, todo bajo el mismo nombre.
El asistente agéntico 24/7 de Google desembarca en el desktop de Apple, integra la app de notas Keep que faltaba desde su lanzamiento y abre soporte a MCP para conectar apps de terceros.
Google añade a la familia Nano Banana un modelo económico enfocado en pipelines de alto throughput y estrena Gemini Omni Flash para generar y editar video de hasta 10 segundos vía API.
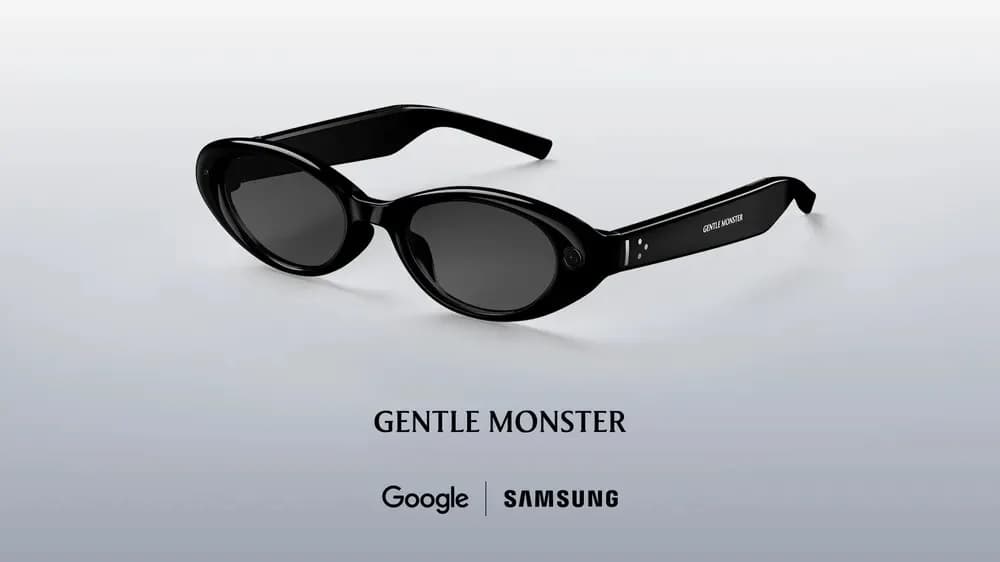
El prototipo con pantalla en la lente derecha proyecta direcciones de Google Maps, traduce conversaciones en tiempo real y se activa con presión larga en la patilla derecha.
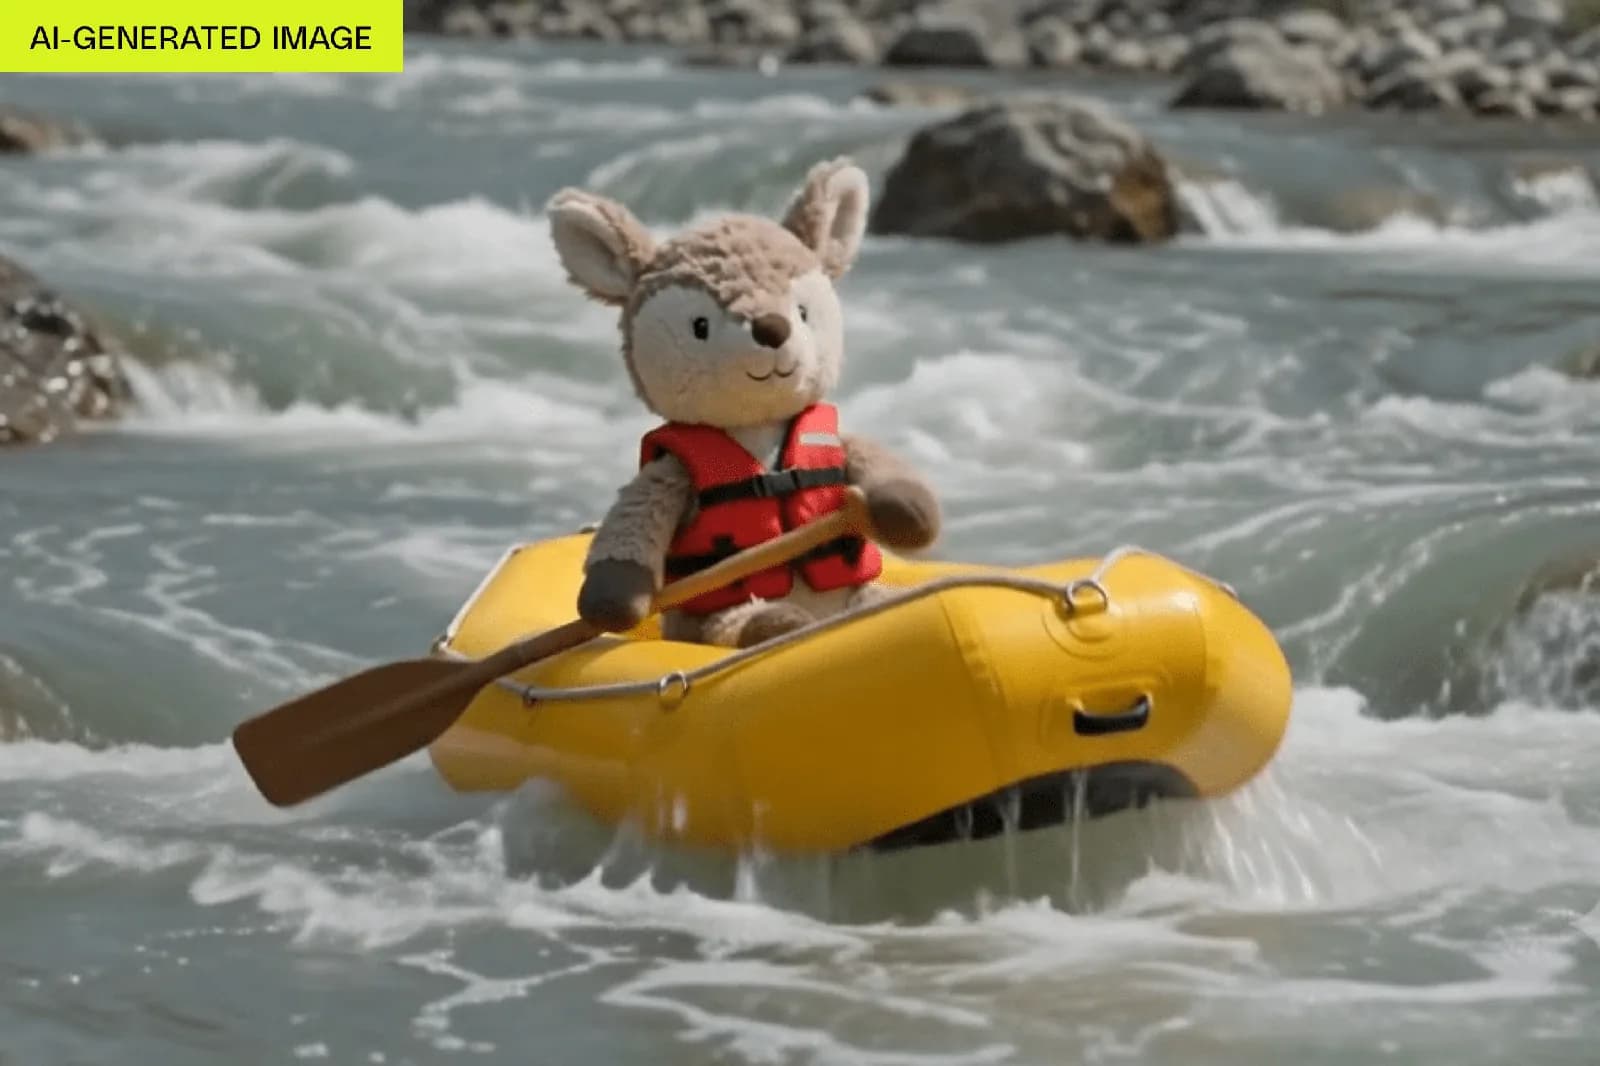
El primer modelo de la familia Gemini Omni sucede a Veo en la plataforma Flow y ya hace video-a-video con consistencia notable, aunque sigue cobrando 15 a 40 créditos por clip.
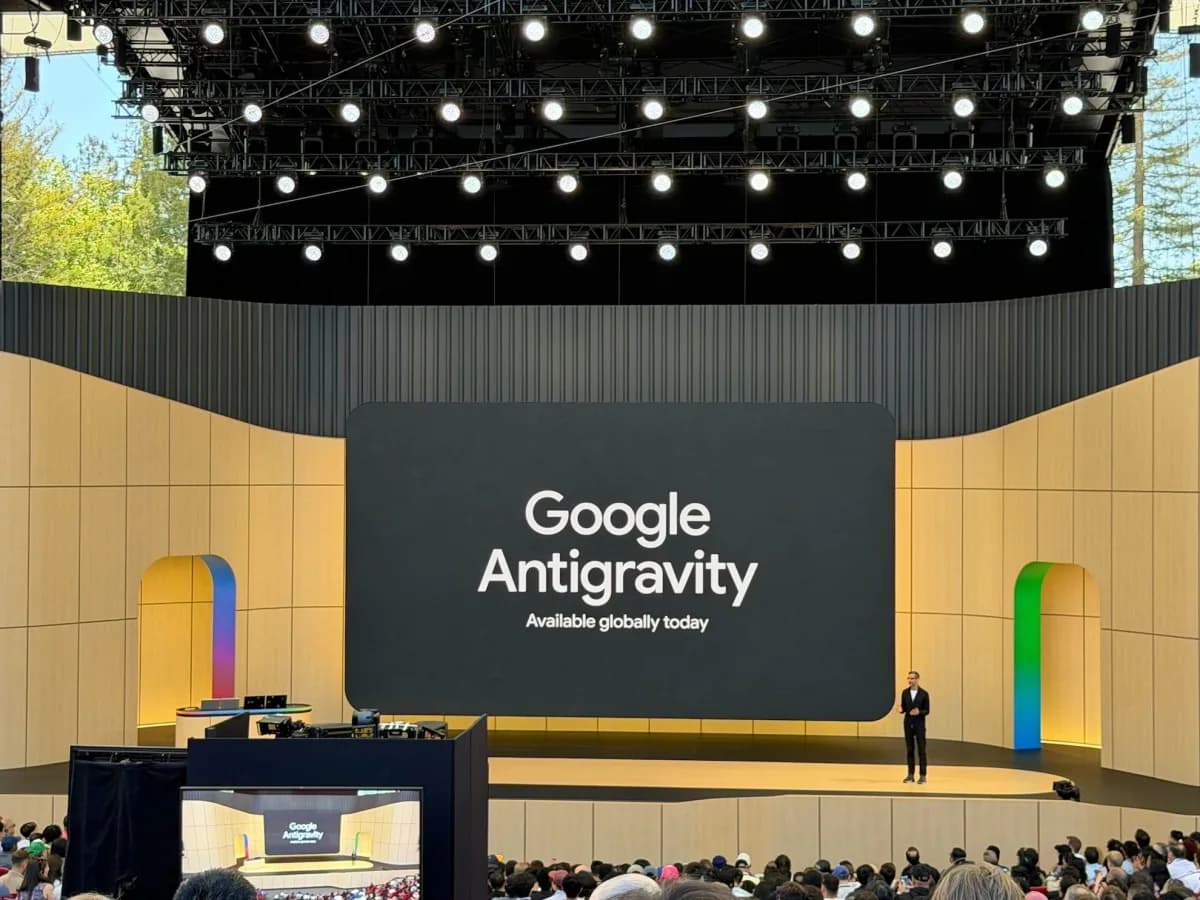
La app agéntica de codificación suma escritorio rediseñado, agentes en background y voz nativa apoyados en Gemini 3.5 Flash; el plan Ultra superior baja de USD 250 a USD 200.
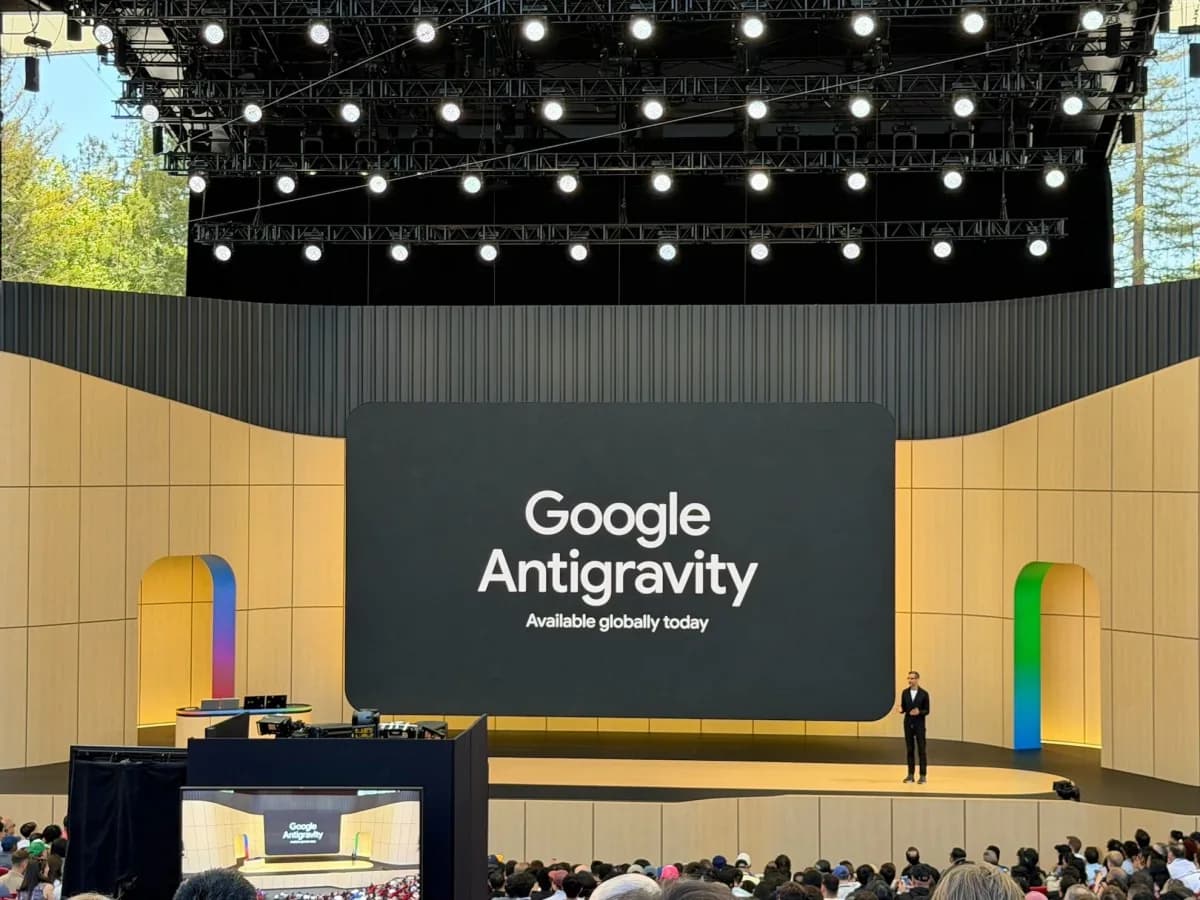
Coding agentic con orquestación multiagente, comandos por voz y exportación a AI Studio. La nueva versión usa Gemini 3.5 Flash y compite directo con Cursor y Claude Code.
Simon Willison desarma el lanzamiento: GA sin preview, USD 1,50 input y USD 9 output por millón de tokens, cerca del 3.1 Pro mientras Google lo regala en sus productos de consumo.
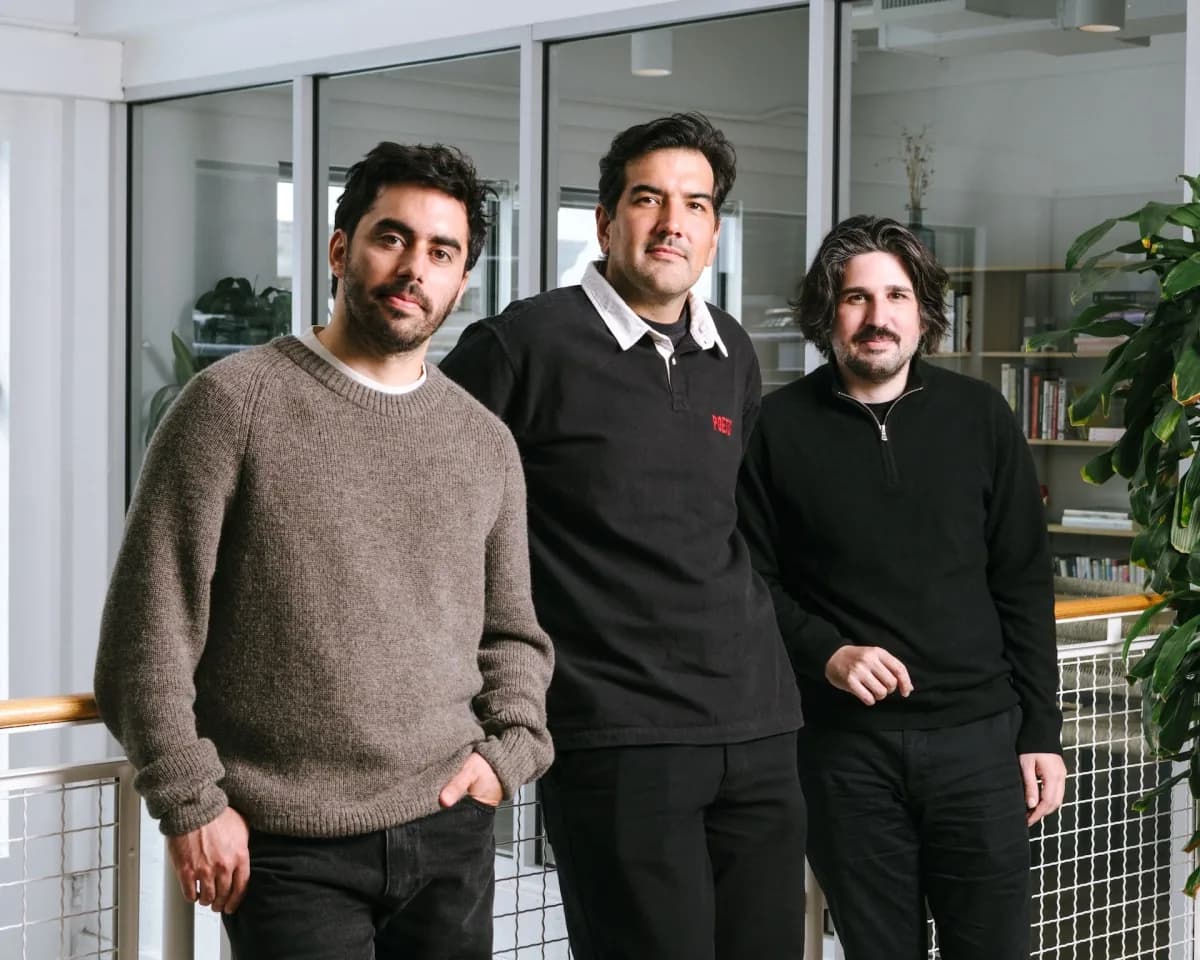
Cristobal Valenzuela y Alejandro Matamala Ortiz, ambos de Santiago, junto al griego Anastasis Germanidis ya recaudaron USD 860 millones. La estrategia: entrenar IA con video, no con texto.
El prototipo de Google DeepMind convierte el puntero del mouse en una entrada multimodal con conciencia visual y semántica de la pantalla, sin pedir un prompt detallado.
Otros temas que aparecen junto a #google en nuestra cobertura editorial.