La alemana Aleph Alpha publicó Kolibri, un modelo de lenguaje en alemán e inglés con 78.000 millones de parámetros. Gracias a una arquitectura de mezcla de expertos (MoE), solo unos 3.000 millones quedan activos por cada token, informó The Decoder el 5 de octubre de 2026.
Los pesos están en Hugging Face con licencia Apache 2.0, que permite uso comercial.
¿Qué promete Kolibri frente a otros modelos?
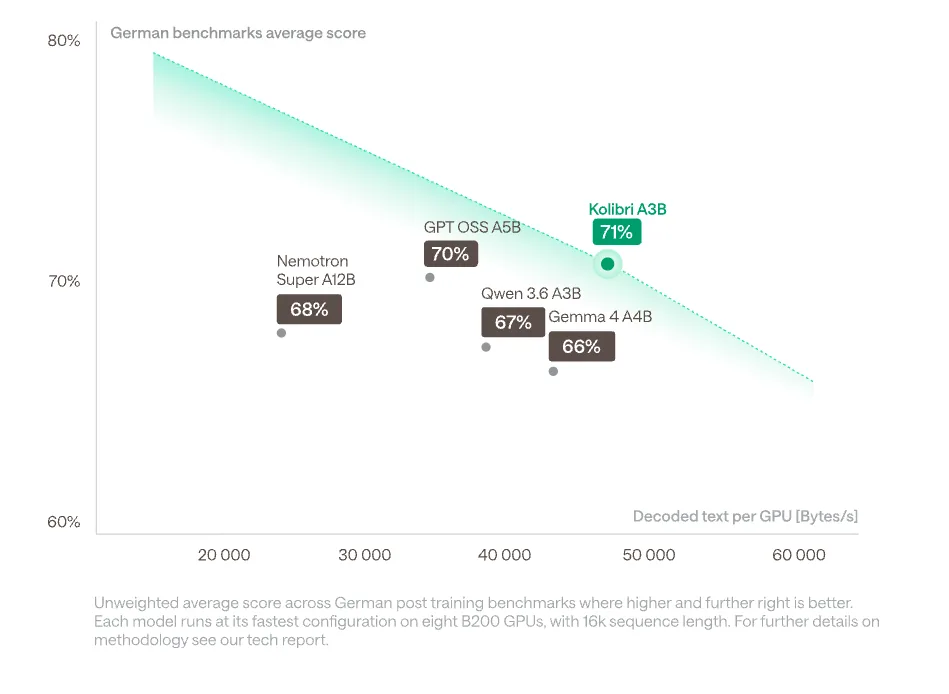
Aleph Alpha sostiene que Kolibri se ubica en la frontera de Pareto entre calidad y costo de operación en los dos idiomas. Según la empresa, supera a los modelos de arquitectura parecida con los que se comparó en una de esas dos métricas. Algunos de esos modelos son bastante más antiguos, de marzo y abril de 2026.
De acuerdo con el gráfico que publicó la compañía, Kolibri obtiene un 71% en pruebas de alemán y decodifica más rápido que GPT OSS A5B, Qwen 3.6 A3B y Gemma 4 A4B, tres modelos de tamaño activo comparable.
Datos en alemán y datos sintéticos
El alemán representa el 21,3% de los datos de entrenamiento. Para lograrlo, Aleph Alpha armó una cadena de procesamiento de datos dedicada solo a ese idioma. La empresa también usó modelos chinos para generar parte de los datos sintéticos con que se entrenó Kolibri.
Hardware, contexto y a quién apunta
Según el informe técnico, el modelo se entrenó en 768 GPU B200 ubicadas en Alemania y Finlandia. Admite ventanas de contexto de hasta un millón de tokens.
Aleph Alpha dice que Kolibri apunta a la administración pública, la aviación y la industria. Se desarrolló bajo la ley europea y teniendo en cuenta el Reglamento de IA de la Unión Europea (EU AI Act).
El contexto de la empresa
El lanzamiento llega seis meses después de que la canadiense Cohere acordara comprar Aleph Alpha, en abril de 2026, en una operación que valoraba a la compañía combinada en unos 20.000 millones de dólares, según informó The Decoder entonces. A esa altura Aleph Alpha había dejado la carrera por construir grandes modelos de lenguaje propios y se había separado de su fundador, Jonas Andrulis.