Google presentó dos modelos nuevos de texto a voz para la familia Gemini, Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Según la empresa, son sus modelos de generación de audio más expresivos hasta ahora. Permiten crear voces de personajes a medida y dirigir diálogos de una escena, y están disponibles en Google AI Studio, la API de Gemini, Gemini Enterprise, Gemini Notebook y Google Vids.
Los dos modelos pasan la generación de voz de un catálogo de voces fijas a algo parecido a un estudio de grabación. Google los integra además en productos propios como Gemini Notebook y Google Vids.
- Gemini 3.8 Flash TTS está pensado para dirección creativa y diseño de personajes. Crea voces nuevas desde cero con instrucciones en lenguaje natural, para videojuegos, audiolibros, pódcasts y medios interactivos. Cada línea se dirige por separado, con control sobre indicaciones de actuación, ritmo, cambios de dialecto y las interjecciones que marcan escucha activa.
- Gemini 3.8 Flash-Lite TTS apunta a volumen alto y costo bajo. Está optimizado para doblaje masivo, creación de contenido en audio y agentes de voz, con control fino de tono, ritmo y matices.
Los modelos se suman a la familia Gemini Audio, después de 3.5 Live Translate, 3.5 Transcribe y 3.8 Live y 3.8 Live Extended Thinking.
¿Cómo se crean y se personalizan las voces?
El catálogo pasa de 30 voces originales a una biblioteca sin límite. Estas son las funciones que anunció Google.
- Diseño generativo de voz. Con Gemini 3.8 Flash TTS se crean voces a medida definiendo el rol, el acento y las características de la voz, en más de 100 idiomas y dialectos, con instrucciones en lenguaje natural. Google muestra como ejemplos la voz de un DJ de Melbourne con mucha energía, la de un robot metálico y monótono, y la de un dragón japonés.
- Biblioteca de voces. Más de 2.000 voces listas para producción, con variantes regionales como el español de México, el francés de Quebec y el inglés de Escocia.
- Clonación de voz. Reproduce un perfil vocal a partir de una muestra de 30 segundos de la propia voz o de una voz sobre la que se tengan derechos. Incluye verificación de consentimiento, marca de agua SynthID y credenciales C2PA.
- Guardado. Las voces diseñadas se guardan y se administran, para que suenen igual en proyectos largos sin que se deformen con el tiempo.
- Remezcla de voz. Llegará más adelante. Permitirá tomar una voz de la biblioteca y ajustar timbre, tono, velocidad y acento con instrucciones como "agrega un leve acento del sur de Estados Unidos" o "suaviza la entrega".
Dirección de la actuación, línea por línea
Una vez elegidas las voces, los dos modelos permiten controlar cómo se dice cada línea.
- Dirección por línea. Se pueden escribir acotaciones propias o dejar que Gemini ajuste la entrega a partir de indicaciones en el guion, desde un agente de atención al cliente tranquilo hasta una escena de suspenso susurrada.
- Audio largo. Mantiene la calidad, el ritmo y el timbre del personaje durante horas de audio continuo, con poca deriva del hablante. Google lo apunta a pódcasts y audiolibros.
- Escenas con dos hablantes. Dirige conversaciones de varios turnos desde un solo guion, con las dos voces bien separadas y turnos de habla naturales.
- Sonidos no verbales. Agrega textura con marcas como
<laughs>,<sigh>o<gasp>e interjecciones de escucha activa como|mhm|o|yeah|, para ajustar tiempos de comedia y reacciones.
¿Cómo rinde frente a la competencia?
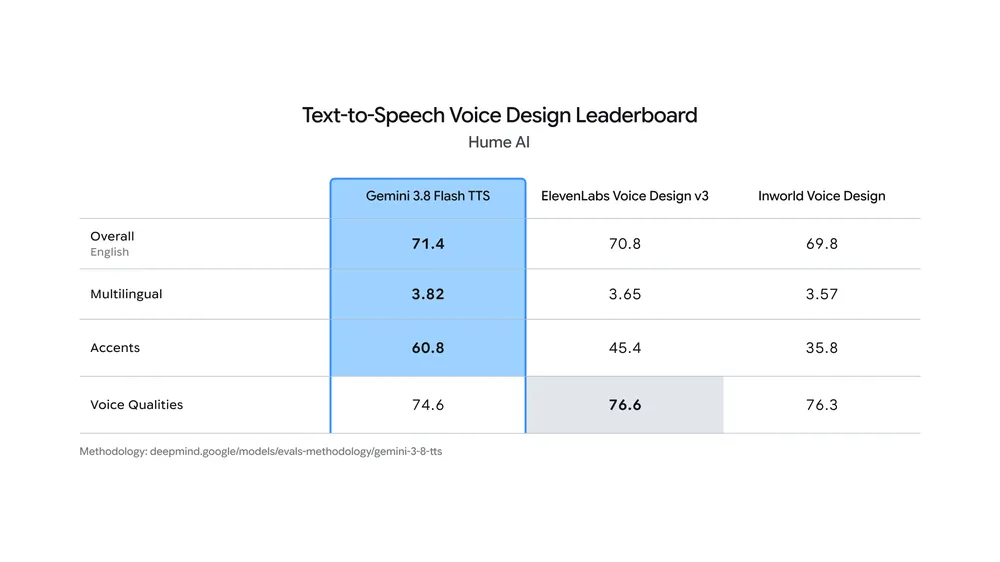
Según Google, Gemini 3.8 Flash TTS ocupa el primer lugar general en el Voice Design Benchmark de Hume AI, con 71,4 puntos, y también lidera en modelado de acentos, con 60,8.
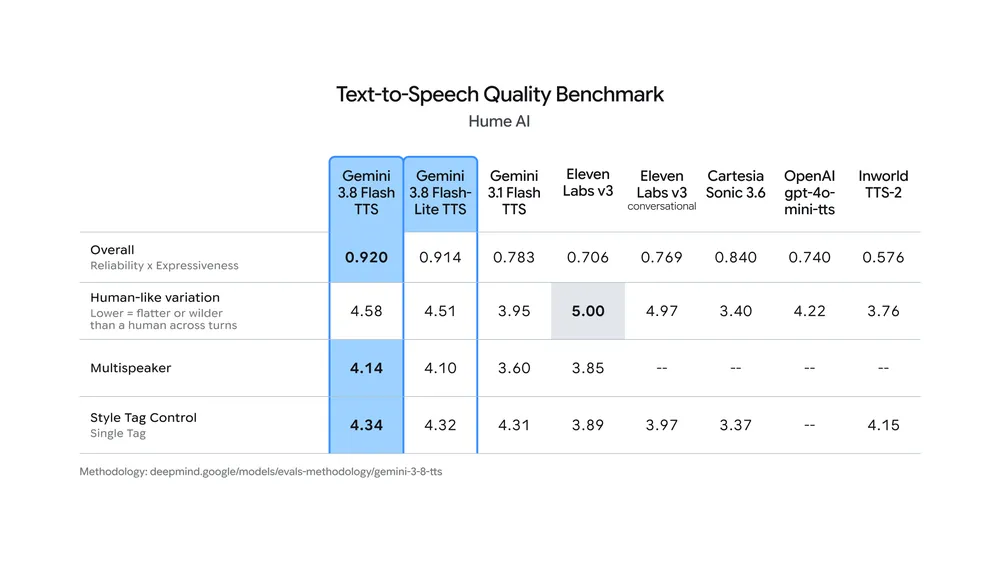
Flash TTS y Flash-Lite TTS quedaron primero y segundo, respectivamente, en el Overall Quality Index de Hume AI. Google informa mejoras grandes frente a Gemini 3.1 Flash TTS en contenido largo y en el control de guiones con dos hablantes.
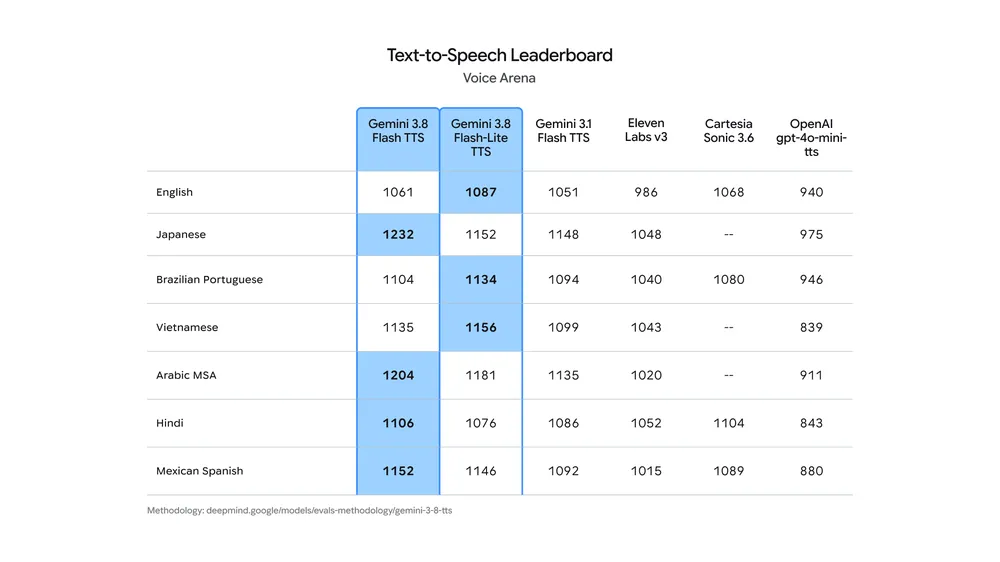
En las evaluaciones ciegas de preferencia humana de Voice Arena, los dos modelos quedaron en los primeros puestos en japonés, portugués de Brasil, vietnamita, árabe estándar moderno, español de México e hindi.
¿Qué protecciones trae la clonación de voz?
Google dice que la creación y la clonación de voces tienen salvaguardas para proteger a los locutores, respetar la identidad y transparentar el contenido. Para clonar una voz, el sistema exige una grabación de consentimiento hablada del dueño de la voz, que tiene que coincidir con el hablante de la muestra de referencia.
Todo clip de audio que generan los modelos Gemini Audio lleva la marca de agua SynthID, imperceptible e incrustada en el propio audio, para que la voz generada por IA siga siendo detectable. El detalle del enfoque de seguridad está en la ficha del modelo.
Dónde se puede probar
Desde este 23 de septiembre, los desarrolladores pueden probar la generación de voz en Google AI Studio. El espacio funciona como un taller de diseño de voz, donde se crean identidades vocales nuevas o se clona la propia voz y luego se llevan a un editor de guiones para dos hablantes.
A través de la API de Gemini, plataformas como Agora, LiveKit, Pipecat y Vercel ya permiten montar servicios de generación de voz.
Google además trabaja con Figma, HeyGen, Linguana, Wondercraft, 99.co y Ollang, que integran estos modelos para doblaje, localización de contenido con acentos regionales y agentes de voz conversacionales.