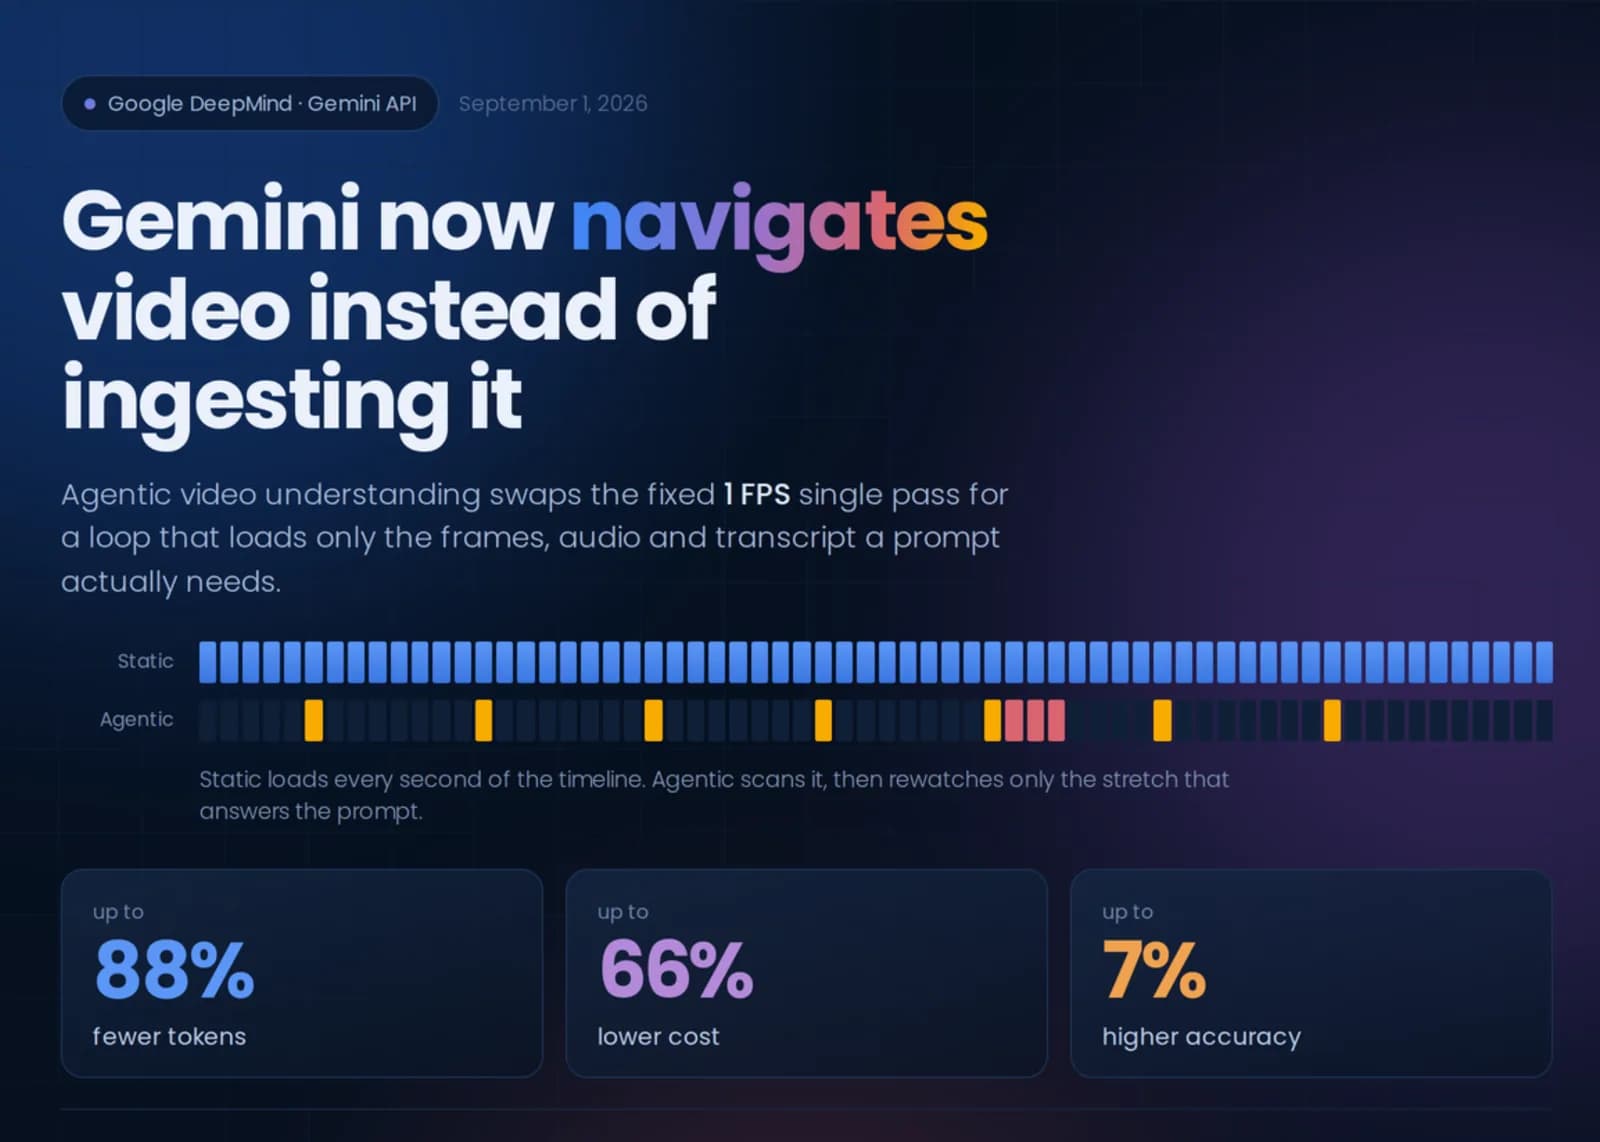
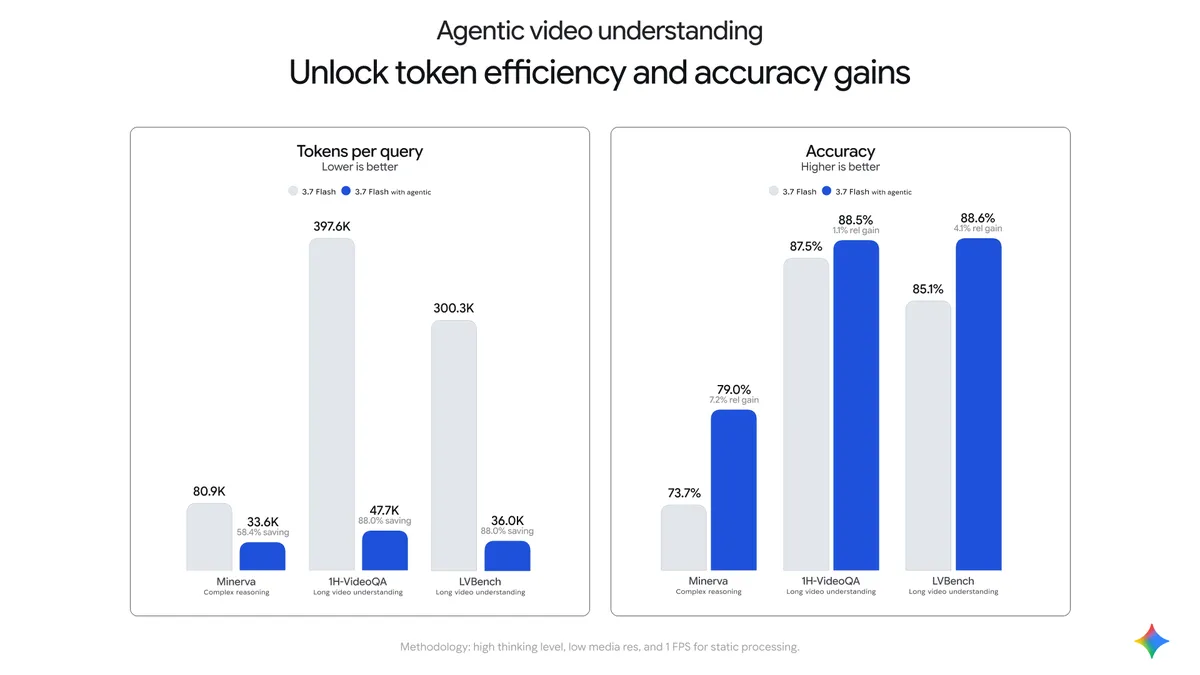
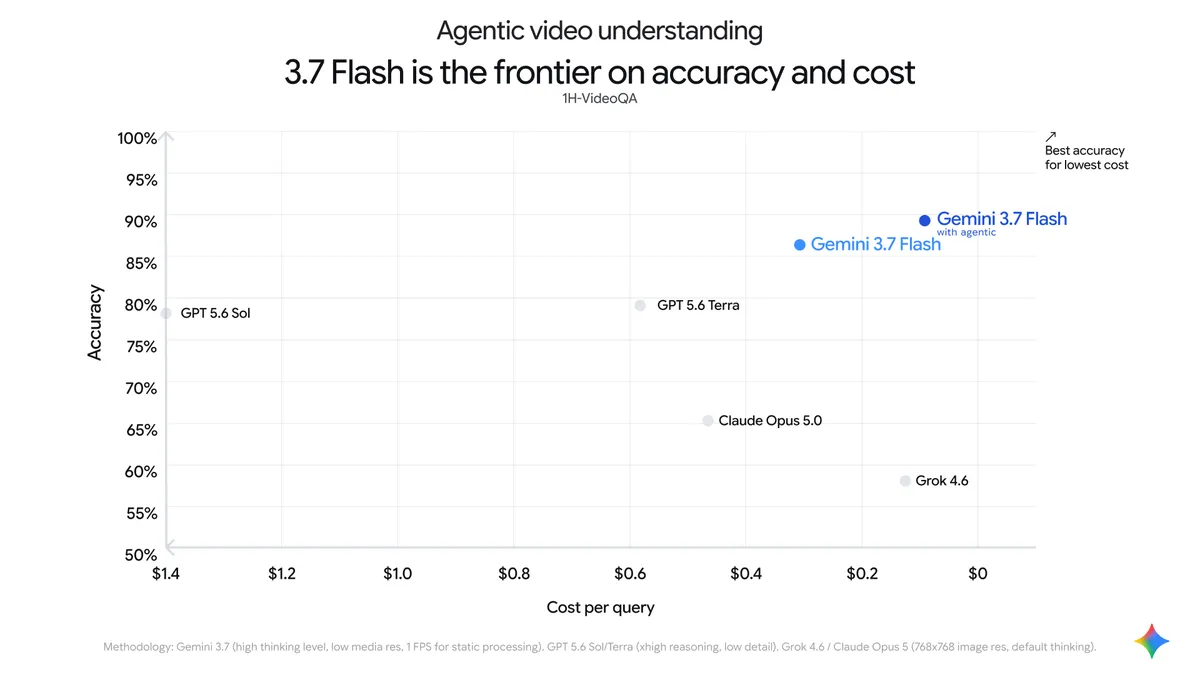
Google acaba de lanzar la comprensión agéntica de video para Gemini 3.7 Flash, Gemini 3.6 Flash y Gemini 3.5 Flash-Lite. La función permite que el modelo escanee segmentos del video de forma dinámica, lo que mejora la exactitud a la vez que recorta el consumo de tokens hasta en 88% y los costos hasta en 66%. Google añade que la calidad de las respuestas sube hasta 7%.
¿Cómo se activa?
Se puede empezar a usar hoy configurando la API en modo agéntico, ya sea desde Google AI Studio o desde la Gemini Enterprise Agent Platform. En la práctica se trata de un solo campo dentro de la entrada de tipo video:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.7-flash",
    input=[
        {
            "type": "video",
            "uri": "https://youtu.be/7Z5Vy9JBANs",
            "processing": "agentic"
        },
        {
            "type": "text",
            "text": "¿Cuáles son los 3 anuncios más importantes de esta charla?",
        },
    ],
)

print(interaction.output_text)
El resto del flujo no cambia: se entrega la dirección del video, se hace la pregunta en texto y se lee la salida del modelo.
¿Por qué el ahorro es tan grande?
El video es la modalidad más cara de todas las que procesa un modelo de lenguaje, porque cada segundo se convierte en fotogramas y cada fotograma en tokens. El enfoque tradicional obliga a ingerir la pieza completa aunque la respuesta esté en veinte segundos del minuto cuarenta. El modo agéntico invierte esa lógica: el modelo decide qué tramos vale la pena mirar.
La aritmética ayuda a dimensionarlo. Sobre una consulta que antes gastaba 100.000 tokens, un recorte de 88% la deja en 12.000. Ese es el orden de magnitud que separa un prototipo que se puede dejar corriendo de uno que solo se enciende para la demostración.
¿Por qué el costo baja menos que los tokens?
Hay un detalle en las cifras que conviene no pasar por alto: el ahorro en tokens llega a 88%, pero el ahorro en costos llega a 66%. La brecha entre ambos números es esperable, porque el escaneo dinámico agrega trabajo propio, decidir qué segmentos revisar y pedirlos, y ese trabajo también se cobra. Dicho de otro modo, el ahorro nominal en el contador de tokens no se traslada uno a uno a la factura.
Para equipos de la región que facturan en dólares y evalúan análisis de video a escala, videovigilancia, revisión de grabaciones de atención, control de calidad en línea de producción, esa diferencia entre 88% y 66% es exactamente la que hay que meter en la planilla, no la más vistosa de las dos.
¿Para qué sirve en la práctica?
Google enumera cuatro usos donde el modo agéntico cambia el resultado, no solo la factura.
- Encontrar un instante preciso. El muestreo fijo de un fotograma por segundo se salta cambios de estado y cortes de edición que duran menos que eso.
- Buscar una aguja en un pajar de horas. Responder una pregunta puntual sobre una grabación larga sin gastar millones de tokens.
- Detectar anomalías. El modelo vuelve a mirar los tramos que le parecen raros a más fotogramas por segundo, para revisar movimientos rápidos.
- Contar acciones y objetos. Seguir movimientos repetidos y objetos distintos a lo largo del video.
¿Cuánto cuesta y dónde llega?
Se cobra con el precio normal de tokens de la API de Gemini, sin cargo aparte por la función. Funciona en Gemini 3.7 Flash, 3.6 Flash y 3.5 Flash-Lite.
Google adelantó dos despliegues. La función llegará a todos los usuarios de la aplicación de Gemini en los modelos Flash y Flash-Lite, y en los próximos meses moverá la función Ask YouTube de la página de reproducción, para responder preguntas apoyándose en lo que se ve en el video.