Saltar al contenido
Etiqueta

#multimodal

14 notas publicadas

Qwen-Drive 1.0 explica por qué frena, pero no siempre acierta
IA

Qwen-Drive 1.0 explica por qué frena, pero no siempre acierta

El modelo de Alibaba unifica percepción espacial, preguntas de tránsito y planificación de ruta, y bajó del 24% al 12% las salidas de calzada en simulación.

The Decoder
NeoMME: Encoders multimodales eficientes sin visión tower
IA

NeoMME: Encoders multimodales eficientes sin visión tower

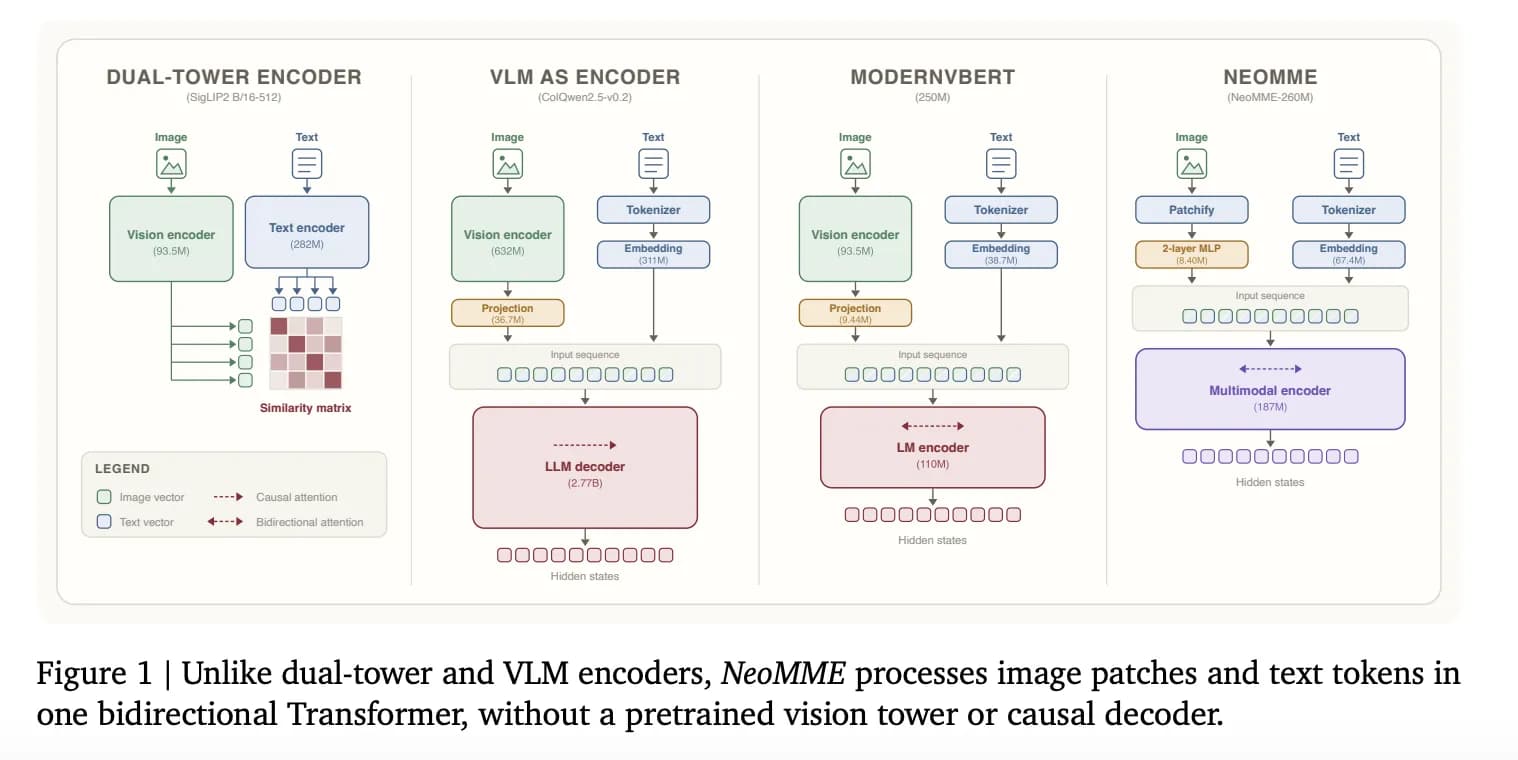
H Company presenta NeoMME, una familia de encoders multimodales que elimina la visión tower y el decoder causal para mejorar la eficiencia en tareas de recuperación.

MarkTechPost
Gemini navega el video y recorta hasta 88% de los tokens
IA

Gemini navega el video y recorta hasta 88% de los tokens

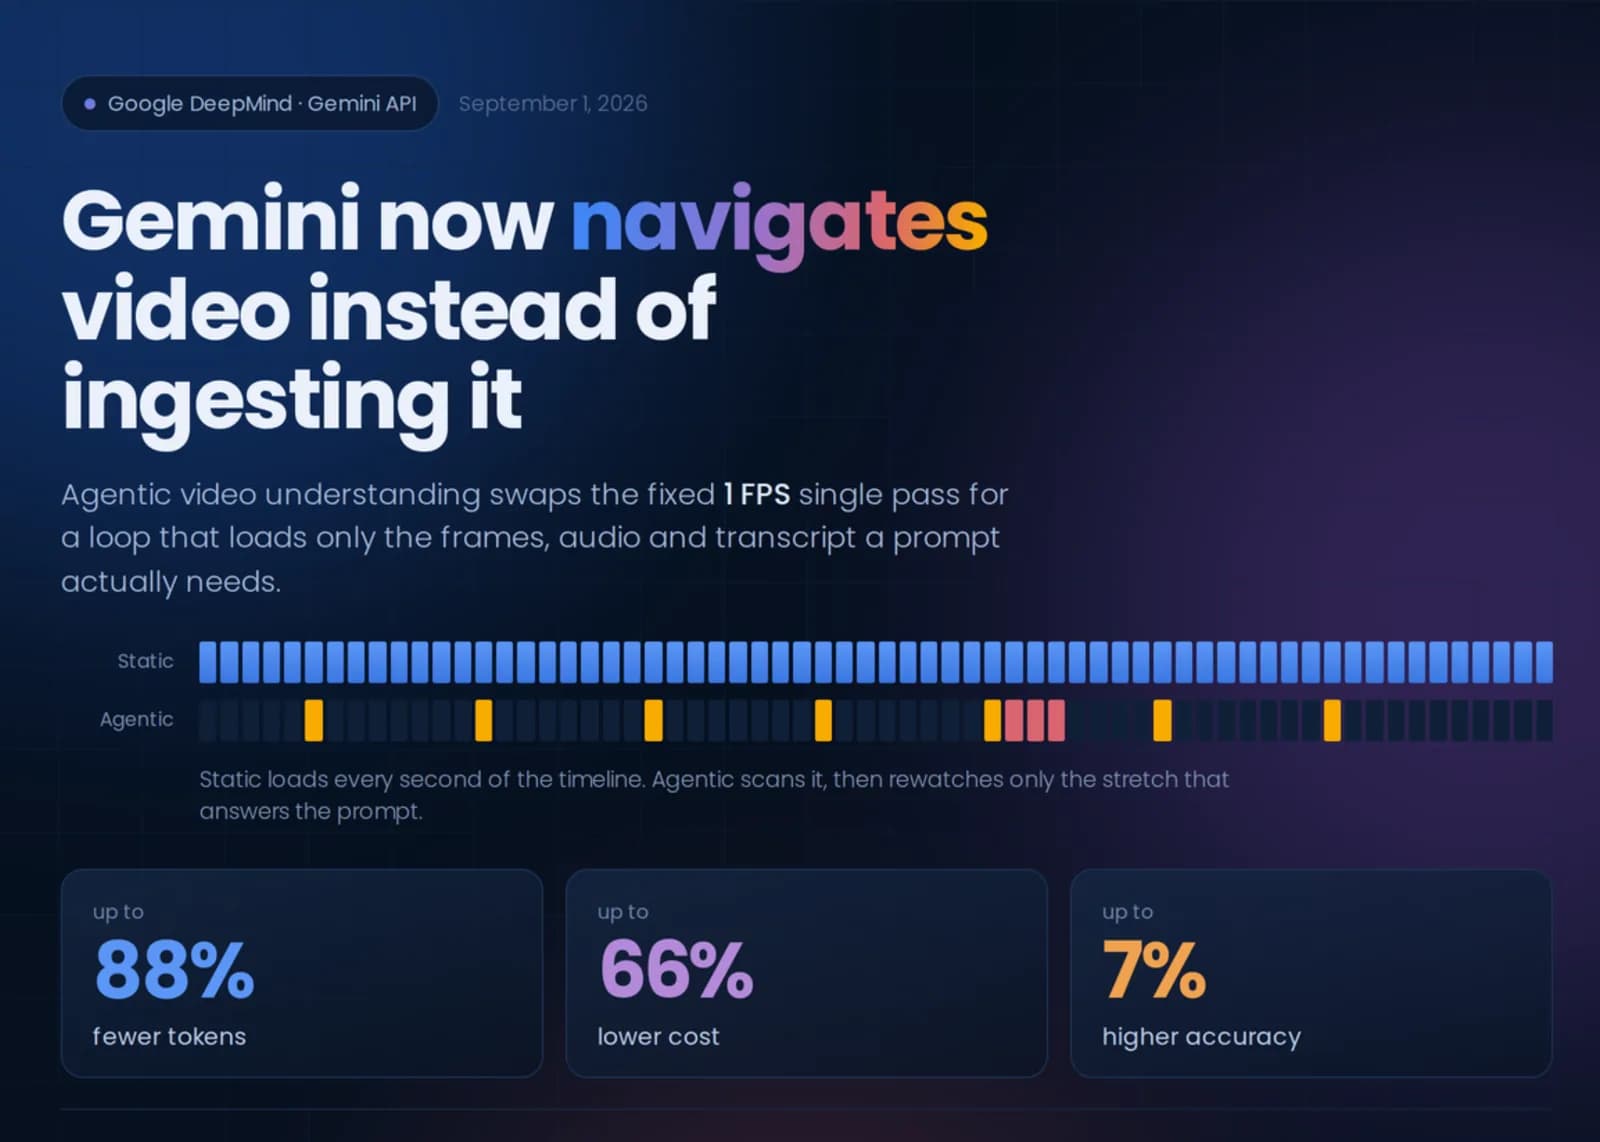
Google habilitó el modo agéntico de comprensión de video en sus modelos Flash: en vez de tragarse la línea de tiempo completa a un cuadro por segundo, el modelo decide qué mirar.

MarkTechPost
Gemini analiza video por segmentos y recorta 88% de tokens
IA

Gemini analiza video por segmentos y recorta 88% de tokens

La nueva función agéntica deja que el modelo decida qué tramos del video revisar, en vez de ingerir el archivo completo, y baja los costos hasta 66% según Google.

Google DeepMind
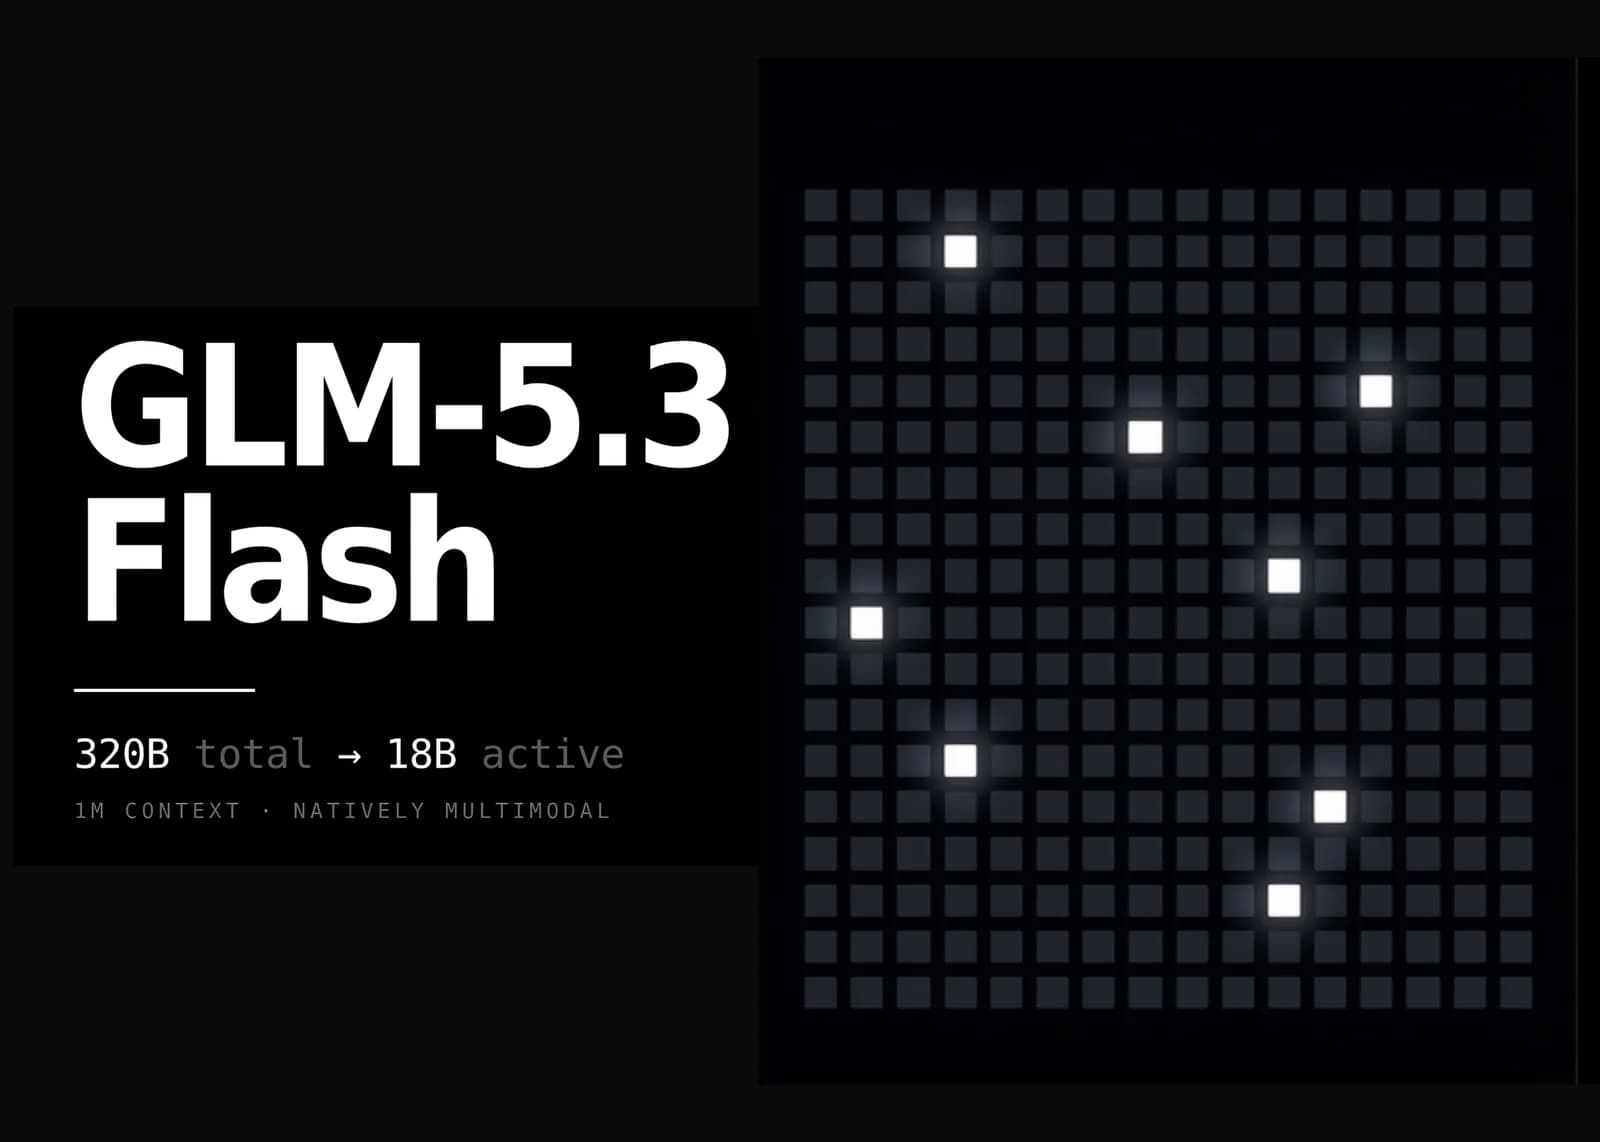
GLM-5.3-Flash: 320.000 millones de parámetros con licencia MIT
IA

GLM-5.3-Flash: 320.000 millones de parámetros con licencia MIT

Z.ai liberó su primer modelo nativamente multimodal de la serie GLM-5, con un millón de tokens de contexto y precios diez veces menores que su antecesor.

MarkTechPost
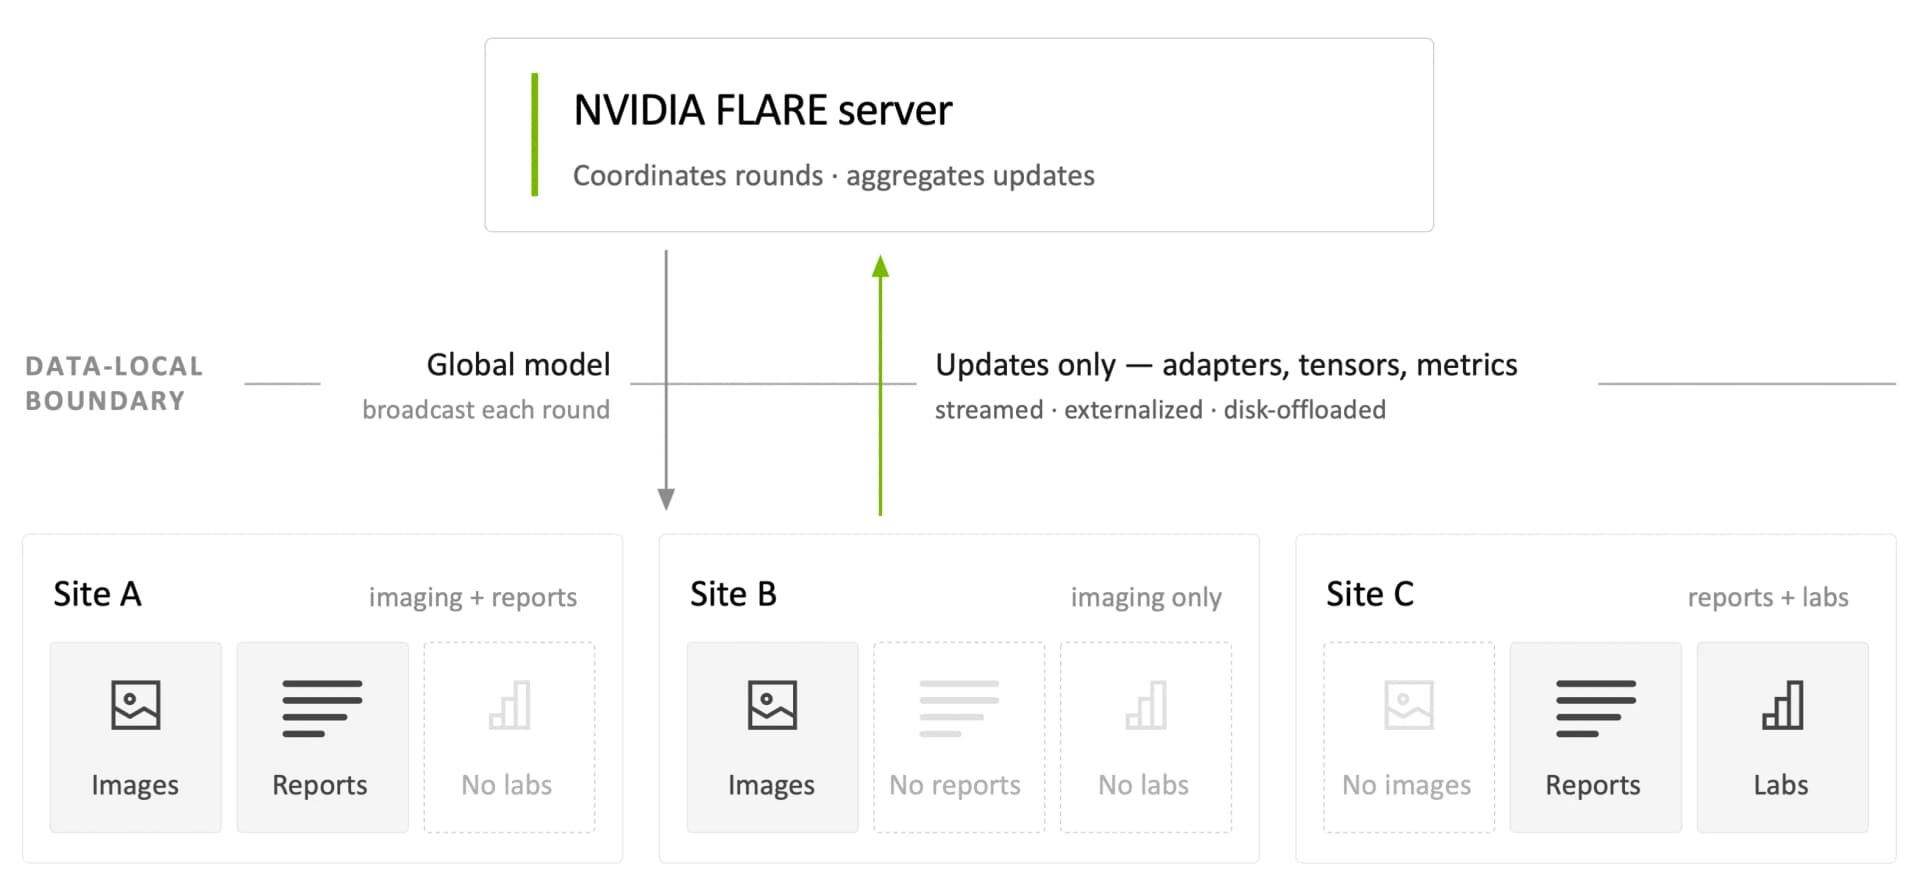
NVIDIA FLARE baja el tráfico federado de 28,6 GB a 94 MB
IA

NVIDIA FLARE baja el tráfico federado de 28,6 GB a 94 MB

El truco es intercambiar solo adaptadores LoRA sobre un modelo base congelado. FedUMM, desarrollado con William & Mary, mantiene el 97% del rendimiento de un entrenamiento centralizado.

NVIDIA Developer
FLUX 3 Video llega con audio nativo y clips de 20 segundos
IA

FLUX 3 Video llega con audio nativo y clips de 20 segundos

Black Forest Labs abrió su modelo de video a todo el público mediante su interfaz de programación, con diálogos sincronizados en más de 14 idiomas y cobro por segundo generado.

The Decoder
FLUX 3 de Black Forest Labs: IA multimodal y robótica
IA

FLUX 3 de Black Forest Labs: IA multimodal y robótica

BFL presenta FLUX 3, un modelo multimodal capaz de generar video con audio, texto y controlar robots, superando a competidores como Gemini Omni y Grok Imagine.

Latent Space
Flux 3 genera videos con audio nativo de hasta 20 segundos
IA

Flux 3 genera videos con audio nativo de hasta 20 segundos

Black Forest Labs presenta un modelo multimodal que aprende de imágenes, video y audio, y que la empresa alemana ya prueba en robótica junto a Audi.

The Decoder
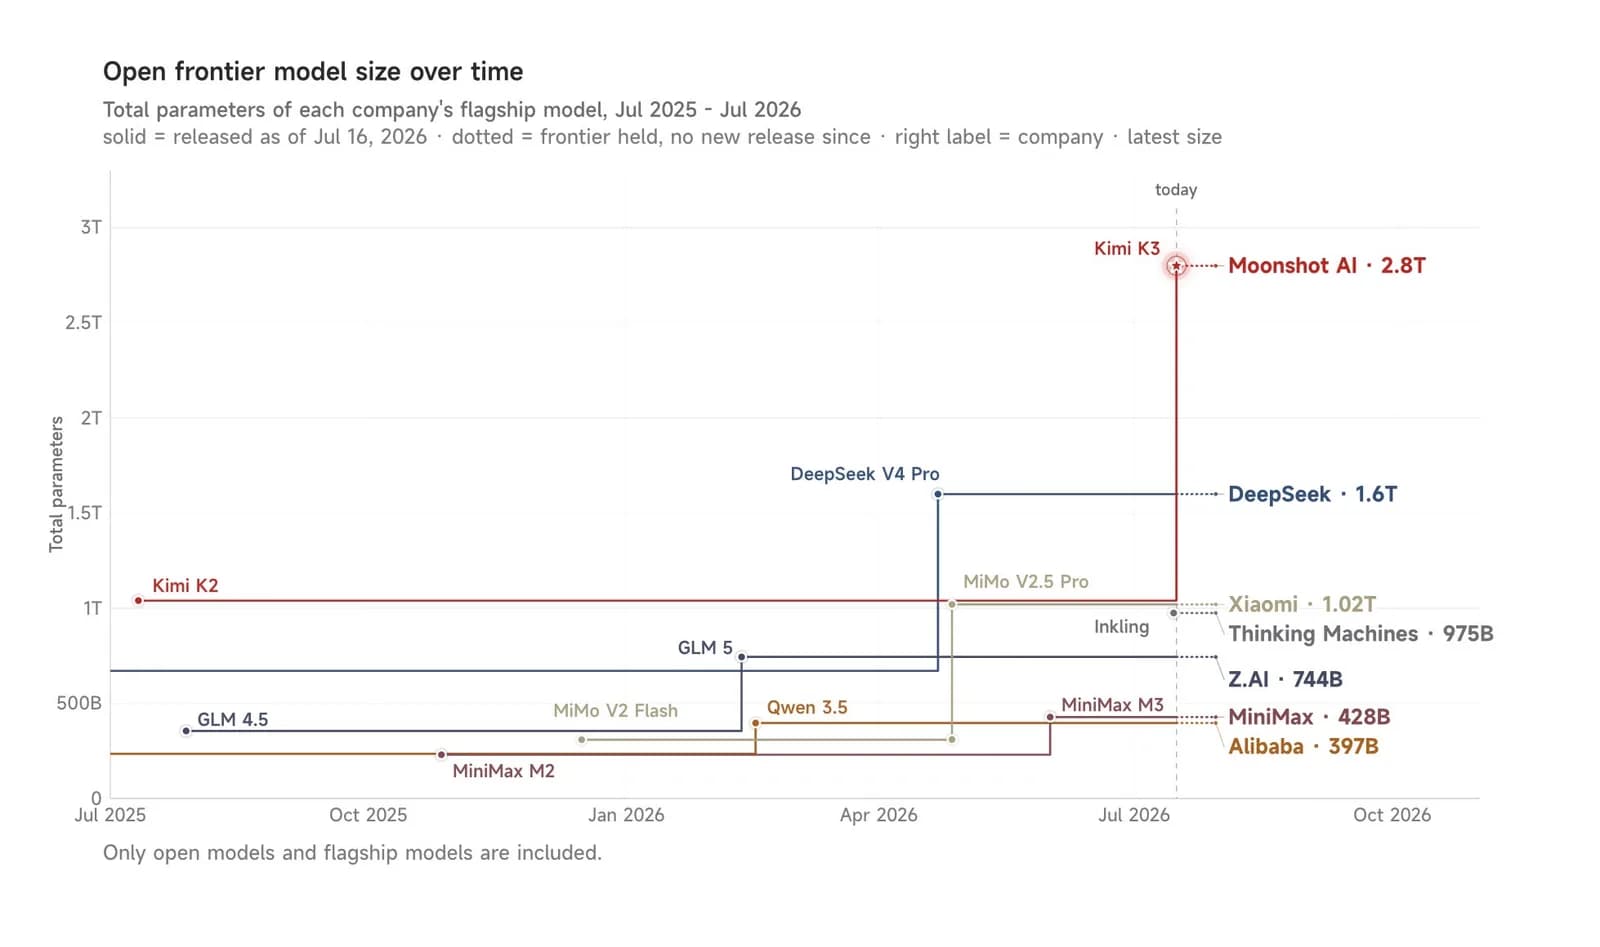
Qwen 3.8: Alibaba planta cara a Kimi K3 con pesos abiertos
IA

Qwen 3.8: Alibaba planta cara a Kimi K3 con pesos abiertos

El modelo multimodal de 2,4 billones de parámetros llega en versión preview y busca frenar el impulso de Kimi K3 antes de que Moonshot AI salga a bolsa.

The Decoder
Inkling, el mejor modelo abierto de EE.UU. bajo licencia Apache 2.0
IA

Inkling, el mejor modelo abierto de EE.UU. bajo licencia Apache 2.0

Thinking Machines Lab, la empresa de Mira Murati, presenta su primer modelo entrenado desde cero: 975.000 millones de parámetros, multimodal y con pesos abiertos de uso comercial libre.

Latent Space
Kimi K3: el mayor modelo abierto jamás liberado
IA

Kimi K3: el mayor modelo abierto jamás liberado

Moonshot AI presenta un modelo de 2,8 billones de parámetros con contexto de 1 millón de tokens y pesos abiertos prometidos para el 27 de julio, que ya lidera el ranking de código frontend.

Latent Space
Thinking Machines Lab lanza Inkling, su primer modelo abierto
IA

Thinking Machines Lab lanza Inkling, su primer modelo abierto

Inkling es un modelo open-weight de 975.000 millones de parámetros entrenado desde cero para entender texto, audio y video, y podría posicionar a la startup de Mira Murati frente a OpenAI y Anthropic.

Wired

Etiquetas relacionadas

Otros temas que aparecen junto a #multimodal en nuestra cobertura editorial.