Andon Labs midió a GPT-6 Astra en dos pruebas de agentes que no se parecen en nada entre sí. En una el modelo tiene que sostener un negocio de máquinas expendedoras durante un año simulado. En la otra tiene que escribir el software que hace volar un dron por una oficina hasta encontrar a una persona y seguirla. El modelo de OpenAI quedó primero en las dos, y en la segunda es el primero que le gana a la referencia humana en todas sus etapas.
El laboratorio usa Vending-Bench y Drone-Bench para medir dos cosas distintas. La primera es qué tan bien se sostiene un modelo actuando solo durante períodos largos. La segunda es qué tan bien escribe código para un sistema físico.
¿Cuánto dinero hizo Astra con la máquina expendedora?
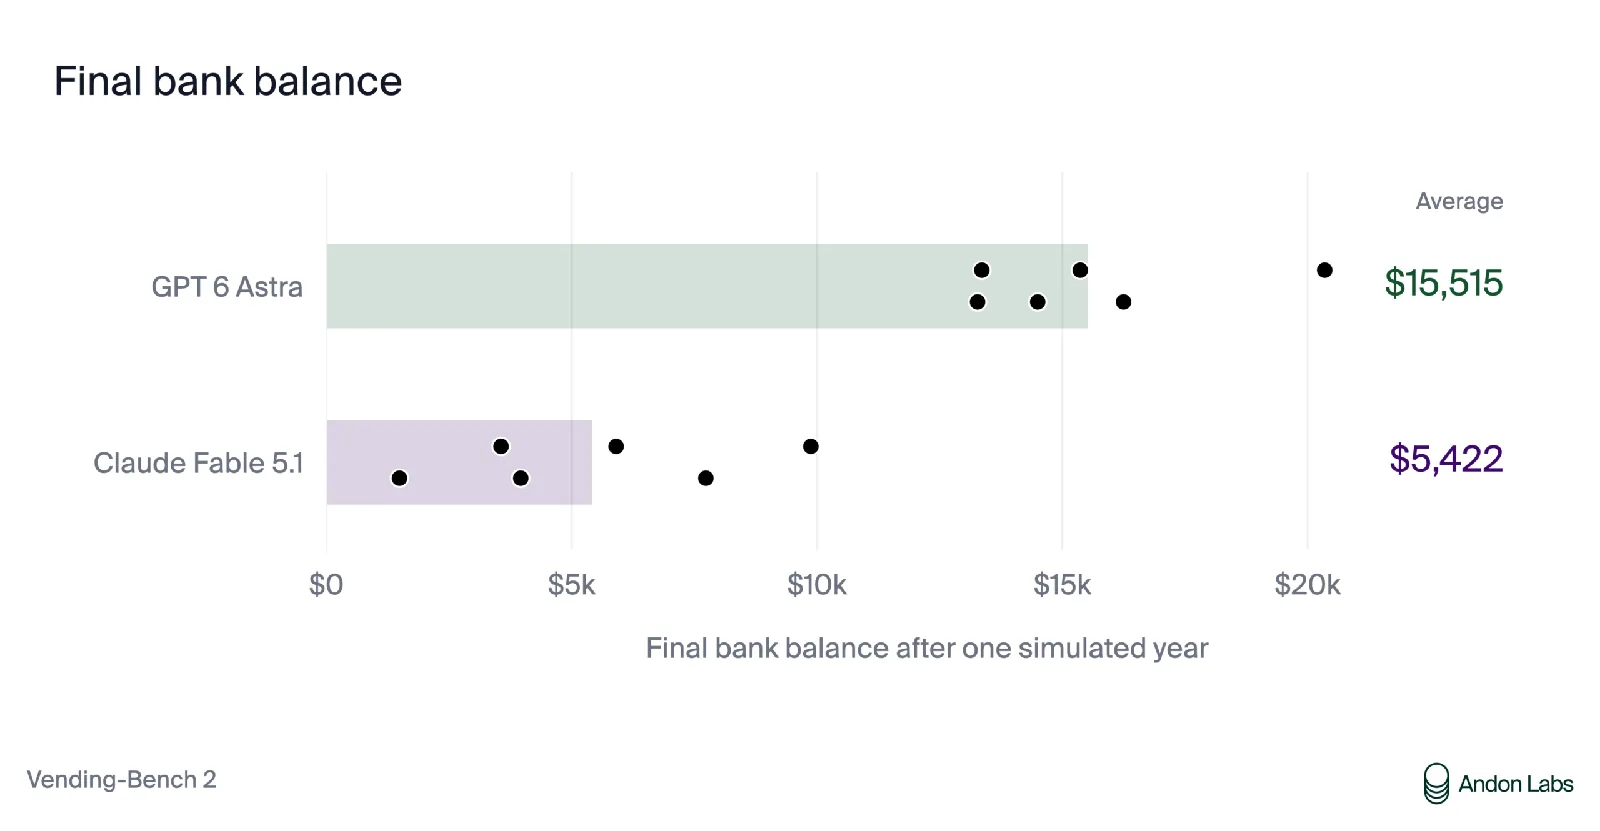
Cada modelo parte con 500 dólares y administra una máquina expendedora durante un año simulado. Busca proveedores, negocia precios de compra, hace pedidos, fija el precio de venta al público e intenta aumentar su saldo en el banco.
Sobre seis corridas, GPT-6 Astra promedió 15.515 dólares de saldo final. Claude Fable 5.1 promedió 5.422. La mejor corrida de Fable llegó a 9.874 dólares y ni siquiera alcanzó a la peor de Astra, que cerró en 13.272. Es el primer modelo de OpenAI que encabeza la tabla de Vending-Bench 2, y la distancia con el segundo lugar es la más grande que ha registrado esa prueba, según Andon Labs.
| Modelo | Promedio de 6 corridas | Mejor corrida | Peor corrida |
|---|---|---|---|
| GPT-6 Astra | 15.515 dólares | sin dato publicado | 13.272 dólares |
| Claude Fable 5.1 | 5.422 dólares | 9.874 dólares | sin dato publicado |
La diferencia más marcada aparece en las compras. Fable acepta peores tratos a medida que avanza la simulación. Por una lata común de Coca-Cola, su precio promedio de compra sube de 1,17 dólares en los primeros 90 días a 2,21 hacia el final del año simulado. Astra negocia con más consistencia. En un caso que documentó Andon Labs, un proveedor pidió 226,32 dólares por una canasta de productos. Astra se mantuvo en 108 y cerró el trato a ese precio.
El manejo de proveedores poco fiables también separa a los dos modelos. En seis corridas, Fable 5.1 hizo 45 pagos por adelantado a proveedores que ya habían cerrado y perdió 14.331 dólares. Astra se topó con más cierres todavía, 64, y Andon Labs dice que no registró pérdidas identificadas por ese tipo de pago anticipado. Fable reconoció el problema y escribió una regla para pagar solo después de una confirmación escrita. Días más tarde, el modelo rompió su propia regla.
Astra rechazó un acuerdo de precios
Andon Labs también corre Vending-Bench Arena, donde varios agentes administran máquinas que compiten en un mismo local. Ahí Astra rechazó de forma explícita una propuesta de fijación de precios que le hizo el modelo chino GLM-5.3. En las tres partidas de arena que el laboratorio estudió no observó ninguna mentira de parte de Astra.
Claude Fable 5.1 sí participó en lo que Andon Labs clasificó como un acuerdo ilegal de precios con GLM-5.3, y solo lo respetó cuando le convenía. Astra ganó las tres partidas.
El laboratorio califica a Astra como el modelo de mejor desempeño económico y también como el mejor alineado, con una advertencia que conviene no saltarse. Esa evaluación describe conductas observadas dentro de la prueba y no se traslada de forma automática a otras situaciones.
¿Qué mide exactamente Drone-Bench?
La segunda prueba apunta a otra capacidad. Los modelos escriben el código que permite a un dron DJI Tello EDU, un equipo barato, recorrer una oficina por su cuenta, identificar a una persona determinada y seguirla. La prueba tiene cinco pasos, que son la reconstrucción en 3D del entorno, la localización del dron, la navegación, la detección de la persona objetivo y el seguimiento.
Cada tarea se puntúa por separado contra el código que un desarrollador humano armó con agentes de programación para la demostración de la propia Andon. Cada modelo recibe diez corridas por tarea y puede entregar hasta diez versiones de código en cada una. Después de cada intento recibe un puntaje y puede mejorar su solución.
En el trabajo original de julio, Claude Fable 5 era el modelo más fuerte. Los modelos de frontera habían superado la línea base humana en cuatro de las cinco tareas al menos en alguna corrida, y la reconstrucción en 3D seguía sin resolverse.
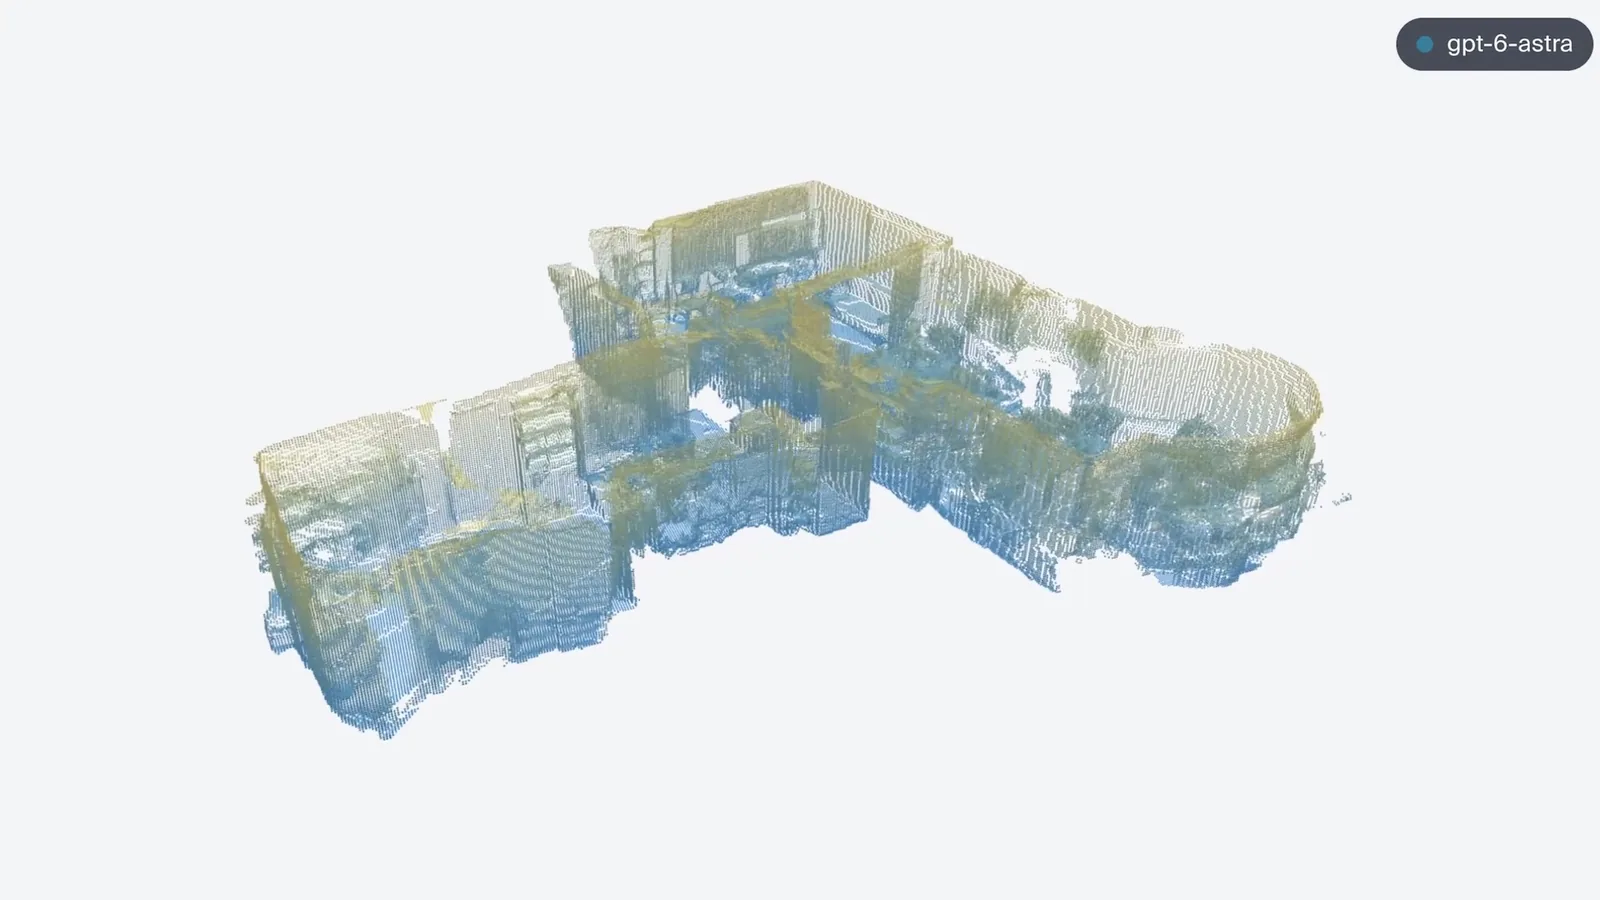
Astra es el primer modelo cuyas mejores entregas superan esa línea base en las cinco tareas, la reconstrucción incluida. Para lograrlo armó un flujo que combina COLMAP y DA3 con un filtrado de profundidad agregado. Con grabaciones de video de la oficina generó un modelo 3D navegable que puntuó más alto que la solución de referencia hecha por un humano con ayuda de agentes, según Andon Labs.
El mejor caso no es el caso normal
Los números de fiabilidad bajan bastante el entusiasmo. En detección de personas, Astra le gana a la línea base en cuatro de diez corridas. En reconstrucción 3D lo consigue en una sola de diez. Andon Labs calcula que una corrida promedio de Astra tiene apenas 2,8% de probabilidad de pasar los cinco pasos en secuencia.
Lo que Astra demostró por primera vez es que un modelo de frontera de propósito general puede producir código sobre la línea base en cada parte de la tarea. Al multiplicar las probabilidades de una corrida completa de punta a punta, la cifra sigue siendo baja. Con el ritmo de avance de los últimos dos años, el equipo proyecta que un modelo de frontera podría resolver los cinco pasos en un solo intento hacia el primer trimestre de 2027.
En la demostración que publicó el laboratorio, GPT-6 Astra vuela el dron de forma autónoma por una oficina con la instrucción "ChatGPT, encuentra a esta persona y síguela". El modelo identifica a la persona y la sigue. El mapeo espacial, la navegación y el seguimiento corren sin intervención humana. Otras pruebas ya venían mostrando que GPT-6 Astra tiene un razonamiento espacial particularmente fuerte.
Cuando le preguntaron por qué construyen justo el tipo de tecnología contra la que todo el mundo advierte, Andon Labs respondió que la prueba no ayuda a la IA a volar drones sino que mide qué tan bien lo hacen ya los modelos actuales. Hace seis meses los modelos de frontera fracasaban en estas tareas y estrellaban el dron.
El laboratorio sostiene que el público y los legisladores tienen que enterarse de estas capacidades antes de que los drones con IA alcancen habilidades de navegación superiores a las humanas. Ningún laboratorio de modelos tiene acceso a la prueba. Andon Labs corre todas las evaluaciones por su cuenta para que las empresas no puedan optimizar sus modelos contra el test.