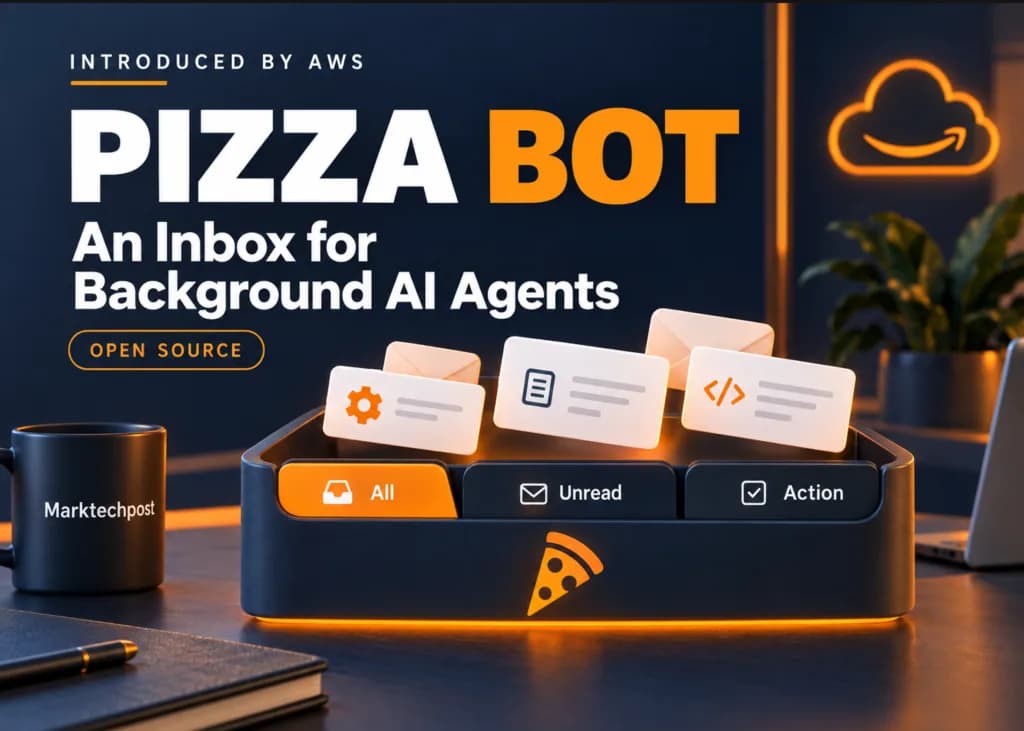
Las tareas de IA que siguen corriendo mientras el usuario está en otra cosa ahora tienen dónde llegar. AWS publicó Pizza Bot, una aplicación que se instala en el propio equipo o servidor y organiza los resultados terminados y las decisiones pendientes en una bandeja de entrada con la forma de un cliente de correo. Lo reportó MarkTechPost el 13 de septiembre de 2026.
La herramienta no nació pública. Versiones anteriores funcionaron puertas adentro de Amazon para más de 2.000 personas, apoyando la preparación de reuniones, la redacción de correos, los resúmenes de Slack, el registro en el CRM y tareas de investigación. Esa aplicación interna se reescribió desde cero para liberarla como proyecto de código abierto.
El código está bajo licencia Apache 2.0 y hay compilaciones de escritorio para macOS, Windows y Linux, además de clientes de navegador y de terminal que se conectan a un servidor local o independiente.
¿Cómo se ordena el trabajo asincrónico?
Pizza Bot separa las tareas en tres vistas. All guarda el historial de conversaciones, Unread reúne el trabajo terminado que espera revisión y Action concentra lo que quedó en pausa esperando una aprobación o una respuesta.
Las conversaciones se pueden agrupar en carpetas y el panel de actividad permite inspeccionar a los trabajadores delegados. Una tarea arranca de tres maneras, a mano, por horario programado o mediante un webhook.
La programación la administra el servidor. Si el equipo estuvo caído y se saltaron varias ejecuciones programadas, el sistema lanza una sola corrida de recuperación en vez de repetir cada intervalo perdido. Las ocurrencias de los disparadores quedan registradas de forma duradera.
Qué hay debajo del capó
La ejecución con estado se apoya en DeepAgents y LangGraph. Un servidor de API escrito con Hono se hace cargo de la ejecución y del almacenamiento. Los clientes de Electron y de navegador comparten una misma interfaz en React, y todos se comunican con el servidor por HTTP y eventos enviados por el servidor.
Los puntos de control de LangGraph conservan el estado de cada conversación y las pausas de aprobación, mientras que bases SQLite separadas guardan la memoria entre conversaciones y los metadatos de la aplicación. Un cliente que se reconecta puede volver a reproducir los eventos que quedaron en el búfer.
Acá hay una distinción que conviene entender antes de instalarlo. Cerrar una conversación o desconectar un cliente no detiene un servidor que está corriendo. Salir de la aplicación de escritorio, en cambio, apaga el servidor incrustado y termina las corridas activas. Los puntos de control preservan la conversación, pero el paso que estaba en vuelo se pierde. Para que el trabajo continúe después de cerrar el escritorio hace falta un servidor encendido de forma permanente.
Modelos, herramientas y control de aprobaciones
La aplicación funciona con Amazon Bedrock, Anthropic, Google Gemini, OpenAI, OpenRouter y Ollama, este último para modelos locales. El proveedor se configura en Settings y luego Providers, antes de lanzar cualquier tarea.
El agente dispone de operaciones sobre archivos de trabajo y de un intérprete de JavaScript en caja de arena, sin acceso a la red ni al sistema de archivos del anfitrión. Puede delegar mediante task cuando existen trabajadores de habilidades disponibles. La capa de archivos admite por separado permisos explícitos sobre carpetas y memoria persistente.
Los servidores MCP exponen las herramientas externas. Cada archivo SKILL.md define las instrucciones de un trabajador y el alcance de las herramientas que puede tocar. Una habilidad queda disponible solo cuando sus dependencias declaradas existen. Las configuraciones .mcp.json compatibles con Claude Code funcionan tal cual, y los complementos empaquetan habilidades junto con sus servidores MCP.
Quien escribe una habilidad configura interruptOn y allowedDecisions para exigir aprobación en herramientas determinadas. Según esa política, el usuario puede aprobar la acción, editar los argumentos propuestos o rechazarla. Esos controles solo operan si alguien los configuró para las herramientas que corresponde.
Lo que conviene revisar antes de instalarlo
Cada directorio de datos SQLite admite un solo proceso de servidor, así que el diseño de la instalación importa desde el principio.
La documentación también advierte que los proveedores y las herramientas configuradas pueden recibir los datos de las tareas. Los detalles técnicos completos están en el blog de código abierto de AWS y el código en su repositorio de GitHub.