El laboratorio chino AllSpark publicó los pesos de dos agentes de búsqueda, Iris-mini e Iris-pro, acompañados de la receta completa con la que fueron entrenados. Según el paper que reseñó The Decoder el 13 de septiembre de 2026, los datos de entrenamiento y los modelos además mejoraron el rendimiento en tareas para las que nunca fueron entrenados, como el uso general de herramientas y el trabajo de oficina.
Un agente de búsqueda construido sobre un modelo de lenguaje investiga la web por su cuenta. Tiene que entender la pregunta, decidir qué buscar, interpretar lo que encuentra y juzgar cuándo reunió evidencia suficiente para responder. Cuánto de eso ocurre de verdad está en discusión. En los benchmarks establecidos, los sistemas líderes de este tipo usan la web sobre todo para confirmar conocimiento que ya traían del entrenamiento.
Iris-mini tiene 35.000 millones de parámetros e Iris-pro llega a 397.000 millones. Los dos están construidos sobre modelos de la serie Qwen, el Qwen3.6-35B-A3B y el Qwen3.5-397B-A17B respectivamente, y trabajan con una ventana de contexto de 256.000 tokens.
¿Cómo se arman las preguntas de entrenamiento?
El flujo de entrenamiento construye las tareas al revés, partiendo de la estructura de enlaces de las páginas web. Toma una página semilla junto con sus enlaces salientes y levanta un grafo de términos y relaciones. De ese grafo sale una pregunta de varios pasos cuya respuesta obliga a encadenar varios saltos conectados entre sí.
Todos los términos, salvo la respuesta final, se reemplazan por una paráfrasis. Así ninguna pista se resuelve con una búsqueda de texto simple y el agente tiene que razonar en vez de mirar de dónde copiar. Solo entran al conjunto de datos las preguntas que un modelo de referencia no logra resolver sin herramientas, pero sí resuelve cuando tiene las fuentes correctas. Ese doble criterio mantiene las tareas difíciles y a la vez verificables.
Dos filtros para botar los ejemplos malos
Un modelo maestro más capaz genera las rutas de solución, formadas por razonamiento, consultas de búsqueda y resultados. Esas rutas pasan por dos rondas de filtrado. La primera revisa la ruta completa buscando errores, bucles de repetición y profundidad de búsqueda. La segunda es una revisión paso a paso a cargo de un modelo juez cuyos criterios, según el paper, salieron de los propios datos y no de una lista escrita a mano.
Después el modelo se mejora con aprendizaje por refuerzo contra una búsqueda web en vivo. El modelo juez y los resúmenes de resultados corren dentro del clúster de entrenamiento, sobre el modelo Qwen grande del propio equipo, de modo que el entrenamiento no depende de servicios externos. El ajuste supervisado y el aprendizaje por refuerzo se alternan en un procedimiento que los autores llaman "SFT-RL climbing". Las tareas resueltas más difíciles y las rutas de solución más eficientes de cada ronda vuelven a entrar en el ciclo siguiente.
Por qué el manejo del contexto cambia los resultados
El equipo sostiene que el manejo de contexto en tiempo de ejecución suele pesar más en los benchmarks habituales que las diferencias reportadas entre sistemas. En una sesión larga de investigación, el contexto puede llenarse antes de que el agente resuelva todas las subpreguntas. Trucos como descartar el historial de conversación alargan la investigación de manera artificial y dicen poco sobre la calidad del modelo.
Para aislar ese efecto, el equipo corre cada benchmark con y sin manejo de contexto, manteniendo constantes las herramientas, los límites de contexto y el modelo juez. Un resultado informado solo con esa gestión activada no se puede separar limpiamente entre lo que aporta el modelo y lo que aporta el andamiaje que lo rodea. Los puntajes de Iris vienen además de un agente único, sin agentes auxiliares y sin pasos extra de verificación al final.
Los números en los cuatro benchmarks
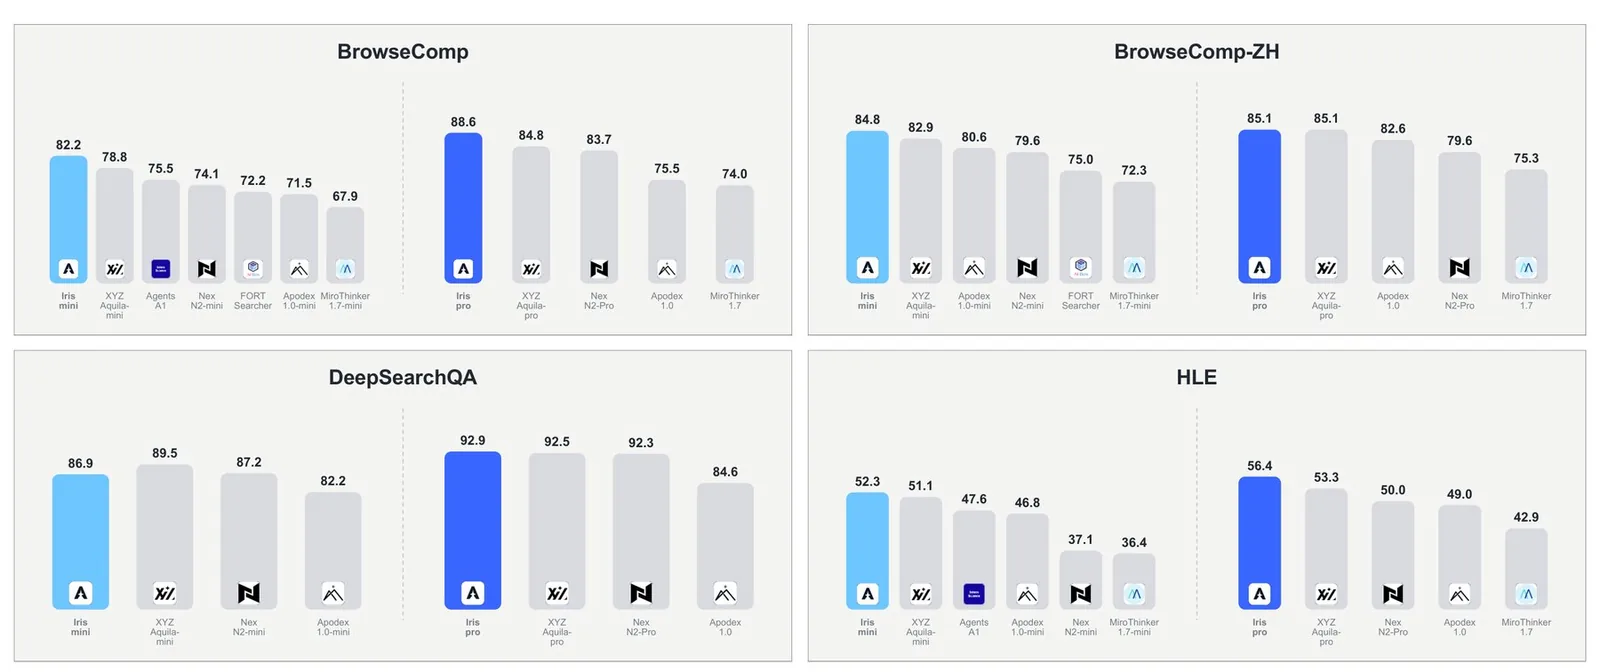
Las pruebas cubrieron BrowseComp, que mide la capacidad de encontrar datos raros a partir de pistas indirectas, su equivalente en chino BrowseComp-ZH, DeepSearchQA, que evalúa qué tan completa es la evidencia recolectada, y Humanity's Last Exam, con preguntas académicas de nivel experto.
Estos son los puntajes que reporta el paper con el manejo de contexto activado.
| Benchmark | Iris-mini | Iris-pro |
|---|---|---|
| BrowseComp | 82,2 | 88,6 |
| BrowseComp-ZH | 84,8 | 85,1 |
| DeepSearchQA | 86,9 | 92,9 |
| Humanity's Last Exam | 52,3 | 56,4 |
En la categoría de menor tamaño, Iris-mini lidera en tres de los cuatro benchmarks y le saca 3,4 puntos en BrowseComp al siguiente mejor modelo, XYZ-Aquila-mini, aunque queda por detrás en DeepSearchQA. Iris-pro lidera o empata en la categoría mayor y a ratos se acerca a sistemas que necesitan mucho más cómputo, según los autores.
El manejo de contexto pesa mucho más en el modelo chico, donde llega a levantar los puntajes de BrowseComp hasta 21,2 puntos. El presupuesto de tokens es el mismo. Lo que cambia es la velocidad con que se consume. Iris-mini necesita más pasos para las mismas tareas y choca con el límite de contexto más seguido.
En Humanity's Last Exam las ganancias son menores, porque ese examen se apoya más en conocimiento de dominio y razonamiento académico, donde la búsqueda web cumple un papel secundario. Los mejores puntajes salen de combinar el descarte de historial con un segundo intento. Si el primero falla, el sistema lo condensa en una nota breve que registra qué se revisó y qué se descartó, y esa nota se agrega a la tarea para la corrida siguiente.
Cuando la respuesta correcta figura como error
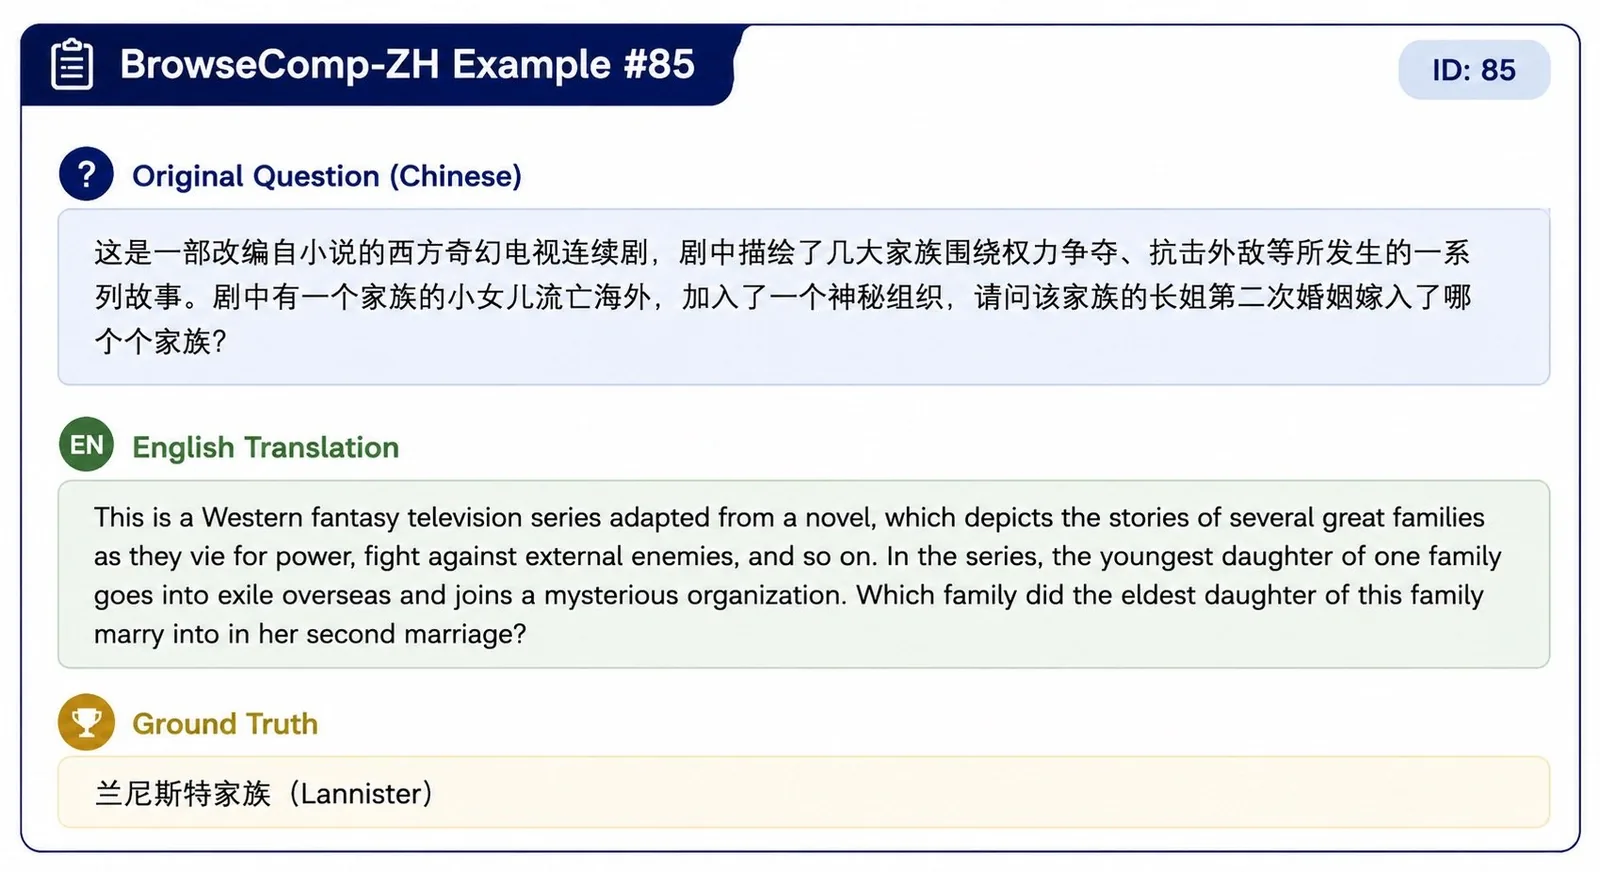
En el apéndice del paper, el equipo describe un caso donde su agente quedó marcado como equivocado pese a que la respuesta estaba respaldada por el material de origen. Una pregunta de BrowseComp-ZH apuntaba a la serie Game of Thrones. El agente respondió "Bolton" y la respuesta oficial del benchmark decía "Lannister". El personaje en cuestión, Sansa Stark, se casa efectivamente con Ramsay Bolton en su segundo matrimonio, así que el agente tenía razón. El equipo señala que contradicciones de este tipo entre la respuesta oficial y las fuentes son lo que los motiva a construir mejores benchmarks.
Más allá de la búsqueda, los autores reportan un efecto lateral que no esperaban. Tanto los datos de entrenamiento generados como los modelos especializados mejoraron el desempeño en tareas para las que nunca fueron entrenados, entre ellas el uso general de herramientas y el trabajo de oficina. El equipo plantea que la búsqueda podría funcionar como una habilidad de base más que como una especialidad estrecha, porque el comportamiento aprendido ayuda en cualquier situación donde el agente tenga que trabajar con información incompleta.
Qué se publicó y qué queda pendiente
Los pesos de Iris-mini e Iris-pro están disponibles en una colección de Hugging Face y el código está en GitHub. La entrega incluye por ahora el Iris Harness con el bucle del agente, las herramientas, las estrategias de manejo de contexto y los cuatro benchmarks con su evaluación. Ese harness corre contra cualquier servicio compatible con la interfaz de OpenAI.
Los procesos de construcción de datos y de entrenamiento quedaron fuera de esta publicación. El equipo dice que las liberará más adelante.