La inteligencia artificial dominó la reciente conferencia Hot Chips, en California, con procesadores para inferencia, para centros de datos y hasta para escritorio. Hubo además varios anuncios de procesadores de alto rendimiento antes y después del encuentro. Pese a lo que sugiere el nombre de la conferencia, muchos de los diseños se las arreglan para quedarse en torno a los 300 W, que no es logro menor dado el rendimiento que entregan.
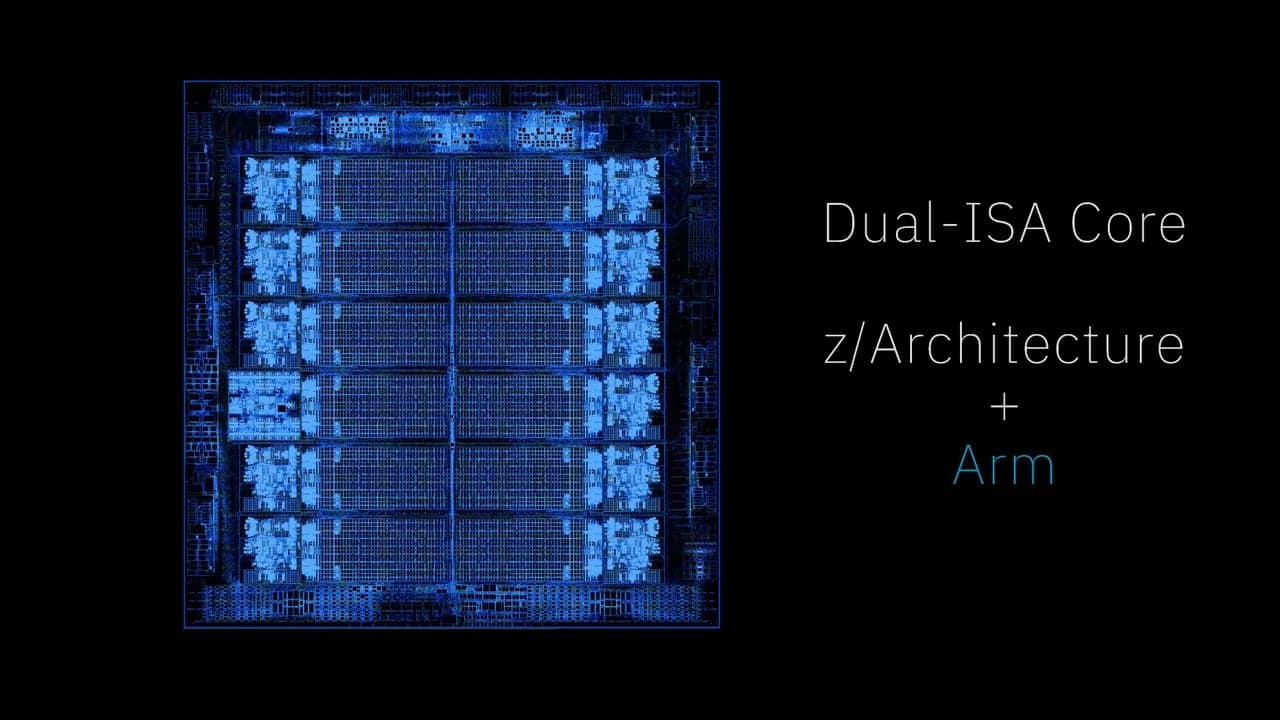
Lo más llamativo de la tanda es el trabajo de IBM para combinar su arquitectura Z con el juego de instrucciones de ARM. El diseño no reparte el trabajo entre dos núcleos distintos. Es un núcleo ARM capaz de ejecutar instrucciones Z, y eso permitirá que los futuros procesadores Z y LinuxONE de IBM ejecuten de forma nativa software de IBM Z y software de ARM AArch64 sobre los mismos núcleos.
¿Cómo ejecuta un mismo núcleo dos juegos de instrucciones?
"Cada núcleo del chip ejecuta tanto z/Architecture como ARM", dijo Matthew Kimball, analista principal de Moor Insights & Strategy, en Hot Chips.
"No mediante emulación, no mediante una capa de traducción, y no estacionando un bloque de núcleos ARM en una esquina del dado. Cada núcleo físico habla los dos idiomas, cambiando entre ellos a medida que se despacha el trabajo. El enorme catálogo de software ya construido para ARM queda al alcance de un mainframe sin que nadie tenga que portarlo primero."
IBM reutilizó el predictor de saltos, el hardware de traducción de direcciones y las rutas aritméticas principales de la z/Architecture, y luego agregó lo que ARM exige. Entre esas adiciones está invertir el orden de los bytes a medida que los datos salen de la caché, para que el software ARM vea exactamente lo que espera ver.
"Poner ARM dentro de los núcleos existentes también fue una decisión deliberada", agregó Kimball. "Licenciar un bloque ARM estándar habría sido mucho más fácil de construir, pero habría sido silicio de clase commodity, y la matemática de consolidación que justifica la plataforma se habría derrumbado con eso."
El enfoque de IBM pesa por la arquitectura en sí y porque abre el acceso al ecosistema de software de ARM conservando las características de seguridad, disponibilidad y operación de los mainframes IBM Z y LinuxONE. Ese ecosistema hoy abarca más de 22 millones de desarrolladores, además de distribuciones de Linux, software nativo de nube, aplicaciones empresariales y frameworks de inteligencia artificial. Para los clientes de IBM, el resultado posible es acceder a ese software sin obligar a sus desarrolladores a portar aplicaciones para correr entornos Linux nativos de ARM en paralelo con z/OS y con Linux sobre IBM Z.
El chip de 2 nm que viene
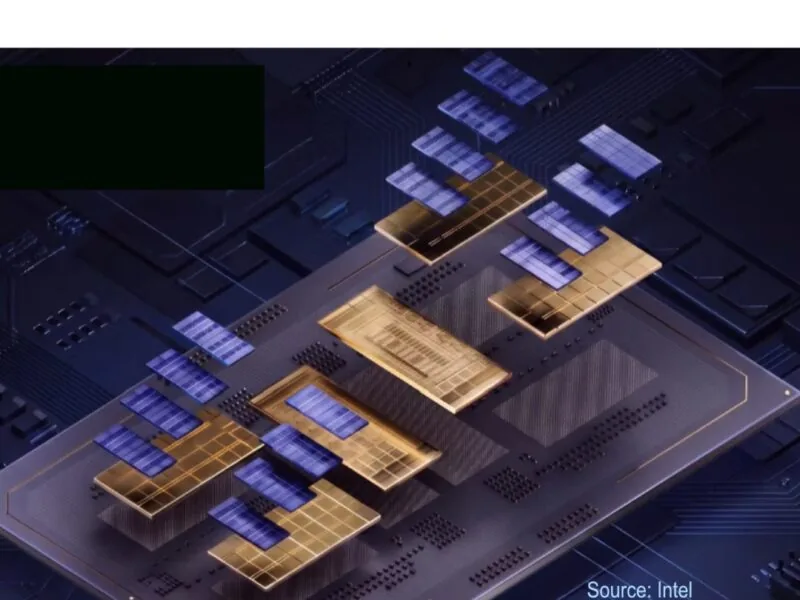
Construido sobre un nodo de tecnología de 2 nm, el diseño del procesador contendrá 11 núcleos de alto rendimiento operando a más de 5,7 GHz, aceleradores de inferencia de inteligencia artificial para detección de fraude dentro de la transacción, una unidad de procesamiento de datos dedicada en el propio chip para acelerar la entrada y salida, y una arquitectura de caché grande para cargas empresariales exigentes.
Hay una tubería de decodificación, y muchos de sus detalles se comparten entre las dos arquitecturas de juego de instrucciones. Los decodificadores individuales que hacen la decodificación propiamente tal, sin embargo, son decodificadores separados que IBM construye. Unos toman las instrucciones de 16 a 48 bits de la z/Architecture y otros las instrucciones de 32 bits de la arquitectura ARM.
En la unidad de carga y almacenamiento, la caché de datos está organizada en palabras, con soporte para accesos no alineados en cualquier frontera de byte. Una estructura da formato a esos accesos por palabra que vienen de la caché, hasta dejar la palabra concreta que pidió la instrucción de carga, y así sostiene la operación tanto en big endian como en little endian.
Fujitsu apunta a 144 núcleos con Monaka
Fujitsu mostró otro camino, con 144 núcleos ARM en el procesador Monaka, orientado a computación de alto rendimiento. Monaka se basa en la arquitectura ARMv9 y se desarrolla junto con un entorno de software amplio de inteligencia artificial y HPC, que incluye software de código abierto importante, sistemas operativos, frameworks y bibliotecas.
Fujitsu señala que la plataforma dará acceso al ecosistema de software de ARM sin modificaciones, mientras la empresa sigue optimizando a fondo alrededor de sus propios objetivos de rendimiento y eficiencia.
¿Qué trae el procesador AGI de ARM?
Aparecieron más detalles del procesador AGI que ARM diseñó para centros de datos de inteligencia artificial. El chip integra hasta 136 núcleos ARM Neoverse V3 repartidos en dos chiplets, corriendo a 3,7 GHz sobre un proceso de 3 nm. Tiene 12 canales de memoria DDR5, 96 líneas de PCIe Gen 6 y soporte de CXL 3.0, todo dentro de un envolvente térmico de 300 W. Entrega más de 6 GB/s de ancho de banda de memoria por núcleo, con la conectividad necesaria para trabajar junto a aceleradores y a memoria expandida.
Neoverse N4 sube a 3,8 GHz
ARM también dio continuidad a su serie Neoverse N con la última versión, la N4, antes bajo el nombre clave Dionysus. Es el primer núcleo de la serie N que opera a 3,8 GHz en un proceso de 3 nm. Hasta ahora la serie V era el diseño de alto rendimiento de la familia.
La N4 se implementa inicialmente en un nuevo subsistema de cómputo, el CSS N4, que admite hasta 128 núcleos por dado, memoria LPDDR6 y hasta 128 líneas de PCIe Gen 7 para sostener la especificación CXL 4.0. Esa combinación entrega el doble de rendimiento, 1,25 veces el rendimiento por watt y hasta 1,75 veces el ancho de banda de memoria del Neoverse CSS N3.
La clave del CSS N4 es una interconexión de malla coherente de 16 × 16 que duplica el ancho de banda de la interconexión S3 anterior y usa el protocolo AMBA CHI C2C para conectar chiplets. CHI C2C se encarga de la lógica de capa superior, como la coherencia de caché, la seguridad del sistema y la virtualización a través de los chiplets, mientras UCIe se ocupa de las tareas de capa inferior, entre ellas la conexión física, la gestión del enlace y la transmisión de datos en bruto.
Con eso se pueden agregar aceleradores a medida a la plataforma como chiplets, y quien desarrolla se concentra en su valor agregado en vez de la infraestructura de procesador que va debajo. Alibaba y Microsoft ya usan el CSS N2 para chips de centro de datos, y Google usa N3 en su chip Axion N4A.
"Es un momento increíblemente entretenido para estar en el negocio de la nube", dijo Mohamed Awad, vicepresidente ejecutivo de Cloud AI en ARM. "1.500 millones de núcleos Neoverse despachados a centros de datos a nivel global desde 2018, 500 millones en los últimos nueve meses, lo que da una idea del ritmo al que Neoverse está acelerando en el centro de datos como parte de esta construcción global de cómputo de centro de datos."
"A medida que la inteligencia artificial escala, una porción mayor del panorama de cómputo está convergiendo hacia ARM", agregó Awad sobre el trabajo con IBM. " IBM Z y LinuxONE mueven algunas de las cargas más exigentes del mundo en industrias altamente reguladas. Llevar el cómputo ARM y su ecosistema de software a esas plataformas extenderá ese impulso hacia la infraestructura empresarial de misión crítica, para dar a las organizaciones mayor libertad de elección en cómo despliegan inteligencia artificial."
¿Por qué NVIDIA rediseñó el núcleo para agentes?
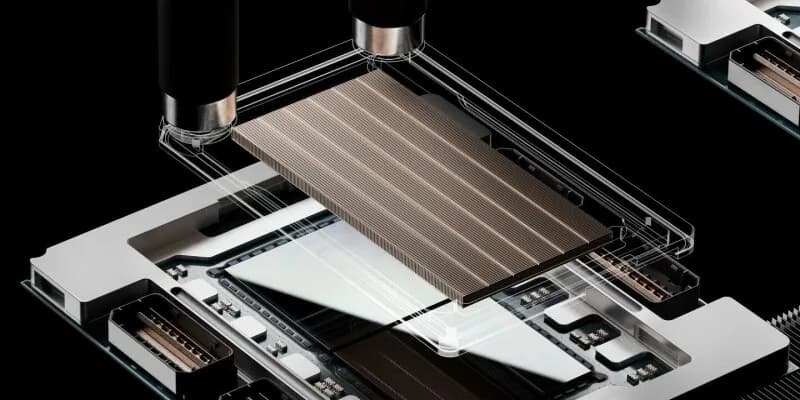
NVIDIA también reveló más detalles de su núcleo Olympus, basado en ARM, que se usa en la CPU Vera junto a la GPU Rubin. La empresa afirma que es el primer núcleo diseñado pensando en agentes de inteligencia artificial.
"La IA agéntica traslada una porción mayor de la ruta crítica de ejecución hacia la CPU", dijo Eduardo Alvarez, líder técnico senior en NVIDIA. "Los agentes operan en entornos aislados para ejecutar código, invocar herramientas, recuperar contexto, interactuar con bases de datos y analizar resultados antes de devolver información al modelo."
"Estos requisitos difieren de los diseños tradicionales de CPU para la nube, que muchas veces priorizan densidad de núcleos y throughput a lo largo de cargas más uniformes", agregó Alvarez. "La IA agéntica, en cambio, valora más el progreso sostenido por hilo a lo largo de las rutas de software secuenciales, cargadas de saltos y sensibles a la latencia dentro de cada ciclo del agente. La CPU Vera se construyó para esta clase de carga, con el núcleo Olympus en el centro de su diseño."
Dentro del núcleo Olympus
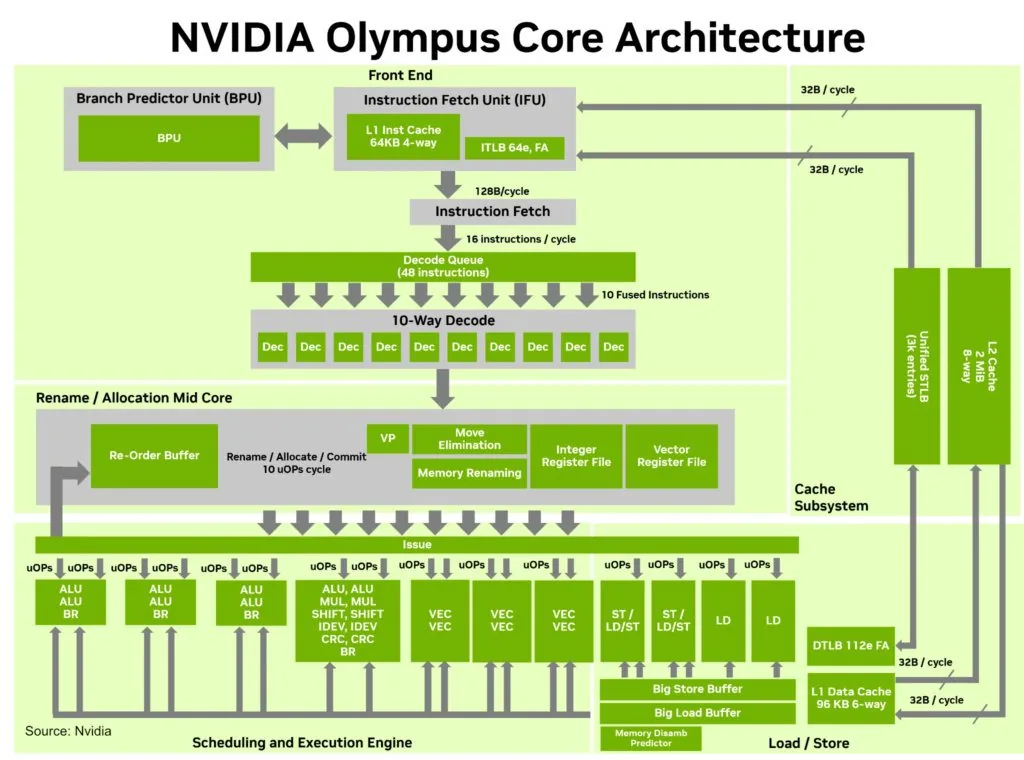
El front end de Olympus está construido para mantener al núcleo abastecido de instrucciones útiles a través de pilas de software grandes y cargadas de saltos. Cargas como los entornos de ejecución de agentes, los intérpretes, los compiladores, la analítica de grafos y los frameworks de procesamiento de datos suelen combinar huellas de instrucciones grandes con cambios frecuentes de flujo de control, lo que puede dejar subutilizados los recursos de ejecución. Olympus responde con predicción de saltos avanzada, búsqueda de instrucciones de alto ancho de banda y un motor de decodificación de 10 vías, que entrega más instrucciones al núcleo en cada ciclo.
En el centro de ese enfoque está el subsistema de predicción de saltos de Olympus, que incluye un predictor de saltos neuronal diseñado para mejorar la precisión en patrones de salto difíciles y estadísticamente sesgados. Al reducir la ejecución por caminos equivocados y admitir hasta dos saltos tomados por ciclo, ayuda a sostener el throughput del flujo de control cuando el comportamiento del software es irregular. Combinadas con la ruta de decodificación ancha, estas capacidades permiten que Olympus mantenga mejor throughput de front end para cargas sensibles a la latencia, incluidas la IA agéntica y las aplicaciones de aprendizaje por refuerzo.
Las cargas agénticas suelen seguir cadenas largas de trabajo dependiente. Interpretan código, recorren objetos, gestionan estado de ejecución, procesan salidas de herramientas y navegan estructuras de datos parecidas a grafos. En esas rutas el rendimiento depende de la búsqueda de instrucciones y también de la capacidad del núcleo para destapar trabajo independiente mientras instrucciones anteriores esperan por saltos, memoria o resolución de dependencias.
El mid-core de Olympus está diseñado para exponer y acelerar ese paralelismo escondido. Un motor ancho de renombrado y asignación mapea las instrucciones decodificadas a recursos físicos, mientras un búfer de reordenamiento grande y una capacidad extensa de registros físicos mantienen más instrucciones en vuelo, para una ejecución fuera de orden más profunda. Capacidades que rompen dependencias, entre ellas el renombrado de memoria, la predicción de valores y la aceleración de ruta crítica, ayudan a reducir los atascos que provocan el código cargado de punteros, las operaciones de memoria serializadas y las cadenas largas de dependencias.
Juntas, estas características mantienen productivo el motor de ejecución, mejoran el IPC y refuerzan el rendimiento de un solo hilo a lo largo de las rutas de software irregulares que son comunes en agentes, en entornos de aprendizaje por refuerzo y en infraestructura moderna de inteligencia artificial.
Las cargas agénticas necesitan más que un front end ancho. Una vez que las instrucciones entran al núcleo, la CPU debe ejecutar con eficiencia una mezcla cambiante de operaciones enteras, saltos, trabajo vectorial y accesos a memoria, sin crear cuellos de botella nuevos. Las CPU de servidor x86 tradicionales suelen apoyarse en frecuencias de reloj más altas para mejorar la capacidad de respuesta de un solo hilo, pero las cargas agénticas quedan limitadas con frecuencia por flujo de control irregular, cadenas largas de dependencias y latencia de memoria. Esos desafíos exigen más IPC, y la frecuencia sola no basta.
El motor de ejecución de Olympus convierte un suministro amplio de instrucciones en ejecución productiva. Planifica dinámicamente operaciones a lo largo de un conjunto amplio de recursos de enteros, saltos, vectoriales, de punto flotante, criptográficos, de carga y de almacenamiento, apoyado en un back end ancho y en ejecución fuera de orden profunda. Ese diseño balanceado ayuda a Olympus a manejar con eficiencia software cargado de saltos, procesamiento vectorizado de datos, preprocesamiento de inteligencia artificial, cifrado, compresión, analítica y otras cargas intensivas en memoria.
Los agentes operan a menudo sobre estructuras de datos que no caben limpiamente en la caché, entre ellas objetos de ejecución, índices de recuperación, estado de herramientas, estructuras de grafo, datos dispersos, bases de datos y memoria de entorno. Los diseños tradicionales de caché y de prebúsqueda funcionan bien con patrones de acceso regulares y en flujo, y pierden efectividad cuando cada dirección depende del resultado de una búsqueda previa en memoria, como ocurre en los flujos de trabajo de agentes cargados de punteros y con forma de grafo.