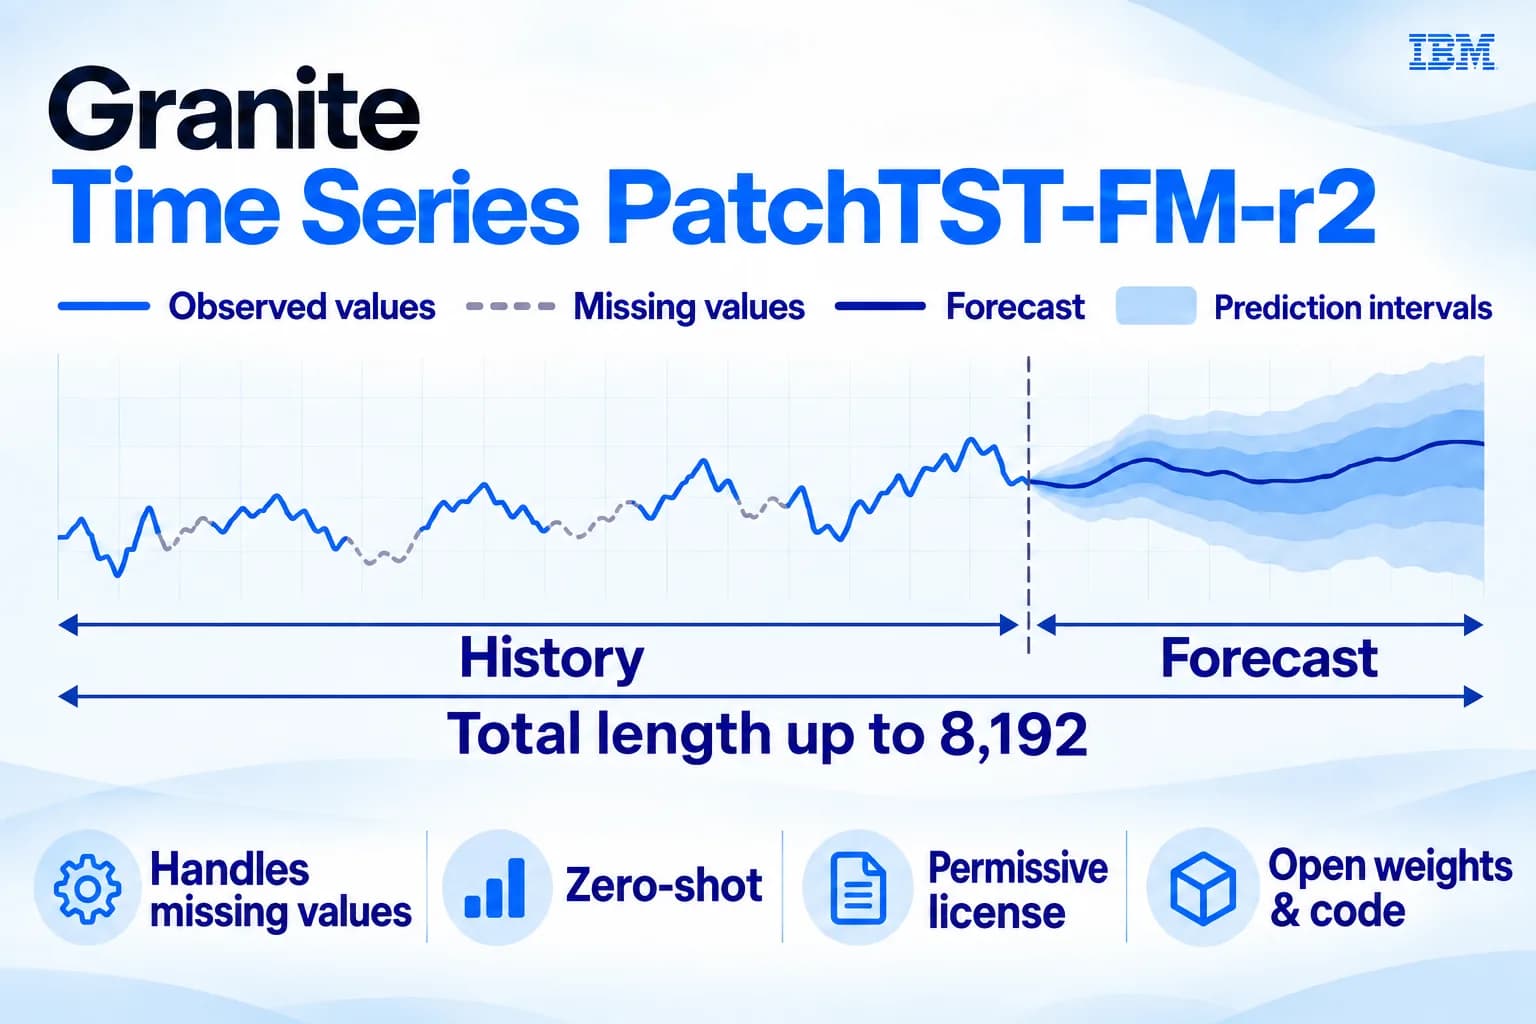
Pronóstico de alto rendimiento sin entrenamiento previo, con licencia abierta apta para uso comercial.
Los modelos fundacionales de series de tiempo están cambiando la forma en que se construyen los sistemas de pronóstico. En vez de entrenar y mantener un modelo distinto para cada conjunto de datos, se puede usar un modelo preentrenado y generar pronósticos sin ajuste previo.
IBM liberó Granite Time Series PatchTST-FM-r2, el modelo más reciente de la familia Granite TSFM (repositorio, blog). PatchTST-FM-r2, una nueva versión de su antecesor PatchTST-FM-r1, combina una arquitectura actualizada, un corpus de preentrenamiento más grande, pronóstico probabilístico, soporte para imputación de valores faltantes y un desempeño fuerte sin ajuste previo, todo en un modelo de cerca de 385 millones de parámetros.
Al 8 de septiembre de 2026, es el modelo de mejor desempeño sin ajuste previo publicado bajo una licencia abierta permisiva y apta para uso comercial (Apache 2.0 y OpenMDW 1.0) entre los modelos replicables del ranking GIFT-Eval, un banco de pruebas amplio de pronóstico de series de tiempo. En la tabla general de modelos replicables sin ajuste previo, queda en el segundo lugar.
Los pesos del modelo, la arquitectura, la tubería de inferencia y el código necesario para reproducir los resultados del banco de pruebas están todos disponibles.
Lo esencial
- Pronóstico de propósito general sin ajuste previo para demanda, precios, cargas de energía, tráfico, telemetría y otras series de tiempo.
- Cerca de 385 millones de parámetros, longitud de contexto de hasta 8.192 pasos, largos de pronóstico flexibles y pronósticos probabilísticos mediante una cabeza de predicción de 99 cuantiles.
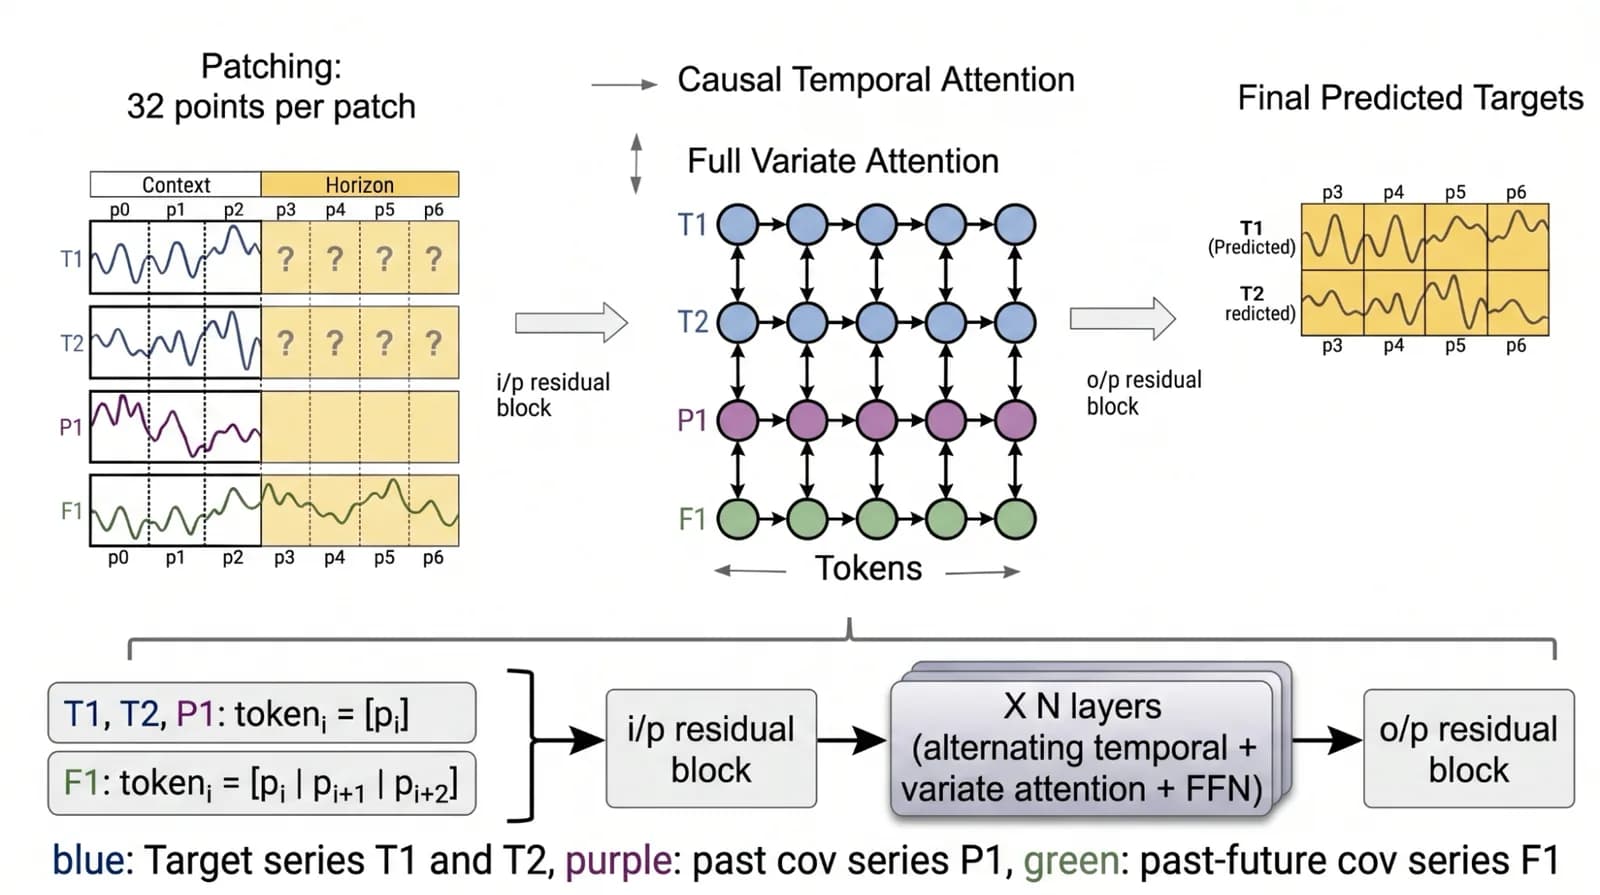
- El troncal del modelo está construido con bloques conformer, que combinan autoatención de múltiples cabezas con convolución temporal para capturar estructura temporal de corto y largo alcance.
- Licencia permisiva y primer lugar de desempeño en la categoría replicable sin ajuste previo de GIFT-Eval, con doble licencia Apache 2.0 y OpenMDW 1.0, a elección del usuario.
- Pesos abiertos, arquitectura, tubería de inferencia y código para reproducir el banco de pruebas.
¿Qué tan bueno es sin ajuste previo?
Un modelo fundacional es más útil cuando generaliza a series de tiempo con las que no fue entrenado específicamente. Por eso el foco parte por el desempeño sin ajuste previo.
Cuando se restringe el ranking a modelos sin ajuste previo, replicables y evaluados sin filtración del conjunto de prueba, PatchTST-FM-r2 queda segundo tanto en CRPS como en MASE al 8 de septiembre de 2026, según las figuras 1 y 2 (en ambas métricas, menos es mejor). Y es el modelo de mejor desempeño de esa categoría entre los que tienen licencia permisiva y apta para uso comercial.
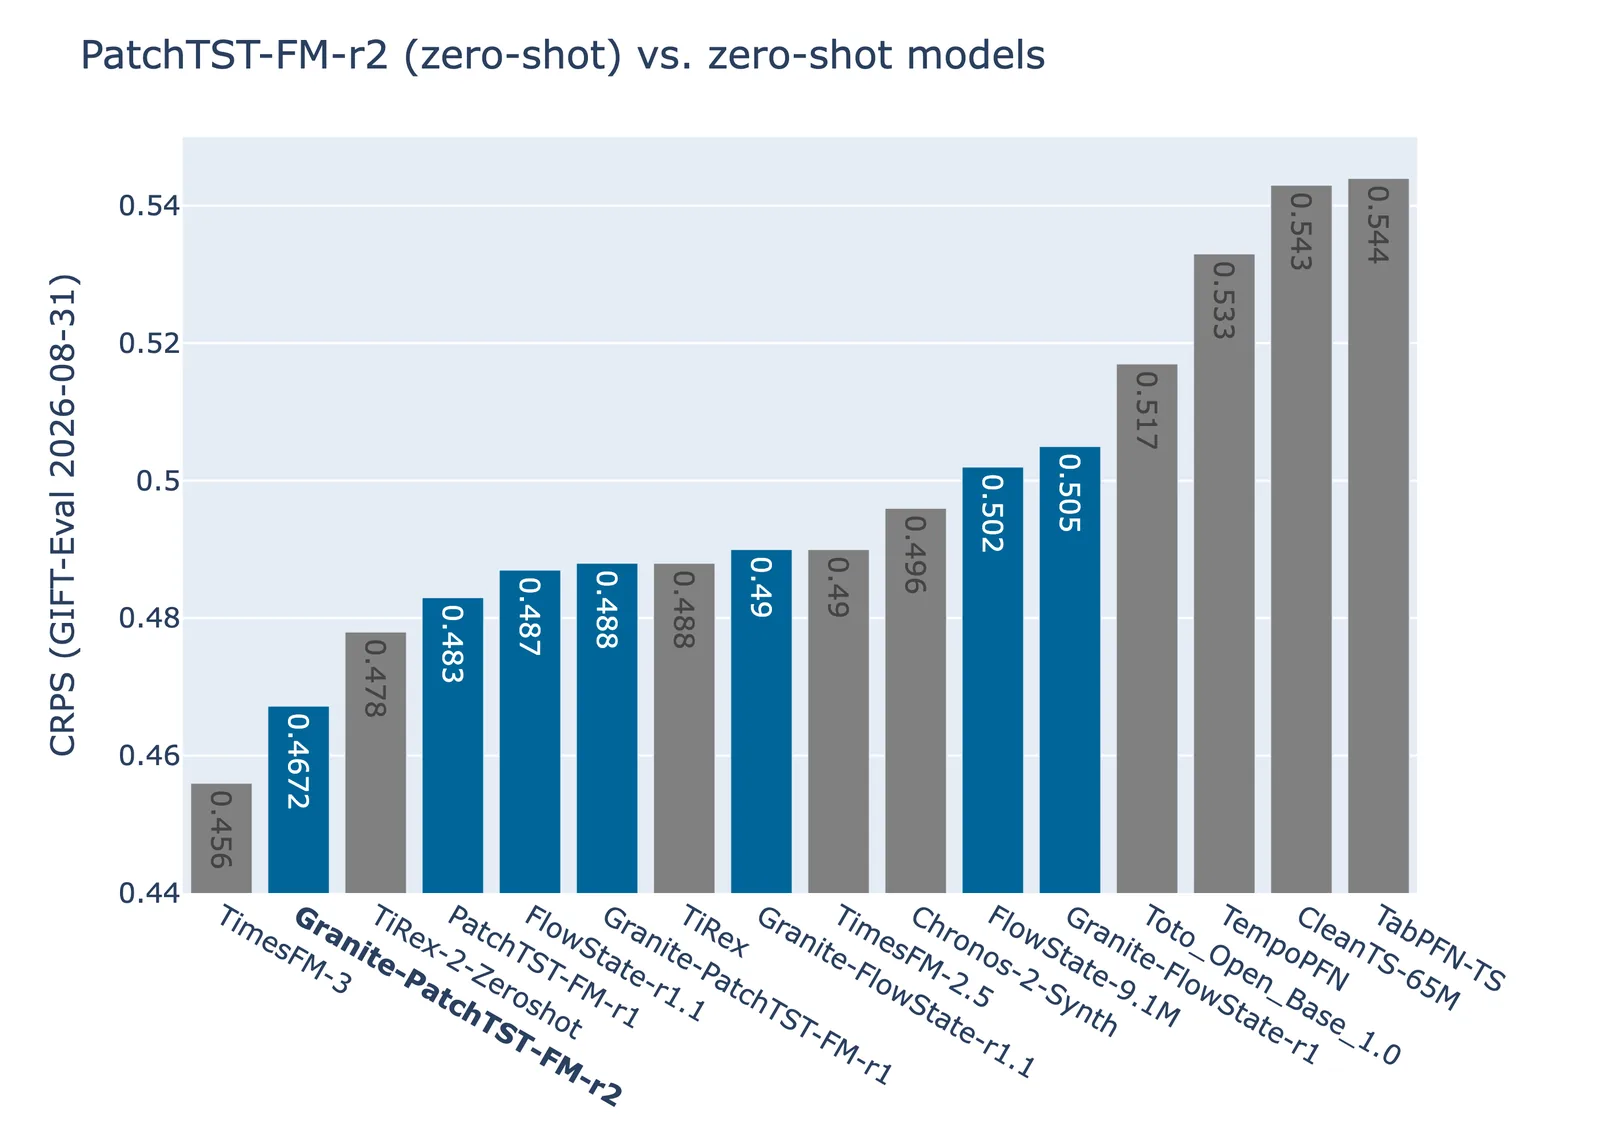
Figura 1. CRPS en GIFT-Eval para los principales modelos replicables sin ajuste previo. PatchTST-FM-r2 logra un CRPS de media geométrica de 0,467, lo que lo deja inmediatamente detrás de TimesFM-3 en esta comparación, y primero entre los modelos con licencias permisivas.
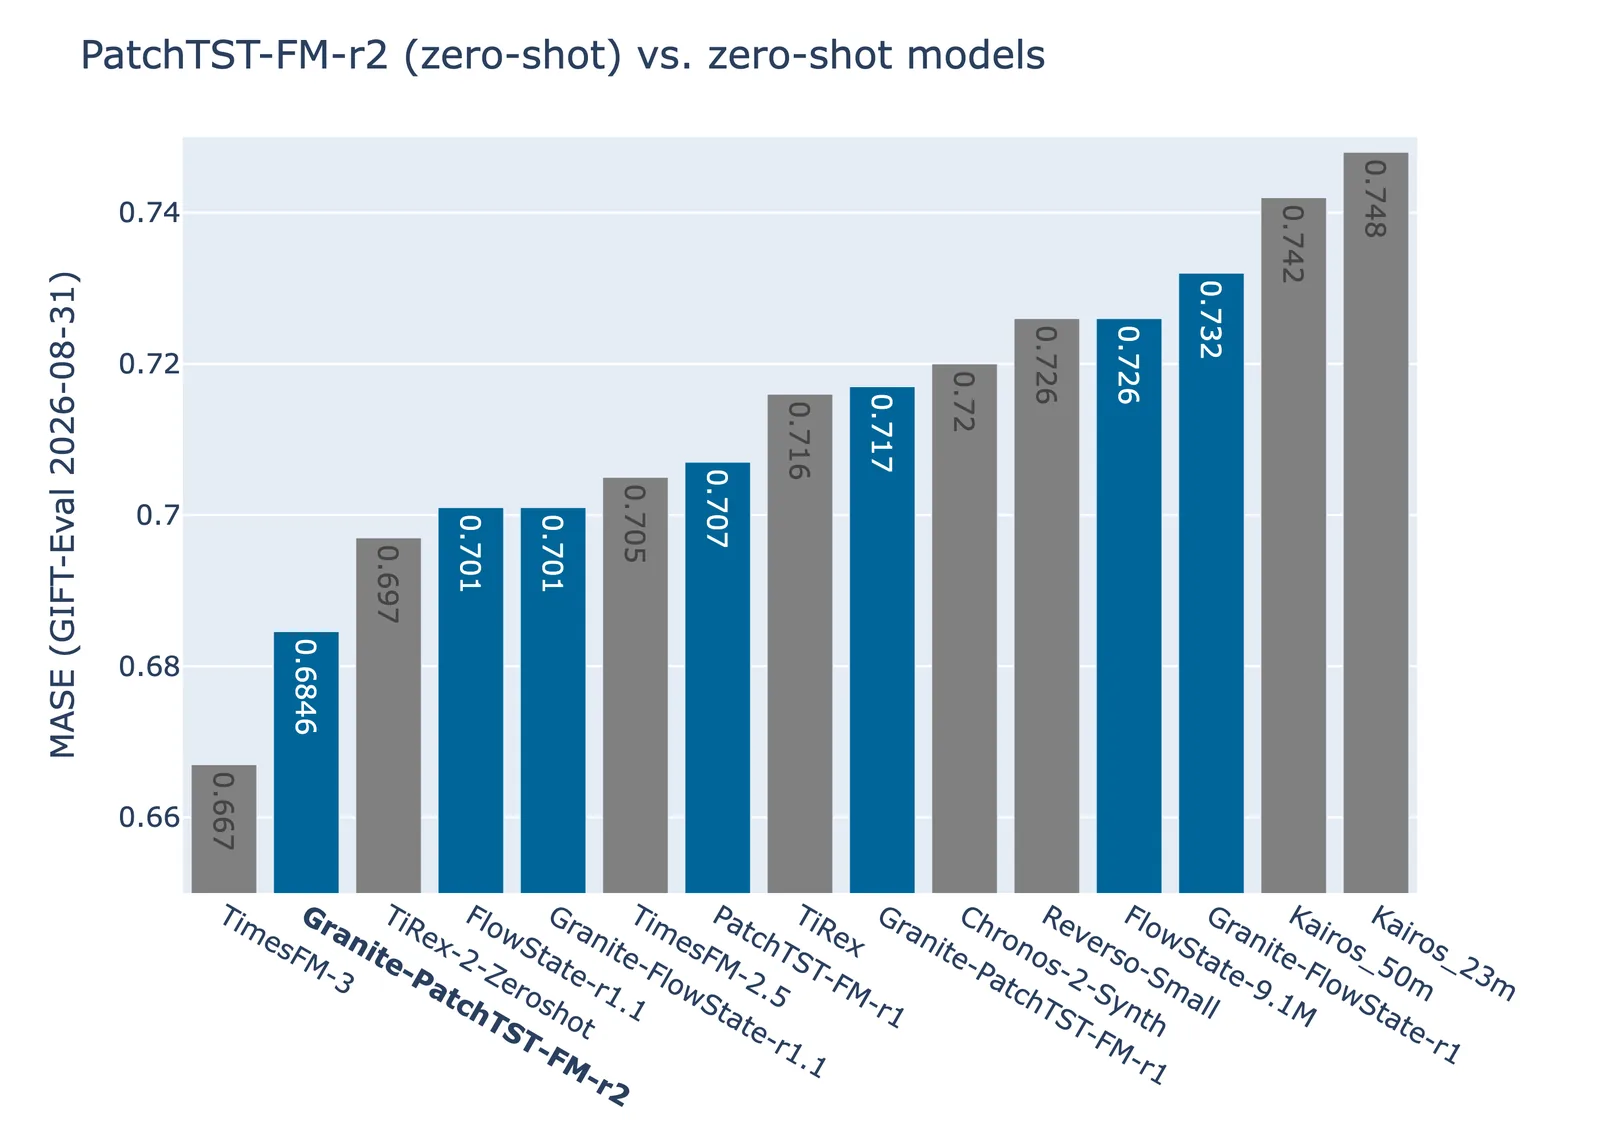
Figura 2. MASE en GIFT-Eval para los principales modelos replicables sin ajuste previo. PatchTST-FM-r2 logra un MASE de media geométrica de 0,6846. Las barras azules corresponden a modelos publicados por el equipo de modelos fundacionales de series de tiempo de IBM.
Competitivo incluso frente a modelos que sí vieron los datos
Algunos modelos de GIFT-Eval se clasifican como preentrenados y no como estrictamente sin ajuste previo. A esos se les permite incluir las porciones de entrenamiento de los conjuntos de evaluación de GIFT-Eval dentro de su corpus de preentrenamiento.
Aun sumando esos modelos a la comparación, PatchTST-FM-r2 se mantiene cerca de la cima, como se ve en las figuras 3 y 4: tercero en CRPS y cuarto en MASE entre los modelos replicables. Supera a varios modelos preentrenados, entre ellos Chronos-2, Timer-S1 y las variantes de Toto, pese a que algunos competidores son considerablemente más grandes.
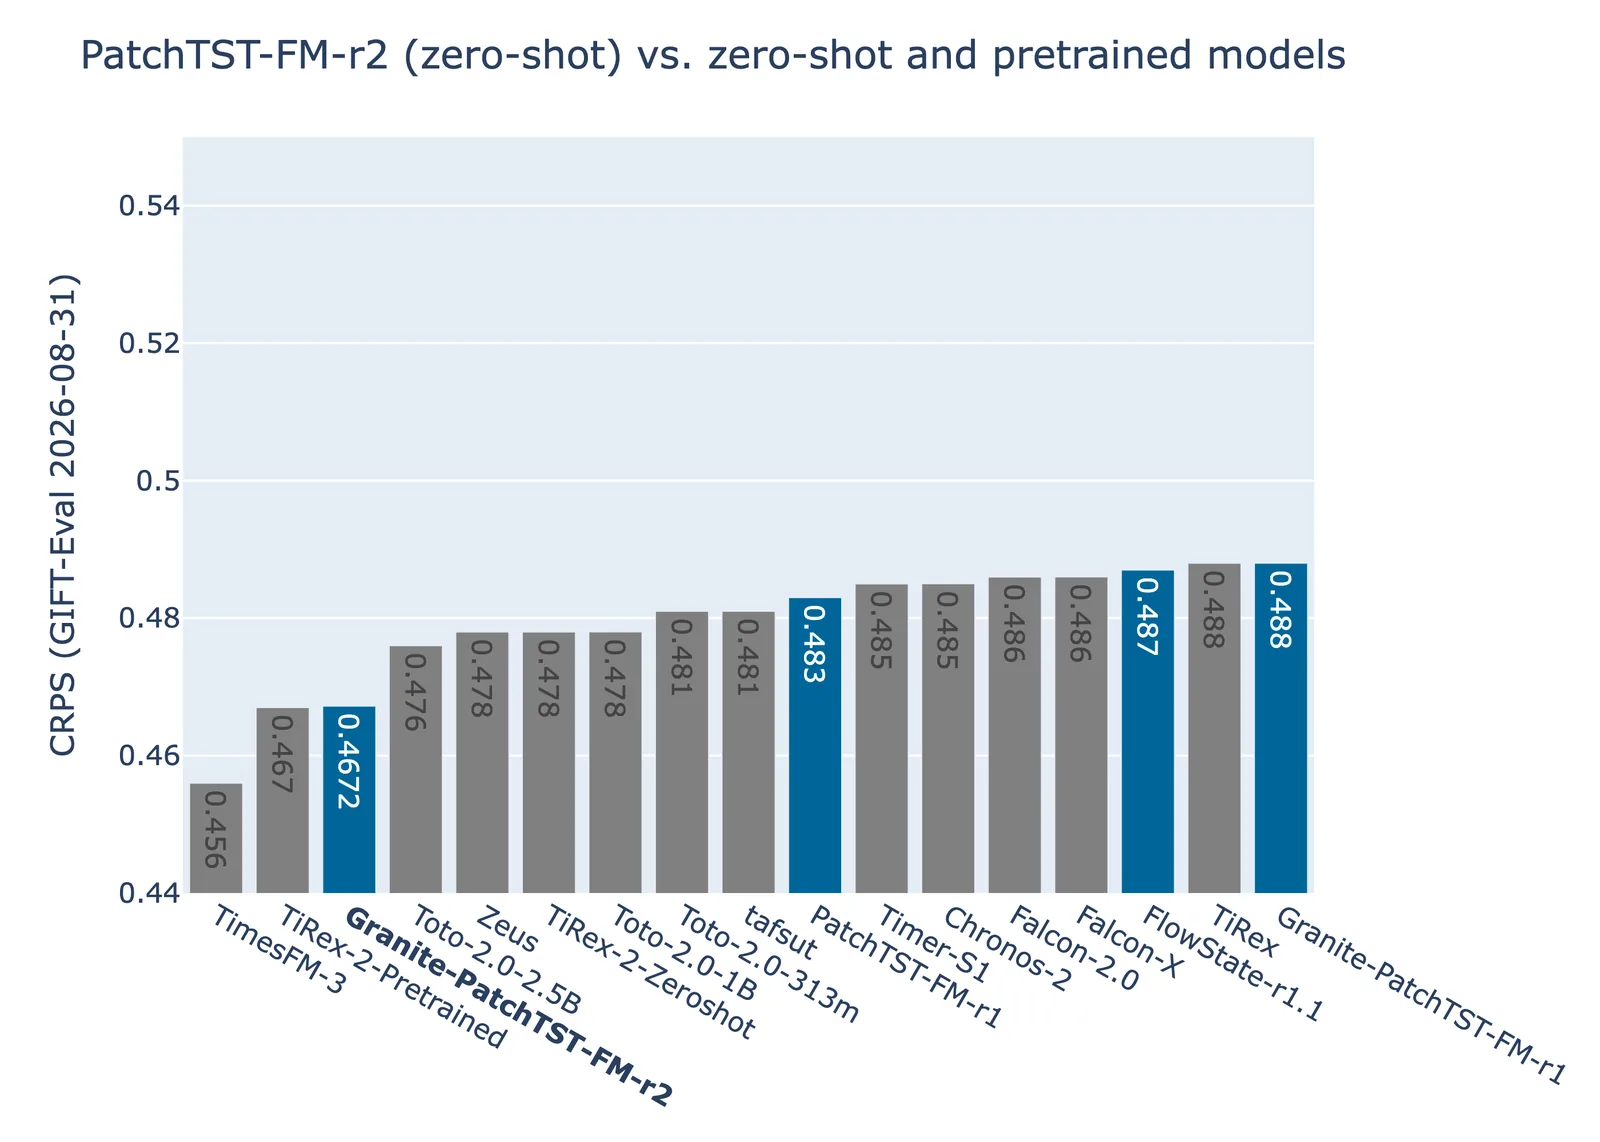
Figura 3. CRPS en GIFT-Eval cuando se consideran tanto los modelos replicables sin ajuste previo como los preentrenados.
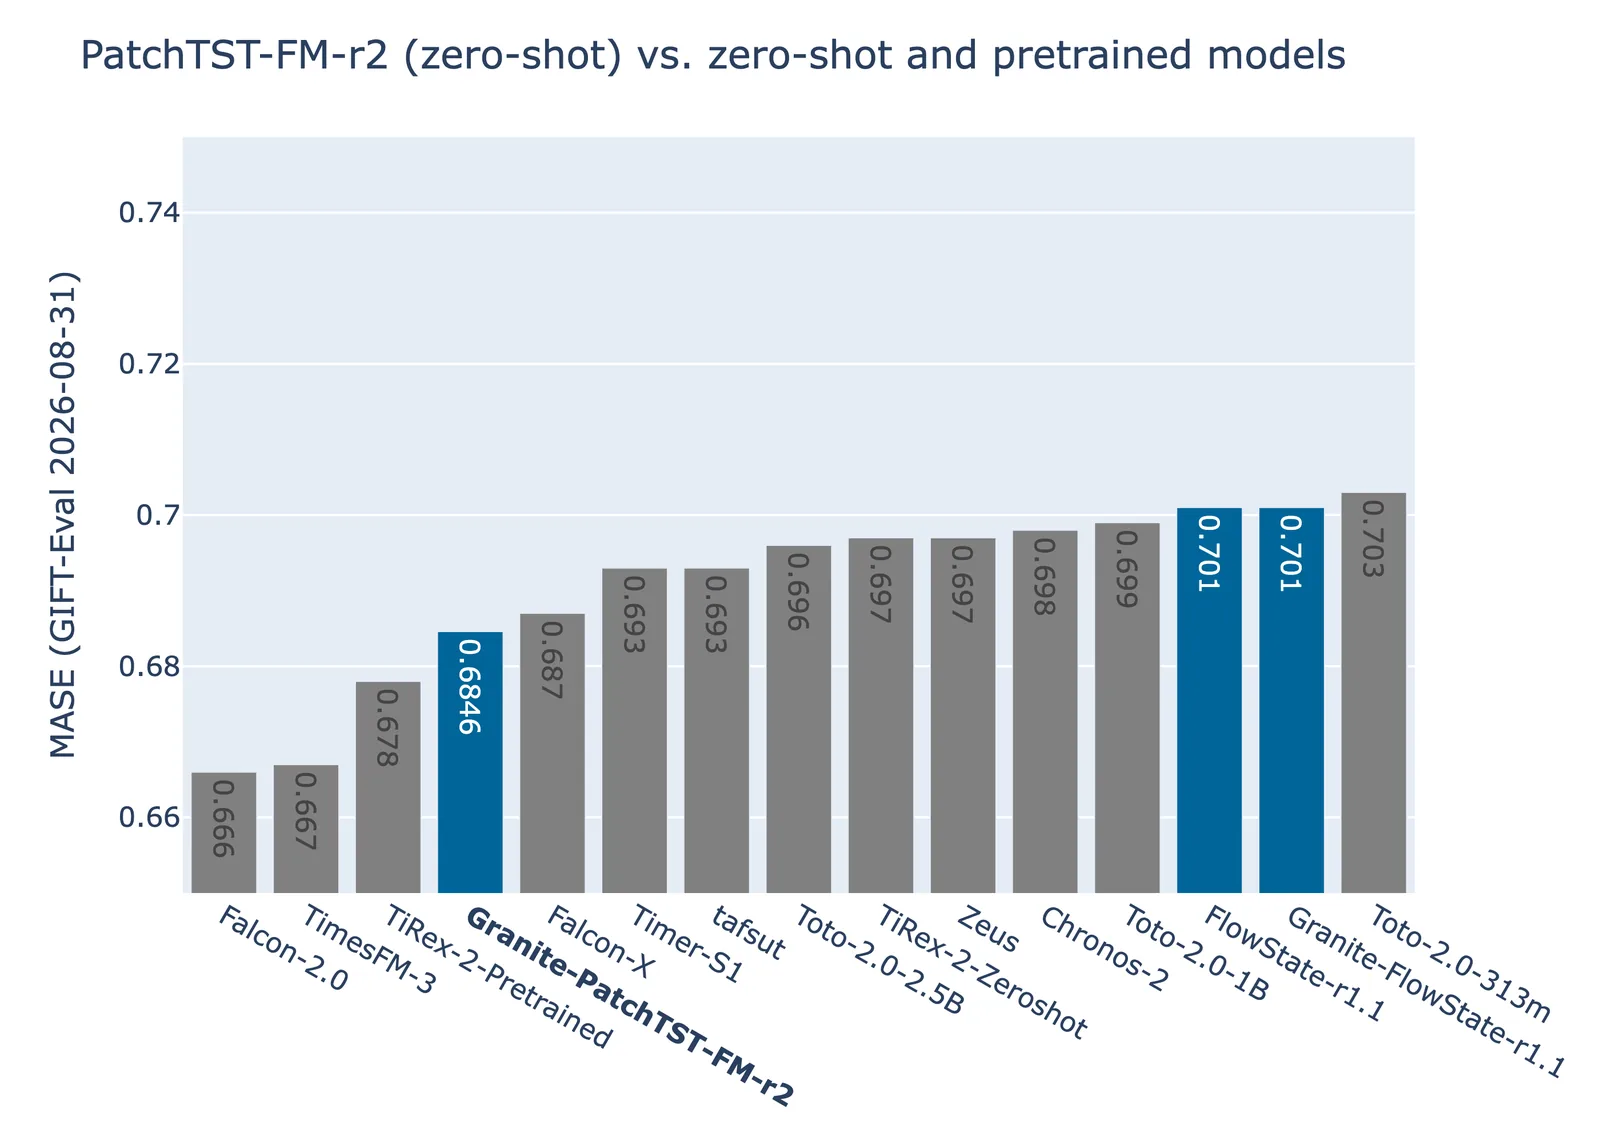
Figura 4. MASE en GIFT-Eval cuando se consideran tanto los modelos replicables sin ajuste previo como los preentrenados.
¿Qué cambió respecto de PatchTST-FM-r1?
PatchTST-FM-r2 conserva la representación por parches que hizo efectiva a la familia PatchTST, pero rediseña la arquitectura interna para capturar de forma eficiente las relaciones de corto y largo plazo, y para suavizar las predicciones entre parches. Ambas cosas mejoran sustancialmente las medidas de error.
Un cambio es el paso de capas de transformador estándar a capas que incorporan convolución junto a la autoatención de múltiples cabezas. Esas capas se conocen como capas conformer y tienen su origen en aplicaciones de procesamiento de habla.
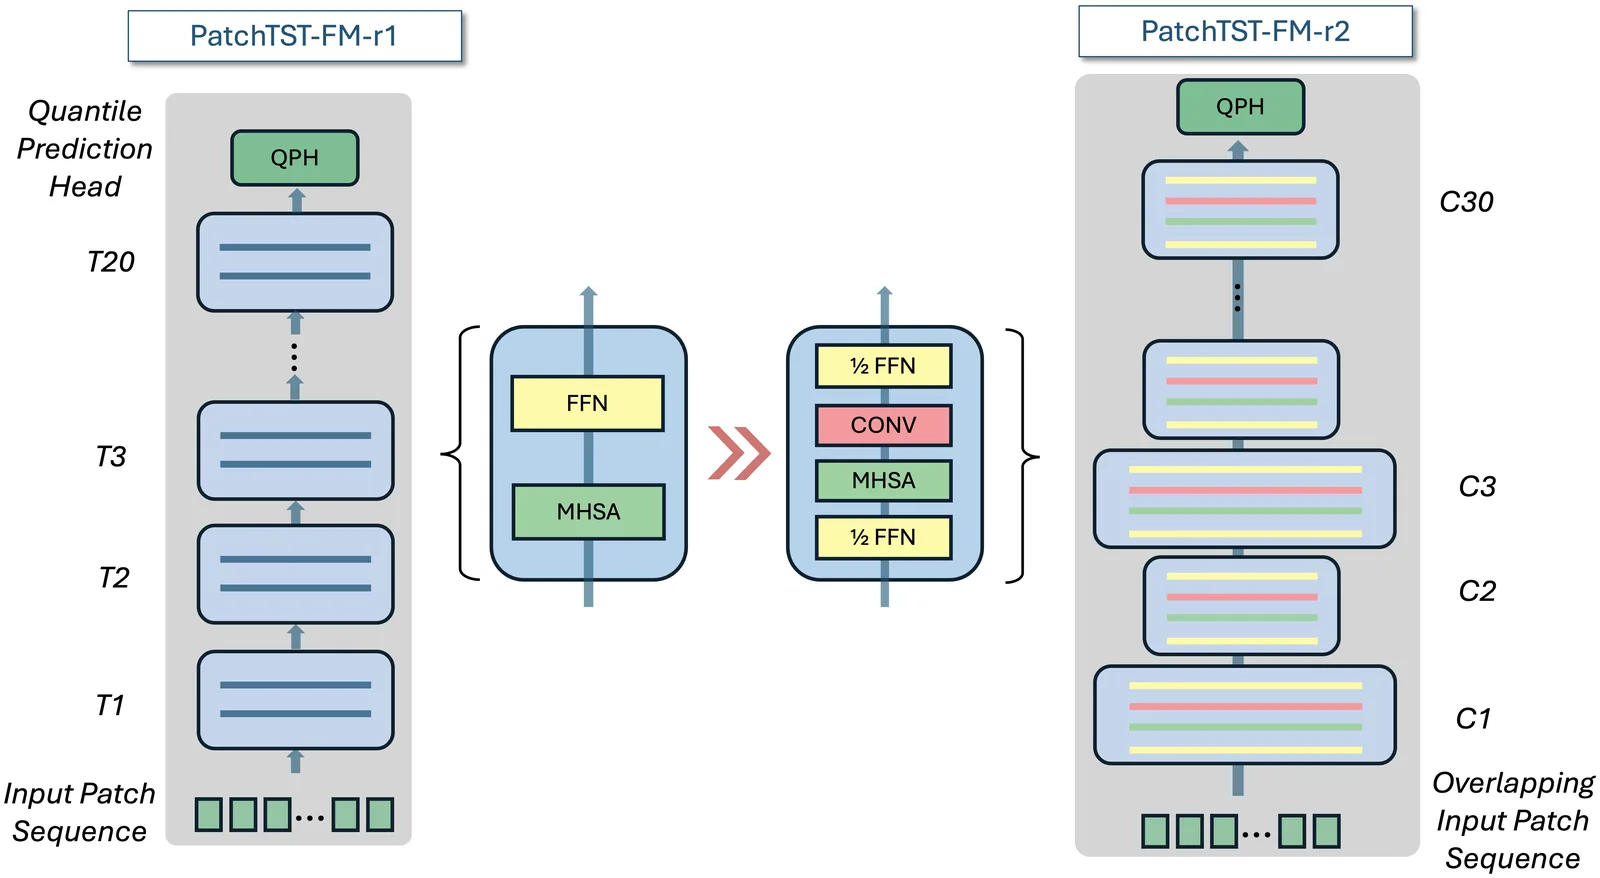
Figura 5. Evolución arquitectónica de PatchTST-FM-r1 al PatchTST-FM-r2 basado en conformer.
Un bloque de PatchTST-FM-r1 combina autoatención de múltiples cabezas con una red de propagación hacia adelante. En r2, eso se reemplazó por un bloque de estilo conformer que contiene dos capas de propagación de medio paso rodeando la autoatención de múltiples cabezas y una capa de convolución temporal.
Eso le da al modelo dos mecanismos complementarios para razonar sobre una serie de tiempo. La autoatención puede modelar relaciones de largo alcance entre parches, mientras la convolución aporta un sesgo inductivo hacia la estructura temporal local. El componente convolucional captura entonces las interacciones de corto plazo y deja que la atención se concentre en relaciones de horizonte más largo.
El fenómeno se observa en los patrones de atención capturados en las versiones con transformador y con conformer. Mientras una porción significativa de la autoatención del transformador (a la izquierda de la figura) se concentra cerca de la diagonal, es decir capturando relaciones locales, las atenciones del bloque conformer (a la derecha) muestran foco a larga distancia, lejos de la diagonal, gracias a que la capa de convolución cubre las distancias cortas. Los bloques conformer del troncal usan tamaños de núcleo de convolución alternados de 3 y 5, en un patrón repetido de 5, 5, 3 y 3.
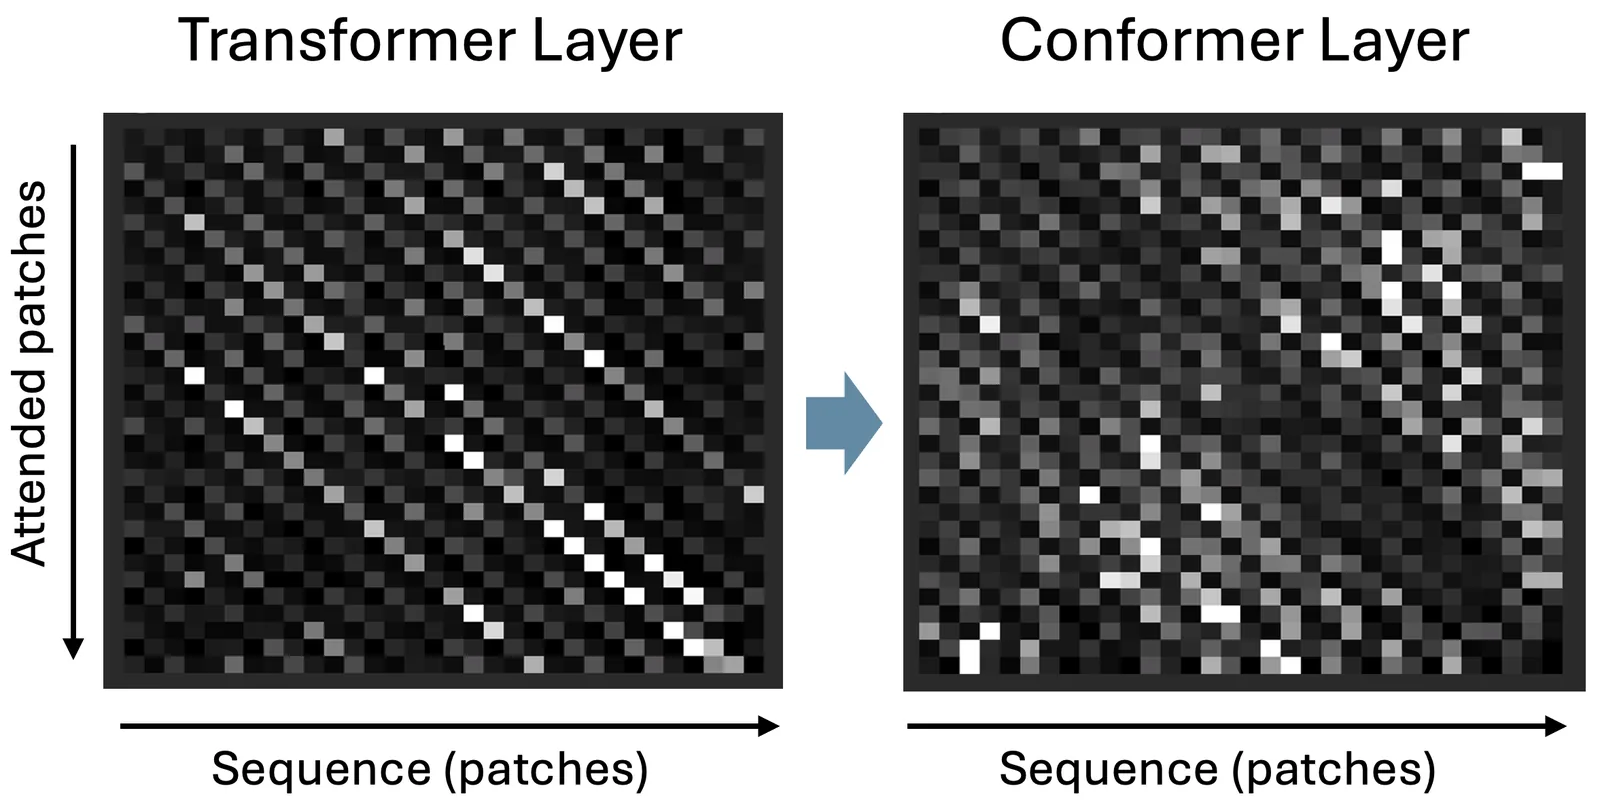
Figura 6. Comparación de los patrones de atención capturados en la versión con transformador (izquierda) y con conformer (derecha), usando muestras reales del conjunto de datos ETTh1.
Además, PatchTST-FM-r2 usa parches con 50% de traslape, ponderación por ventana de Hamming y pronóstico por traslape y suma para suavizar los bordes entre parches y mejorar la exactitud. Por último, la arquitectura agrega normalización para dar estabilidad y se expande de 20 a 30 bloques.
Con esos cambios, el modelo resultante tiene cerca de 385 millones de parámetros, admite contextos muy largos de hasta 8.192 pasos y predice 99 cuantiles sobre largos de pronóstico flexibles. Entrega tanto pronósticos puntuales como salidas por cuantil, para distribuciones de pronóstico e intervalos de incertidumbre.
¿Con qué datos se entrenó?
En modelos fundacionales pensados para aplicaciones reales, la calidad es solo una consideración. Cada vez más, quien desarrolla necesita entender qué datos entraron al modelo, si datos del banco de pruebas pudieron filtrarse al entrenamiento y qué implicancias tiene eso para el despliegue.
PatchTST-FM-r2 usa un corpus de preentrenamiento documentado, compuesto por cuatro fuentes: conjuntos seleccionados de GiftEvalPretrain; datos sintéticos propios basados en KernelSynth con núcleos periódicos modificados y aumentación limitada; un corpus TSMixup generado con el enfoque descrito por Chronos, pero restringido a conjuntos fuera del set de evaluación de GIFT-Eval; y cerca de 500.000 secuencias sintéticas CauKer, cada una de 4.096 pasos de largo.
Para quien adopta esto en una empresa, ese nivel de transparencia puede ser tan importante como unos puntos más en un ranking. No elimina la necesidad de una revisión propia de gobernanza y licenciamiento, pero entrega bastante más información para hacerla que un corpus de preentrenamiento opaco.
Abierto para investigación y también para uso comercial
Granite Time Series PatchTST-FM-r2 tiene doble licencia Apache 2.0 y OpenMDW 1.0. El usuario puede elegir cualquiera de las dos, y ambas otorgan derechos amplios y permisivos de uso, modificación y distribución. OpenMDW, de la Linux Foundation, ofrece un marco de licenciamiento diseñado específicamente para modelos de IA y materiales asociados.
La implementación de la arquitectura también está disponible en el repositorio Granite-TSFM y es compatible hacia atrás con los puntos de control de PatchTST-FM-r1.
Probarlo en unas pocas líneas
La forma más fácil de evaluar un modelo fundacional es sobre los datos propios. Primero se instala el paquete Granite TSFM:
pip install "granite-tsfm>=0.3.9"Después se carga PatchTST-FM-r2 directamente desde el repositorio de Hugging Face:
import pandas as pd
from tsfm_public import PatchTSTFMForPrediction, TimeSeriesForecastingPipeline

model = PatchTSTFMForPrediction.from_pretrained(
    "ibm-granite/granite-timeseries-patchtst-fm-r2"
)

df = pd.read_csv(
    "https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
    parse_dates=["date"],
)

pipe = TimeSeriesForecastingPipeline(
    model=model,
    id_columns=[],
    timestamp_column="date",
    target_columns=["HUFL"],
    max_context_length=model.config.context_length,
    context_length=512,
    prediction_length=64,
    impute_method=None,
    quantile_levels=[0.1, 0.5, 0.9],
    explode_forecasts=True,
    freq="1h",
)

forecast = pipe(df.iloc[-512:])
Para equipos de la región, el caso de uso más directo no es el pronóstico bursátil sino el consumo eléctrico y la demanda de inventario: con 385 millones de parámetros, el modelo cabe holgadamente en una GPU de escritorio, y la doble licencia permisiva evita la revisión legal que suele frenar los pilotos con pesos de licencia restrictiva.