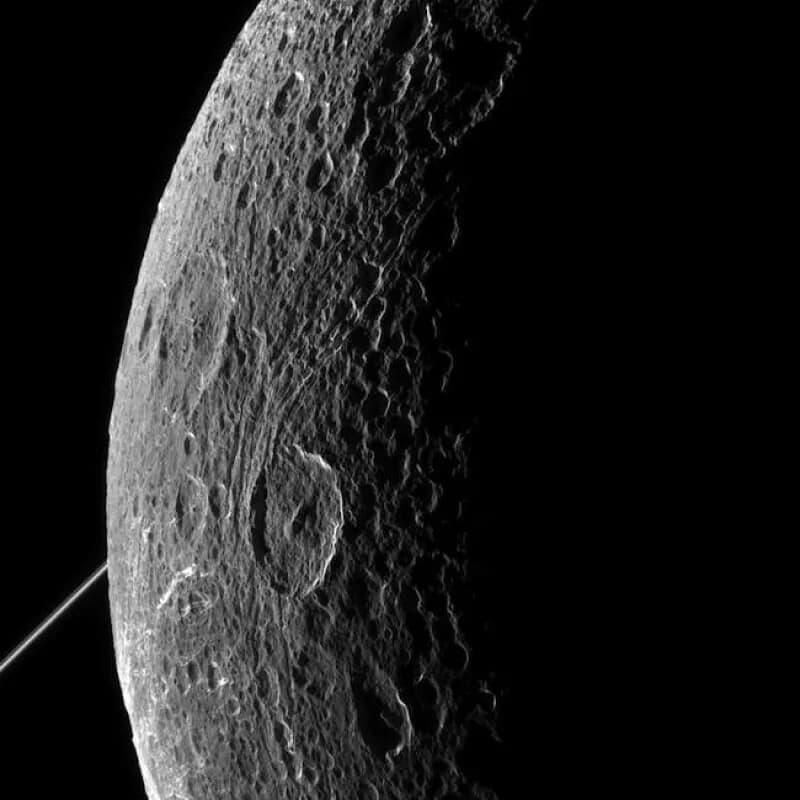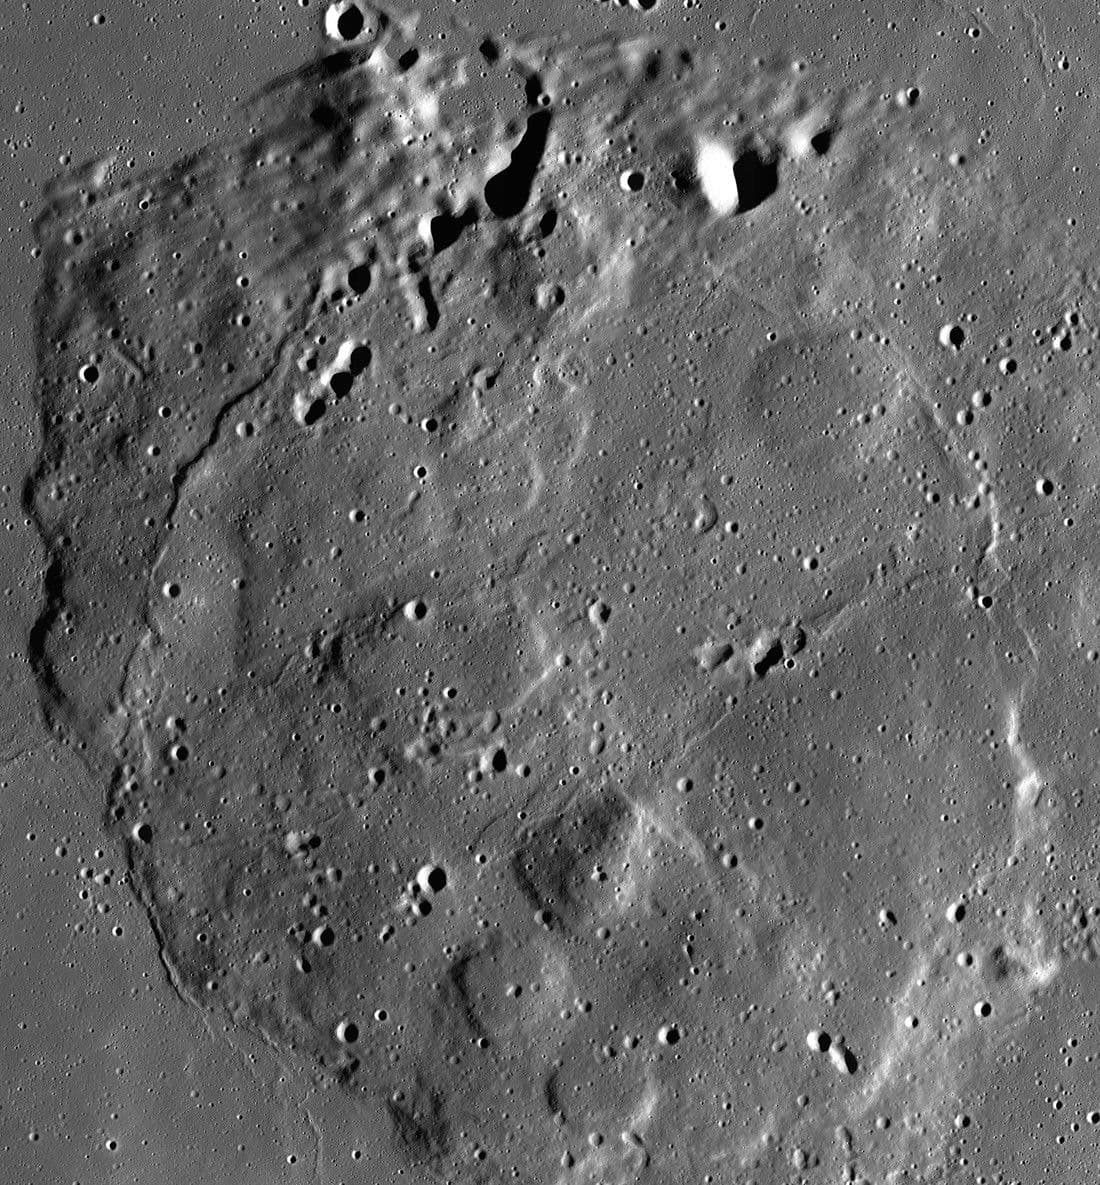
NASA lanzó junto a IBM Research y varias instituciones académicas el NASA-IBM Lunar Foundation Model, uno de los primeros modelos de inteligencia artificial de código abierto construidos específicamente para ciencia lunar. El modelo se entrenó sobre todo con datos del Lunar Reconnaissance Orbiter (LRO), está alojado públicamente en Hugging Face y su código completo quedó en GitHub.
Kevin Murphy, director de datos científicos y director interino de datos e IA en la sede de NASA en Washington, explicó el problema que el modelo viene a resolver.
"NASA ha pasado décadas construyendo un registro científico extraordinario de la Luna, pero recolectar datos es solo una parte del trabajo. También tenemos que hacer que los datos sean más fáciles de explorar y usar para los científicos. El NASA-IBM Lunar Foundation Model muestra lo que es posible cuando llevamos la IA a los petabytes de datos científicos de NASA. Esa es una oportunidad real que vemos con la IA, convertir datos a gran escala en nuevos descubrimientos", dijo Murphy.
Los modelos tradicionales exigen construir y entrenar un algoritmo desde cero para cada tarea. Un modelo fundacional, en cambio, se preentrena sobre conjuntos grandes y sin etiquetar, y después se ajusta con poca cantidad de datos etiquetados para tareas distintas.
¿Con qué datos se entrenó?
Los datos que el LRO recolectó en los últimos 17 años cubren en detalle casi toda la superficie lunar. Lo que produjo esa misión pesa más que todas las demás misiones planetarias de NASA sumadas, y arma un mosaico de alta resolución casi sin costuras de la Luna entera. El entrenamiento usó alrededor de 2 millones de teselas de imagen.
| Conjunto de imágenes del LRO | Cantidad | Resolución |
|---|---|---|
| Cámara de alta resolución | más de 1 millón | 1 metro por píxel |
| Multiespectrales | cerca de 964.000 | 100 metros por píxel |
También entró material de otras misiones, entre ellas GRAIL y Lunar Prospector de NASA, y el Selenological and Engineering Explorer de la agencia japonesa JAXA.
¿Para qué sirve en la práctica?
Como el modelo ya viene preentrenado, un científico planetario lo adapta a tareas distintas con poco material etiquetado. Mapear cráteres, detectar formaciones volcánicas jóvenes o estimar dónde puede haber hielo cerca de los polos.
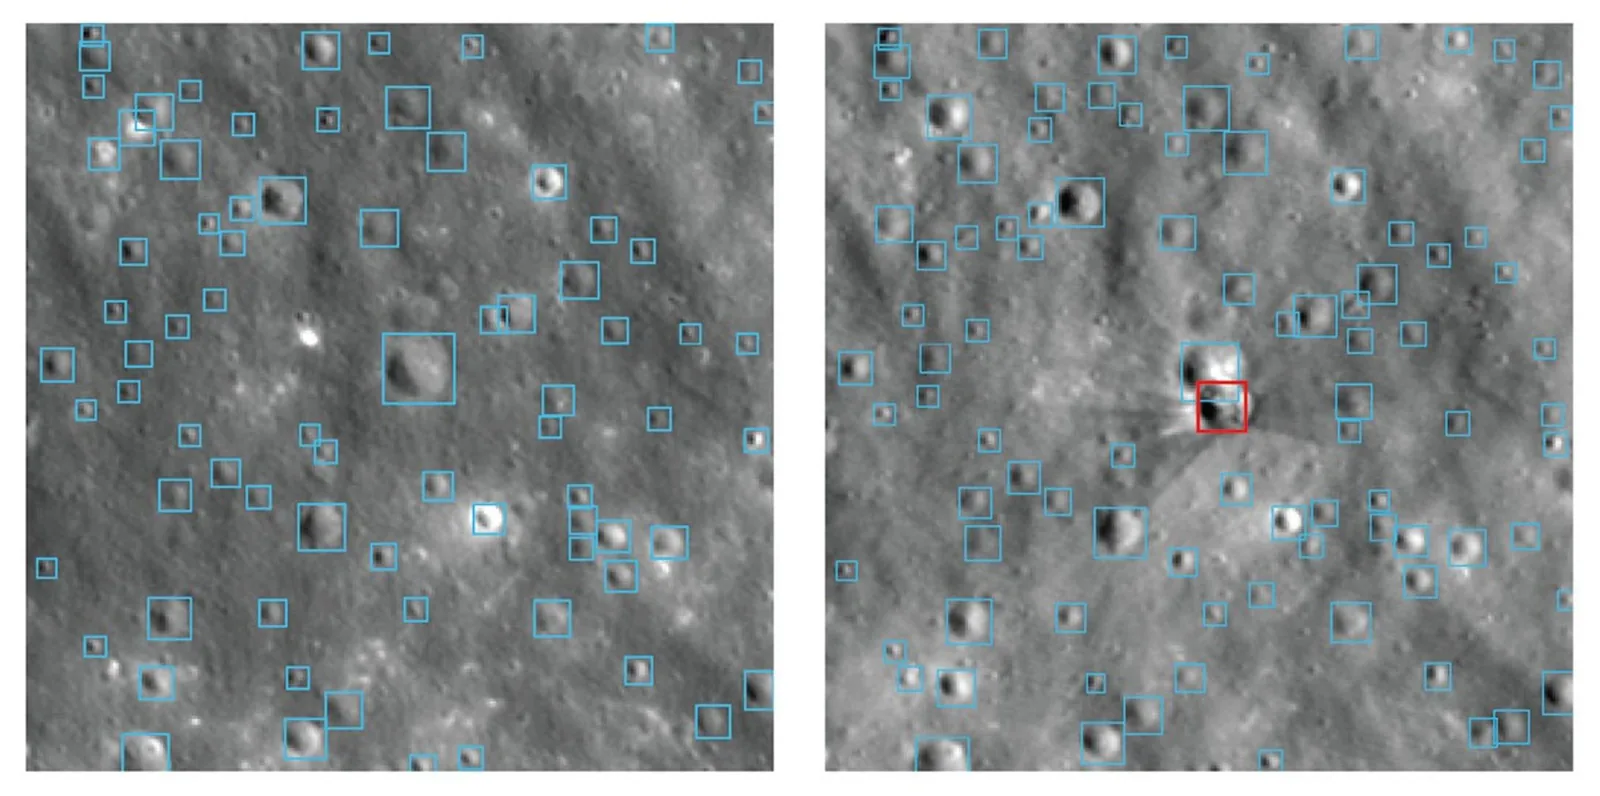
En el caso del hielo, el modelo ayuda a estimar dónde es probable que las manchas se mantengan estables, en la superficie y bajo ella. Las regiones en sombra permanente se mantienen lo bastante frías como para atrapar y conservar hielo por hasta miles de millones de años, y mapearlas abre la posibilidad de ubicar recursos aprovechables para la exploración futura.
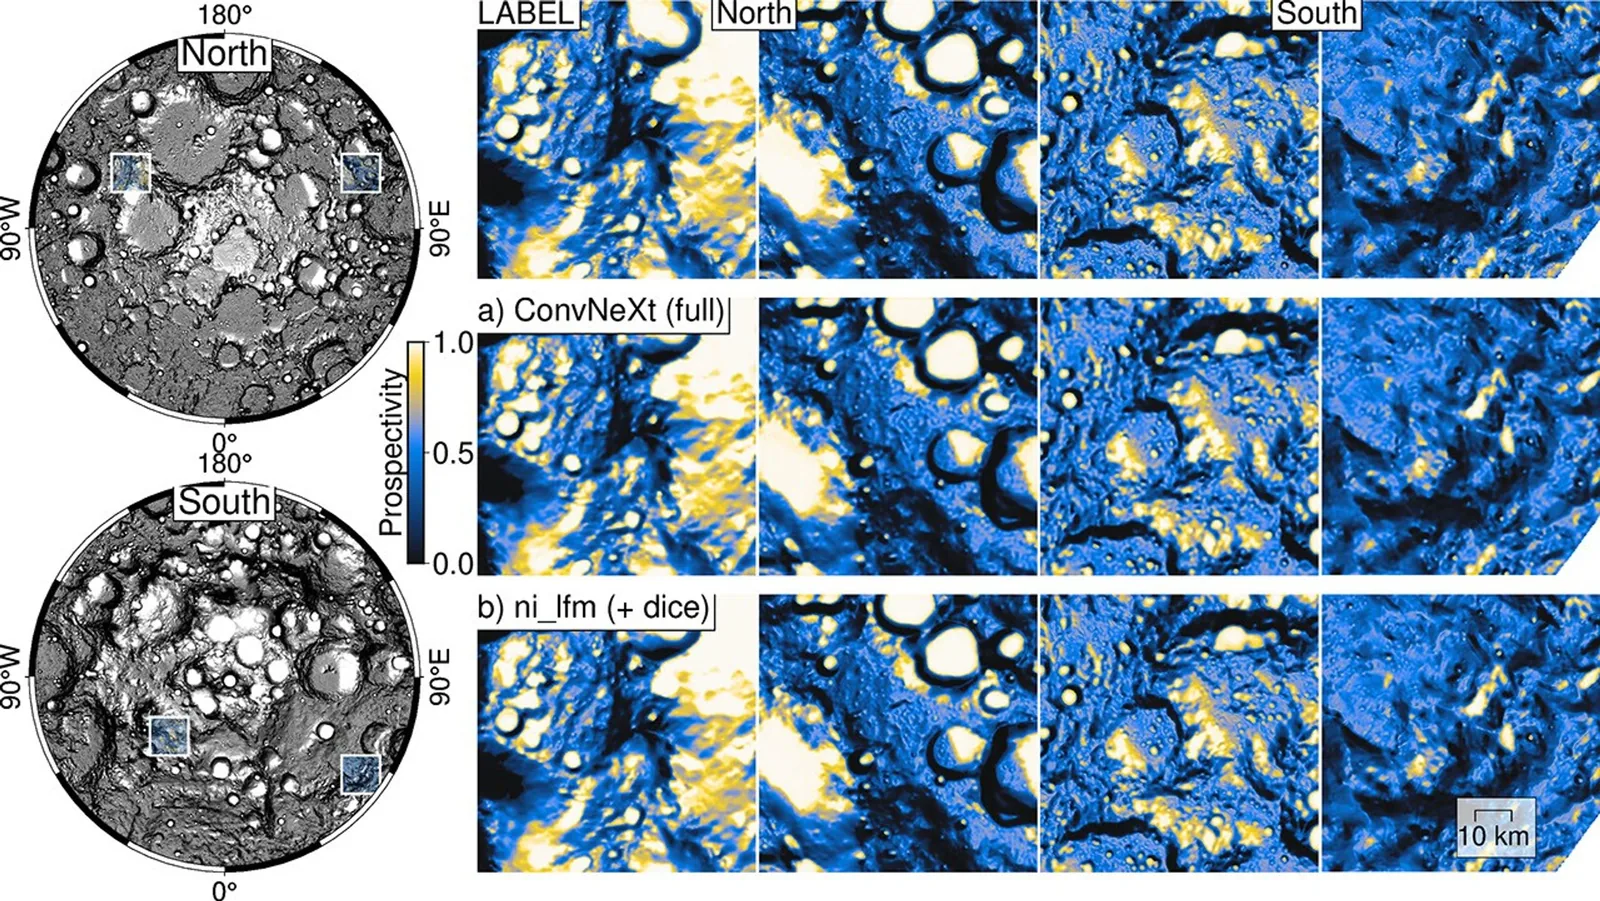
La Luna ya no tendría actividad volcánica, pero alguna vez tuvo procesos geológicos activos. El modelo acelera la identificación de unas formaciones de aspecto extraño llamadas parches de mare irregulares. Como se ven relativamente jóvenes, desafían las líneas de tiempo aceptadas para el enfriamiento lunar.
Con los cráteres pasa algo parecido. Cada uno se formó por un impacto, así que contarlos y medirlos es la base para datar la superficie y reconstruir la historia del sistema solar. El modelo acorta esa parte del trabajo.
¿Qué tan bien funciona?
El modelo igualó o superó el desempeño de varios modelos de referencia en todas las tareas evaluadas. En mapeo de cráteres y en segmentación de parches de mare irregulares los resultados son comparables, y la ventaja clara aparece en la estimación de estabilidad del hielo polar.
El NASA-IBM Lunar Foundation Model se suma a otros modelos de la misma colaboración entre NASA e IBM.
- Los modelos Prithvi, una familia preentrenada con datos de observación terrestre, para monitoreo de desastres, mapeo de inundaciones, predicción de rendimiento de cultivos y pronóstico de huracanes.
- El modelo Surya, de heliofísica, entrenado con observación solar de alta resolución para anticipar fenómenos como las fulguraciones que alteran redes eléctricas y satélites.
Dentro de NASA lo construyó el equipo Impact AI del Marshall Space Flight Center en Huntsville, Alabama, junto a la División de Ciencia Planetaria, el Goddard Space Flight Center en Greenbelt, Maryland, y el Ames Research Center en California. El equipo científico sumó a la Universities Space Research Association, el SETI Institute, la Universidad de Maryland en Baltimore County y la Universidad Howard.
Junto al modelo se liberaron los conjuntos de preentrenamiento listos para aprendizaje automático y las colecciones de referencia, integrados al conjunto de herramientas de código abierto TerraTorch, con un reporte técnico publicado en Hugging Face.