Investigadores de la Universidad de Maryland y AWS presentaron LEGO-Anything, un proyecto en que un agente de código construye una escena 3D editable a partir de una sola foto, escribiendo y corrigiendo código paso a paso, informó The Decoder el 3 de octubre. El benchmark que acompaña el trabajo muestra dónde se rompe todavía el proceso. Los agentes fallan al evaluarse a sí mismos y en la precisión geométrica.
La premisa es que una reconstrucción 3D desde una foto sirve más cuando existe como programa ejecutable, que se puede inspeccionar, editar y consultar.
¿Cómo funciona el enfoque Image-to-Code?
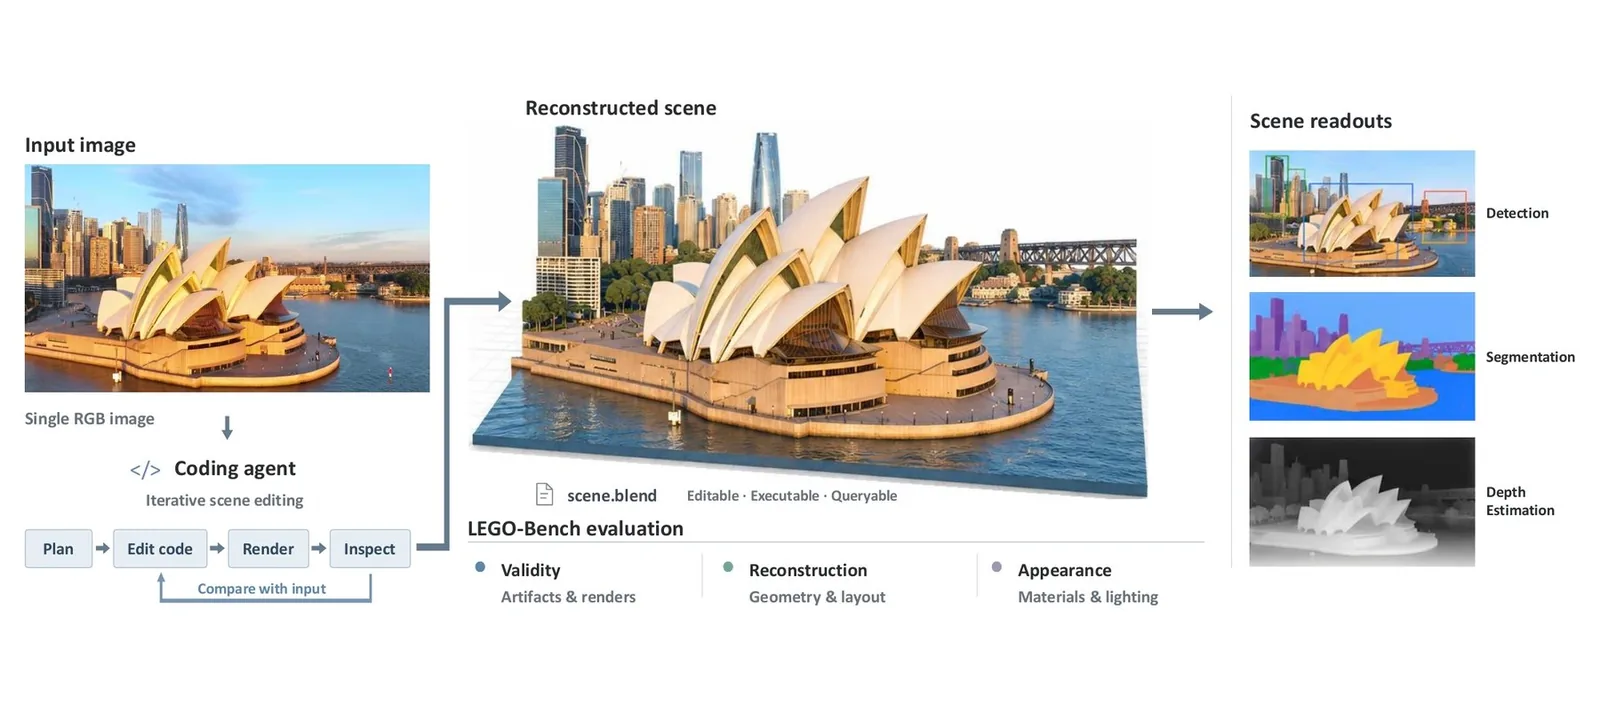
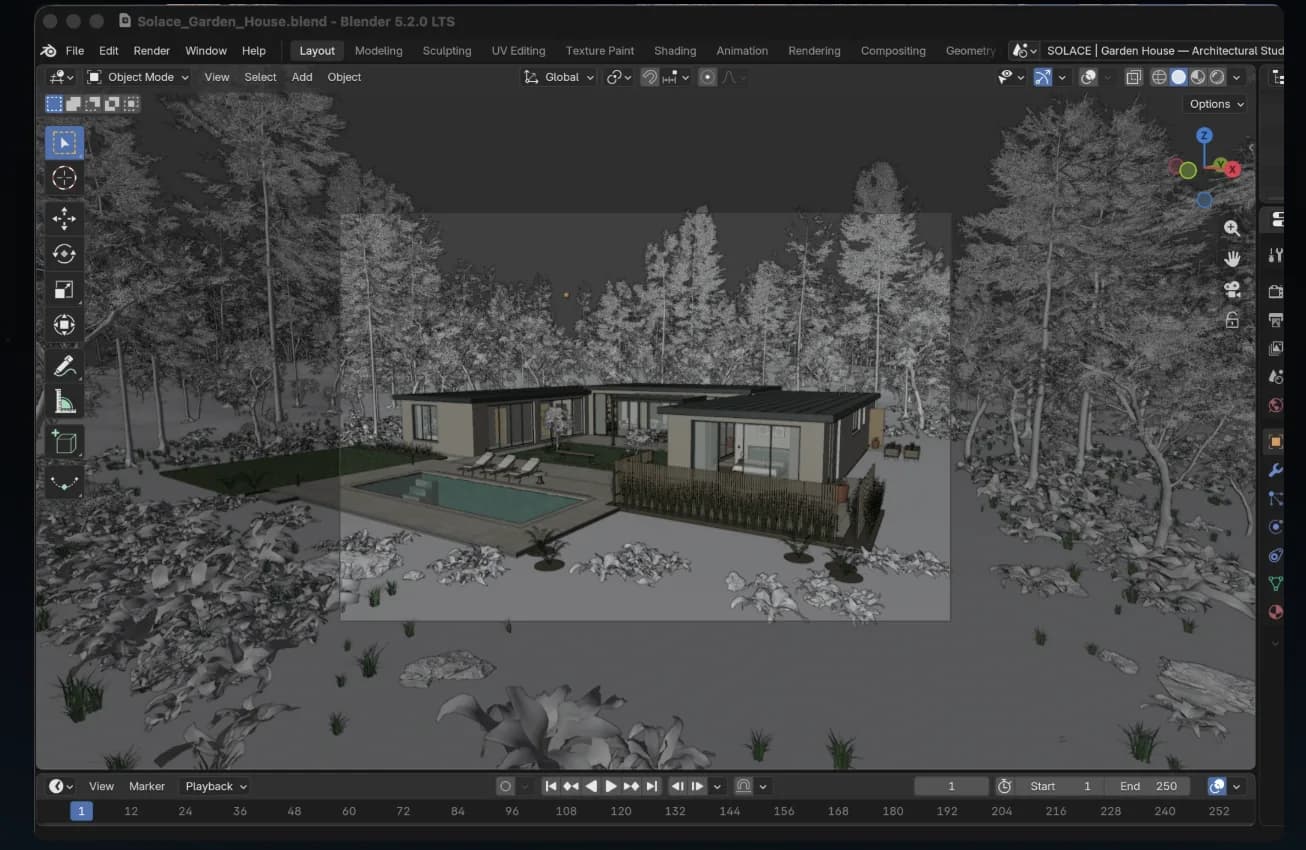
El método se llama Image-to-Code. Un agente de código recibe una imagen y escribe código para Blender, el software 3D de uso masivo. No genera la escena de una sola vez. Trabaja por iteraciones, escribe código, lo ejecuta, mira el resultado y lo corrige hasta que la escena se parece a la original.
Como el resultado es un programa, guarda de forma explícita los objetos, la geometría, la disposición y la posición de la cámara. La escena se puede ejecutar, revisar y modificar como cualquier otro código.
Escenas de simulador como respuesta exacta
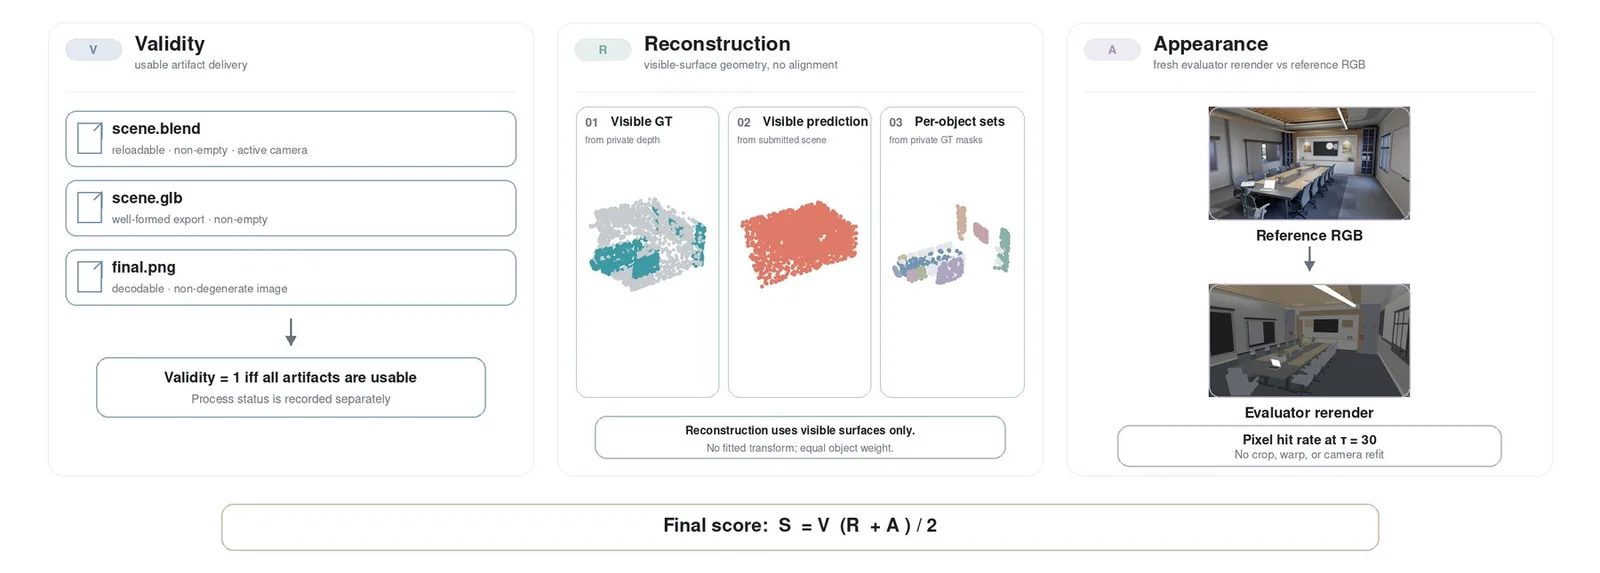
Para medir el desempeño de los agentes, el equipo creó LEGO-Bench, con 208 imágenes de 104 escenas interiores y exteriores y 443 recursos 3D registrados.
Según los investigadores, las fotos reales no traen una referencia 3D exacta contra la cual comparar, y las escenas sintéticas simples se ven poco realistas. LEGO-Bench resuelve eso renderizando sus imágenes desde escenas de simulador construidas por profesionales. Las imágenes de entrada se ven naturales, mientras la geometría, la profundidad y la asignación de objetos quedan ocultas y sirven de pauta para la corrección automática. La complejidad de la escena también se puede subir sin cambiar la iluminación ni la cámara.
El benchmark evalúa cada escena en tres ejes.
- Validez, si el agente entregó o no una escena utilizable.
- Reconstrucción, qué tan exacta es la geometría visible.
- Apariencia, qué tanto se parece al original, comparando píxel a píxel la escena renderizada contra la imagen de referencia.
¿Qué tan bien les fue a los modelos?
Las seis configuraciones de GPT probadas entregaron una escena funcional casi siempre, pero la precisión varió mucho. GPT-6 Astra, el mejor modelo probado, llegó a 53,4% en escenas interiores y a 39,6% en exteriores. Las configuraciones más débiles rondaron el 15%. Los modelos más antiguos suelen errar el ángulo de cámara, la iluminación o se saltan objetos completos.
Mientras más compleja la escena, más cae la precisión, y los exteriores son más difíciles que los interiores. Cuando los investigadores aumentaron el presupuesto de razonamiento, las variantes de GPT-6 mejoraron harto. En un subconjunto de pruebas de oficinas, Astra subió de 32,3% a 61,8%.
Al revisar los pasos de trabajo de los agentes, el equipo encontró tres problemas frecuentes. Intentos iniciales malos, correcciones que deshacían avances anteriores y una autoevaluación poco confiable. Incluso GPT-6 Astra arruina su propia escena al final del proceso, y en un caso cayó de 33,9% a 4,4%.
Los agentes no saben si mejoraron
Cuando los modelos tuvieron que elegir cuál de dos versiones se parecía más al original, su juicio geométrico quedó cerca o por debajo del azar, incluso al evaluar sus propias escenas. En la práctica, un agente no distingue si su escena mejoró. Los investigadores concluyen que la corrección debe apoyarse en mediciones concretas y no en el juicio del propio agente.
De ahí salió LEGO-Plugin, una extensión que no requiere entrenamiento adicional. Ancla la escena inicial en la imagen de referencia, reemplaza la autoevaluación por mediciones concretas y protege los avances correctos de las ediciones que retroceden. El plugin mejoró a los seis modelos. Los agentes más débiles ganaron más, con alzas de hasta 62,7%, mientras el mejor modelo sumó apenas unos dos puntos porcentuales.
Todavía no alcanzan a los modelos especializados
Por último, el equipo probó si las escenas reconstruidas sirven de base para tareas de visión estándar. Como cada escena es un programa, la detección de objetos, la segmentación y la estimación de profundidad se pueden sacar directamente de ella.
Sin entrenamiento extra, las escenas dieron resultados utilizables pero discretos en las tres tareas. La detección de objetos fue la que mejor resultó, con cerca de la mitad del rendimiento del modelo especializado DINO. En segmentación y profundidad, la distancia con modelos como SAM 3 y Depth Anything 3 fue mayor. Los autores dicen que los programas de escena de los agentes actuales son prometedores, pero todavía no son lo bastante exactos.
Otros caminos hacia la escena 3D
La ventaja de GPT-6 Astra en LEGO-Bench coincide con otras observaciones. El investigador de IA Yoav Artzi ve en el modelo un gran salto en comprensión espacial y sospecha que se entrenó con mucho material 3D, como escenas de Blender. Los fabricantes de software 3D ya se preparan para estos agentes, y Unity publicó plugins oficiales para Claude Code y Codex.
Otros enfoques se saltan el código y reconstruyen la escena dentro del modelo, como el modelo de mundo Atlas de World Labs. Google DeepMind sigue otra ruta con GenCeption, que usa un modelo de video para estimar profundidad y segmentar con un rendimiento equivalente al de los modelos especializados.