
Robótica
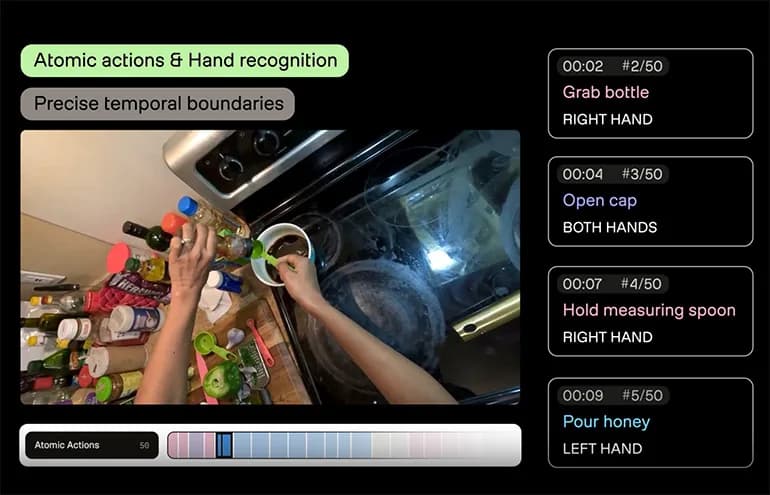
Pegasus 1.6 de TwelveLabs entrena robots con video en primera persona
El modelo segmenta, etiqueta y filtra grabaciones hechas desde el punto de vista del operador para convertirlas en datos de entrenamiento.
The Robot Report
9 notas publicadas
Un equipo de la Universidad de Maryland y AWS midió cuánto aciertan los agentes de código al convertir una foto en un programa de Blender, y cuánto se equivocan al juzgar su propio trabajo.
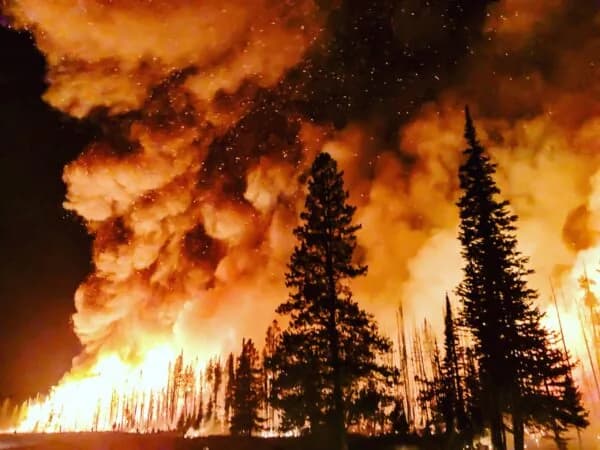
El equipo AURA Foresight, de Australia y Reino Unido, detectó focos en menos de 10 minutos en Alaska uniendo cámaras fijas, IA y drones coordinados.
La nueva tecnología permite que robots humanoides sincronicen sus movimientos con el lenguaje hablado en tiempo real, logrando interacciones más naturales.
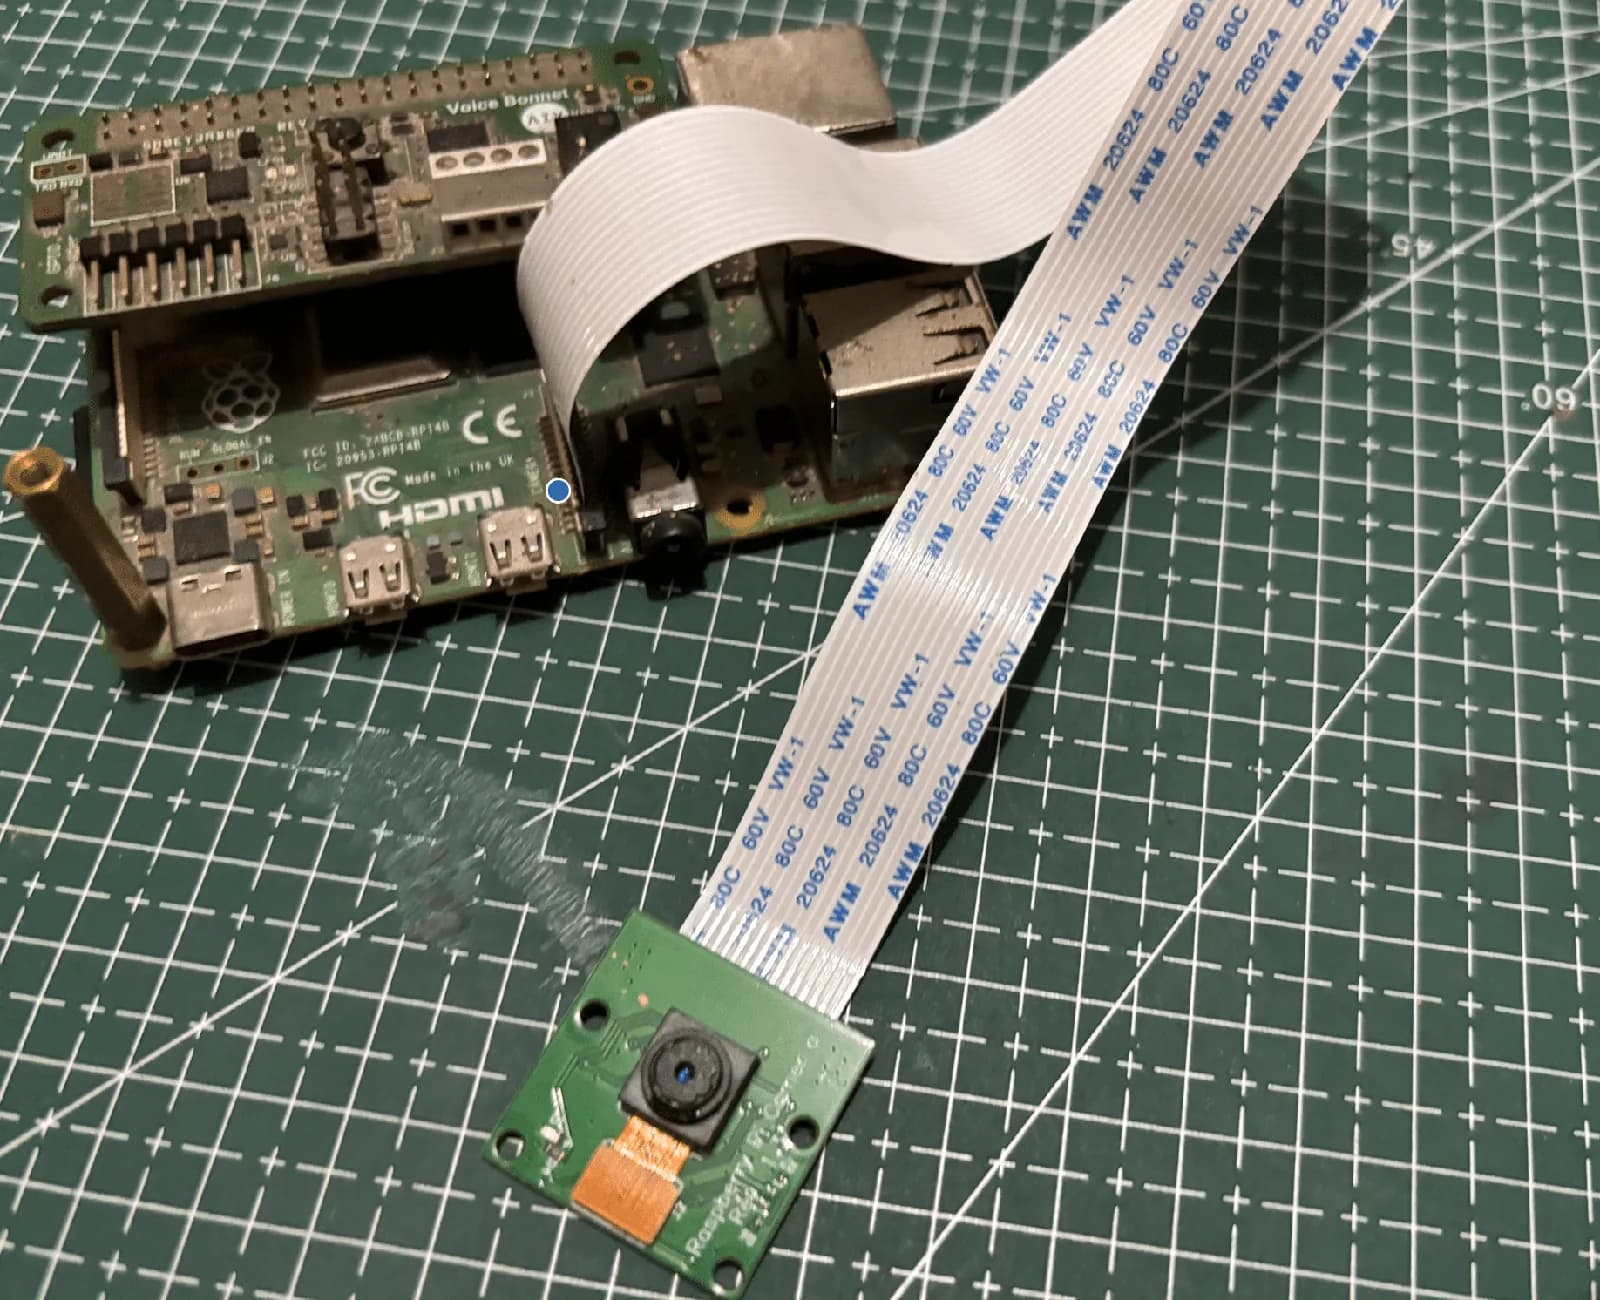
El proyecto clasifica cada píxel de la escena en categorías como calzada, vehículo o peatón, y suma seguimiento de objetos para anticipar trayectorias en tiempo real.
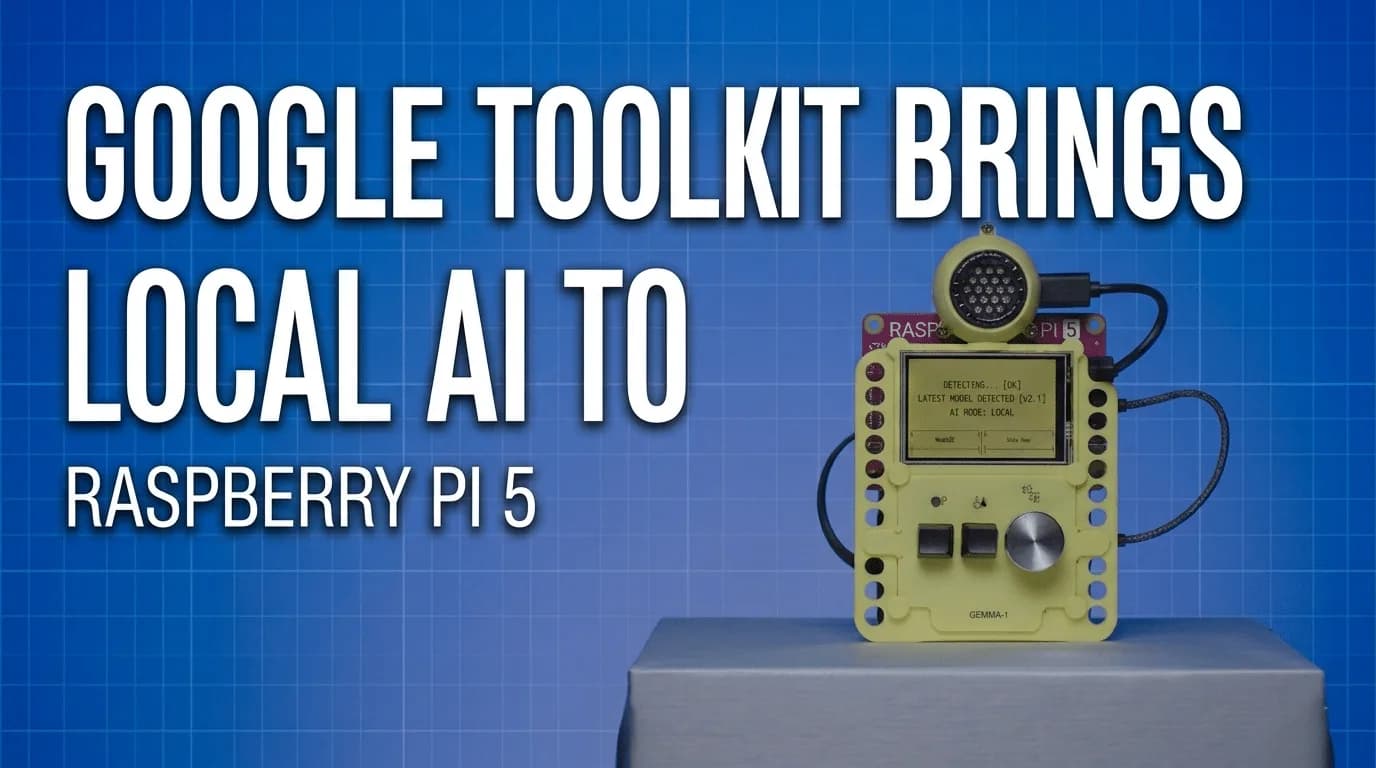
El tutorial oficial de Raspberry Pi mide 433,17 tokens por segundo de prefill con Gemma 3 270M sobre la placa de 8 GB, sin enviar una sola consulta a la nube.
Con TAO, LoRA y un agente de programación, NVIDIA post-entrenó su modelo de razonamiento visual para preguntas sobre video y comprimió a un día lo que antes tomaba una semana de ingeniería.
El nuevo motor DNN acelera modelos como Qwen 2.5 y Gemma 3 con backends nativos en Intel, Arm, Qualcomm y RISC-V, y supera por hasta 36% al ONNX Runtime en benchmarks.
Espressif publica un tutorial paso a paso para compilar ESP-WHO sobre la ESP32-S3-EYE, correr reconocimiento facial y extenderlo con callbacks que prenden un LED al detectar un rostro.
Otros temas que aparecen junto a #vision por computador en nuestra cobertura editorial.