Nick Cammarata, investigador del laboratorio de interpretabilidad Goodfire, publicó un ensayo largo titulado "Neural Networks Are Already Clean" ("Las redes neuronales ya están limpias"). Su tesis es que el funcionamiento interno de los grandes modelos de IA es mucho más fácil de entender de lo que se pensaba. Con el texto, Cammarata rechaza una explicación que él mismo ayudó a construir hace años. Roon, de OpenAI, lo calificó de momento histórico, y Neel Nanda, investigador de Google DeepMind, advirtió que no hay que exagerarlo, según informó The Decoder el 16 de octubre de 2026.
¿Qué es la polisemanticidad?
La interpretabilidad mecanicista intenta ir más allá de observar lo que un modelo de IA responde. Busca rastrear cómo llega internamente a esas respuestas. En el caso ideal, cada una de los millones de neuronas artificiales representaría un concepto reconocible.
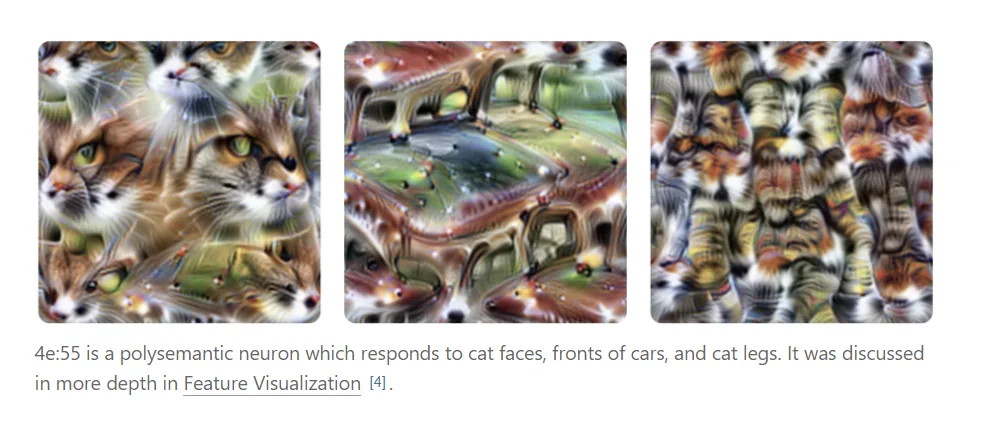
En la práctica, muchas neuronas parecían activarse con cosas sin ninguna relación entre sí, un fenómeno que los investigadores llaman polisemanticidad. Uno de los ejemplos tempranos y más conocidos es una neurona del modelo de imágenes InceptionV1 que respondía tanto a caras de gatos como a frentes de autos. Cammarata usó ese caso en sus propias investigaciones iniciales.
La explicación estándar era la superposición. Según esa teoría, cuando a una red le faltan neuronas, empaqueta conceptos sin relación en las mismas neuronas porque rara vez se estorban. El resultado parece un nudo. Por eso muchos laboratorios entrenan un segundo modelo, como un autoencoder disperso (sparse autoencoder), para separar los conceptos, y estudian ese modelo en lugar del original.
Cammarata tuvo un papel central en esa visión. Junto a Chris Olah escribió el paper "Zoom In", que presentó el primer circuito de superposición. En 2023 inició un proyecto de interpretabilidad automatizada en OpenAI. En ese momento solo cerca del 1,7% de las neuronas contaba como comprensible, incluso con la medida más generosa.
La evidencia se habría leído mal
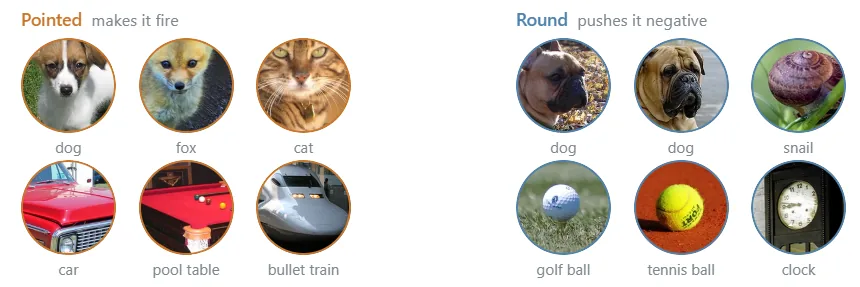
Cammarata cree ahora que los ejemplos más famosos se interpretaron mal. Según él, la neurona de gatos y autos es en realidad un detector de formas en V. Las formas puntiagudas, como el hocico de un zorro o una llama, la activan, y las formas redondas, como la letra O, empujan su activación a valores negativos. O sea, no representa dos conceptos sin relación como caras de gato y autos, y por lo tanto no es un ejemplo de superposición.
También reinterpreta el circuito de superposición de "Zoom In", donde un auto parecía esconderse entre neuronas de perros. A su juicio es generalización común y corriente, y el circuito simplemente agrupa autos y perros según hacia dónde miran respecto de la cámara. El desorden de las capas finales de InceptionV1 lo atribuye a una arquitectura anticuada y a herramientas de análisis débiles. Con mejores métodos de visualización, dice, los patrones de respuesta de esas neuronas se ven con mucha más claridad, y eso es motivo para revisar los hallazgos antiguos sobre lo difícil que es entender una red neuronal.
La ambigüedad que queda la explica con un patrón que llama generalización recursiva. Según Cammarata, una neurona crece como una rama que echa brotes laterales. Una neurona que reconocía la secuencia de letras "iy" pasó después a responder a "diy" y finalmente a "do it yourself" ("hazlo tú mismo"), que ya no contiene "iy". A diferencia de la superposición, estas agrupaciones enseñan algo sobre la red.
¿Qué tan legible es un modelo de lenguaje?
Para los modelos de lenguaje entrega cifras preliminares. En Qwen3-32B, cerca del 90% de los polos de neuronas tiene una tarea principal y alrededor del 7% tiene dos tareas relacionadas. Solo entre el 2% y el 4% queda sin explicar. Goodfire dice ver resultados parecidos en modelos de hasta billones de parámetros.
| Polos de neuronas en Qwen3-32B | Porcentaje |
|---|---|
| Con una tarea principal | cerca de 90% |
| Con dos tareas relacionadas | cerca de 7% |
| Sin explicar | 2% a 4% |
La mayor parte del trabajo la hicieron agentes de IA que analizan neuronas en masa. Cammarata toma prestada la idea de "The Bitter Lesson" de Rich Sutton y concluye que también en interpretabilidad la investigación simple a escala masiva le gana a los métodos ingeniosos de descomposición.
Cammarata no presenta un método nuevo. Vuelve al enfoque original del campo, estudiar las neuronas en forma directa, con mejores herramientas, modelos más grandes y agentes automatizados.
Lo que ganaría la seguridad de la IA
Si Cammarata tiene razón, sería una buena noticia para la seguridad de la IA. Hoy, aparte de vigilar las cadenas de razonamiento, que son cada vez menos confiables, hay pocas formas de saber si un modelo engaña a las personas o se comporta de manera peligrosa. Cammarata duda que la alineación, el trabajo de orientar la IA hacia objetivos humanos, se pueda resolver sin interpretabilidad, porque sin ella no sabemos qué estamos construyendo.
El engaño no tiene por qué esconderse de los propios circuitos del modelo, escribe. Si los humanos pasan a ser un "lector" más de la red, también pueden ver el engaño, y los errores se podrían corregir de forma dirigida.
Roon, empleado de OpenAI que publica con ese seudónimo en X y es una voz influyente en el mundo de la IA, celebró el ensayo. Dice ser amigo cercano de Cammarata y que sin él nunca habría llegado a OpenAI.
El trabajo "podría recordarse como un momento importante de la historia de la ciencia", escribió Roon.
Agregó que la noticia es tan buena que incluso Eliezer Yudkowsky, una de las voces más conocidas entre quienes advierten de una catástrofe por IA, tendrá que bajar su estimación de probabilidad de desastre. Para Roon, la alineación podría convertirse en una "ciencia normal".
Roon también tiene reservas. Otros investigadores deben confirmar los resultados, y sospecha que los avances en interpretabilidad van a empujar también las capacidades de la IA. Que vengan desde fuera, agrega, no es buena señal para los grandes laboratorios, OpenAI incluido.
Nanda ve una herramienta útil, no un avance definitivo
Neel Nanda es mucho más mesurado. Se le considera una de las figuras fundadoras de la interpretabilidad mecanicista y dirige el equipo de interpretabilidad de Google DeepMind. Antes trabajó en Anthropic y como investigador independiente.
Según cuenta, sus opiniones cambiaron. Desde mediados de 2024 se volvió más pesimista sobre la interpretabilidad ambiciosa y se inclinó por enfoques pragmáticos. Su equipo bajó la prioridad de la investigación en autoencoders dispersos. No los consideraban inútiles, pero no parecían valer el esfuerzo que el campo les estaba dedicando.
Nanda escribe que el trabajo de Cammarata es interesante pero no cambia el panorama general. El análisis por neuronas podría ayudar con preguntas prácticas, como por qué un modelo hizo algo cuestionable, y es mucho más fácil de aplicar a modelos de frontera. Lo que no acepta es la idea de que la interpretabilidad esté cerca de resolverse por completo. Espera que el análisis por neuronas tenga fallas serias y que también deje mucho afuera.
Nanda sigue creyendo que la superposición existe. Argumenta que los modelos de lenguaje almacenan muchos más datos que neuronas, y que las activaciones débiles en particular probablemente guardan buena parte de esa información. Duda que los hallazgos en modelos de imágenes pequeños se trasladen a los grandes. También cree que el ensayo define la monosemanticidad de forma demasiado laxa, aunque le reconoce a Cammarata haber revisado su trabajo antiguo con herramientas modernas.
Una parte de la disputa es de definiciones
Cammarata no tiene problema con que un modelo represente más conceptos que dimensiones, y Nanda lo ve de acuerdo en ese punto. Lo que Cammarata discute es que las redes empaqueten de forma arbitraria cosas sin ninguna relación.
El paper técnico que acompaña al ensayo todavía no se publica. Goodfire, como empresa de interpretabilidad, tiene además un interés evidente en la tesis. Si su lectura se sostiene, Cammarata cree que investigadores automatizados podrían hacer en meses lo que a los humanos les tomó casi una década con modelos de imágenes. Escribe que quizás no quede mucho tiempo para eso.