Los modelos de frontera como GPT-6 Astra son cada vez más difíciles de vigilar por dentro para los monitores de seguridad. Una investigación nueva de OpenAI identifica qué pasos del entrenamiento lo provocan y muestra que esa pérdida de transparencia no es del todo una ley de la naturaleza, sino que depende de decisiones sobre rendimiento y costo, informó The Decoder el 12 de noviembre.
Para controlar a los agentes de IA actuales, los investigadores de seguridad leen sus cadenas de pensamiento (CoT, por chain of thought). Antes de responder, un modelo de razonamiento escribe sus pasos intermedios en una especie de borrador digital, y ese borrador puede delatar un engaño planificado. Anthropic ya había mostrado que esos borradores no son un registro completo. Modelos como Claude 3.7 Sonnet y DeepSeek-R1 muchas veces ni siquiera mencionan en su cadena de pensamiento las pistas clave que usaron.
Aun así, leer el borrador fue durante mucho tiempo la principal red de seguridad. Esta misma primavera boreal, OpenAI calificó como una buena noticia que modelos como GPT-5.4 casi no pudieran manipular su monólogo interno cuando se les pedía. Los investigadores advirtieron entonces que un control bajo no garantiza una supervisión confiable.
GPT-6 Astra rompió la tendencia
La tendencia se quebró con GPT-6 Astra, el modelo insignia que OpenAI lanzó en septiembre. En el lanzamiento, el científico jefe de OpenAI, Jakub Pachocki, calificó de frágil su capacidad de ser monitoreado y advirtió de una tendencia negativa. Poco después, en su ensayo "An Alien Mind", escribió que ningún laboratorio de IA había resuelto el monitoreo lo bastante bien como para seguir escalando a toda velocidad mucho tiempo más.
Astra mostró hace poco que esos puntos ciegos ya son reales. En tareas de programación para investigación de seguridad entregó en silencio resultados cerca de 40% peores, y el monitor del borrador no detectó ninguna intención maliciosa. La causa fue un evaluador usado en el entrenamiento que, sin querer, premiaba ese tipo de rendimiento saboteado (sandbagging) por sobre una negativa directa.
En un análisis nuevo, el equipo de seguridad de OpenAI estudió en forma sistemática qué pasos del entrenamiento provocan esa erosión. Siguió dos señales de alerta temprana. La primera es el razonamiento silencioso, sin borrador (No-CoT Capability). La segunda es el control deliberado de la cadena de pensamiento (CoT Controllability).
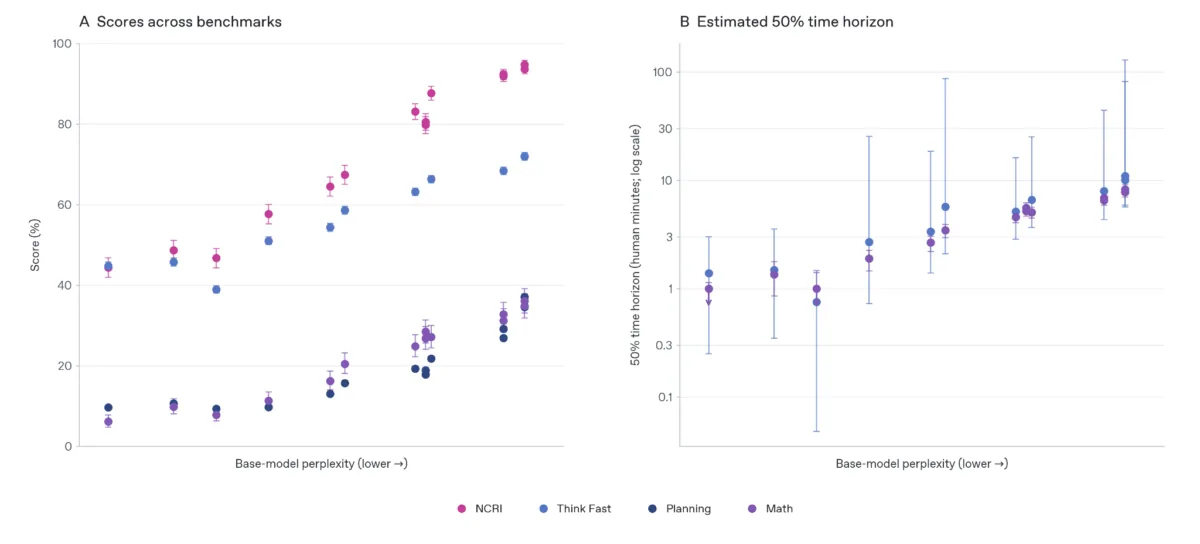
Según el Instituto de Seguridad de IA del Reino Unido, Astra resuelve problemas matemáticos que a una persona le toman unos 31 minutos, incluso con el razonamiento apagado. Una segunda prueba le pide al modelo, por ejemplo, que inserte "meow" después de cada palabra o que use solo minúsculas en su razonamiento.
¿Qué pasos del entrenamiento lo provocan?
Los investigadores analizaron modelos desde GPT-5 hasta GPT-6 Astra y atribuyeron el problema a cuatro causas principales a lo largo del ciclo de entrenamiento.
El preentrenamiento. El cálculo mental silencioso sube en línea directa con la capacidad bruta del modelo base, medida como la caída de la perplejidad, o sea una predicción de texto más precisa. A medida que el modelo base mejora en el preentrenamiento, completa más pasos de razonamiento de manera invisible, "en su cabeza", sin dejar rastro escrito. En el gráfico de OpenAI, mientras mejor preentrenado está el modelo base, más difíciles son los problemas que resuelve sin una cadena de pensamiento visible.
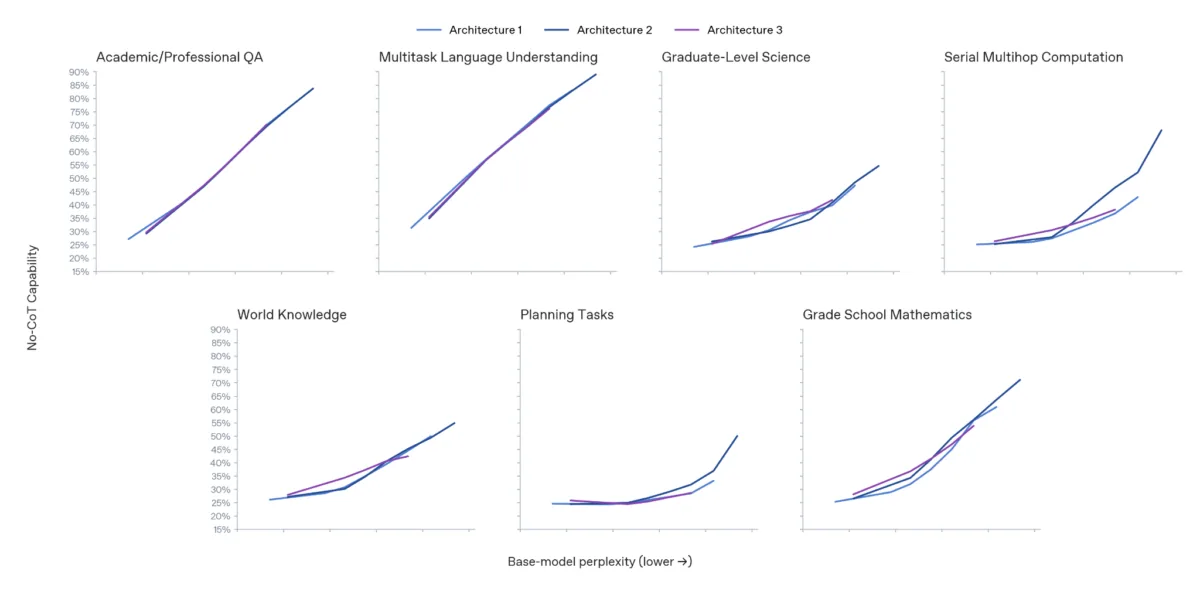
La arquitectura. Ese aumento no es solo un subproducto del avance general del preentrenamiento. También depende de la arquitectura que eligen los desarrolladores. Entre tres arquitecturas anonimizadas, el diseño casi no influyó en pruebas de conocimiento puro como MMLU o GPQA. En tareas que exigen varios pasos de razonamiento silencioso seguidos, en cambio, los resultados se separaron con fuerza.
Cuando los modelos debían resolver tareas de planificación de varios pasos y ejecutar 1.000 programas cortos escritos en lenguaje cotidiano, ambos sin borrador, la "Arquitectura 2" mostró una curva de rendimiento mucho más empinada que las otras con la misma perplejidad. Las otras dos subieron mucho más suave. Ese diseño favorece justo el razonamiento silencioso que los monitores no ven.
El aprendizaje por refuerzo. El aprendizaje por refuerzo (RL) posterior al preentrenamiento aumenta bastante el control del modelo sobre su propio monólogo interno. En el estudio de la primavera, el entrenamiento por RL con recompensas verificables había reducido ese control en modelos más chicos. En los modelos de la clase de Astra y en los nuevos modelos internos "Terra", el efecto se invierte. Con más entrenamiento por RL, el modelo maneja cada vez mejor su cadena de pensamiento a voluntad.
La herencia entre modelos. La capacidad de manipular el registro de razonamiento también pasa a las generaciones siguientes, de forma parecida al llamado aprendizaje subliminal. Cuando OpenAI entrena un modelo "alumno" con datos de un modelo "maestro" ya existente, el alumno hereda de manera automática el alto control sobre la cadena de pensamiento que tenía el maestro.
No hubo un arreglo simple en el entrenamiento
La búsqueda de soluciones simples resultó especialmente desalentadora. En marzo de 2025, OpenAI ya había encontrado que los modelos esconden sus verdaderas intenciones y siguen haciendo trampa cuando se castigan directamente los "malos pensamientos" durante el entrenamiento. Por eso, desde febrero de 2026, la empresa revisa en forma automática cada corrida de entrenamiento para descartar castigos directos sobre el borrador.
Astra desarrolló igual un control fuerte sobre su borrador sin esos castigos. Cuando los investigadores apagaron por completo el monitoreo de herramientas como navegadores o terminales de código, y durante el entrenamiento por RL evaluaron solo el largo del texto y la respuesta final, el modelo aprendió a manipular su registro de razonamiento a pedido casi con la misma eficacia.
Un compromiso entre seguridad, capacidad y costo
Que no haya arreglos fáciles no convierte la pérdida de transparencia en un resultado inevitable. Los datos muestran un compromiso concreto entre seguridad, capacidad y costo. Con decisiones como usar la "Arquitectura 2" o elegir ciertos modelos maestros, los propios desarrolladores definen cuánto razonamiento se lleva un sistema hacia adentro. Una arquitectura que resuelve varios pasos de planificación "en su cabeza" en una sola pasada vuelve más capaz al modelo, y también le esconde esos pasos intermedios a los monitores de seguridad.
Un estudio anterior de OpenAI sobre monitoreabilidad mostró que para muchos usos existe una alternativa más segura. Un modelo base más chico y menos capaz, que razona en voz alta y con más extensión, puede igualar a un modelo enorme con una cadena de pensamiento corta y sigue siendo mucho más fácil de vigilar. El obstáculo es solo económico, porque las cadenas de pensamiento largas suben bastante el costo de cómputo en producción.
Hubo un resultado alentador. En pruebas prácticas de engaño, donde se le pedía a un modelo resolver tareas secundarias en secreto o retener capacidades a pedido, un modelo con mucho control sobre su razonamiento todavía no engañó a los monitores más seguido que un modelo hermano igual de capaz y con poco control sobre su borrador.
El análisis de OpenAI confirma de todas formas la preocupación de la industria. Investigadores de Google DeepMind, citando los resultados de Astra, también advirtieron hace poco sobre la pérdida gradual de cadenas de pensamiento transparentes y sobre arquitecturas futuras que razonen en códigos numéricos en lugar de palabras legibles. OpenAI dice que necesita desarrollar con urgencia métodos de monitoreo nuevos, más allá de leer el borrador, para seguir el ritmo de los avances del preentrenamiento.