Con un puntaje de 97,5% en ARC-AGI-3, Gemini 4 Argon dejó a Google DeepMind como el segundo laboratorio de IA que supera el 95% en ese benchmark. El primero fue OpenAI. Los datos los publicaron ARC Prize y el instituto de investigación Epoch AI, y los recogió The Decoder el 16 de octubre de 2026.
ARC-AGI-3 es considerada una de las pruebas más difíciles de resolución general de problemas. Solo GPT-6 Astra tiene un puntaje mayor, con 99,9%.
¿Cómo se midió el 97,5%?
El resultado se obtuvo con el Provider Adapter Harness, un entorno de prueba que permite usar funciones propias de cada proveedor, como el razonamiento retenido entre turnos y la compactación del contexto. Esa corrida costó 4.800 dólares.
En los 25 juegos públicos de ARC-AGI-3, Argon necesitó 62% menos acciones que la línea base humana, la misma cifra que logró GPT-6 Astra. Según el gráfico de ARC Prize, los dos modelos quedaron a menudo cerca del récord de speedrun. Argon igualó o superó ese récord en tres juegos y quedó a menos de 10% del mejor tiempo en otros seis.
En las versiones anteriores del benchmark, el modelo marcó estos resultados con el precio de lanzamiento de 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida.
| Benchmark | Puntaje de Argon | Costo por tarea |
|---|---|---|
| ARC-AGI-1 | 98,5% | 0,16 dólares |
| ARC-AGI-2 | 91,3% | 0,32 dólares |
| ARC-AGI-3 (Provider Adapter Harness) | 97,5% | 4.800 dólares en total |
¿Por qué el puntaje cae a la mitad en el entorno estándar?
El Standard Harness solo permite notas simples entre una ronda y la siguiente. Ahí Argon baja a 49,8% con razonamiento bajo, a un costo de 5.800 dólares.
La diferencia entre los dos entornos viene de una disputa de julio de 2026. GPT-5.6 Sol, de OpenAI, le ganó a Claude Opus 5 en ARC-AGI-3 usando dos ajustes de la API. En el entorno estándar, que descarta el razonamiento interno después de cada acción, GPT-5.6 Sol había sacado apenas 7,8%. Ese entorno además usaba una interfaz antigua que no tenía las funciones más nuevas de la API de Claude, así que Claude se probó en condiciones distintas a las de GPT-5.6.
Cuando GPT-5.6 Sol se evaluó con la propia Responses API de OpenAI, con Retained Reasoning y la compactación inteligente del contexto, subió a 38,3% y superó a Opus 5, que tenía 30,2%. OpenAI argumentó que un benchmark siempre mide también el entorno técnico. Francois Chollet, cofundador de ARC Prize, terminó por aceptar los ajustes de API que fueran generales y estuvieran disponibles al público.
Problemas con la API impidieron además que Argon terminara los 55 juegos del entorno estándar, según los evaluadores.
- Con razonamiento bajo completó 42 juegos (49,8%).
- Con razonamiento medio completó 46 juegos (46,3%).
- Con el nivel más alto solo terminó 19 juegos, y ARC Prize no publicó puntaje.
Los resultados informados cubren igual los 55 juegos, porque suman puntos parciales de las corridas que se interrumpieron.
Dónde queda Argon frente a la competencia
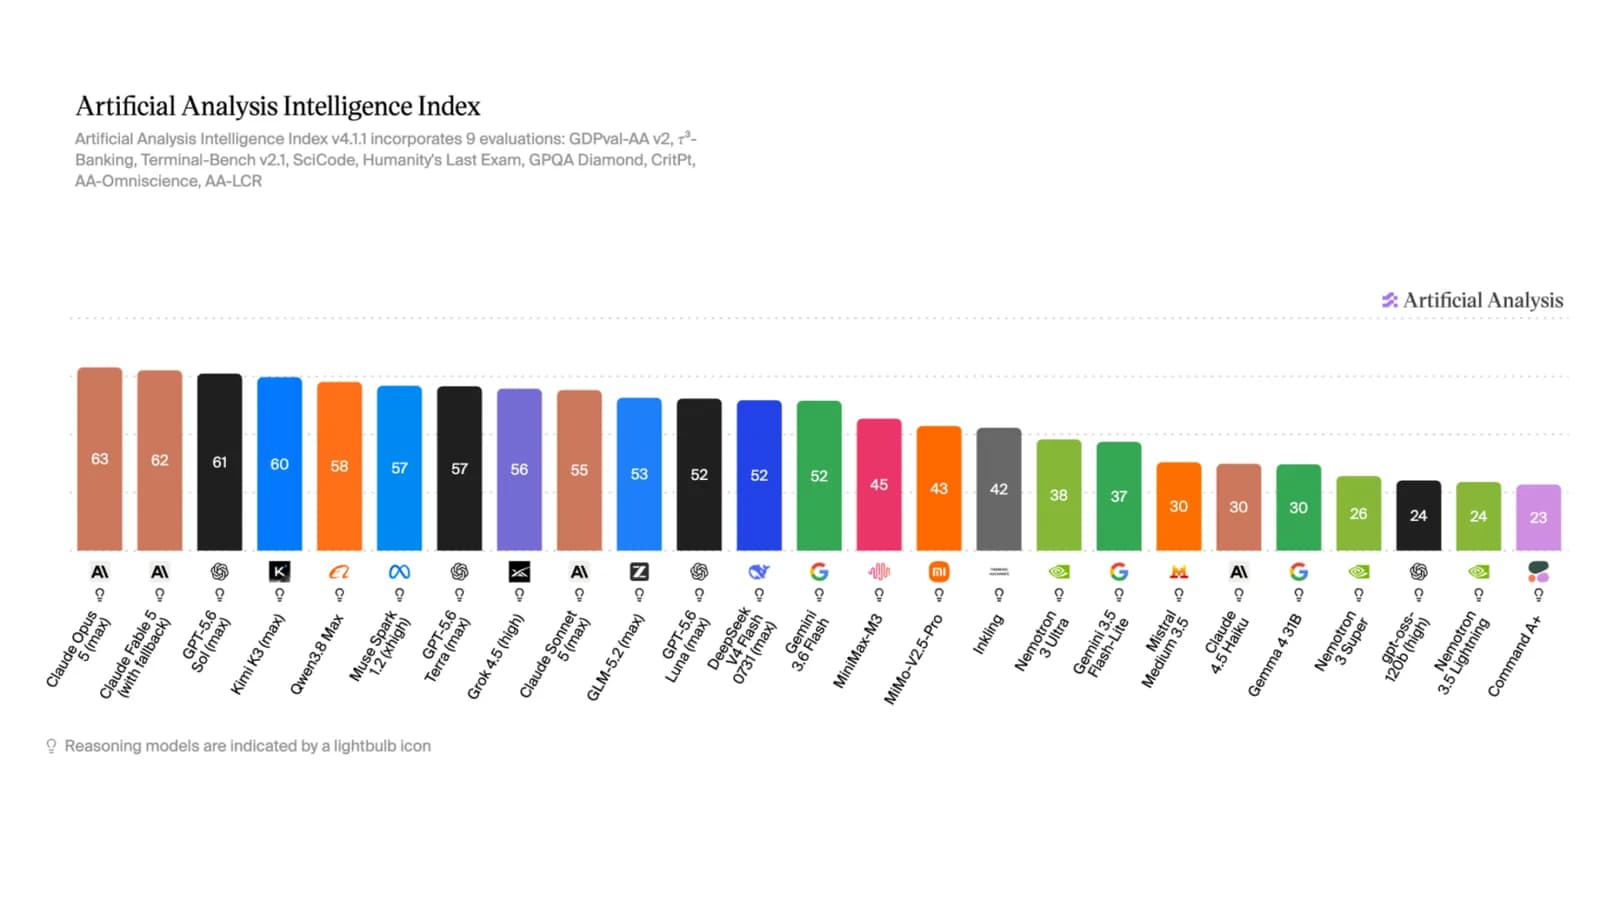
Epoch AI también siguió el avance de Google. Argon sacó 165 puntos en el Epoch Capabilities Index (ECI), empatado con Fable 5.1 y apenas detrás de Opus 5.5 (167) y GPT-6 Astra (166). El ECI junta más de 50 benchmarks en una sola escala de capacidad, de forma parecida a como Artificial Analysis arma su puntaje principal.
| Modelo | Puntaje ECI |
|---|---|
| Opus 5.5 | 167 |
| GPT-6 Astra | 166 |
| Gemini 4 Argon | 165 |
| Fable 5.1 | 165 |
| Gemini 3.8 Flash | 157 |
Argon queda muy por encima de Gemini 3.8 Flash y deja a Google más cerca de la punta que en cualquier momento desde Gemini 3.1 Pro, en febrero de 2026. Artificial Analysis y Vals.ai ya habían mostrado esa misma tendencia.
¿En qué áreas se queda atrás?
El rendimiento cambia según el dominio. De acuerdo con Epoch AI, Argon lidera varios benchmarks de conocimiento, de agentes y de visión. Las primeras estimaciones lo ubican en el octavo lugar del índice de matemáticas (Math ECI) y en el sexto del índice de ingeniería de software (SWE ECI).