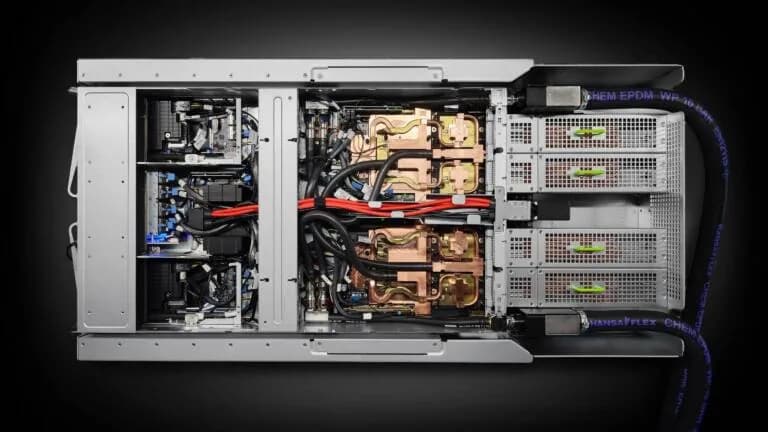
Cómo el equipo de NVIDIA enseñó a robots a montar bandejas de prueba del GB300, y lo que eso le enseñó sobre aprendizaje robótico, inteligencia mecánica y la ingeniería de siempre.
El superchip NVIDIA Grace Blackwell GB300 es el motor de entrenamiento e inferencia de los modelos fundacionales actuales. Pero montar las bandejas del GB300 exige trabajo manual calificado en fábricas de todo el mundo. El NVIDIA Seattle Robotics Lab (SRL), junto con el equipo de ingeniería de NVIDIA Isaac, se planteó una pregunta central. ¿Se pueden construir robots inteligentes que armen sistemas tan complejos?
La respuesta es sí, según el blog de desarrolladores de NVIDIA, pero el camino fue difícil. Lograr que los robots armen bandejas GB300 es uno de los problemas más duros que ha enfrentado el SRL en nueve años como laboratorio de investigación muy prolífico. El problema también puso en duda las ideas del equipo sobre dónde rinde más el aprendizaje de extremo a extremo y dónde conviene más una arquitectura modular.
El problema y el regreso de Moravec
El equipo se concentró en montar las bandejas de prueba del GB300, que sirven para verificar el funcionamiento y el rendimiento de los módulos de cómputo GB300 antes de su despacho e instalación. Por recomendación del equipo de Operaciones de NVIDIA y de Foxconn, fabricante por contrato del GB300, se enfocaron en dos tareas.
- Montaje de la barra colectora. Una barra metálica larga y pesada que transmite alta corriente (busbar) debe tomarse, llevarse a la bandeja, insertarse y atornillarse en 16 puntos. También hay que poner y sacar fijaciones y abrazaderas.
- Inserción de varios conectores. Dos conectores eléctricos grandes y dos chicos, montados en cables, deben levantarse de la bandeja e insertarse en zócalos de holgura mínima.
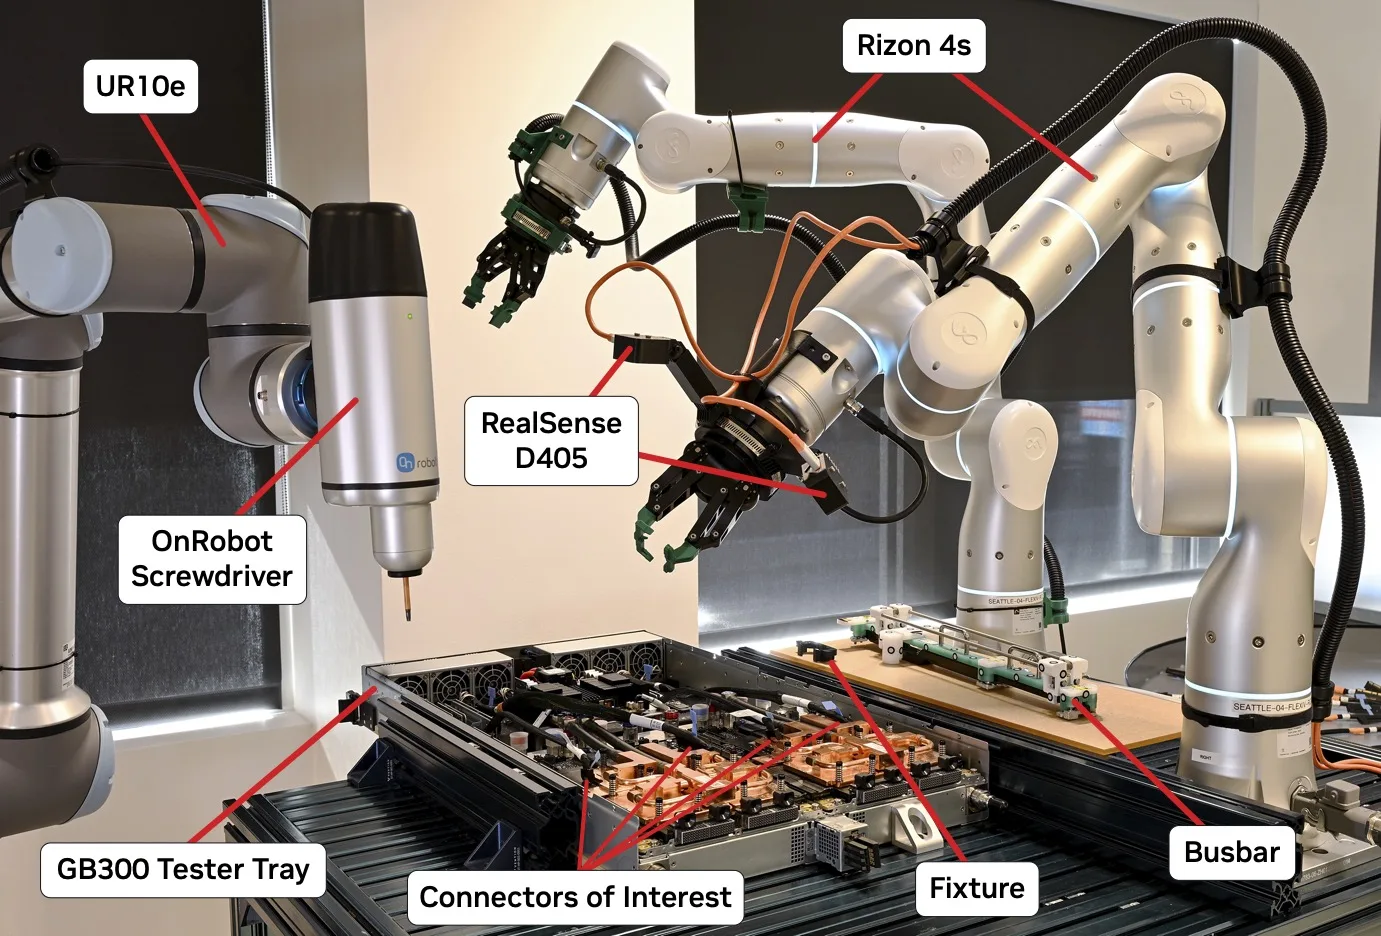
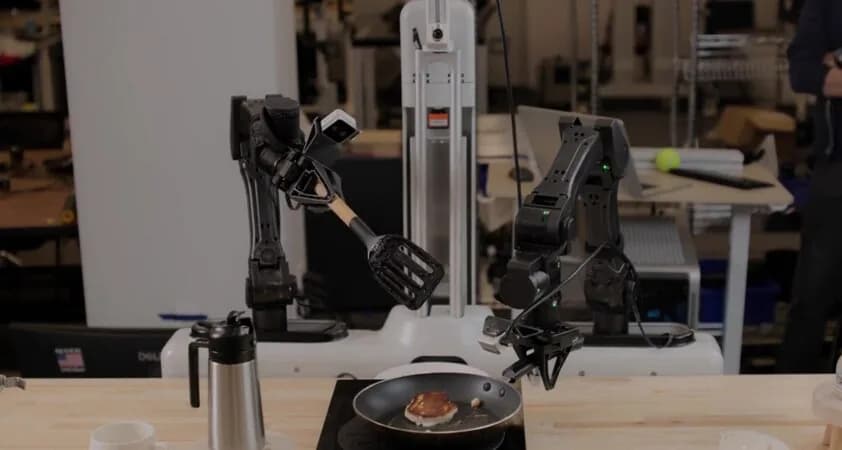
Vista frontal del montaje experimental. Los robots son dos brazos Flexiv Rizon 4S y un brazo UR10e con un atornillador OnRobot.
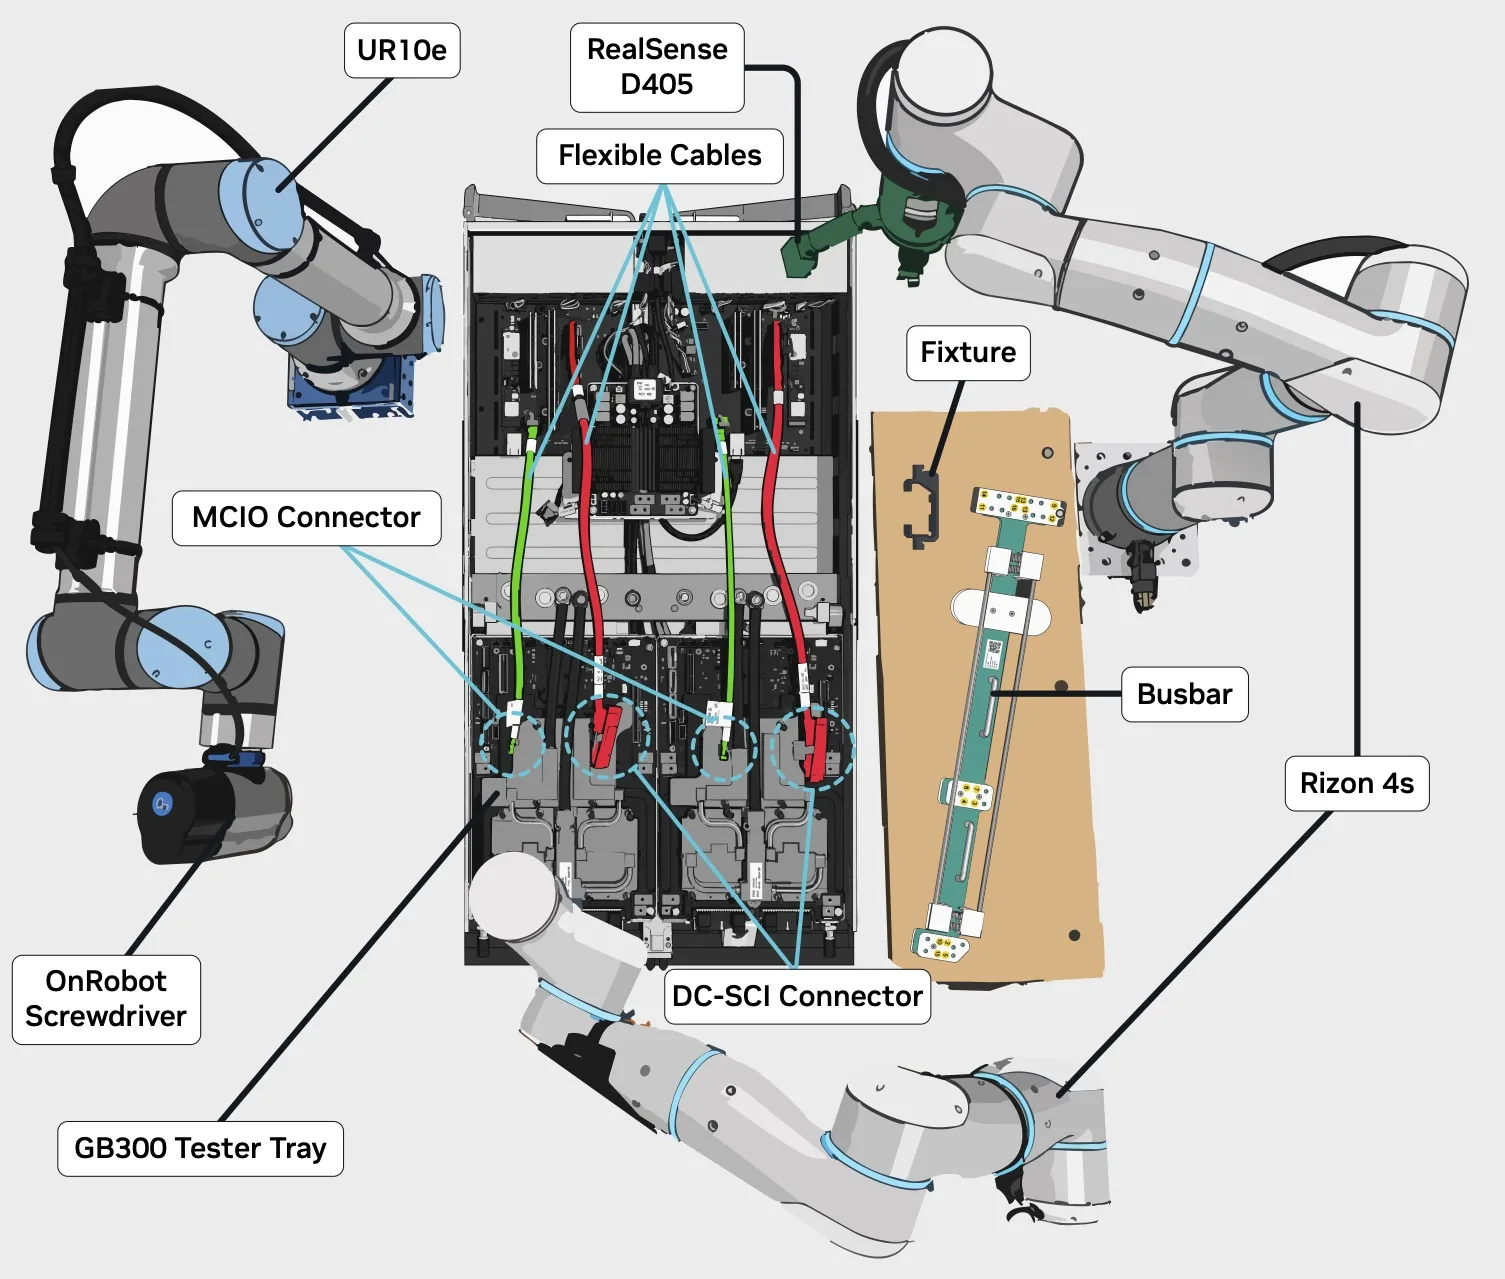
Vista superior del montaje experimental.
Los operarios calificados hacen estas dos tareas de forma confiable y fluida, sin mayor carga mental. Sin embargo, en otro ejemplo de la paradoja de Moravec, la destreza que piden estas tareas puede ser muy difícil de automatizar.
El primer desafío es la incertidumbre. La geometría, la apariencia y la dinámica de las piezas no se conocen con precisión, y la posición inicial de cada pieza puede variar bastante. Además, los conectores eléctricos van unidos a cables que se deforman en todo su largo, tienen bastante variación de fabricación y hasta cambian mecánicamente por deformación plástica y fatiga.
En muchas operaciones de manufactura la incertidumbre se reduce con automatización fija, donde el entorno está controlado al detalle. Las fijaciones y adaptadores se diseñan para sujetar las piezas con precisión submilimétrica, y los robots funcionan como máquinas de movimiento repetitivo. En el montaje de las bandejas de prueba del GB300 la incertidumbre se tiene que resolver con automatización flexible, porque los ciclos de diseño rápidos y los bajos volúmenes hacen inviable la automatización fija. Los robots tienen que adaptarse y tolerar la incertidumbre. Con la demanda creciente de infraestructura de IA, NVIDIA considera este paradigma una prioridad estratégica.
El segundo desafío es el rendimiento. En investigación robótica, una tasa de éxito de 50% a 60% suele bastar, y con 80% a 90% una tarea muchas veces se da por resuelta. El tiempo de ciclo, la suavidad del movimiento y el manejo cuidadoso suelen quedar en segundo plano. Además, el rigor estadístico suele ser insuficiente. Se hacen de 10 a 20 ensayos por tarea, cuando un intervalo de confianza razonable puede requerir muchas más evaluaciones.
Los requisitos de rendimiento se fijaron directamente con el equipo de Operaciones de NVIDIA y con Foxconn, para que resuelto signifique de verdad resuelto. A la fecha de publicación de la entrada, el equipo afirma que se acerca rápido a esos umbrales.
La herramienta correcta en el momento correcto
En investigación robótica se premia la novedad técnica. Esa tradición impulsa la invención, pero da pocos incentivos para optimizar soluciones de referencia que podrían rendir más. Por eso es fácil terminar de leer un paper sin entender por qué fallaron los enfoques anteriores.
La estrategia del equipo para el montaje de las bandejas fue usar la herramienta correcta en el momento correcto. Para cada subproblema consideraron, y casi siempre implementaron, primero una solución clásica. Cuando no alcanzaba, exploraron aprendizaje por imitación, aprendizaje por refuerzo (RL) en simulación con transferencia al mundo real, RL en el mundo real y modelos de visión, lenguaje y acción (VLA). Esa progresión les permitió identificar las fortalezas y debilidades de cada enfoque y justificar cuándo valía la pena innovar y sumar complejidad.
NVIDIA presenta el montaje de la barra colectora y la inserción de conectores como casos de estudio para otros grupos de investigación e ingeniería que enfrentan sus propios problemas de manipulación.
¿Cómo se monta la barra colectora?
El montaje de la barra colectora tiene estos pasos.
- Tomar una fijación de límite (una fijación específica que ayuda en el montaje) e insertarla en la bandeja.
- Tomar la barra colectora, con su abrazadera puesta, e insertarla en la bandeja.
- Poner 16 tornillos para fijar la barra a la bandeja.
- Soltar y sacar la abrazadera de la barra.
- Sacar la fijación de límite.
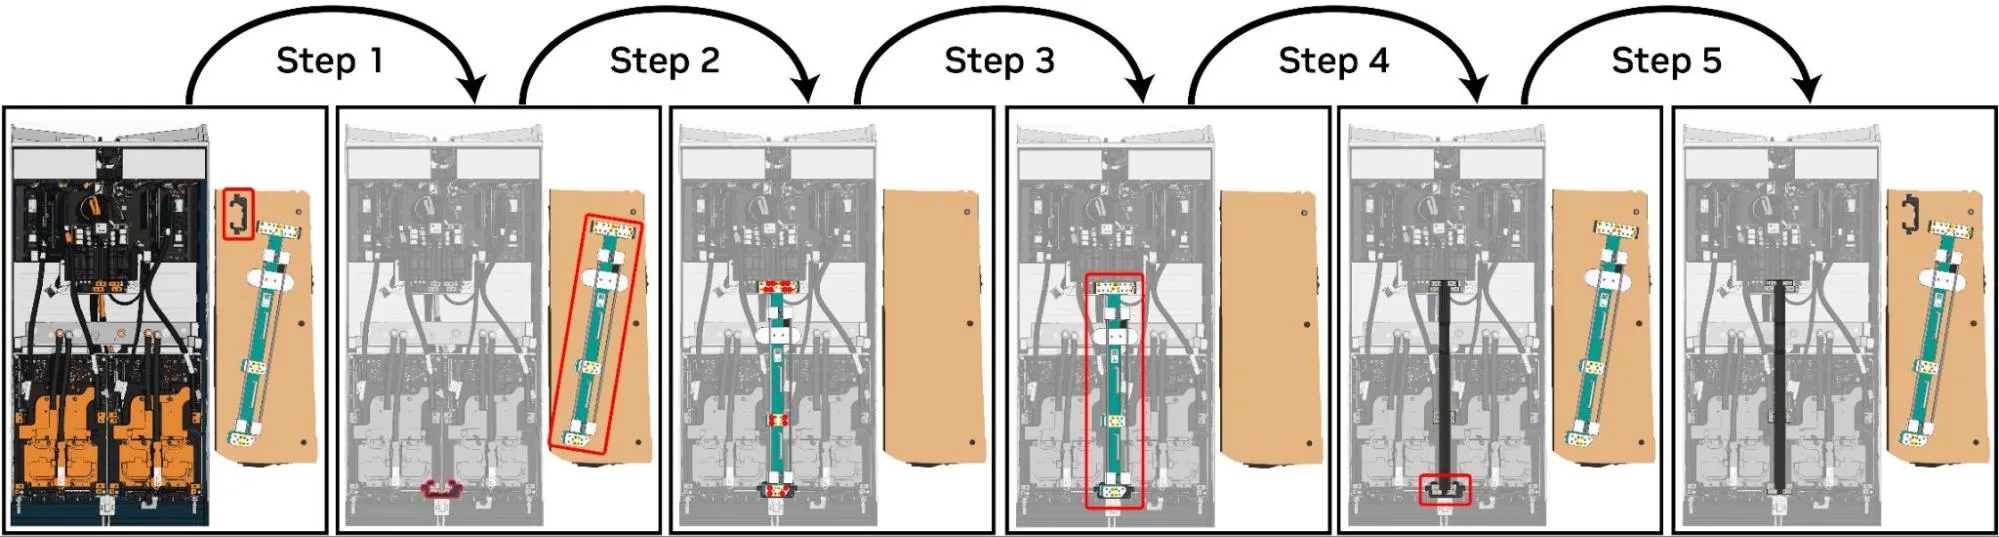
Los cinco subpasos del montaje de la barra colectora. Las piezas principales de cada paso están marcadas en rojo.
Las condiciones iniciales replicaban las de una fábrica. La fijación de límite y la barra (con la abrazadera puesta) partían en posiciones libres sobre una superficie plana junto al robot, y los tornillos venían apoyados dentro de la barra.
Los fabricantes pidieron una tasa de éxito de 99,5% y terminar la tarea en no más del doble del tiempo de un operario calificado, o sea en un máximo de 124 segundos. No se permitía ningún choque involuntario con la bandeja, porque hasta un daño menor puede ser motivo para descartar el sistema completo.
El equipo partió con un sistema clásico, la "ingeniería de siempre", con módulos separados de percepción, planificación y control, y esperaba pasar después al aprendizaje de extremo a extremo. El sistema clásico resultó muy efectivo y ese cambio nunca hizo falta. La estructura modular además hizo que el sistema fuera fácil de depurar, de ajustar y de repartir entre varios brazos.
Para la percepción usaron primero NVIDIA FoundationPose, un modelo generalista que estima la pose 6D de un objeto a partir de su malla, una imagen RGB y una imagen de profundidad. Cuando el objeto no se veía lo suficiente, la estimación podía equivocarse en 90 o 180 grados. Por eso ampliaron el sistema para recibir varias vistas, calcular una estimación por vista y quedarse con la de mayor puntaje de confianza, lo que redujo los errores. Más adelante pasaron a un modelo especialista llamado DOPER.
Para la planificación usaron un planificador rápido por puntos de paso en el espacio libre, que bajó los tiempos de ciclo, y primitivas de manipulación basadas en curvas de Lissajous y otras trayectorias simples para alinear piezas que parten desalineadas.
Para el control implementaron un controlador de impedancia de alto rendimiento, que asegura un contacto suave y estable mientras aplica la fuerza necesaria en la inserción. Los sistemas de aprendizaje actuales suelen usar el controlador más simple posible. Este usa diseño automático del amortiguamiento y compensación inercial. El equipo de NVIDIA considera el control de alto rendimiento una herramienta poderosa y poco aprovechada en el aprendizaje robótico.
Para bajar el tiempo de ciclo, el trabajo se repartió entre tres brazos.
- Un Flexiv Rizon 4S posiciona una cámara para estimar la pose.
- Un segundo Flexiv Rizon 4S inserta la fijación de límite y la barra, y después saca la abrazadera y la fijación.
- Un Universal Robots UR10e usa un atornillador OnRobot para las 16 operaciones de atornillado.
De acuerdo con el fabricante, la abrazadera de la barra se modificó levemente para que un solo brazo pudiera soltarla.
La solución superó 95% de éxito, y el equipo sigue trabajando para subir esa cifra. Las fallas que quedan vienen sobre todo de errores al tomar la pieza y de que se resbala en la pinza durante la inserción. Las subtareas de la fijación y de la barra cumplieron su tiempo de ciclo, pero el atornillado no, así que el ciclo completo tomó 160 segundos contra la meta de 124. El principal cuello de botella son las operaciones de atornillado secuenciales y propias de cada dispositivo, lo que deja un camino claro para optimizar.
La infraestructura que lo hizo posible
En problemas difíciles como este, una infraestructura robótica bien diseñada le permitió al equipo desarrollar, desplegar e inspeccionar sus sistemas con rapidez.
La primera pieza son los servicios robóticos. Como sabe cualquier especialista en robótica, experimentar con varias bibliotecas suele terminar en un infierno de dependencias. El equipo convierte cada biblioteca en un servicio web que se despliega por separado, en el borde, en servidores propios o en la nube. Los servicios van empaquetados en contenedores Docker con endpoints FastAPI/HTTP, y los investigadores usan un cliente liviano en Python para combinar servicios escritos en distintos lenguajes y frameworks. Entre otros, usan un servicio de cuRobo para planificar movimientos, uno de FoundationPose para estimar poses y uno de FoundationStereo para estimar profundidad.
La segunda pieza es TALOS (Task and Agent Lifecycle Orchestration System). TALOS usa ros2_control como base y ofrece planificadores de movimiento, primitivas de manipulación y controladores de alto rendimiento (de impedancia, de admitancia y de fuerza). La biblioteca encadena estos componentes con políticas aprendidas y ejecuta controladores en lazos de tiempo real a más de 500 Hz. TALOS es compatible con los brazos Franka FR3, Flexiv Rizon 4S, Universal Robots UR10e y SO-101. El equipo la usa en todas sus aplicaciones robóticas reales, incluida la enseñanza kinestésica, la teleoperación, la coordinación de dos brazos y la planificación de movimientos.
TALOS también se expone a través de interfaces web estándar. Así, los agentes de programación pueden acceder a los servicios robóticos y a los robots físicos, y combinar capacidades de percepción, planificación y control tanto en el desarrollo como en el despliegue. NVIDIA dice que su enfoque coincide con el Model Hardware Standard (MHS) de Anthropic, una especificación independiente del modelo para que los agentes de IA puedan descubrir y operar dispositivos físicos de forma segura. Su proyecto de código abierto DROID+ es un ejemplo de ese enfoque.