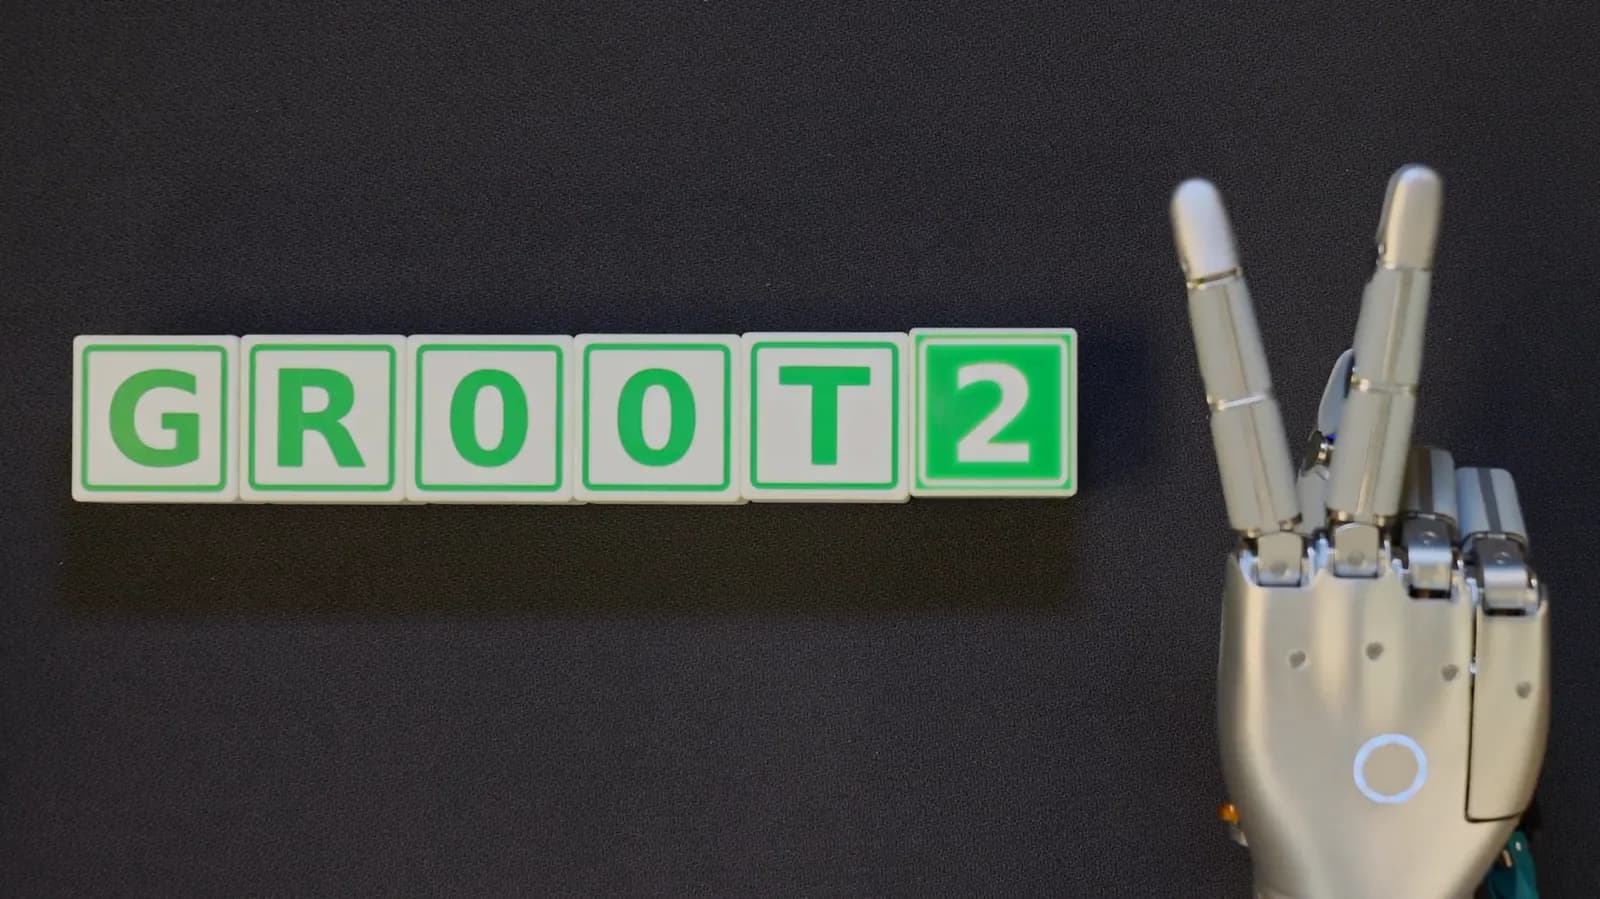
Para enseñarle una tarea nueva a un robot, los ingenieros suelen pasar horas controlándolo a distancia. Esa teleoperación es cara y lenta, y exige datos propios para cada modelo de robot. Nvidia busca acortarla con GR00T 2, un modelo base de IA que describió en un informe de investigación publicado el 10 de noviembre, según The Decoder.
A diferencia de los enfoques anteriores, incluido su antecesor GR00T 1, GR00T 2 no traduce directo las imágenes de cámara y las órdenes en lenguaje natural a movimientos de motor. Nvidia lo llama un modelo de mundo y acción (WAM, por su sigla en inglés). Calcula al mismo tiempo el siguiente movimiento y un video corto del futuro inmediato. Por ejemplo, predice cómo debería cambiar la imagen de la cámara cuando un brazo robótico toma un objeto.
O sea, GR00T 2 ya no es un modelo de visión, lenguaje y acción. Usa difusión para predecir lo que verá a continuación.
¿Cómo aprende de videos de personas?
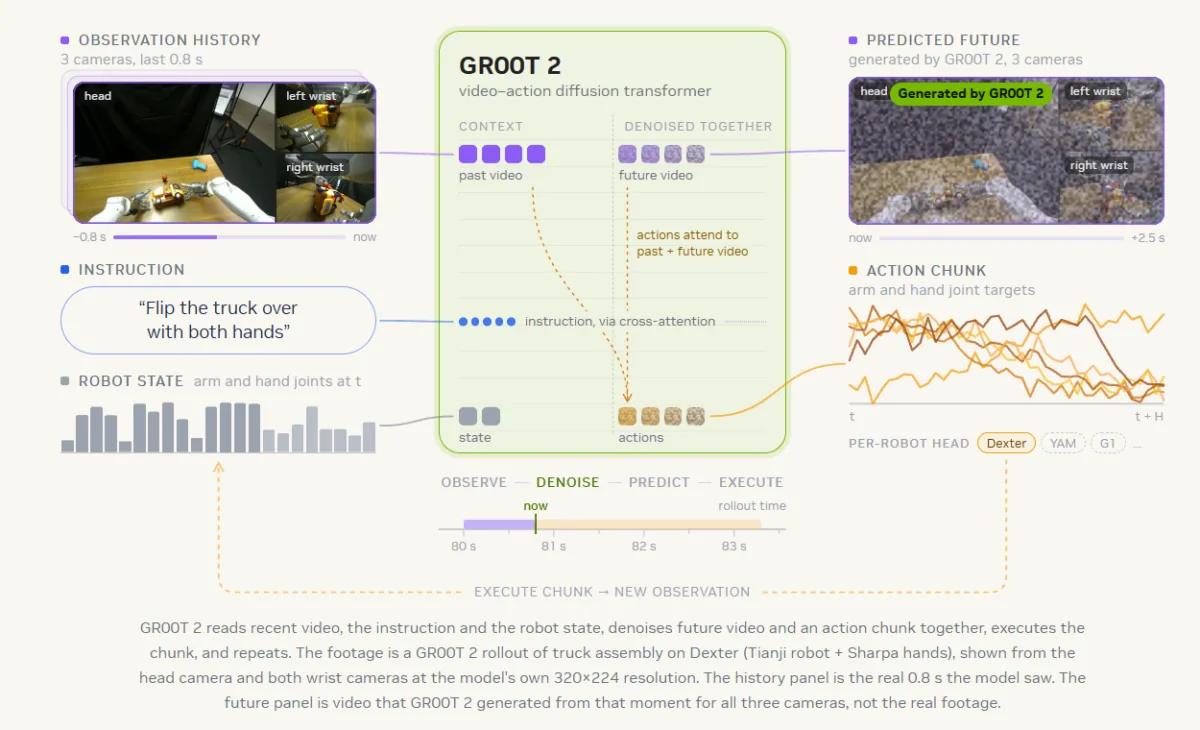
Esa predicción de video debería permitir que el modelo traspase secuencias de movimiento entre robots con distinta forma. Nvidia entrenó el sistema en un clúster de más de mil chips GB300, con unas 400.000 horas de video de personas haciendo tareas variadas con cámaras montadas en la cabeza.
Para enseñarle al robot una tarea nueva, según los investigadores, basta con que una persona muestre los pasos con guantes de datos, pinzas manuales especiales o un exoesqueleto de dedos. Cuando esas grabaciones se combinan en el entrenamiento con datos generales de movimiento del robot de destino, la IA genera en su predicción de video el brazo robótico en lugar del brazo humano, y de ahí deriva los comandos de control.
En pruebas de laboratorio, un robot con manos de cinco dedos logró encender un fósforo, cortar un plátano o lanzar paquetes a una cinta transportadora, sin haber sido teleoperado para esas tareas. Las tasas de éxito fueron de 10% a 80% según la tarea. A partir de un solo video de una mano humana, el sistema aprendió además a clavar clavos, pasando por una simulación computacional. En 50 tareas elegidas, donde el modelo ya rendía bien con pocos ejemplos, menos de tres minutos de entrenamiento convencional bastaron para subir el éxito de 40% a 95%.
Un modelo de lenguaje corrige errores, pero frena al robot
Para trabajos de montaje más largos, Nvidia combina el sistema con un modelo de lenguaje de nivel superior, como GPT-6 Astra de OpenAI. GR00T 2 se encarga de los movimientos de agarre, y el modelo de lenguaje divide la tarea en pasos, marca con colores los puntos de agarre en la imagen de la cámara y lanza rutinas de ayuda cuando se cae una pieza.
Cuando los investigadores dejaron sobre una mesa, sin orden, las piezas sueltas de modelos de juguete, el sistema combinado los armó en al menos 97% de los intentos. Sin el modelo de lenguaje que corrige y sin ajuste fino adicional, el montaje del auto de juguete salió bien en solo 23 de 100 intentos. El equipo también entrenó tareas de precisión, como enchufar cables de red o cargadores, con ensayo y error repetido en el equipo real.
GR00T 2 Turbo para humanoides
Para robots bípedos, Nvidia desarrolló GR00T 2 Turbo, una versión reducida que procesa menos detalle de imagen. Corre directo en el computador Jetson Thor que lleva a bordo el humanoide. En las pruebas, la máquina sirvió cabritas con una pala, despejó mesas y limpió líquidos con una toalla bajo el pie. Esta última tarea salió bien en poco menos de la mitad de los intentos.
Lo que falta para usarlo fuera del laboratorio
El equipo de investigación reconoce obstáculos grandes antes de un uso confiable en el mundo real. El modelo todavía no procesa datos de sensores táctiles y a veces no detecta errores sutiles, como tornillos atornillados a medias. El modelo de lenguaje de nivel superior también frena bastante el trabajo. Al separar basura, el robot quedó detenido cerca de un tercio del tiempo total, porque esperaba en promedio más de siete segundos el siguiente cálculo del modelo de planificación.
Otros laboratorios también buscan formas de enseñar tareas a los robots con menos teleoperación.