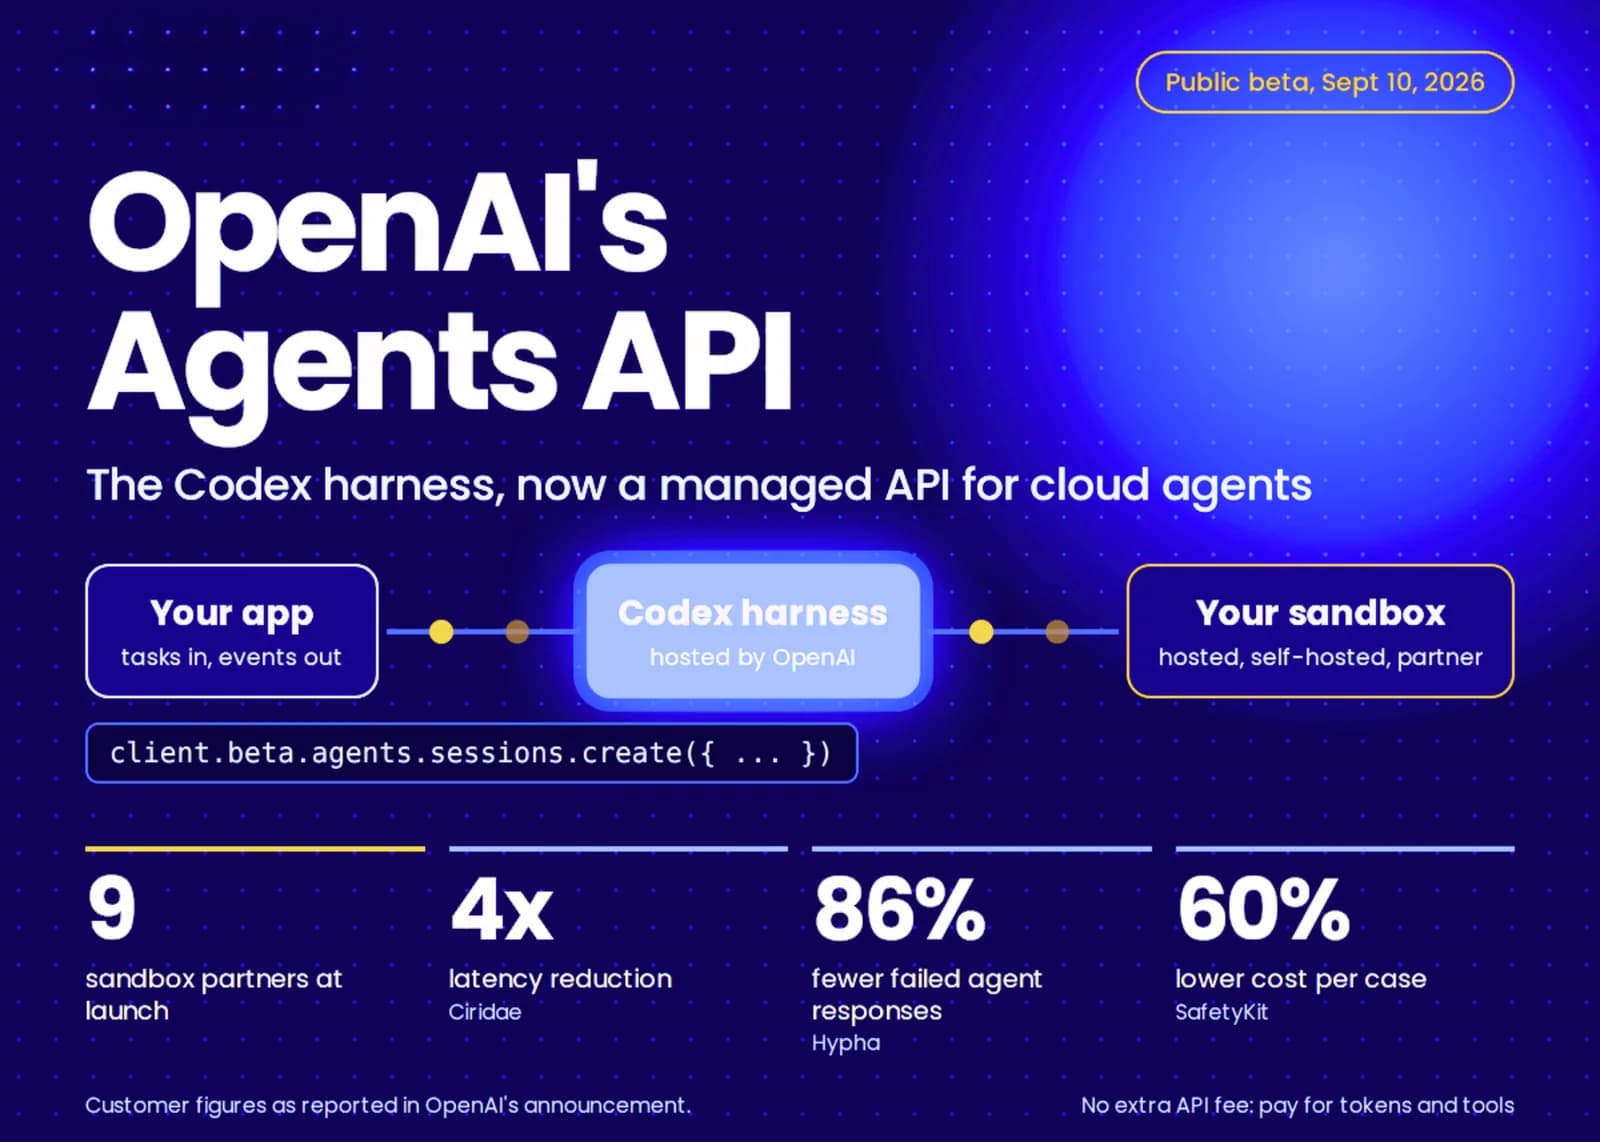
OpenAI liberó su Agents API en beta pública. El servicio le entrega a cualquier desarrollador el mismo motor de ejecución y la misma infraestructura con la que corre Codex. OpenAI aloja y mantiene ese motor, mientras el cómputo del agente puede ejecutarse en un entorno aislado gestionado por la empresa, en infraestructura propia del cliente o en un entorno de un socio.
¿Ya se puede usar en producción?
Sí, está disponible para todos los desarrolladores en beta pública. Hay dos restricciones relevantes: los datos permanecen únicamente en Estados Unidos y la modalidad de retención cero de datos (Zero Data Retention) no está soportada, lo que limita por ahora las cargas de trabajo reguladas.
Qué liberó OpenAI exactamente
La Agents API es un servicio gestionado construido sobre el motor de Codex, que es de código abierto. Según el equipo de OpenAI, escalar Codex y ChatGPT for Work dejó en evidencia qué necesitan los agentes de larga duración: un motor que administre el contexto, use las herramientas de manera eficiente y coordine subagentes, además de infraestructura capaz de mantenerlos operando de forma confiable durante días.
La documentación oficial organiza la API en torno a cuatro conceptos:
- Agente: el modelo, las instrucciones, las herramientas y los servidores MCP disponibles para él.
- Entorno: un espacio aislado opcional donde el agente accede a archivos, carga habilidades y ejecuta comandos.
- Sesión: una instancia durable del agente, que trabaja sobre tareas y responde a nuevas entradas.
- Eventos e ítems: las entradas que se le envían al agente y la salida que produce.
Una sesión corre en cuatro pasos. Se crea y se le asigna una tarea, luego se sigue su progreso mediante streaming o webhooks, y finalmente se continúa con una tarea nueva o se redirige el turno en curso.
Una sola llamada a la API
El anuncio de OpenAI muestra un agente de investigación de incidentes creado en una única llamada:
import OpenAI from "openai";

const client = new OpenAI();

const session = await client.beta.agents.sessions.create({
  agent: {
    model: "gpt-6-astra",
    tools: [
      {
        type: "mcp",
        server_label: "observability",
        transport: {
          type: "http",
          server_url: "https://observability.example.com/mcp",
        },
      },
    ],
    multi_agent: { enabled: true, max_concurrent_subagents: 3 },
  },
  vault_ids: ["vault_YOUR_VAULT_ID"],
  environment: {
    type: "openai_hosted",
    capability_directories: ["/workspace/capabilities/skills"],
  },
  input:
    "Investigate service-api's elevated 5xx rate over the last 30 minutes. " +
    "Delegate deployment, error, and dependency analysis to subagents. " +
    "Save findings, evidence, and recommended mitigation in /workspace/outputs.",
});
La guía de inicio rápido cubre los permisos de la clave de API y la instalación del SDK.
¿Dónde se ejecuta el agente?
La elección del entorno es la principal decisión de arquitectura. La Agents API admite tres opciones de espacio aislado, y también puede correr sin ninguno.
- Entorno alojado por OpenAI: usa la misma infraestructura de aislamiento que hay detrás de Codex y ChatGPT. Se puede configurar con archivos, paquetes, habilidades y complementos.
- Autoalojado: se ejecuta
codex exec-serverdentro del entorno propio. Se registra con una clave restringida y se conecta por WebSocket. Todas las conexiones son salientes. - Entornos de socios: Blaxel, Cloudflare, Daytona, DigitalOcean, E2B, Modal, Oracle, Runloop y Vercel cuentan con integraciones de primer nivel.
Esa última lista, de nueve proveedores, es una señal de posicionamiento: OpenAI no está tratando de quedarse con la capa de ejecución, sino con la de orquestación.
Qué resuelve el motor por el desarrollador
OpenAI mantiene el motor en paralelo a sus modelos, con acceso versionado en cada lanzamiento.
- Sesiones largas: la API compacta automáticamente el contexto anterior cuando una sesión se acerca a su límite. El desarrollador no escribe su propia lógica de compactación.
- Uso eficiente de herramientas: la búsqueda de herramientas carga las definiciones solo cuando se necesitan, lo que reduce consumo de tokens y costo sin invalidar la caché del modelo. La invocación programática permite que el agente ejecute llamadas en paralelo y encadene operaciones, filtrando o combinando resultados en código para que solo lo relevante vuelva al contexto. Se admiten MCP, funciones personalizadas y herramientas integradas como la búsqueda web.
- Subagentes: con el soporte multiagente, el agente principal divide tareas complejas en piezas independientes. Cada subagente conserva su propio contexto y el principal los coordina y combina los resultados.
Resultados tempranos de clientes
OpenAI publicó las siguientes cifras reportadas por sus clientes. Son datos entregados por el proveedor, no pruebas independientes.
| Cliente | Resultado reportado |
|---|---|
| Ciridae | Puntaje de evaluación de 0,71 a 0,85 y latencia 4 veces menor en flujos con subagentes |
| SafetyKit | 60% menos de costo por caso tras migrar su flujo de revisión |
| Hypha | 86% menos de respuestas fallidas al separar el motor del entorno aislado |
| Nash.ai | Miles de agentes de larga duración sobre redes logísticas globales |
Qué implica para un equipo en Chile
El costo sigue siendo por tokens, herramientas y tiempo de contenedor, sin cargo adicional por el servicio. La restricción práctica para acá es la residencia de datos únicamente en Estados Unidos, que choca de frente con cualquier proyecto sujeto a la Ley 21.719 de protección de datos personales, vigente desde diciembre de 2026 en Chile. Para un equipo que procesa datos de clientes, la opción autoalojada, donde el cómputo del agente corre en infraestructura propia y solo el motor queda del lado de OpenAI, es la única de las tres que permite acotar dónde terminan los archivos de trabajo. La ausencia de retención cero refuerza ese punto.
Puntos clave
- La Agents API expone como servicio público el motor gestionado de Codex, en beta.
- Los agentes corren en entornos de OpenAI, propios o de nueve socios externos.
- La compactación, la búsqueda de herramientas, la invocación programática y los subagentes vienen incorporados.
- No hay cargo extra: se paga por tokens, herramientas y tiempo de contenedor.
- La residencia de datos solo en Estados Unidos y la falta de retención cero limitan por ahora las cargas reguladas.