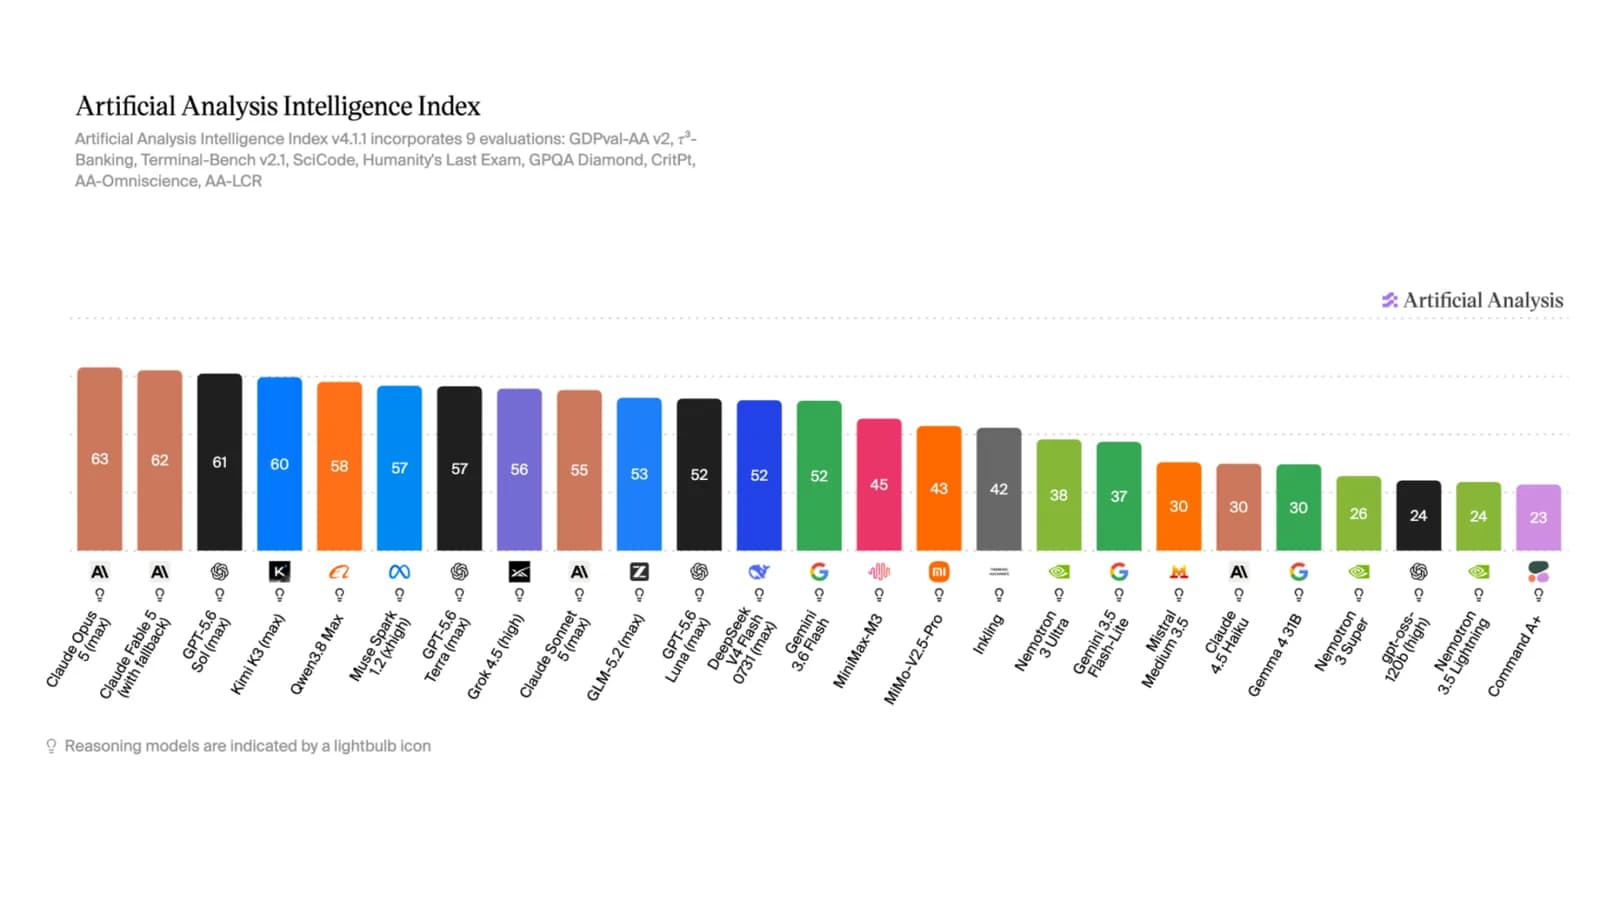
Google DeepMind publicó Gemini 4 Carbon, su nuevo modelo de frontera, apenas dos semanas después de Gemini 4 Argon. Con 59 puntos en la versión 5.0 del Intelligence Index de Artificial Analysis, recién actualizada, Carbon ocupa el primer lugar de esa tabla. Argon se queda en 50.
Además de mejoras generales en tareas agénticas y programación, Google destaca capacidades que cubren todo el ciclo de la ciberdefensa, desde detectar y validar vulnerabilidades hasta parcharlas. Carbon encabeza el índice general de Artificial Analysis, pero en programación agéntica con Claude Code todavía queda un poco por detrás de Claude Opus 5.5.
Pensado para sesiones de programación de varios días
Según Google DeepMind, Carbon fue diseñado para "problemas de ingeniería mucho más difíciles y de largo horizonte", que exigen flujos agénticos persistentes. Equipos internos lo hicieron trabajar varios días seguidos. En ese tiempo, de acuerdo con Google, el modelo salió solo de callejones sin salida y resolvió tareas complejas de varios pasos, como análisis de causa raíz y correcciones de errores sutiles en bases de código grandes y en software de bajo nivel.
Google también reporta avances en razonamiento científico, comprensión multimodal y desarrollo web de pila completa, a partir de la retroalimentación de usuarios. La mejor calidad de lo que genera en desarrollo web subió a Carbon 89 puntos Elo en WebDev Arena, donde ocupa el cuarto lugar con 1.769.
En la selección de pruebas que eligió la propia Google, Gemini 4 Carbon gana 15 de 16, con más distancia en contexto largo y en seguridad. En el benchmark de inyección indirecta de prompts de Gray Swan, la tasa de éxito de los ataques bajó de 0,7% con Argon a 0,0%. Según Google, el modelo bloqueó todos los intentos de manipulación probados. Eso no quiere decir que la inyección de prompts esté resuelta, pero la prueba parece saturada.
¿Qué dicen las evaluaciones independientes?
Según Artificial Analysis, Carbon en su nivel de razonamiento más alto ("high") lidera el Intelligence Index v5 sobre todo por sus resultados en razonamiento complejo, recuperación de conocimiento y tareas científicas. Gana cuatro de las nueve evaluaciones individuales del índice.
En programación agéntica sobre Antigravity sigue tres puntos detrás de Claude Code con Opus 5.5 (62 contra 59), aunque saltó de 53 a 59 respecto de Argon. En trabajo de conocimiento agéntico, en AA-Briefcase, Carbon (high) gana 126 puntos sobre Argon (high, 1.483 Elo) y llega a 1.609 Elo, impulsado por la calidad de las presentaciones (+293 Elo, hasta 1.598) y la calidad analítica (+120 Elo, hasta 1.671). Igual queda detrás de Kimi K3.1 Pro (1.678 Elo), Muse Wonder (max, 1.659 Elo) y Grok 4.7 (xhigh, 1.638 Elo).
La precisión de las respuestas sube de 48% a 58% frente a Argon. La tasa de alucinación también sube, de 4% a 11%. Es más alta, pero sigue siendo la segunda más baja del ranking. Claude Opus 5.5 (max) y GPT-6 Astra (max) marcan 50% cada uno.
La plataforma de evaluación Vals AI pone a Carbon en segundo lugar en su Vals Index v2.2, con 70,36% de precisión. Queda detrás de Claude Sonnet 5.5 (70,85%) y delante de Claude Opus 5.5 (70,18%) y de Argon, cuarto con 69,24%. Con 10,51 dólares por prueba y algo menos de 48 minutos de ejecución, sale más barato y más rápido que los dos modelos de Anthropic.
En Vals.ai, Carbon lidera además el Finance Index y el benchmark de investigación legal. En investigación legal, Vals AI registró cerca de 45% más fuentes citadas, más llamadas a herramientas y respuestas más largas que Argon.
| Evaluación | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|
| AA Intelligence Index v5 | 59 | 50 |
| AA-Briefcase (Elo) | 1.609 | 1.483 |
| Precisión de respuestas (AA) | 58% | 48% |
| Tasa de alucinación (AA) | 11% | 4% |
| Vals Index v2.2 | 70,36% | 69,24% |
| Inyección indirecta, Gray Swan (éxito del ataque) | 0,0% | 0,7% |
Hay un costo. Las tareas del benchmark Finance and Tax Agent tardan más del doble que con Argon, y en investigación legal Carbon promedia más de 50 minutos por tarea. El modelo genera 2,3 veces más tokens de razonamiento y 64% más tokens de salida que Argon, aunque eso sigue siendo menos de la mitad de los tokens de salida de Sonnet 5.5 y Opus 5.5.
En Arena.ai, Gemini 4 Carbon (High) toma el primer lugar de Text Arena con 1.528 puntos, apenas sobre Argon (1.520). En Agent Arena queda segundo, sobre más de 21.900 sesiones reales, con una mejora neta de 16,2% y el mayor puntaje de dirigibilidad (+18,6%). Lo supera Claude Opus 5.5 (Max, +21,1%) y queda delante de GPT-6 Astra (Max, +13,4%) y de Fable-5.1. Su costo mediano por tarea, de 1,80 dólares, es 72% menor que el de Claude Opus 5.5 (Max).
En la categoría WebDev de Code Arena, Carbon llega a 1.768 puntos, 89 por encima de Argon, que está undécimo. Queda cuarto en la tabla general, a solo dos puntos de Claude Sonnet 5.5 (xHigh, 1.770). Eso lo ubica en la curva de Pareto de las tres disciplinas.
Carbon lidera las pruebas de seguridad sin barreras de protección
En varias pruebas de seguridad, Google corrió el modelo sin sus barreras de protección. En SEC-bench Pro, que mide el descubrimiento autónomo de vulnerabilidades en software real, Carbon logra 88,2% y supera a todos los modelos probados. En ExploitGym, que evalúa si un sistema convierte las vulnerabilidades encontradas en exploits funcionales, llega a 54,8% con diez horas de ejecución. En CWE-Bench, que mide la escritura de correcciones, saca 71,0% y una ventaja amplia en el primer lugar. En las tres pruebas queda delante de GPT-6 Astra y de Argon.
Google también cita resultados internos que no se pueden verificar de forma independiente. En pruebas propias, Carbon produciría código seguro más del doble de veces que Argon. En pruebas del equipo de Chrome, rindió más de diez veces mejor escribiendo parches de seguridad que el modelo de frontera de un competidor que Google no nombra.
¿Quién puede usarlo y cuánto cuesta?
Google lo libera por etapas y participa en el proceso voluntario de pruebas previas al lanzamiento del gobierno de Estados Unidos, por las capacidades de seguridad del modelo. Desde esta semana lo reciben primero expertos en ciberseguridad seleccionados. Después, a través del programa Fairwind de Google DeepMind, el acceso se ampliará a más socios de confianza.
La empresa planea abrirlo a desarrolladores, empresas y consumidores en sus productos cuando reúna más retroalimentación y ajuste las barreras de seguridad.
Gemini 4 Carbon sale con el mismo precio de lanzamiento que Argon. Cuesta 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, y los tokens de entrada en caché tienen 95% de descuento sobre el precio normal.
En el Intelligence Index de Artificial Analysis, Carbon cuesta 7,76 dólares por tarea, casi lo mismo que Argon (7,68 dólares). Es cerca de 23% menos que Claude Opus 5.5 (max, 10,04 dólares) y unas 1,2 veces lo de GPT-6 Astra (max, 6,25 dólares). Promedia 123.000 tokens de salida por tarea, 29% menos que el modelo de Anthropic (173.000).
Artificial Analysis hace sus cálculos con el precio de lista normal, de 4 dólares por millón de tokens de entrada y 20 dólares por millón de salida (más 0,20 dólares por la entrada en caché). No considera el descuento de lanzamiento de 50%, que rige hasta fines de 2026.